TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

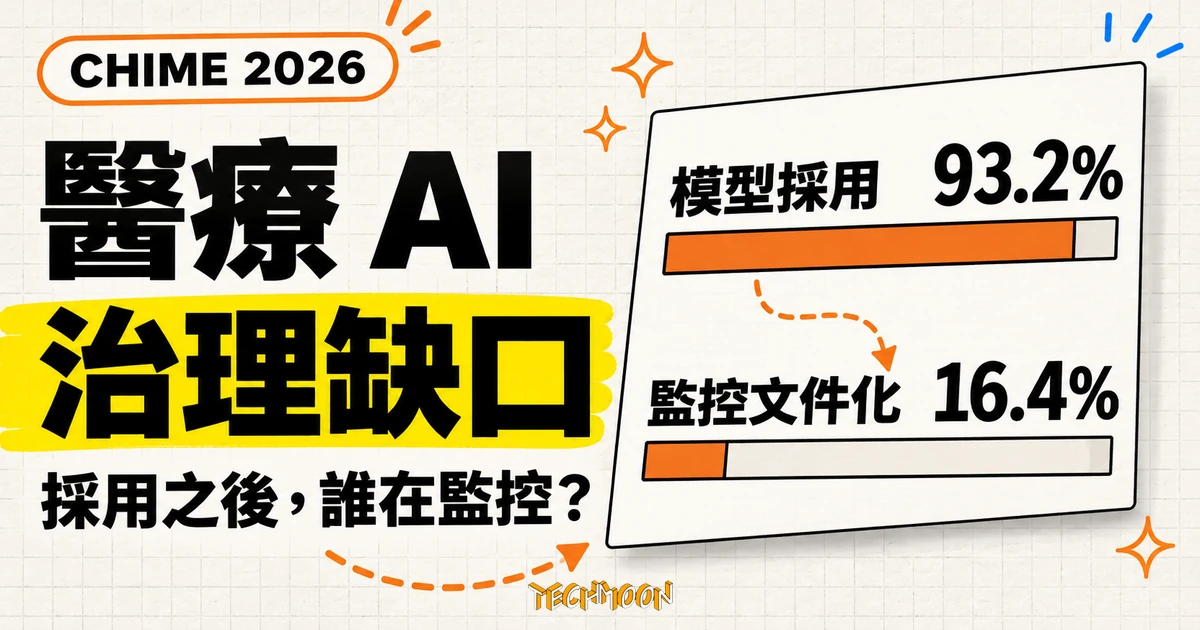
CHIME 與 Digital Health Analytics 的 2026 Digital Health Most Wired 報告涵蓋 46 州、5 國、代表逾 48,800 家醫療機構的 235 家組織:93.2% 已在臨床或營運流程使用 AI,生成式 AI 全面採用一年內從 31.0% 升到 54.8%,但 219 家 AI 使用者中只有 36 家對上線後模型監控建有完整書面流程,連最先進的 95 家組織也只有 24.5%。2027 年 1 月 1 日 CMS 給付方 API 生效前,這份報告畫出了醫療 AI 治理的真實斷點。
用 AI 摘要這篇文章:
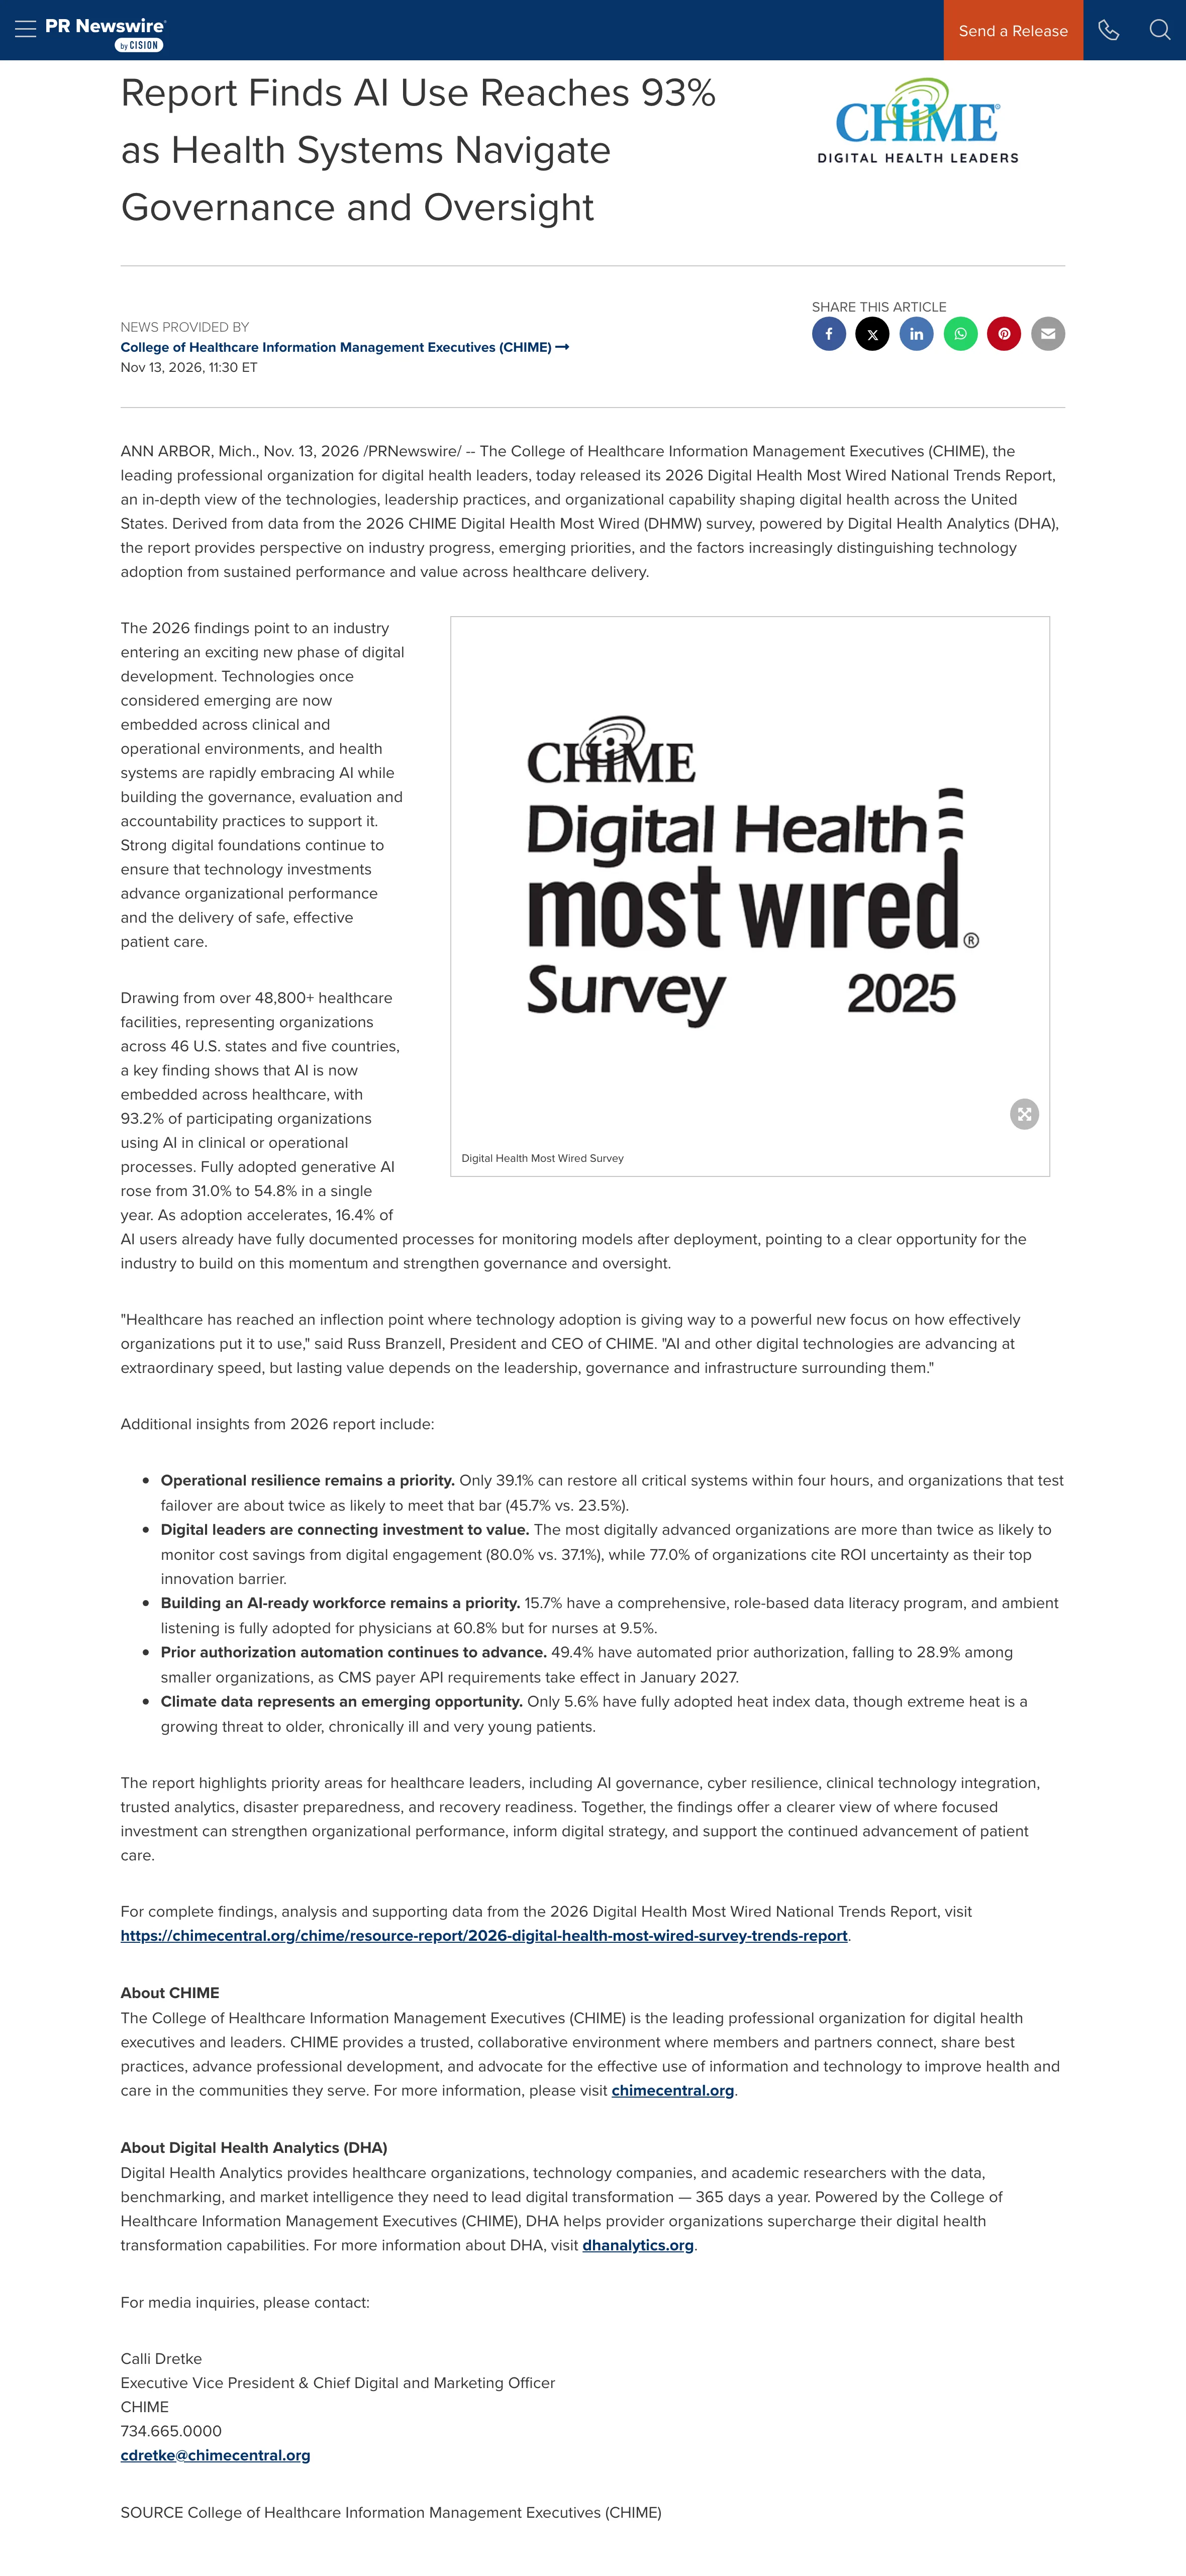
11 月 13 日,美國醫療資訊主管組織 CHIME(College of Healthcare Information Management Executives)發布《2026 Digital Health Most Wired 全國趨勢報告》,這份年度調查涵蓋 46 個州與 5 個國家、由 235 家醫療組織提交 476 份問卷、代表超過 48,800 家醫療設施。媒體頭條大多落在兩個數字:93.2% 的組織已在臨床或營運流程使用 AI,生成式 AI 的全面採用在一年內從 31.0% 跳到 54.8%。但把53 頁報告原文攤開,真正值得放進標題的訊息發生在模型上線之後:在使用 AI 的組織中,只有 16.4% 對上線後的模型監控建有完整書面流程,換算回人數是 219 家 AI 使用者裡的 36 家。採用已經衝過終點線,治理的耐力賽才剛起跑。
報告把 AI 治理拆成上線前、上線、上線後三段共八個控制點,每個控制點都是獨立的問卷題目,各自有自己的作答基數。把這八階排起來,薄化的趨勢一目了然:
| 生命週期階段 | 控制點 | 覆蓋率 | 基數 |
|---|---|---|---|
| 上線前 | 委員會審查並核准 AI 風險模型 | 78.5% | 177 |
| 上線前 | 完整書面的部署前評估 | 42.0% | 219 |
| 上線前 | 定期偏誤與公平性測試 | 33.3% | 219 |
| 上線 | 在臨床或營運流程使用 AI | 93.2% | 235 |
| 上線 | 完整且最新的部署模型清冊 | 65.3% | 219 |
| 上線後 | 完整書面的上線後監控流程 | 16.4% | 219 |
| 上線後 | 追蹤並報告 AI 投資效益 | 80.4% | 219 |
| 上線後 | 隨人口與照護模式改變重新校準模型 | 56.5% | 177 |
有兩個統計細節必須先講清楚,不然這張表會被讀歪。報告自己在表尾註明:這些控制點反映的是獨立題目各自的覆蓋率,任何兩個數字之間的差距並非漏斗式的流失,不能解讀成 93.2% 的機構一路掉到只剩 16.4%。同時「完整建立並文件化」是報告刻意設定的篩選高標,多數組織其實以某種形式做過評估,只是沒有寫成可稽核、可交接的書面規範。把這兩個但書放進來,16.4% 依然低得扎眼:在已經把 AI 放進日常作業的醫院裡,超過八成對「模型開始運作之後誰在盯、盯什麼、多久盯一次」沒有白紙黑字的答案。
報告對這個缺口的定性值得直接引用:部署本身是生命週期的中段,治理應該在上線前就開始、在上線後持續;部署前評估的覆蓋率(42.0%)遠低於已經上線的比例(93.2%),代表許多組織是先上線、後補課。偏誤測試那一階還藏著更刺眼的數字:73 家之外,另有 14.6% 的 AI 使用者完全不測偏誤,等於每七家就有一家連定期檢查都沒有排進流程。至於評估由誰把關,63.5% 的組織把 AI 測試與驗證交給含臨床領導的多學科委員會,這是八階梯裡相對健康的一環。
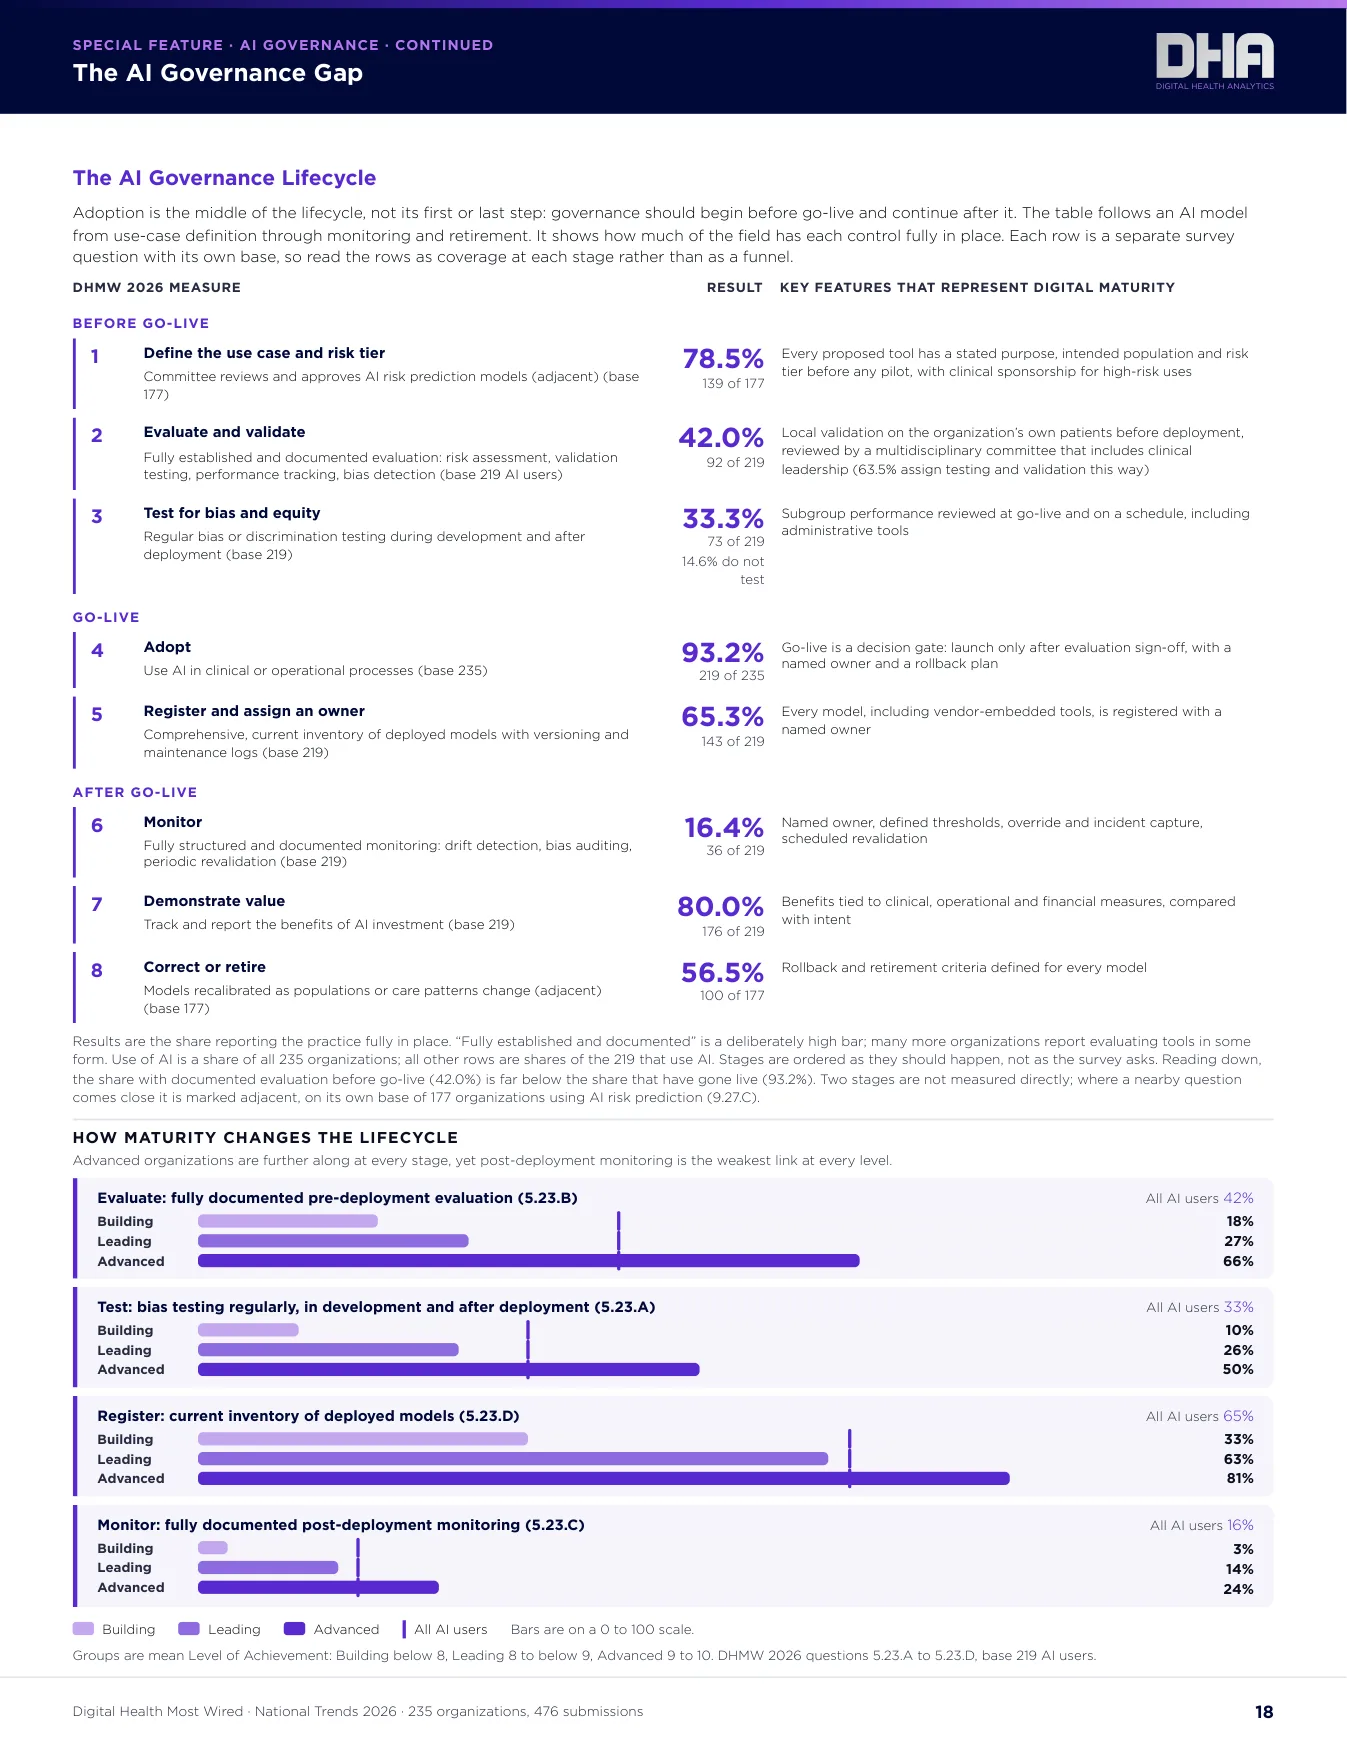
如果以為監控缺口只出現在落後機構,報告下一組數字會推翻這個假設。CHIME 依數位成熟度把 235 家組織分成三組(Building 49 家、Leading 91 家、Advanced 95 家),在 AI 使用者中:
換句話說,就算是最成熟的那 95 家,仍有大約四分之三沒有把上線後監控文件化。報告的用詞很直白:AI 治理的缺口在頂端也不會關閉。這組對照大概是最能戳破「等醫院更成熟就會自動補上」期待的證據:成熟度墊高了部署前評估與偏誤測試的覆蓋率,卻沒有等比例墊高上線後監控。
年度對比是這份報告的變動本體。在連續兩年都作答的組織之間(基數分別為 197 與 188 家):
| 指標 | 2025 | 2026 | 備註 |
|---|---|---|---|
| 生成式 AI 全面採用 | 31.0% | 54.8% | 全部可比項目中移動最快的一項 |
| 環境語音聽寫採用 | 42.9% | 62.1% | 泛用項目,醫師端數字另計 |
| 34 個可比 AI 項目 | 中位數 33.3% 起算 | 增加 4.4 個百分點 | 其餘 263 個項目僅增加 2.4 |
| 平均成就等級 | 7.90 | 8.13 | 續答組織,非同批 |
報告對這段動量的註解是:AI 是唯一一個起點低、又還有很大空間的領域,其他數位健康實踐多半是在收尾已經開始的工程。資安構面裡的 11 個 AI 項目同步前進了 7.1 個百分點,AI 驅動的事件回應與威脅情資從 44.1% 升到 59.4%,報告下的註腳是 AI 同時走進了資安中心與診間。外部對照也指向同一方向,報告引用美國醫學會(AMA)2026 年醫師調查:81% 的醫師已在執業中使用 AI,遠高於 2023 年的 38%,平均每位醫師使用 2.3 個 AI 用例。採用是真的、加速度也是真的,這正是監控數字顯得刺眼的原因。
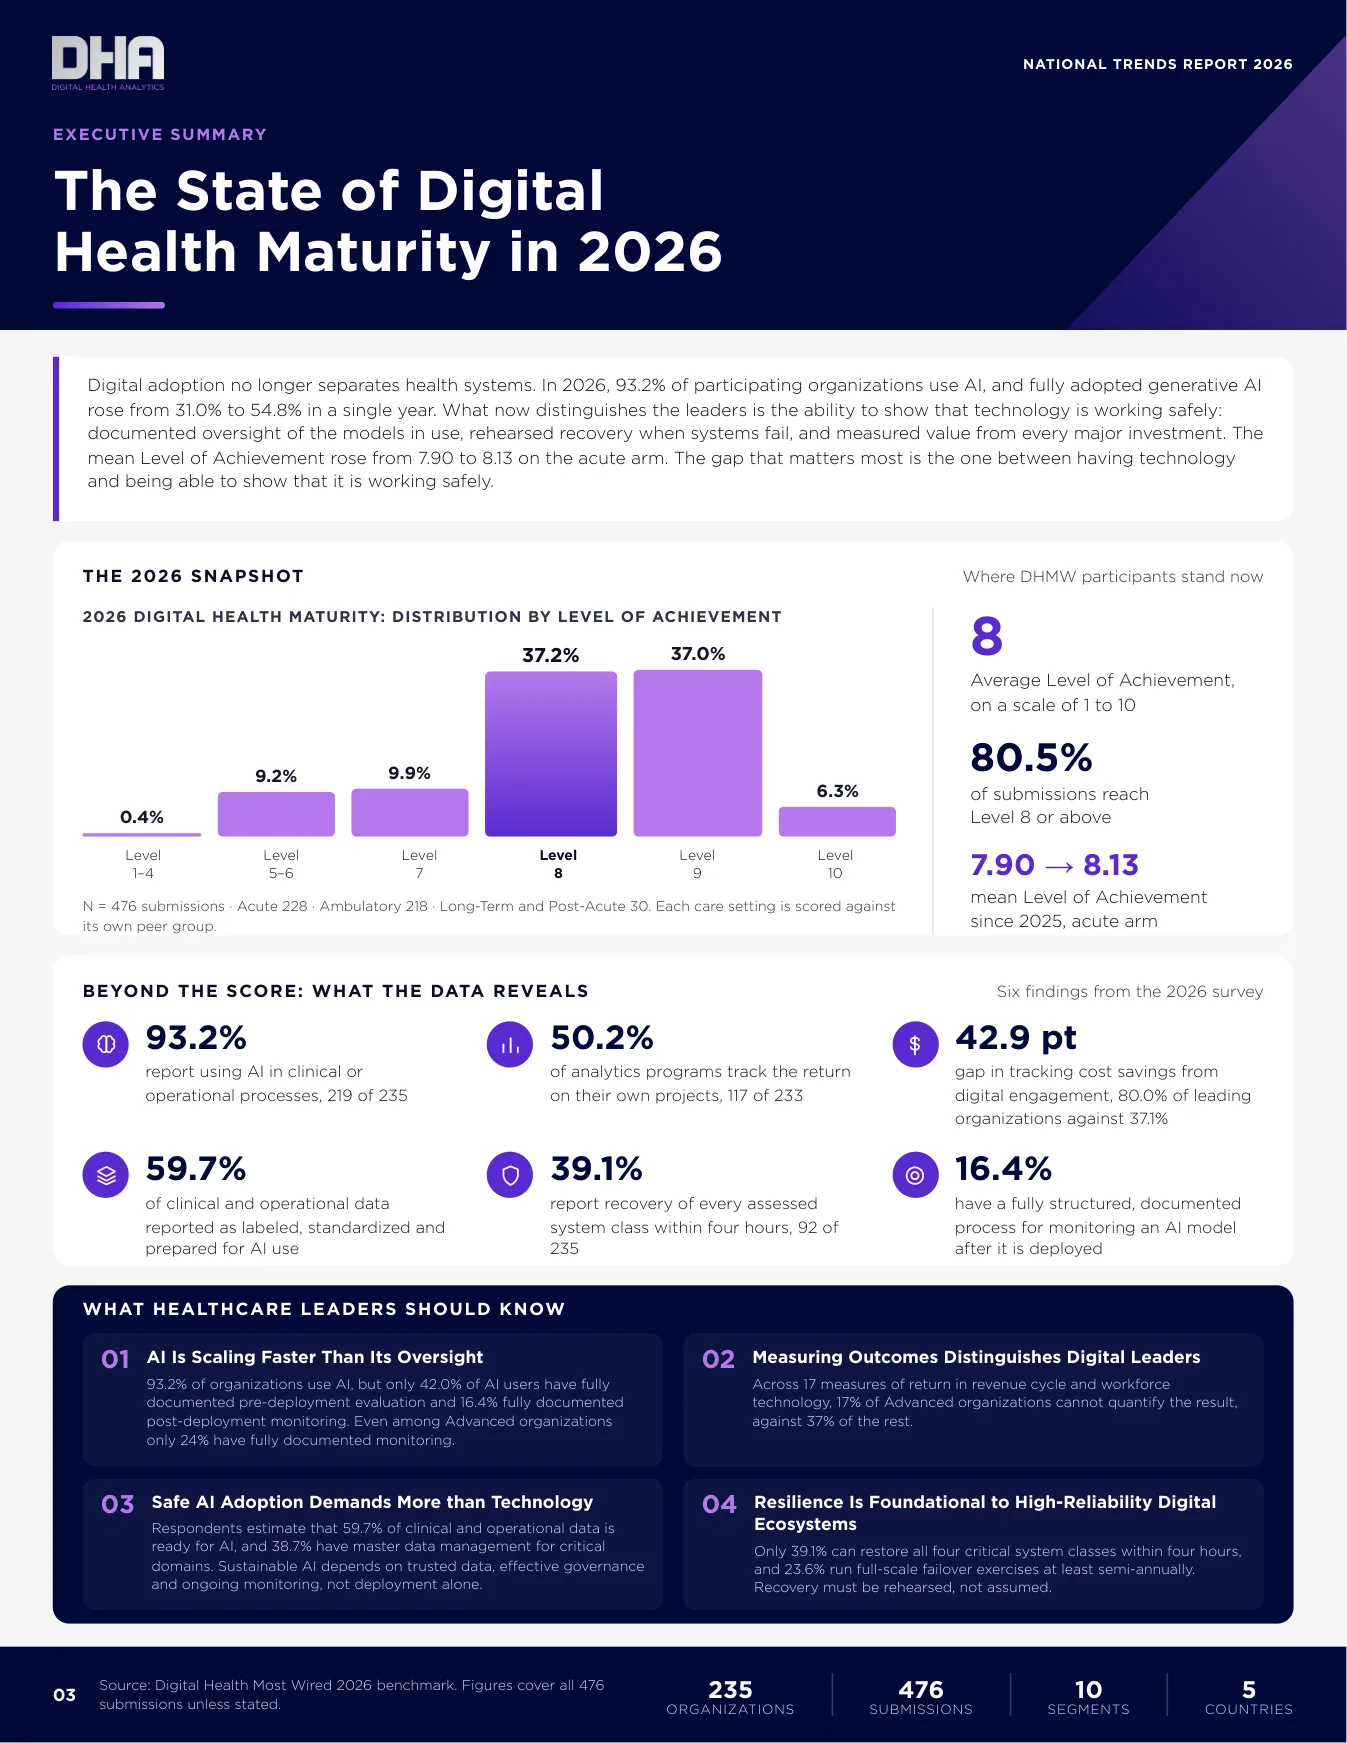
把 AI 放到臨床人員面前的兩個用例跑得最快:醫師與進階執業者的環境語音聽寫全面採用率達 60.8%(132/217)、預測分析模型 56.1%;護理端的環境語音聽寫卻只有 9.5%(20/211)。護理是醫院最大宗的臨床人力,這個 6.4 倍的落差說明採購優先序先解決了醫師的文書痛點,護理團隊還在等;臨床應用從哪個環節起步比較穩,可以對照Google 新加坡醫療 AI 合作從門診評估切入的設計。9.5% 也不是終點:護理端環境語音「已使用或試點中」的比例是 46.9%,Advanced 組織有 62% 在用或試點,14 家最高等級(Level 10)提交的組織裡有 13 家在用或試點。報告同時提醒,2025 年調查有 88.1% 組織通報曾投資或計畫投資護理 AI 工具,與今年的 9.5% 之間存在口徑差(廣義工具對單一工具、意圖對落地),該讀作方向而非趨勢線。
跟工具擴張速度落差最大的是訓練。只有 15.7% 的組織(37/235)對全體員工建有完整、分職務的資料素養計畫;59.1% 只訓練部分角色、22.6% 只有非正式管道、2.6% 完全沒有。同一份調查裡,76.2% 把終端使用者素養列為資料分析導入的障礙,48.0% 把 AI 專業與人力準備不足列為臨床 AI 的障礙,而且這個障礙在每個成熟度層級都被點名。人力端的灰色地帶也在浮現:報告引用 Wolters Kluwer Health 在 2025 年 12 月對 518 位專業人員的調查,40% 曾在工作場所遇到未經核准的 AI 工具、近 20% 用過、約十分之一用在直接照護。未核准工具繞過了清冊、驗證與監控的每一道關卡,而模型清冊覆蓋率只有 65.3%,這正是它最實際的風險來源。
治理席次上的落差同樣具體:護理在網路風險治理委員會是核心成員的比例只有 38%,臨床營運是 55%,病人與家屬代表進入創新治理核心的更只有 17.1%。報告自己的分析也誠實:讓護理進核心委員會的組織,確實更可能有標準化的評估框架(85.4% 對 60.4%),但在部署前評估(44.7% 對 38.3%)與上線後監控(18.6% 對 12.8%)上並沒有明顯差距,護理進了創新治理的門,還沒真正進到 AI 監督的桌子。前線的態度也值得治理會議參考:AMA 調查中 88% 的醫師擔心技能退化、85% 希望在 AI 導入決策中被諮詢。想系統性補訓練缺口,可以參考Google 把醫療 AI 訓練做成 CME 學分證書的做法。
韌性段的關聯性資料同樣值得細讀。只有 39.1% 的組織(92/235,自評能力)表示臨床、行政、網路與員工通訊四類關鍵系統都能在主要資料中心失效後 4 小時內復原。把機構分成「有做故障切換測試」與「沒做」兩組,達標率立刻拉開一倍:45.7% 對 23.5%,而且報告註明這個關聯在控制組織規模後仍然成立。全規模、含實際切換的演練只有 23.6% 的組織至少每半年做一次,對照之下釣魚演練卻高達 95.3%,報告的註解是:組織只排練容易的部分。這依然是橫斷面相關而非實驗因果,但對營運團隊的含義很實際:復原能力可以被定期排練出來,不排練就不會憑空出現。第三方風險是另一個結構性缺口,82.1% 把第三方風險列為經營網路風險職能的最大障礙,報告並以 2024 年 2 月 Change Healthcare 勒索攻擊(影響約 1.927 億人,美國史上最大醫療資料外洩)作為供應鏈單點失效的註腳。
財務段出現一組很有意思的對照。77.0% 的組織(177/230)把財務限制與回報不確定列為創新的頭號障礙;而數位化程度最先進的組織中,80.0% 會持續追蹤數位互動帶來的成本節省,其他組織只有 37.1%,兩組相差 42.9 個百分點。「看不出回報」與「沒有建立計分板」經常是同一件事的兩面。這裡有個值得指出的細節:追蹤 AI 投資效益的覆蓋率,報告第 17 頁印的是 80.4%(176/219),第 18 頁生命週期表印的卻是 80.0%,兩處分子分母相同,按算術 176 除以 219 應為 80.4%,報告自身存在一處未校正的排版差異,引用時建議以 176/219 的實數呈現。
其他效益量測的覆蓋率依序是:將預期與實際成果相比 63.6%(136/214)、追蹤分析專案回報 50.2%(117/233)、使用正式創新評估框架 38.7%(91/235)。在收入週期與人力技術的 17 項回報指標上,Advanced 組織只有 17% 回答無法量化,其他組織是 37%。報告給領導者的建議是把成效量測寫進投資核准的那一刻,而不是上線後再找指標。
這份報告裡唯一帶著法定倒數的一項是事前授權自動化。整體已有 49.4%(112/227)的組織把事前授權的提交與追蹤自動化,但按規模切開是 28.9%、46.6%、70.7% 的階梯,最小型機構明顯墊底。期限在這裡:報告指出,CMS 互通性與事前授權最終規則(CMS Interoperability and Prior Authorization Final Rule)要求受影響的給付方自 2027 年 1 月 1 日起實作事前授權、提供者存取與給付方對給付方三組 API。
有一個常見的轉述偏差值得導正:法規的課責對象是給付方(保險端),報告原文對提供者的說法是尚未自動化者「將獲得較少的好處」,並非部分轉述渲染的行政作業全面卡關。但方向仍然清楚:API 通了之後,資料能自動流動的機構才能把自動化的效益吃滿,最小型機構距離這個位置最遠,而它們正是最沒有餘力吸收行政負擔的一群。
作為自評式的基準調查,這份報告有幾條邊界必須先畫出來。39.1% 的 4 小時復原能力是自評,未經實測;59.7% 的資料就緒度(臨床與營運資料已標籤化、標準化、可互通,中位數 65.1%)是受訪者的估計值,報告特別標明這不是量測結果,並下了註解:約五分之二的資料元素在模型可安全訓練的範圍外,這是治理補不掉的擴張上限,再多的監控流程都改變不了訓練資料本身的品質。調查的商業結構也該知道:10 個評分構面中有 4 個(基礎設施、安全、分析與資料管理、臨床品質)由贊助商支持,今年的研究與分析夥伴是 Revolutional,贊助商名單以圖片形式呈現、未進入文字層。對台灣讀者還有一條最實際的:樣本是美國 46 州加 5 個國家,台灣不在其中,這些數字是美國醫療體系的鏡像,反映全球醫療 AI 治理的共同階段,不能直接推論台灣醫院的現況。同樣在講治理與評測尺度的還有 AWS 開源的 UAEF 代理評測框架,兩者可以對照著讀。
對照這份報告,2027 年有三個可驗收的時間點。最近的關卡是 2027 年 1 月 1 日 CMS 給付方 API 生效,屆時最小型機構的事前授權自動化是否從 28.9% 往上爬,是最直接的落後指標。更能說明治理是否補課的,是下一輪 Most Wired 調查:16.4% 的上線後監控覆蓋率與 24.5% 的 Advanced 組數字,會不會以採用率同樣的速度收斂。報告本身的編務嚴謹度也可以順便驗收:80.0% 對 80.4% 的排版差異是否在下一版修正,小事一件,卻是觀察這份年報品質的便宜指標。
在這些節點之前,已經把 AI 工具放上線的機構可以做一件不花錢的事:對每一個部署中的模型,把負責人、監控閾值與重新驗證的週期寫成一頁文件。36/219 這個數字之所以低,缺的從來不是工具,而是把已經在做的事寫下來的那一步。