TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

AWS 於 2026 年 11 月 11 日公開開源評測框架 UAEF:轉接器先把 LangGraph、LangChain、Strands、AgentCore 等框架的執行紀錄轉成共通的 AgentTrace,再用 36 項內建指標評分,實驗存進 DynamoDB 與 S3 供版本比較與回歸分級。本文核對指標組成:12 項確定性、24 項 LLM 評審,並整理 Bedrock 評審成本、美國三區部署限制與租戶邊界等採用前條件。
用 AI 摘要這篇文章:
AWS 在 2026 年 11 月 11 日於官方機器學習部落格公開一套名為 UAEF(Universal Agent Evaluation Framework)的 AI 代理評測系統,並以 Apache-2.0 授權把完整程式碼放進 awslabs/uaef 儲存庫。它要解的問題很具體:同一個代理換了模型或改了提示詞,回答讀起來好像更順,但工具有沒有多叫錯幾次、成本有沒有上升,很難用眼睛看出來;而各團隊用的代理框架各自記錄執行過程,格式互不相容,評測工具一旦綁死某一家的紀錄格式,換框架或跨框架比較就得重寫。UAEF 的做法是先把不同框架的執行紀錄轉成同一種格式,再用同一組指標打分數,讓「這次修改到底有沒有進步」第一次有了可以對照的歷史紀錄。
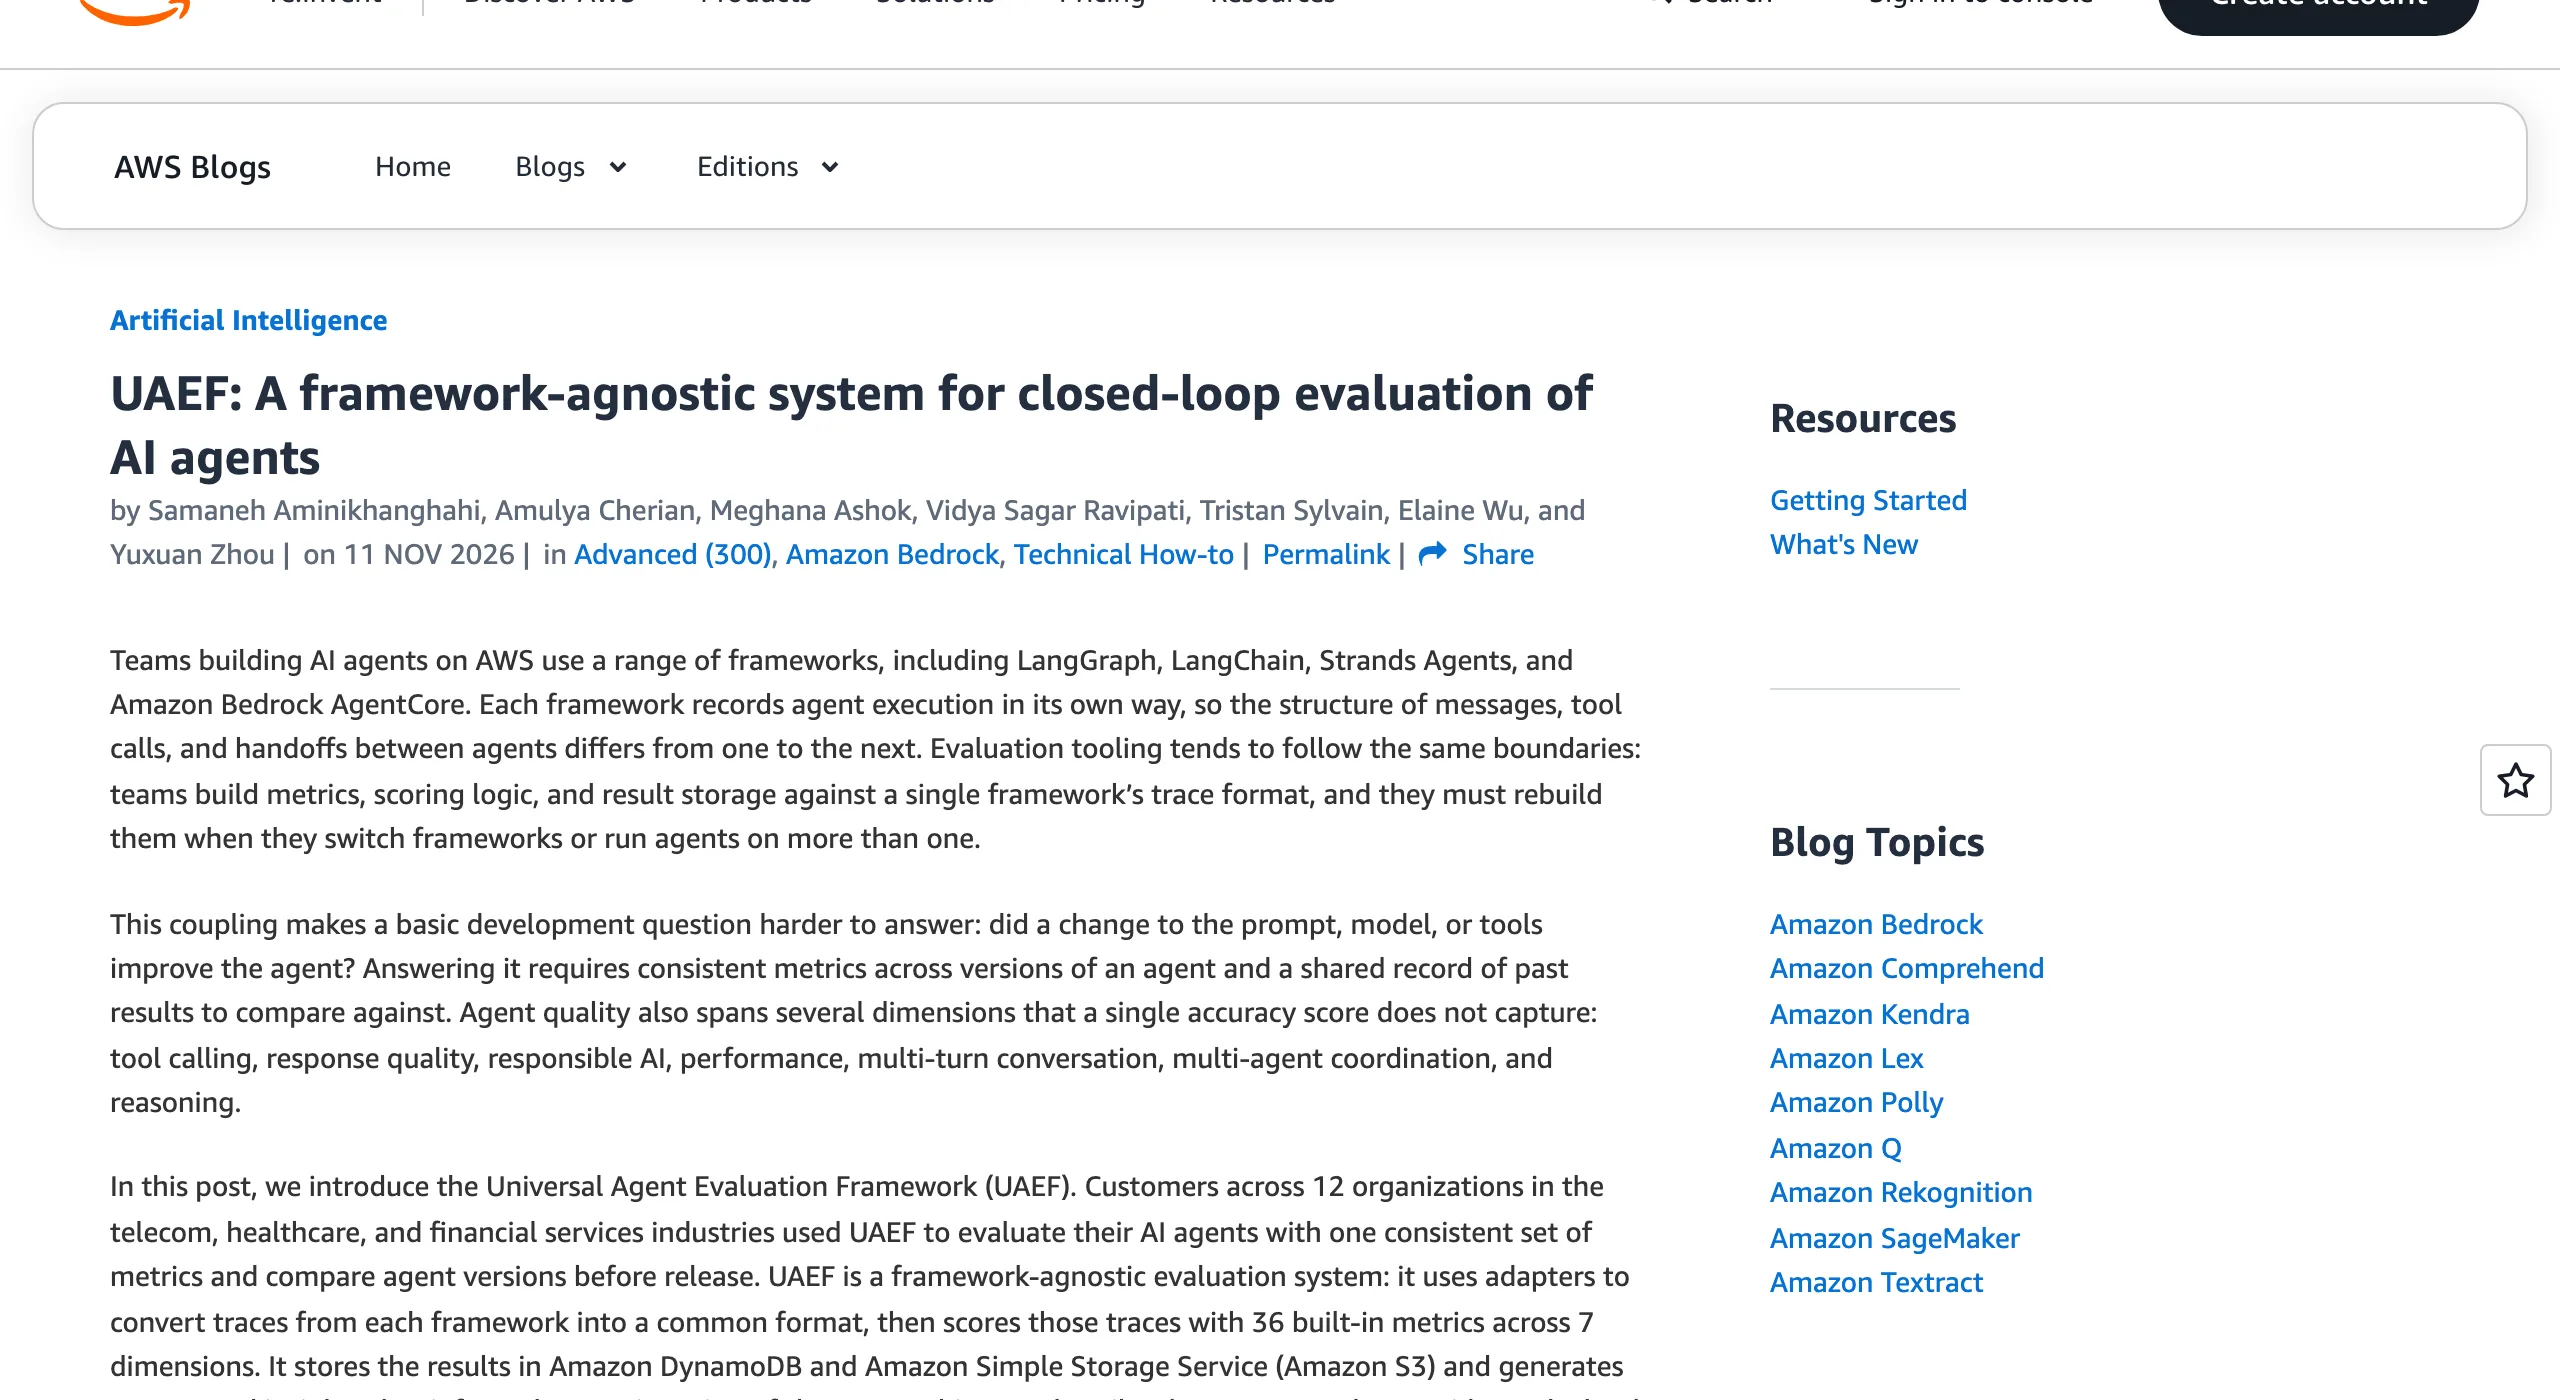
依官方公告,電信、醫療與金融業共 12 家組織已用 UAEF 以同一組指標評測自家代理,並在發布前比較代理版本;這個數字出自 AWS 自己的說法,名單與細節並未公開,先當成熟度訊號看就好。這套系統的實際設計、36 項指標的組成、版本比較的粒度,以及採用前要先算清楚的幾筆帳,官方公告與儲存庫文件都給得足夠完整。
UAEF 的核心只有一個順序問題:先轉換,再評分。它不要求你換掉手上的代理,而是為 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore、Langfuse 這些主流環境各提供一個轉接器,其他自訂框架走通用 JSON 轉接器。轉接器讀取代理的原始執行紀錄,包括訊息來往、工具呼叫與代理之間的交接,全部轉換成一種稱為 AgentTrace 的共通格式;之後所有評分、比較與報表只看 AgentTrace,不再碰任何框架的原生格式。
執行紀錄有兩種進來的方式。團隊如果已經有過去執行留下的紀錄,不管是 log 或觀測平台裡的資料,直接交給對應的轉接器正規化;如果沒有,UAEF 也能反過來呼叫代理:給它一個執行環境的 ARN 或 HTTP 端點,它就對資料集裡每一筆輸入逐一呼叫代理、收集回應、就地轉換。兩條路產出同一種 AgentTrace,所以評分結果不因來源不同而變。儲存庫另外附了十本可直接執行的 Notebook,涵蓋批量評測、多輪對話、多代理、實驗管理與 PII 偵測等情境,每個支援框架都有對應範例,入手時不必從空白筆記本開始。
評測的輸入有兩項:待測代理,以及一份資料集。資料集給每個測試案例一筆輸入,也可以附上參考答案;參考答案是選配,只有需要對照標準答案的指標會用到。要評工具呼叫的話,參考答案還得寫清楚預期呼叫哪些工具、什麼順序、帶什麼參數。換句話說,框架幫你省掉的是評分與比較的重建工作,預期結果的整理仍然是團隊自己的事,這點跟先前整理過的代理任務驗收方法是同一個道理:先想清楚「對」長什麼樣子,檢查才有意義。
資料集本身用 CSV 或 XLSX,一列一個測試案例,只有 Question 欄必填;Question 與 Answer 兩欄的大小寫不分,也接受 Query、Expected_Output 這類常見別名,既有的測試檔多半直接能用。多輪對話的案例靠 session_id 與 turn_id 兩欄分組排序,而且有個容易踩的細節:這兩欄必須小寫,否則檔案會被當成單輪評測;同一組對話的每一輪是帶著 session ID 逐輪送給代理端,對話狀態要由代理自己維持,UAEF 不會替它重播前面的歷史。
進入評分前,UAEF 會先掃描紀錄裡的個人資料,例如信箱、電話號碼與信用卡號,才把資料寫進儲存。跑完的結果若設定保存,會記成一筆實驗:評分、看報告、改提示詞或模型、再評一次,不斷繞圈改良,官方稱這套流程為 closed-loop evaluation。
官方文件把 36 項內建指標編成一張編號表;對照儲存庫的指標目錄,七個維度的分佈如下。
| 維度 | 內建指標數 | 全部確定性計分 | 說明 |
|---|---|---|---|
| 工具呼叫 | 4 | 4 | 選對工具、順序正確、參數品質、MCP 相容 |
| 回應品質 | 4 | 0 | 相關性、完整度、準確度、幻覺分數 |
| 負責任 AI | 4 | 1 | 安全、偏見、毒性、提示注入偵測 |
| 效能 | 4 | 4 | 延遲、token 用量、成本、吞吐量 |
| 多輪對話 | 12 | 1 | 上下文延續、連貫、滿意度、語氣等 |
| 多代理協作 | 4 | 2 | 任務完成、委派品質、利用率、協調效率 |
| 推理 | 4 | 0 | 思維鏈連貫、邏輯一致、步驟正確、謬誤偵測 |
把 Type 欄加總,36 項裡 12 項是確定性指標,直接從紀錄與參考答案計算,重複執行會得到一模一樣的分數;另外 24 項交給 LLM 評審,由 Amazon Bedrock 上的模型打分。每項指標都正規化到 0 到 1 之間,1 最好,所以維度分數與總分共用同一把尺。這個組成比例值得留意:整套系統三分之二的分數來自模型判斷,多輪對話維度尤其明顯,12 項裡 11 項靠 LLM 評審,連顧客滿意度、語氣、自然度這類指標也都是模型說了算。拿分數做版本比較時,評分來源與穩定度要跟著指標類型一起看,跟前述 iFixAi 代理稽核的 A 到 F 成績單一樣,單看總分最容易誤判。
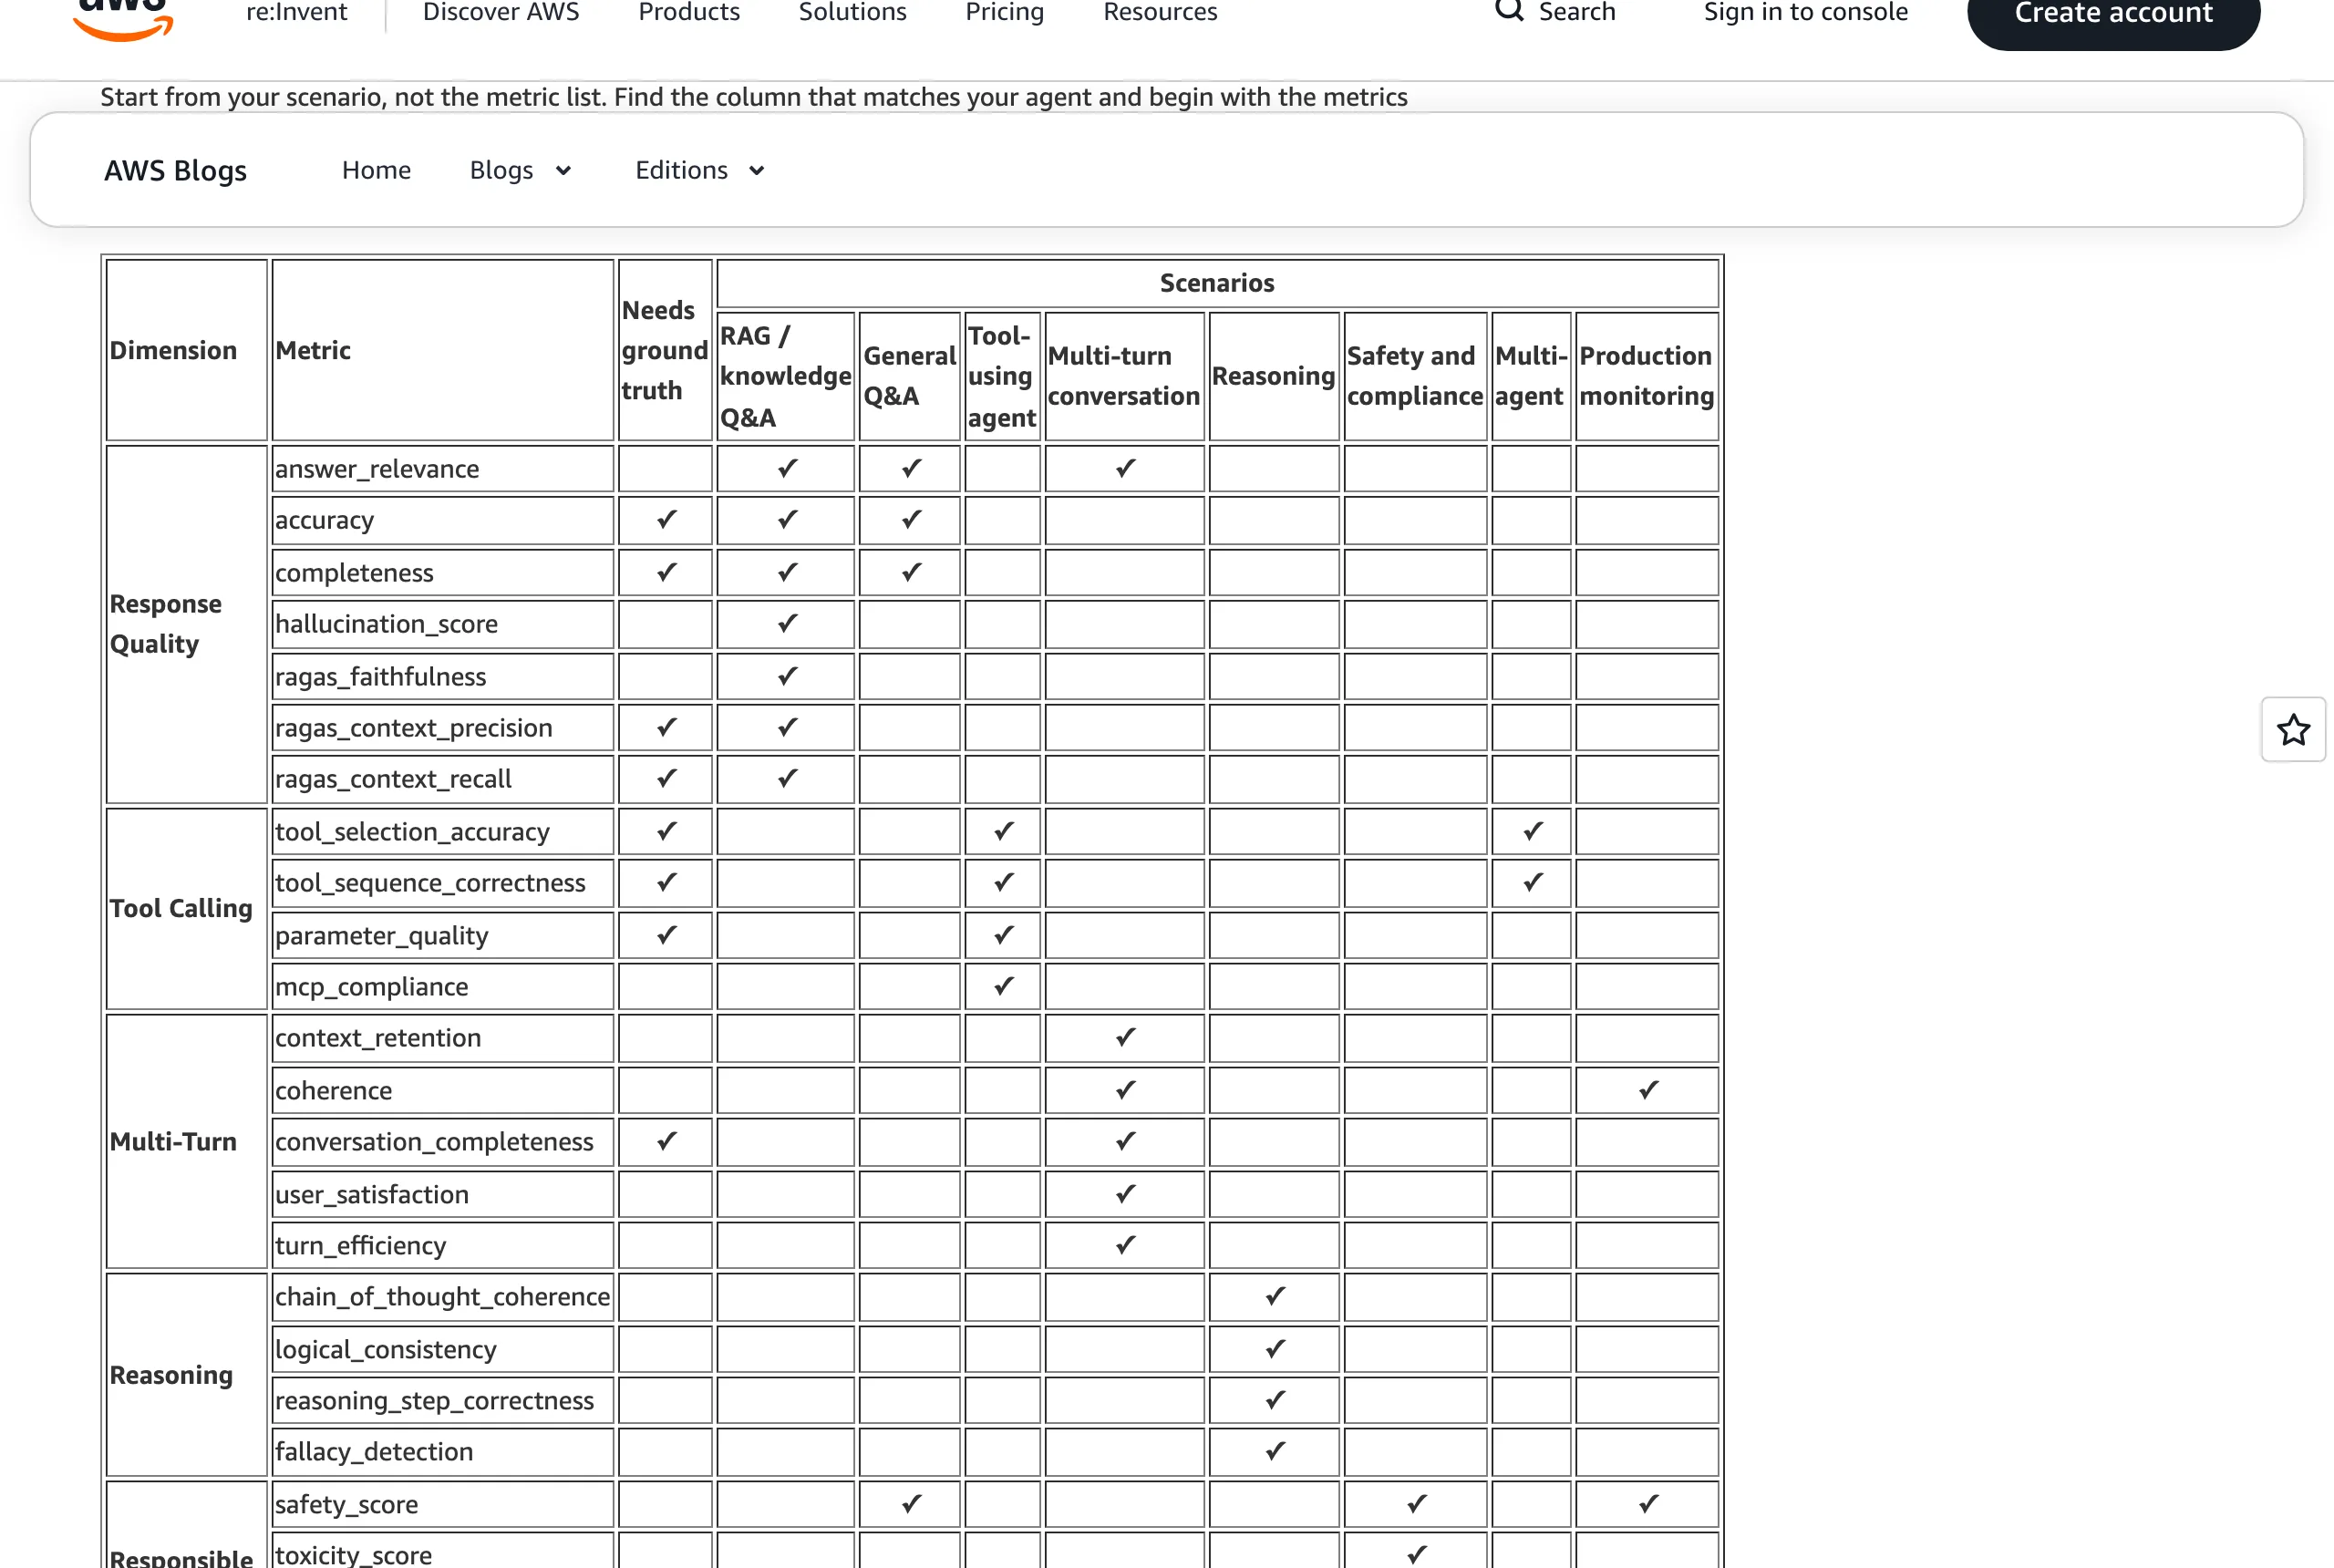
36 這個數字也有邊界。兩個客服情境專用的指標(有沒有升級真人、問題有沒有解決)採登錄制,不在預設清單裡;RAGAS 的 7 項與 DeepEval 的 8 項屬於整合進來的外部指標,Stickler 的 6 項官方標註還在進行中,都不算在 36 項內。另外,資料集沒有參考答案時,需要對照答案的指標會自動跳過,所以只有輸入、沒有標註的線上流量也照樣能評一部分指標;想把測試集做得更扎實,可以參考微軟用一整間假公司測 Copilot 的合成資料做法。
評測結果保存時,UAEF 把它組織成實驗與執行兩層。一次實驗底下可以有多個執行,每個執行記錄當時的設計:框架、模型、工具、系統提示詞與參數,也能附上設定快照與 Git commit,並可以把其中一個執行標為基準線。每個分數因此綁著產生它的那次改動,無論是換提示詞、換模型還是加了工具,事後都追得回來。
實驗資料落地在兩個地方:Amazon DynamoDB 每筆實驗存一列摘要,包含評測次數、每個指標的平均分與總平均,供列表與比較用;Amazon S3 存完整結果 JSON,含每項分數與評審模型的推理過程。比較引擎對兩個執行共有的每個指標算絕對與百分比變化,超過門檻就標成回歸或改善,門檻預設 5%、可以調。回歸另分三級:5% 到 10% 算輕微,10% 到 20% 算中度,超過 20% 算嚴重,並按維度分組,看得出某次提示詞修改傷了工具呼叫、但回應品質沒動這類局部變化。
報表有三層。結果頁給單次執行的摘要與每個案例的明細;統計報告隨選產生,從儲存的分數算信賴區間、離群值、分佈與指標間相關,最後指向分數最低的維度,這層計算不用 LLM,同樣的結果永遠出同樣的報告;第三層把報告交給 Bedrock 上的模型生成分析,單次執行給優弱點與根因假設,跨執行比較給趨勢、回歸原因與下一步建議。想用網頁介面而不寫程式也有路:UAEF 附一套可部署的 AWS 服務與網頁介面,上傳資料集、選框架與指標、看分數,與 Python 程式庫共用同一個評分引擎與儲存,從介面起步、日後進程式碼不必重來。
指標決定要量什麼之後,官方把跑評測的方式整理成六個互相獨立的選擇:拿現成紀錄評,還是讓 UAEF 實際呼叫代理;評單一案例,還是跑整份資料集;單輪還是多輪;單一代理還是多代理系統;離線測試還是盯線上對話;結果用完即丟,還是保存成實驗以便日後比較。六個問題各自按團隊情境回答即可,彼此不綁定;唯一要記住的是,只有保存下來的執行才能進版本比較。
24 項 LLM 評審指標背後的評審模型,服務部署預設是 us.anthropic.claude-sonnet-4-6。因為這是 us. 開頭的跨區推理設定檔,整個服務的部署區域被限制在 us-east-1、us-east-2 與 us-west-2 三個美國區域,站不在這三區的團隊要先把這個前提算進遷移成本。
評審環節的安全設計比多數同類工具講得明白。代理的輸出會被當成不可信輸入處理:評分規則與待評內容分開送出,內容經跳脫處理,無法掙脫分隔符號被讀成指令;評審模型的每個回應都要嚴格解析,並引用它所評內容的逐字片段當證據,找不到證據的分數直接拒收,不會記進結果。官方也把界線說清楚:評審分數是評測訊號,拿來輔助判斷可以,拿來當安全控制不行,代理本身要防護,請另外接 Amazon Bedrock Guardrails。完整的信任模型放在儲存庫的 SECURITY.md。
成本面還有一層容易被忽略:24 項 LLM 指標每一項都是一次模型呼叫,全開跑一輪,Bedrock 帳單與評測時間都會隨案例數線性疊上去。官方的指標選擇建議也因此在勸人別貪多:從你的情境出發,先挑會影響上線判斷的少數幾項,其餘之後再補。
UAEF 本體開源、Apache-2.0 授權,但它的資料落地路徑每一步都在 AWS 服務上:評審走 Bedrock,實驗摘要進 DynamoDB,完整結果進 S3,服務部署再掛 Cognito 使用者池。程式庫單跑不會建立任何資源,只有保存實驗才會寫入上述兩個儲存,預設名稱 uaef-experiments 與 uaef-results,可用環境變數改。要拆掉的時候有個計費陷阱:DynamoDB 表、S3 儲存貯體與 Cognito 使用者池都設了保留政策,刪掉部署堆疊不會連帶刪它們,存放的實驗資料會留在原處繼續計費,直到手動清乾淨;儲存貯體也得先清空才刪得掉。
租戶邊界是另一個要先看的安全前提。SECURITY.md 明講:UAEF 是參考架構,設計上要嵌在一個自帶租戶隔離的平台裡跑,一個租戶一個部署;直接部署在多租戶環境、沒有上層平台做隔離是不支援的組態。單一部署內,它做到每個登入使用者只能讀到自己的實驗紀錄,但官方定位這是租戶內的縱深防禦,不能取代部署層的隔離。另外,部署腳本會建立一個掛 AdministratorAccess 政策的 CodeBuild 角色,官方自己警告這只適合 dev 或沙盒帳號,接上生產環境前要先限縮權限。
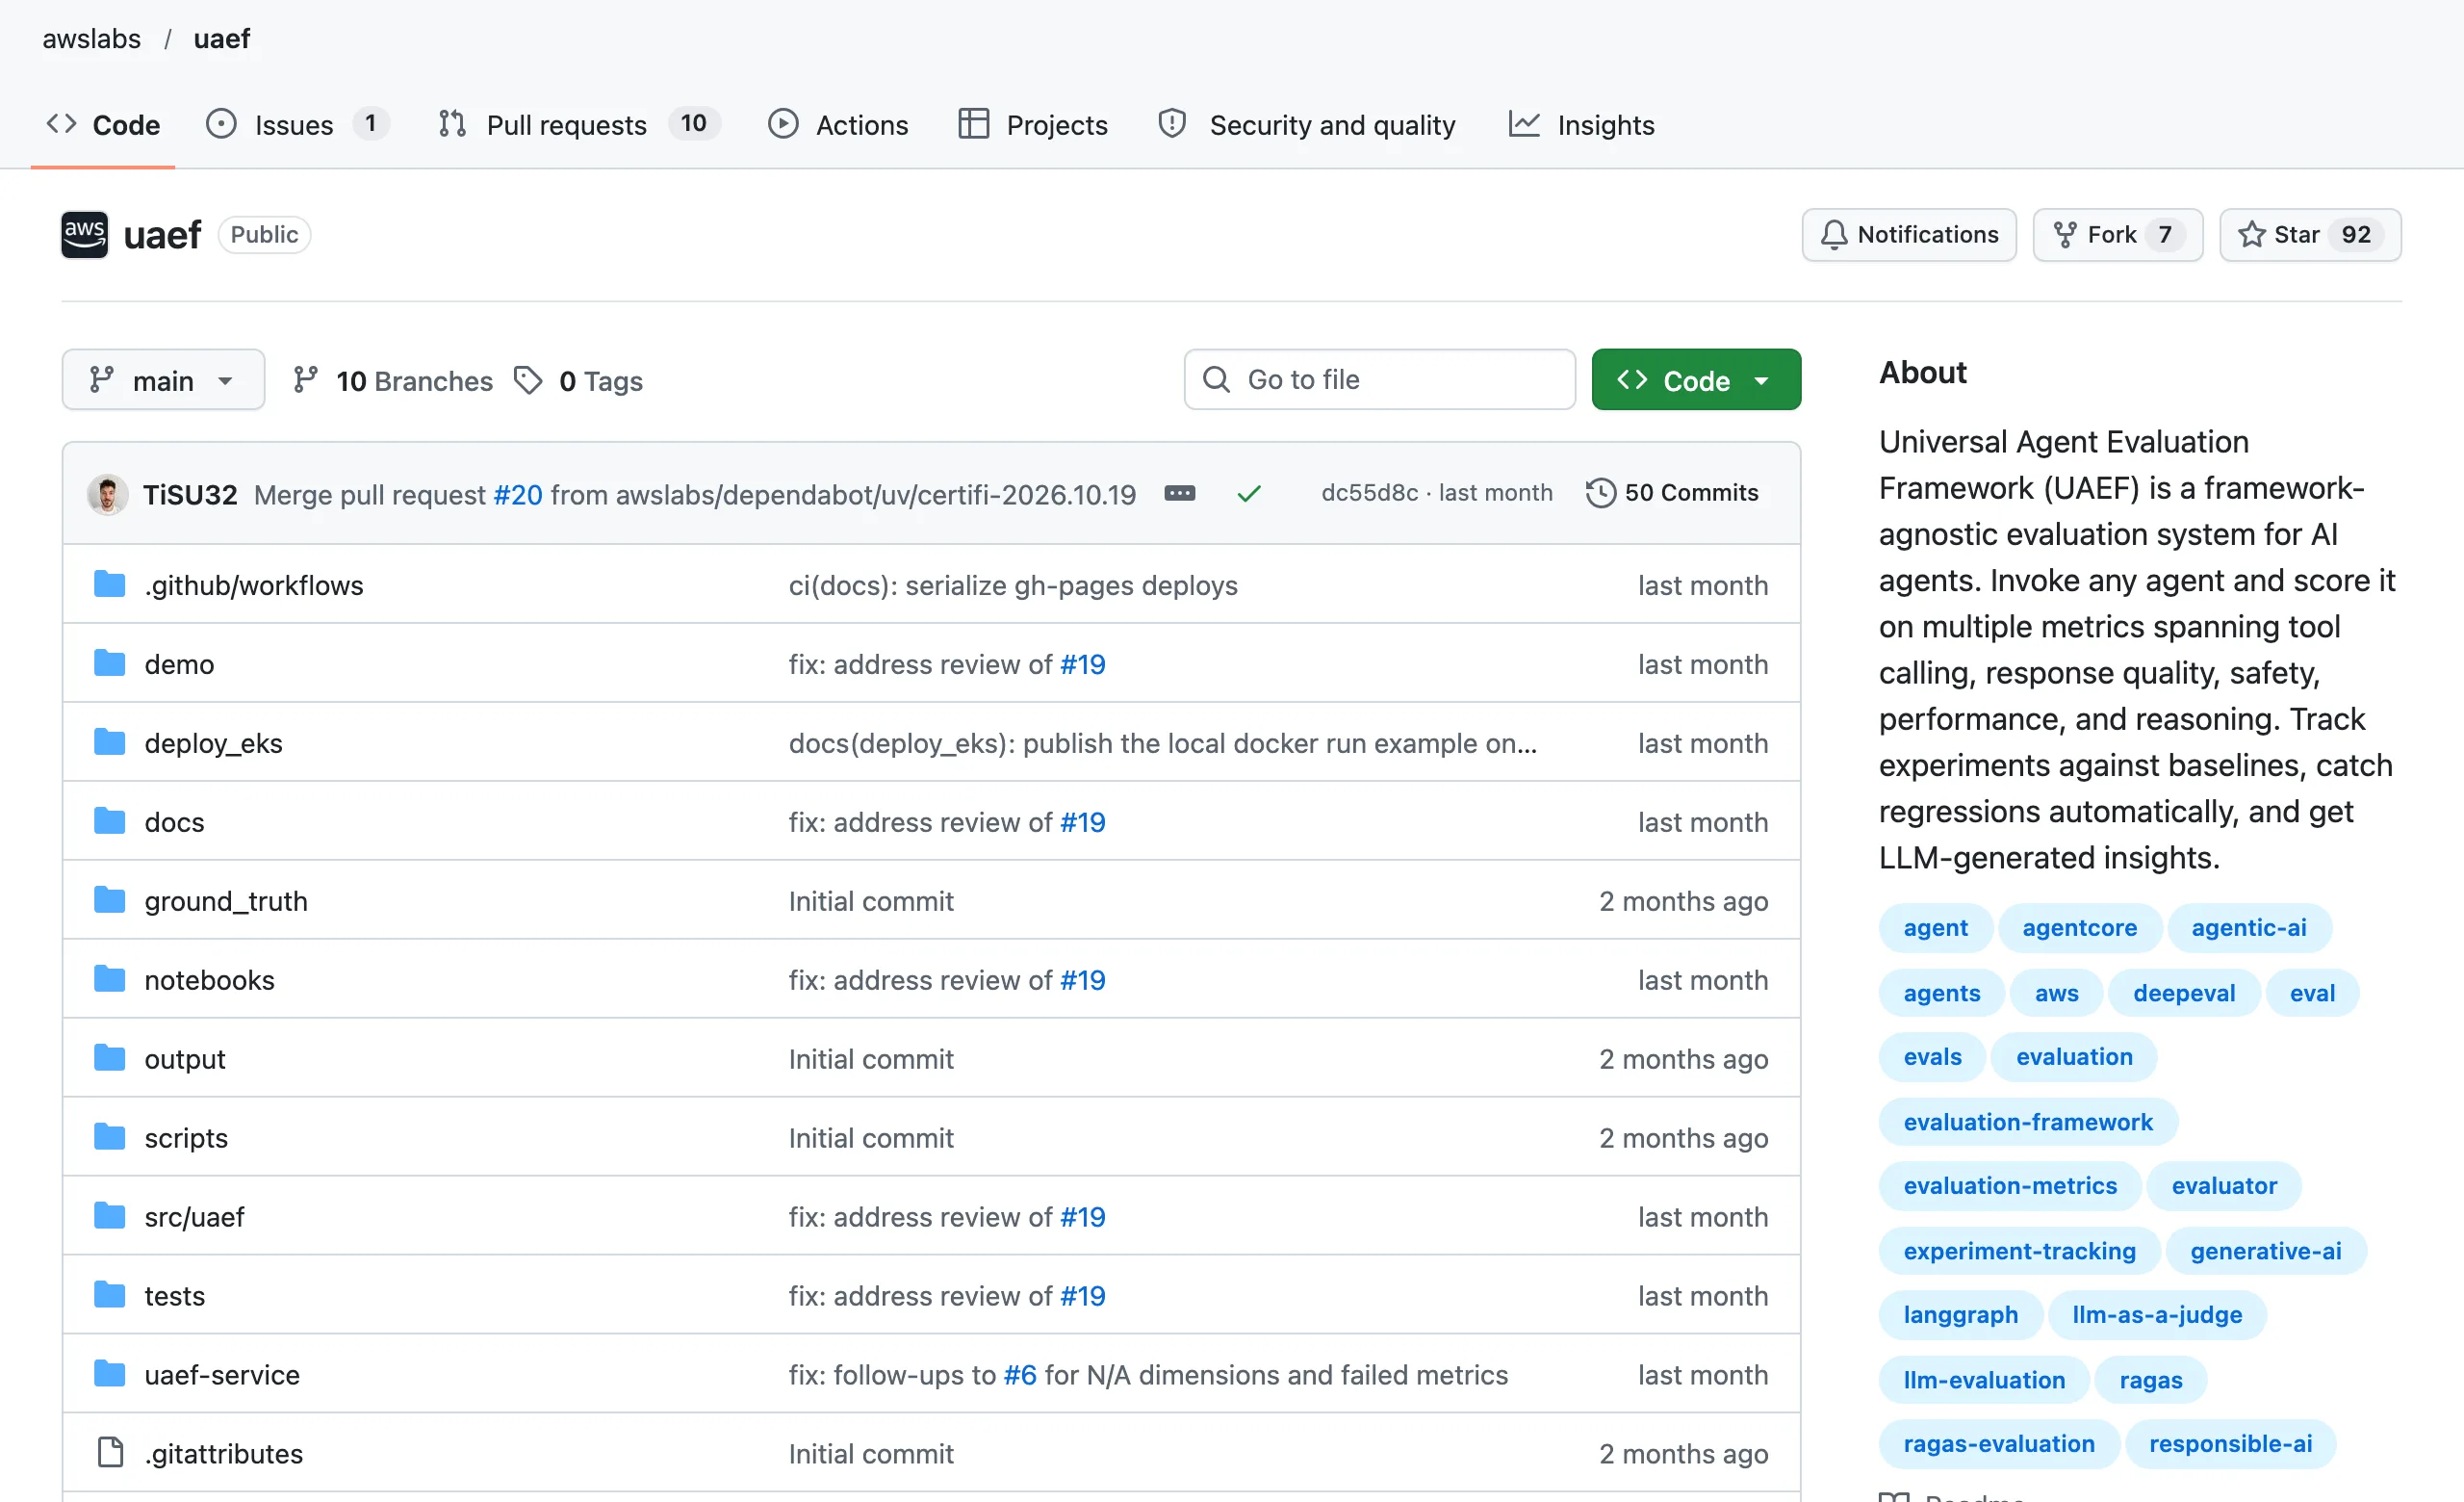
安裝方式目前是從儲存庫出發:Python 3.10 以上、用 uv 套件管理器 clone 後同步安裝,PyPI 上還查無 uaef 套件,服務部署那條路還另外要求 Python 3.11 以上。專案本身還年輕:儲存庫 2026 年 9 月中建立,截至 2026 年 11 月 15 日有 92 顆星,最後一次推送是 2026 年 11 月 13 日,落在活躍開發狀態。
最適合先試的是這種團隊:代理已經上線或快要上線、手上有(或願意整理)一批固定測試案例,而且每隔一陣子就會改提示詞、換模型或加工具,需要每次改動都有前後對照。起步順序官方給的方向是對的:先固定一組案例,把現行版本存成基準線,之後一次只改一項設定,用同一份案例重跑再比較,回歸自然無所遁形;至於指標,從你的代理最不能出錯的條件選起,不必 36 項全開。技術棧不在 AWS 的團隊,先把 Bedrock、DynamoDB、S3 與美國三區的部署限制一起算進總成本再決定。
12 家組織的身分與使用細節、Stickler 整合的完成度、會不會上架 PyPI,官方文件都沒有給出時間表。這些現況一個月內就可能變動,值得回頭看的變數是星數成長、指標目錄的增減與部署區域限制有沒有放寬。