TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

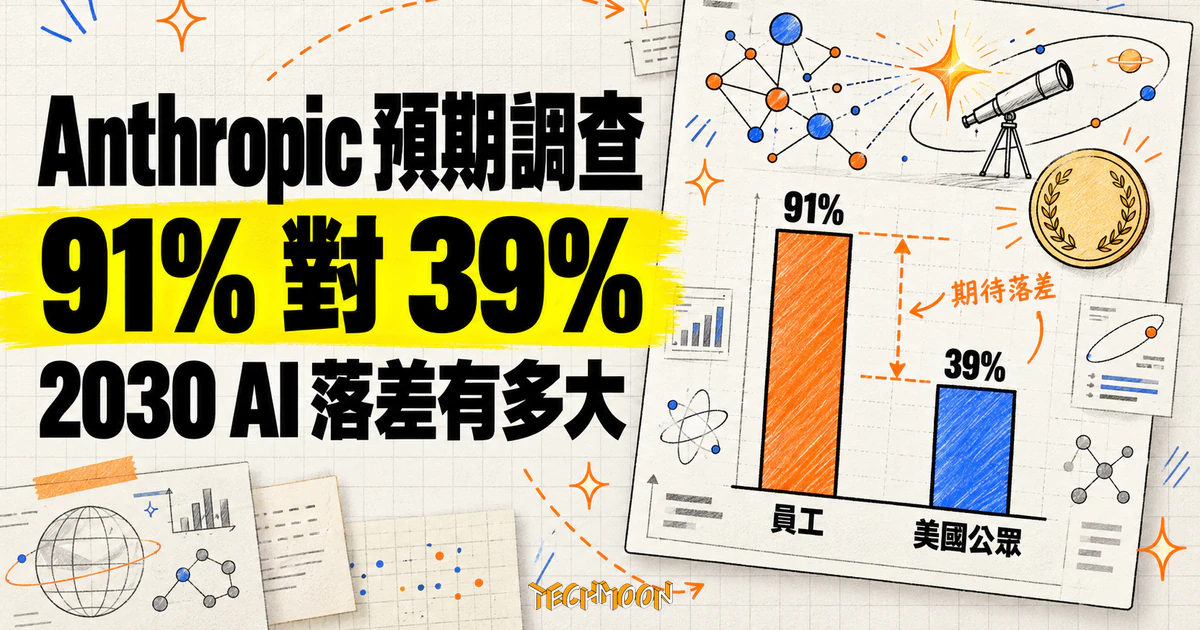
Anthropic 研究部門 10 月 16 日發布 The AI Expectations Gap 報告,用同一份問卷量 10,980 位美國成人與 1,334 位自家員工:2030 年 AI 做出諾貝爾級發現的預期是 39% 對 91%,自家工作可交給 AI 的工時比例是 28% 對 75%,GDP 情境中位數是 5.4% 對 17.1%。更關鍵的發現是兩組人在相同自身暴露下的失業預測幾乎一致,分歧集中在進步速度與親身經驗,9 月複測公眾的諾貝爾級預期已升到 44%。
用 AI 摘要這篇文章:
Anthropic 的研究部門 The Anthropic Institute 在 2026 年 10 月 16 日發布技術報告《The AI Expectations Gap》(台北時間 17 日凌晨上線),做了一件過去沒人做過的事:用同一份問卷,同時量「美國一般成人」與「一家前沿 AI 實驗室全體員工」對 2030 年的預期,再把兩組答案並排。報告全文與摘要都公開在官方研究頁上。
問卷本身在更早的 8 月執行。市調機構 Morning Consult 在 8 月 11 日到 23 日訪問了 10,980 位美國成人,樣本加權到接近全國成人結構;Anthropic 內部民調則在 8 月 9 日到 12 日收到 1,334 位員工的回答,來自公司各部門,未加權。報告由 Sacher、Cotter、Jones、Korinek 與 McCrory 五人署名,同日另發一篇導讀貼文,搭配一份內部就業變化報告一起閱讀。
看到「91% 的 Anthropic 員工認為 AI 在 2030 年前能做出諾貝爾獎級發現,美國公眾只有 39%」這樣的標題,多數人會帶著幾個疑問:91% 是在預言得獎嗎?哪一邊的看法比較準?這些數字對台灣的職場有沒有意義?接下來按報告原文逐項拆開。
問卷的核心設計,是把「AI 做得到」與「企業會不會真的交給它做」分成兩組題目。能力題列出八類任務,從寫例行電子郵件到做出諾貝爾獎級的科學發現,問受訪者「AI 何時能做得跟熟練的專業人士一樣好」,年份選項一路到 2030 年,也包含「永遠做不到」。
幾個關鍵數字都出自這組題目。2030 年前做出諾貝爾獎級發現:美國成人 39%、Anthropic 員工 91%。難度低一階的「設計、執行並發表科學研究」,明年(2027 年)就做得到:員工約九成、公眾 38%。換句話說,91% 量的是「屆時技術上做得到」的判斷,與得獎機率或對科學突破的信心程度是兩回事。
轉到受訪者自己的工作,差距更切身。到 2030 年,AI 能承接自己現有工時的比例:美國工作者平均估 28%,Anthropic 員工平均估 75%。更極端的分布差在尾端:僅二十分之一的美國工作者認為 AI 能做到自己八成以上的工時,員工則有超過一半這樣認為。
讀這些數字前,兩份樣本的體質要先記住。美國成人是線上自願樣本加權,官方腳註明說這排除了不上網的人口,且加權無法修正所有選樣差異;員工端是內部民調、自願填答、未加權,反映的是「這家公司參與調查的員工」的看法,不能代表所有 AI 研究者。未來題還有個細節:美國成人拆成兩半,一半問 2027 年、一半問 2030 年,報告全篇以 2030 年組為主。
如果把焦點從標題數字移開,這份報告最有價值的發現其實是:兩組人的共識比想像中多,分歧集中在很特定的地方。
對「今天的 AI 能做什麼」,兩組判斷相當接近,任務越複雜越接近;八類任務的難度排序,兩組幾乎一致。約四分之一的美國成人與員工都認為,AI 今天已能設計、執行並發表科學研究。真正拉開差距的題目落在未來速度:視任務不同,有 19% 到 40% 的美國成人認為某些任務 AI 永遠做不到,選這個答案的員工至多 2%。最大的落差出現在諾貝爾級題組:91% 對 39%,相差 52 個百分點。
更值得注意的是失業預測。研究員先告知受訪者當前美國失業率約 4.2%,再請他們預測 2030 年。結果呈現一條整齊的梯度:預期自己工作被 AI 承接不到一半的人,預測失業率 7% 到 8%;預期被承接超過八成的人,平均預測 12.2%,高於金融海嘯時的高峰;自身工作每多十個百分點交給 AI,失業預測平均多 0.4 個百分點。而報告明確寫出:放在相同的自身暴露水準下,兩組人的失業預測幾乎一致。
這是整份報告最重要的洞察。員工與公眾並非抱著兩套互相衝突的經濟直覺,他們對「自己的工作被 AI 吃掉多少,就業市場會多痛」的推理方式幾乎相同,差別只在餵進這套直覺的輸入:對進步速度與自身暴露的估計。報告用的說法是,兩組人對勞動市場有相似的理論,不同的只是經驗。
還有一個方向相反的細節:被問到「2030 年因 AI 自動化失業、需要轉換職業的人要多久找到新工作」,員工的中位數答案是 12 個月,美國成人的中位數落在 7 到 12 個月區間。離技術最近的這組,在轉職摩擦上反而略為悲觀。
那 91% 的信心從哪裡來?報告裡另一組題目給了線索:研究員問 Anthropic 員工,「建造一座 2026 年初水準的前沿模型」這件事,今天已經有多少比例由 AI 完成。中位數答案是 51%;到 2027 年底是 80%,2030 年底是 95%。離模型建造最近的研究團隊成員,對今天的估計平均 60%,高於其他部門的 53%。官方在圖註特別聲明,這是員工個人估計,不代表公司的測量或預測。
同日發布的導讀貼文補上了背景。根據搭配的內部就業報告,2026 年 3 月起,Anthropic 內部 AI 代理累積的工作時數已超過人類員工;到 8 月,代理數量約為員工的六倍。初級職缺與技術職的佔比都在下降,工程師採用編碼代理後,單月新增的程式碼行數約為過去的三倍,銷售與法務的人均產出也上升。貼文的結論是:加速之後,瓶頸正在變成人類的注意力,員工花更多時間建造監控代理工作的機制。
這與公司先前公布過的研發量測方向一致:Anthropic 在 8 月公布的研發步調量測裡估計,Claude 已主導內部約 26% 的模型研發工作。把這些放在一起看,員工問卷裡的高預期更像在描述現在進行式,而非押注未來。外部也有對照組:AI 前沿到底擴張多快,是連實驗室負責人之間都還在激烈爭辯的題目。
公眾端也有內部梯度支撐「經驗塑造預期」的解讀。在工作上常使用 AI 的美國成人(約佔五分之一)裡,56% 認為 2030 年前八項任務中至少七項 AI 能做到;全體成人是 41%,從未用過任何 AI 工具的人是 28%,員工則是 96%。常使用者的高預期仍未追上員工,但方向一致。
報告腳註還留了一個會讓數字過時的訊息:9 月 17 日到 24 日,Morning Consult 用同一份問卷複測了 7,613 位美國成人。諾貝爾級發現的期待從 39% 升到 44%,中位數情境的 GDP 成長率從 5.4% 微升到 5.6%。一個月內五個百分點的移動,提示公眾端數字並非固定地形,會隨使用擴散而漂移。
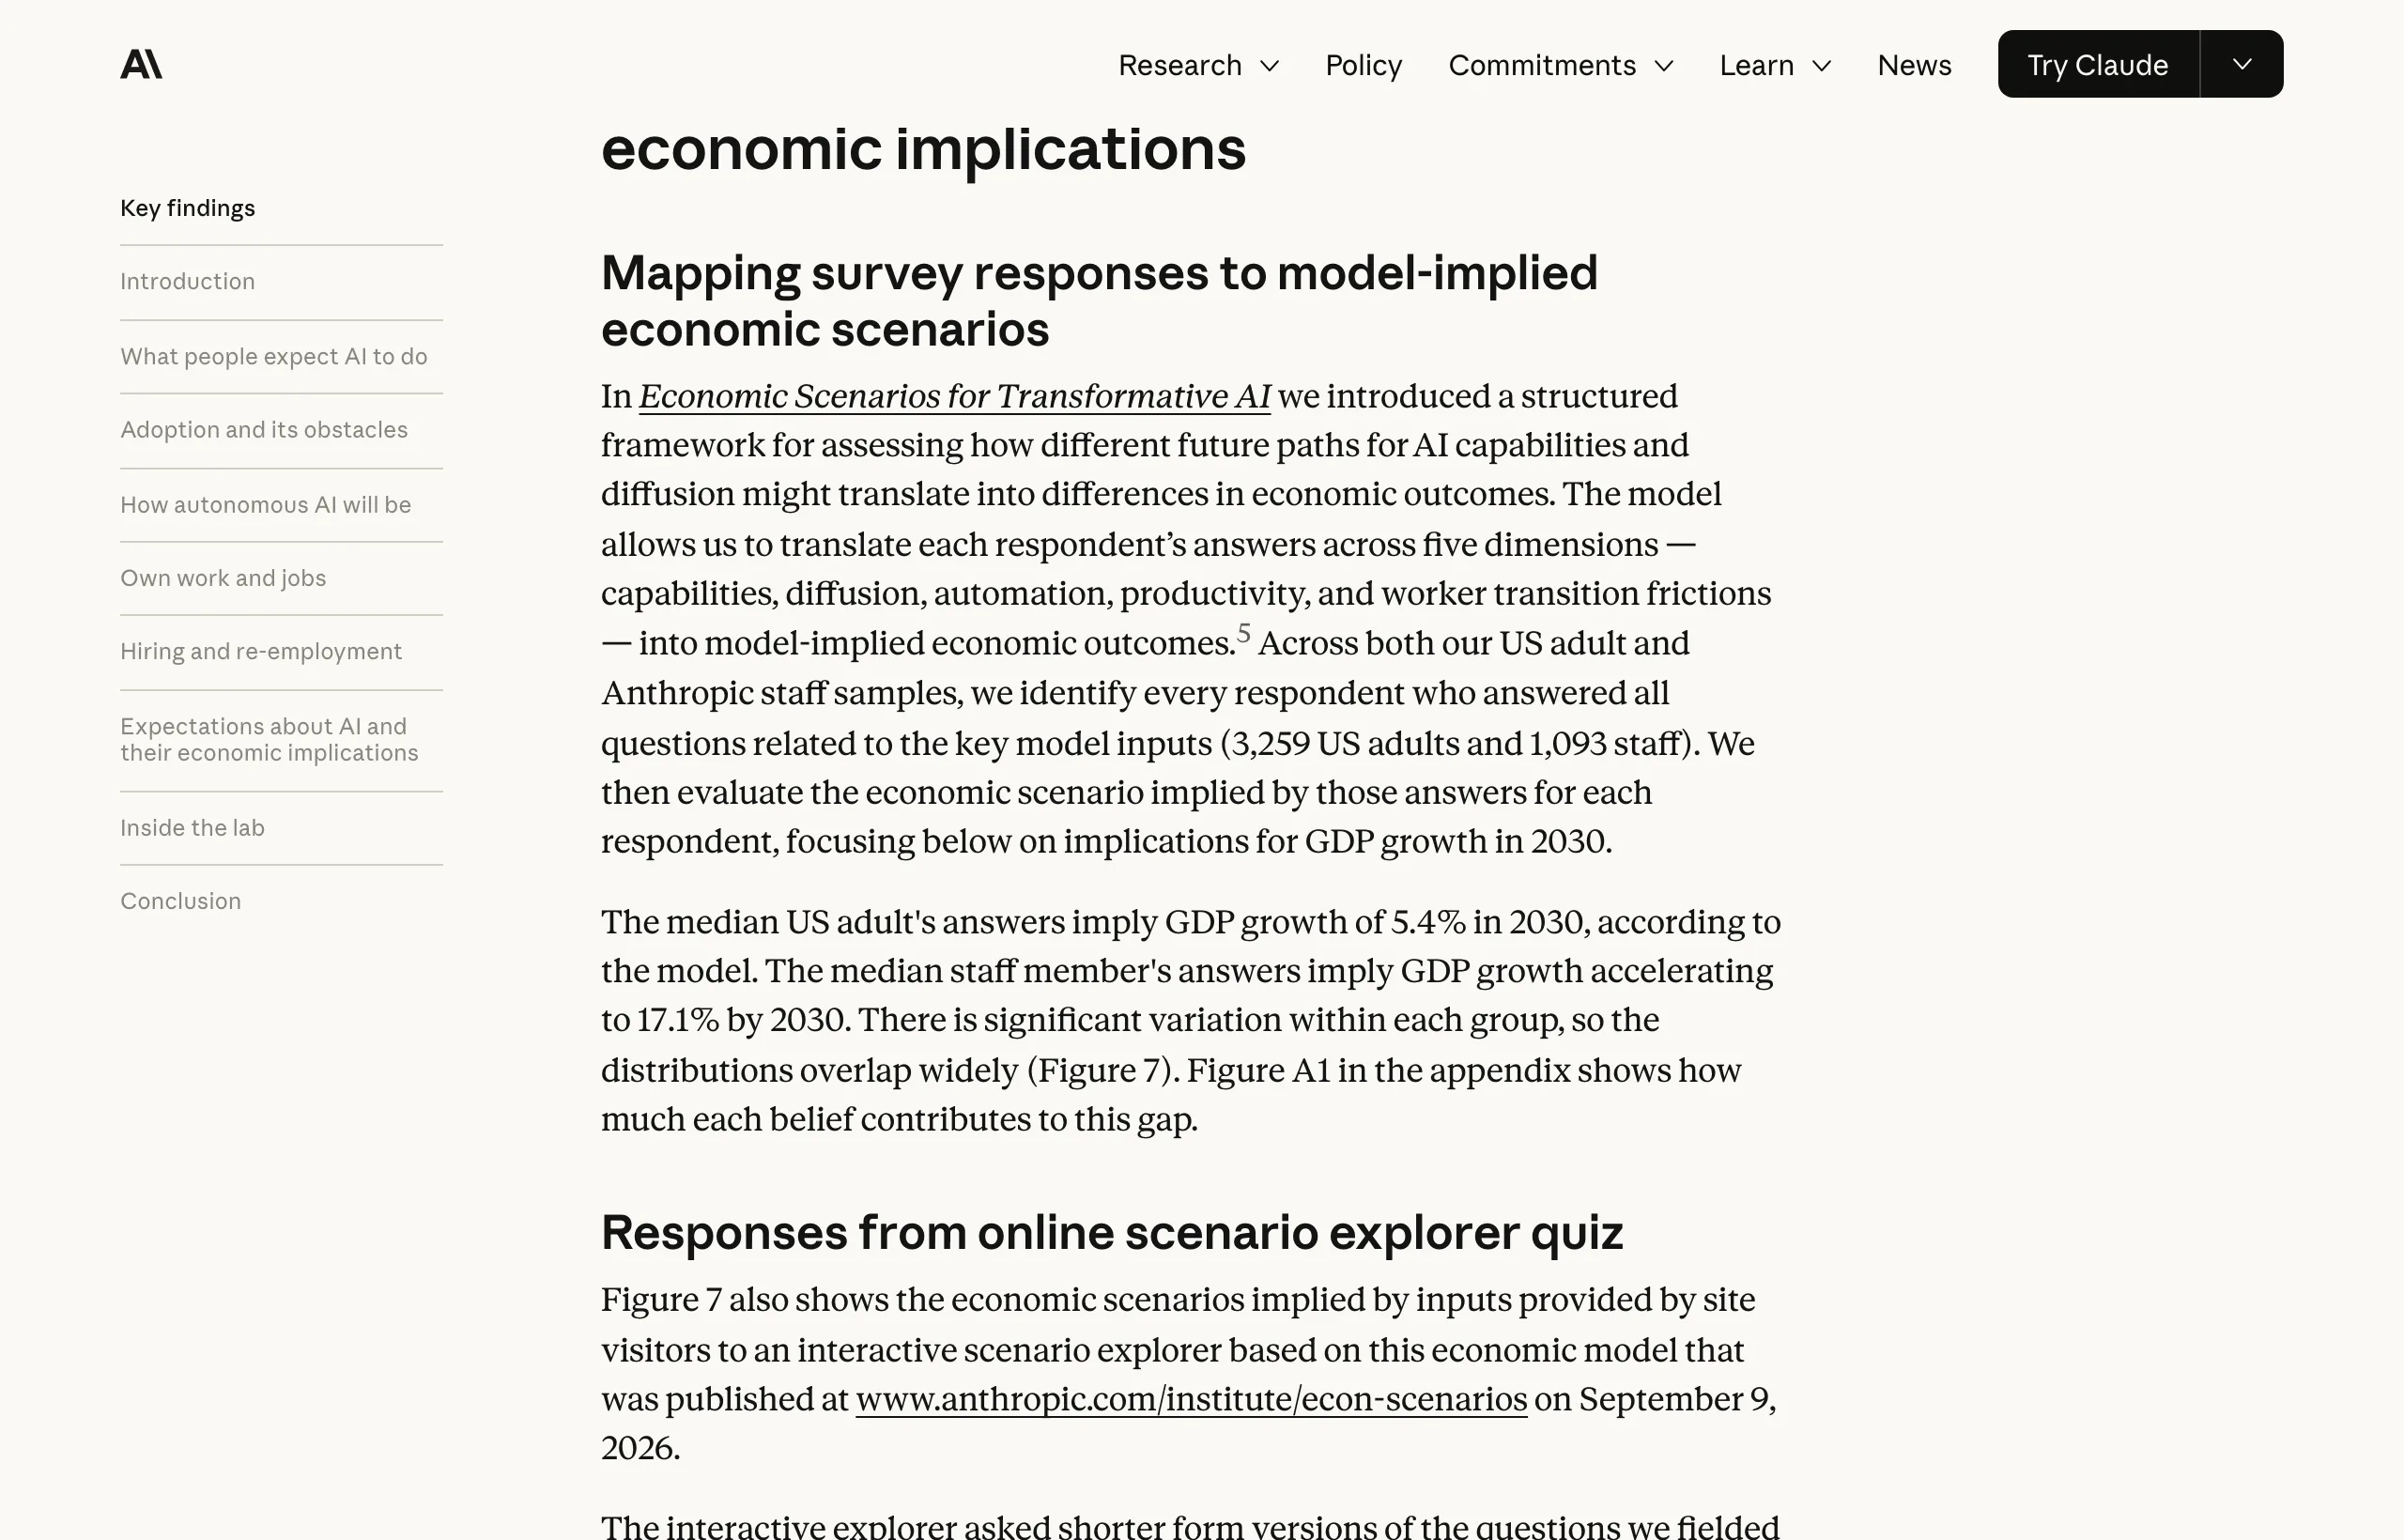
媒體轉述時最容易被放大的是兩個 GDP 數字。把受訪者的答案(完整回答五道關鍵題的 3,259 位成人與 1,093 位員工)逐一代入研究團隊先前發表的經濟情境模型後,美國成人的中位數答案對應 2030 年當年 GDP 成長 5.4%,員工中位數對應 17.1%。員工那組相當於每四年半讓經濟規模翻一次,是歷史上未見的速度。
這兩個數字的正確讀法是「假設的後果」。模型本身設了三個基準情境:溫和(年成長 2.4%)、實質(5.4%)、極端(15.4%),中位數公眾剛好落在實質情境附近。但兩組內部差異都很大,分布大幅重疊;同一套模型,換一組答案就會得出很不一樣的結果。研究團隊另外納入了 23,075 名在情境工具上線 48 小時內自行作答的網站訪客,這群自選樣本對 AI 的興趣明顯偏高,只能當參照,不具人口代表性。
招聘題同樣要小心讀。95% 的員工預期 Anthropic 未來 12 個月人數會成長,中位數預期增幅 66%,27% 預期至少翻倍。官方緊接著聲明:這是內部民調的個人預期,不代表公司招聘計畫。自動化任務與裁減人力是兩種不同的預測,在這家實驗室內部,多數人預期兩者同時成立。
報告把「能力」之外又拆出兩層,各有各的落差。
採用層問的是:在 AI 能勝任的工作任務裡,2030 年前會有多少比例真的由 AI 處理。美國成人預期 42%,員工預期 65%。公眾端另有一題障礙清單,九個選項最多選三個。被選最多的是「客戶偏好跟真人往來」,接著是資料隱私與安全、可靠性,以及法規與責任。有意思的是使用經驗造成的反轉:工作上常使用 AI 的人,把資料隱私與安全排第一的比例(42%)高於其他人(37%),對客戶偏好的在意程度反而略低。
省時層的落差最大。想到一件 AI 很適合的任務(例如摘要文件、起草信件),並把檢查與修正的時間算進去:工作上使用 AI 的美國成人裡,26% 說整件任務只需原本四分之一以下的時間,員工是 59%。反過來看,29% 的公眾使用者說用 AI 花的時間一樣久或更長,員工只有 5%。
這三層分開,是整份調查最可搬移的方法論。相信「AI 能做到」與相信「公司會放行」與相信「真的省到時間」,是三個可以分開檢驗、也常常脫鉤的假設。調查裡最會高估能力的人,未必是最敢交付任務的人。
先畫邊界:這份調查的兩組樣本,一組是美國成人、一組是一家美國 AI 公司的員工,沒有台灣樣本。39%、91%、28% 這些數字對台灣職場沒有直接移植價值,把它們當成「全球共識」或「台灣落後指標」都會誤導。
能搬走的是問卷的骨架。替自己或團隊做 AI 導入規劃時,把預期拆成能力、採用、省時三層各自寫下來:你認為 AI 今天能做哪些事?組織實際會放行哪些?放行之後,來回修正的時間成本是多少?哪一層最不確定,下一步就測哪一層。這比直接抄某一方的人數比例有用得多。
追蹤方式也比預言可靠。挑一件每週重複的任務,留下使用前後的紀錄:完成時間、修正次數、覆核成本。日後再調整自己對 2027 或 2030 的判斷時,手上有自己的紀錄資料,而不是別人家的百分比。若想跟著總體勞動市場的辯論走,Bezos 的 AI 缺工預言與機器人成本研究是同一條討論線上的另一個極端,可對照閱讀。
這份調查的設計無法回答兩組人誰的預測比較接近未來。接近技術可能帶來資訊優勢,也可能帶來選樣與立場偏差,要等實際結果出來才能回頭檢驗。9 月的複測已經顯示公眾數字會移動,之後幾季再測,落差的形狀可能又不一樣。
之後要追蹤也有幾個明確的點:Anthropic Institute 的內部就業報告、持續更新的經濟指數報告、以及 AI 自我改進進度的後續報告。這份調查 9 月已經複測過一次,之後幾季再測,百分比會繼續移動,最新數字以官方研究頁為準。
「實驗室的人比較樂觀」只是標題;真正值得帶走的是把期待拆成能力、採用、省時三層再各自檢驗的方法。你自己落在哪一層最不確定,就從那一層開始補證據。