TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

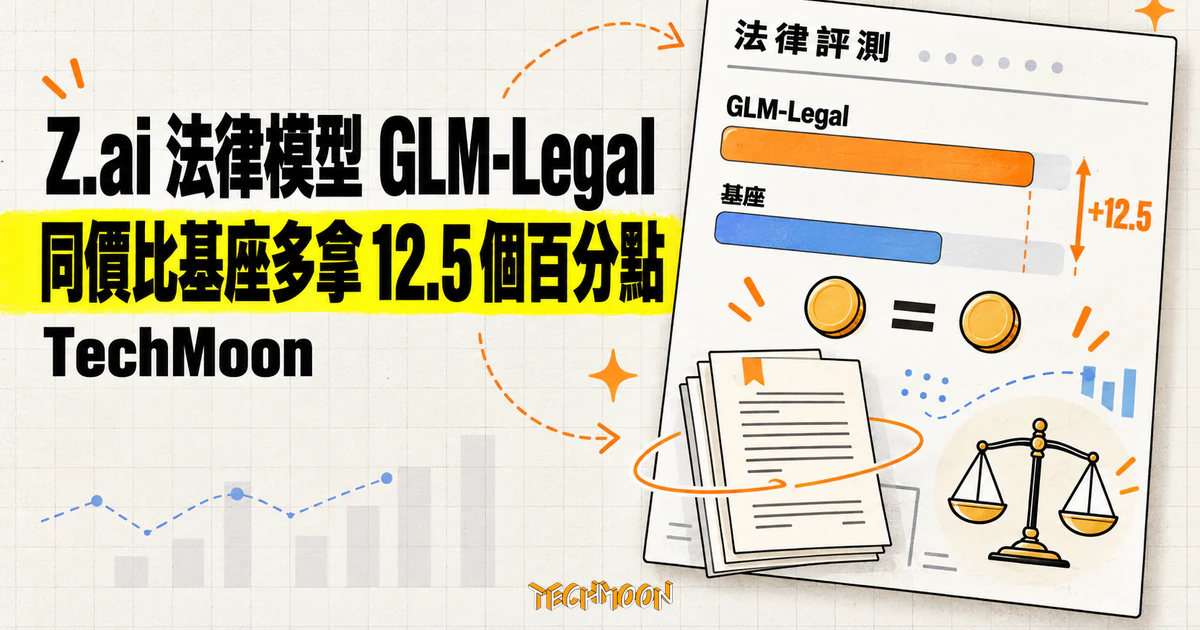
智譜 10 月 12 日發表法律專用模型 GLM-Legal,獨立評測機構 Vals 的榜單讓它與基座 GLM-5.3-Flash 同框對照:19.17% 對 6.67%,相差 12.5 個百分點,與官方宣稱完全一致,輸入輸出牌價也與基座相同,是 Harvey 法律代理基準前十名最便宜的模型。想用它目前只能填表申請 Beta:公開文件、定價頁與 Hugging Face 都還查不到它。
用 AI 摘要這篇文章:
10 月 12 日,智譜(Z.ai)在官方部落格發表法律專用模型 GLM-Legal,基底是自家的 GLM-5.3-Flash,定位的三類工作是合約審查、證據分析與合規研究,官方 X 帳號的宣告落在台北 10 月 13 日凌晨。發表當天,獨立評測機構 Vals 就把它排上法律代理基準第七名,而在同一張榜單的第三十二名,正好就是它的基座:一個 19.17%,一個 6.67%,相差 12.50 個百分點,與官方宣稱的進步幅度完全對上。Vals 登記的牌價也與基座相同,輸入每百萬 token 0.075 美元、輸出 0.25 美元。代價不在帳單上:這個模型目前沒有公開文件、沒有公開定價頁,唯一的取得入口是一張申請表單。
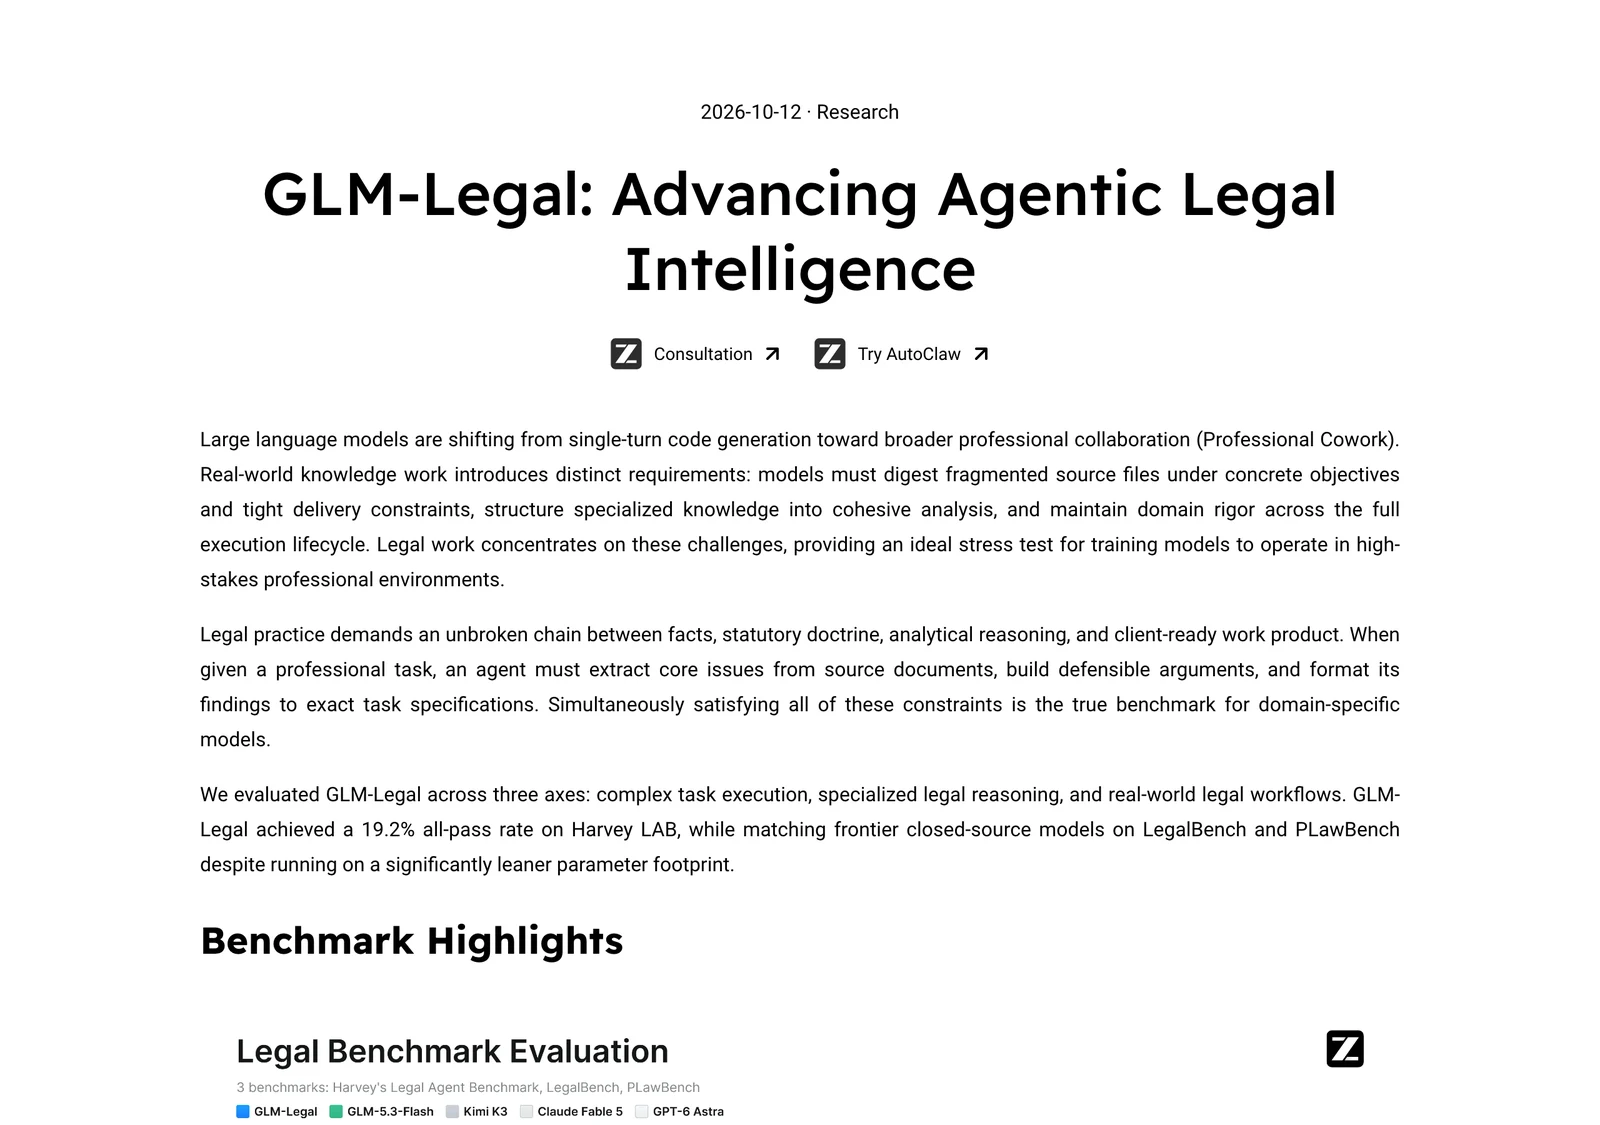
Vals 的 Harvey 法律代理基準(Harvey’s Legal Agent Benchmark)榜單在 10 月 16 日更新,GLM Legal 與 GLM 5.3 Flash 同框列出。官方部落格宣稱 GLM-Legal 拿下 19.2% 的 all-pass rate,比基礎模型提高 12.5 個百分點;Vals 獨立測得的 19.17%,四捨五入就是官方的 19.2%,而它減去基座的 6.67%,正好也是 12.50。模型發布文裡的自報成績常見,連進步幅度都有第三方逐項核對的案例並不多見。
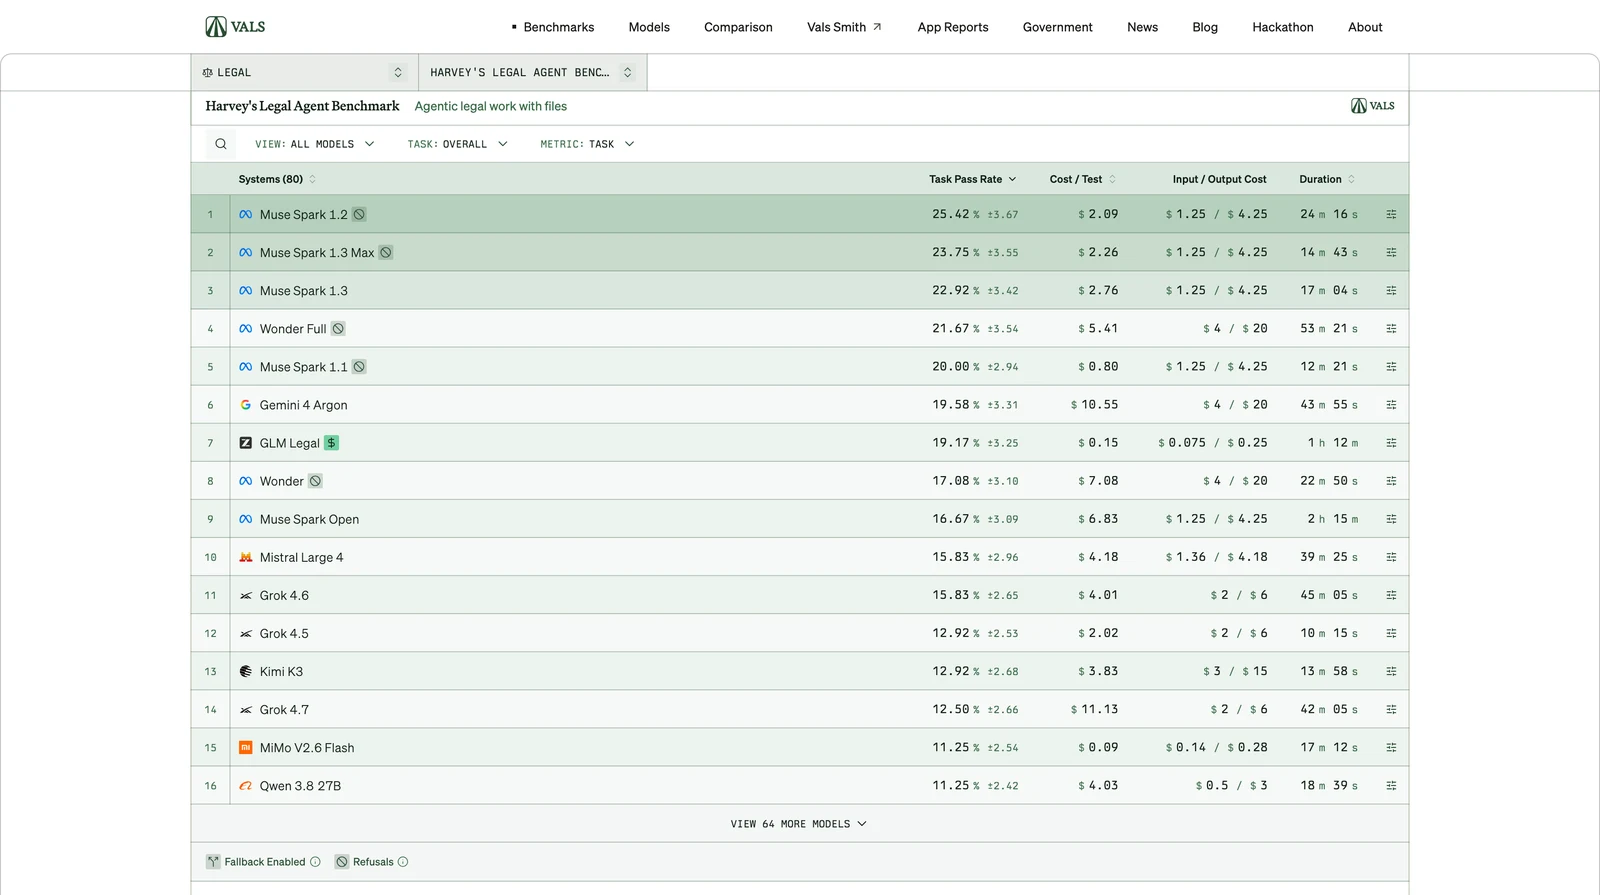
價格欄位說的是同一個故事。兩個模型在 Vals 榜上的輸入輸出牌價完全相同,都是 0.075 與 0.25 美元(每百萬 token)。Vals 另算了每次測試的實際花費:GLM Legal 每次 0.15 美元,是榜單前十名裡最便宜的一個,前十名裡次低的 Muse Spark 1.1 要 0.80 美元,其餘八個落在 2.09 至 10.55 美元。帳單數字背後的結構不難理解:GLM Legal 的單次測試跑了 1 小時 12 分(榜單 Duration 欄記錄),帳單由 token 用量決定,只有單價壓得低的模型才能把單次成本留在這個水位。Vals 模型頁同時登記了 1M 上下文與 128k 最大輸出,評測參數是 temperature 1、top p 0.95、推理等級開到最大,供應商設為 zAI。這些參數跟著分數一起公布,別人要重跑同一套測試時至少有起點可循。
這個分數不是答對率,而是任務層級的整體通過率:官方部落格稱之 strict all-pass grading,一個任務要滿足整組評分條件才算通過。Vals 對這個基準的描述是測試代理能否運用文件、試算表、簡報與檔案系統工具完成法律工作,也就是從讀資料到交出成品的整段流程。
把分數放回榜單就看得出難度:前三名是 Muse Spark 1.2 的 25.42%、Muse Spark 1.3 Max 的 23.75% 與 Muse Spark 1.3 的 22.92%,全榜 80 個模型裡,分數達到兩成的只有五個。最強的模型在四個任務裡也只勉強過一個,GLM Legal 的 19.17% 排第七,與第三名只差 3.75 個百分點,與榜首差 6.25。整個領域都還在起跑段,這個判斷比任何單一模型的名次都重要。對採購端的意思也很直接:就算拿榜首模型,四個任務裡仍有三個會在某個條件上失分,任何交付物都需要專業覆核,差別只在覆核時看的是機器漏了什麼,而不是機器對了什麼。
官方部落格對成績的表述是「涵蓋 24 個執業領域的律所工作流程」,並宣稱在嚴格評分下證實了端到端的任務執行沒有中間退化。24 個領域是官方口徑,外人能核對的只有分數與排名兩件事。
官方對 LegalBench 的說法是「以顯著更精簡的參數量,用頂級封閉前沿模型的水準解析專業合約、併購申報與司法意見」。Vals 實測 86.23%,在 151 個模型裡排第 15,榜首 Claude Fable 5 是 88.56%。
「追平」兩個字需要換算才好判斷。差距是 2.33 個百分點,但價差是輸入約 133 倍(0.075 對 10 美元)、輸出 200 倍(0.25 對 50 美元)。任務如果忍受得了那 2 個百分點,剩下的就全是成本結構的問題,這也是近期模型發表共同的故事線:DeepSeek V4.1 Flash 把快取命中的成本壓到前代的四分之一,GLM-Legal 則是把領域訓練的加價壓到零。Vals 另測了 Legal Research Bench,GLM Legal 得 41.83%、排 24 名,研究型任務的落差比推理型大。
中文法律這條線要分開看。公告對 PLawBench(中文法律情境基準)只給了定性說法:在中文法律諮詢、案件分析與文書起草上追平前沿系統,沒有公布任何分數。官方部落格自己寫明由 Vals 獨立評測的是 Harvey 與 LegalBench 兩項,PLawBench 不在其中。對台灣讀者還有一層:中文法律情境不等於台灣法域。PLawBench 測的是哪個法域的諮詢與文書情境,公告裡沒有細講;簡體語料養出來的法條直覺能不能遷移到台灣的法制與用語,官方資料裡同樣沒有答案。真要測,與其問它中文流不流利,不如直接餵一份台灣的合約與往來信件,看它引用的是哪個體系的條文與救濟途徑。
智譜公布的方法學分成兩段,以下都是原廠自述。中期訓練擴大高品質法律語料的量,讓模型在密集的領域上下文裡學法律概念、成文法規與解釋框架;後訓練用強化學習,在數萬個擬真法律環境裡練習規劃分析、推進工作流程,並在具體限制下產出交付物。
比較特別的是訓練目標裡包含 harness,也就是模型外圍的工作架構:整理任務背景、連接工具、把執行結果送回模型。公告形容兩者是鎖定步伐共同迭代,訓練中冒出的邊界案例會指出架構瓶頸,架構調整後又讓模型在更真實的執行限制裡練習。這套敘述解釋了法律代理為什麼要把讀檔、修改文件、標示來源整條鏈納入訓練範圍,問答只是其中一環。原廠另列了四個生產端驗收問題:重大議題與邊界案例是否都處理到、論證與引用是否站得住、交付物是否貼合任務簡報、下游團隊能否直接接手而不需人工重做。這四問把「看起來不錯」換成可檢查的訊號,也剛好是申請到 Beta 之後可以照抄的驗收清單。方法學自述的效果只能由榜單間接反映,這條界線在申請測試前要先放在心裡。
智譜今年在模型基礎設施上動作不斷,九月才發過自建推理基礎設施的技術報告,GLM-Legal 是這條產品線跨向垂直領域的新嘗試。
公告裡附了三組 GLM-5.3-Flash 對 GLM-Legal 的對照示範,全部是原廠展示,不是實測結果。
合約審查的任務是換軟體服務商時檢查終止與交接條款。基座的答案是通用建議:縮短通知期、要求返還資料與已付款的交付物。GLM-Legal 給的是可直接套用的修訂:便利終止的通知期從 60 天改成 30 天、智財保密與資安違約拿掉補救期讓客戶可立即終止、要求返還所有交付物與進行中的工作(無論是否已付款)、再加上最長 90 天的轉換協助。Z.ai 強調這些修改會透過 AutoClaw 平台寫進 Word 文件的追蹤修訂與註解,覆核者看得到每一處改動。
證據整理的任務是從 40 份軟體專案爭議文件裡找進度說明的矛盾。基座版的答案也抓到了 60% 與 41% 的落差,但結論停在「這些文件可能支持客戶的主張,建議再查報告與請款紀錄」。GLM-Legal 多走了兩步:把 9 月 30 日對客戶報告的「進度 60% 上軌道」,對上 9 月 8 日內部警告「里程碑無法誠實達成」與內部快照的約 41%,再連到執行長「壓下風險、繼續請款」的指示,每一項都附文件編號(BR-000024、BR-000014 等),組出隱匿理論的初步骨架,同時保留完成度口徑與其餘要件的查核空間。這種輸出的價值在於可勾稽:每個主張都能回到編號文件。
合規研究的任務是網站在新加坡、馬來西亞、印尼上線前的隱私規劃。GLM-Legal 的輸出是帶優先級的工作清單:英文與印尼文隱私聲明、非必要分析與廣告改採 opt-in 同意並留存紀錄、行銷授權與註冊分離、退訂請求進入抑制名單、把雲端與支付等廠商對應到資料落地市場,並附上三國法條出處(SG PDPA s26、MY PDPA s129、ID PDP Law Arts 55-56)。
三組示範的共同點是交付物有形:修訂、對照表、清單,而非一段總結文字。但示範是官方挑的案例與任務假設,不能推論成一般案件的水準保證。
時間點要先講清楚。官方部落格對 AutoClaw 的整合用的是未來式寫法,You’ll soon be able to 是原句;AutoClaw 官網目前首頁標題主打的是 GLM-5.3-Flash Now Live。GLM-Legal 進 AutoClaw 是預告,法律工作流進 Word 的那支示範影片是願景展示。AutoClaw 本身是 Z.ai 的桌面代理平台,支援 Windows、macOS、iOS 與 Android 並另提供 Linux 下載,可切換 GLM 與 DeepSeek 系列模型,內建辦公、資料、網頁與自動化類技能五十餘項,也標榜能把大型工作拆給多個代理平行處理,或用目標模式讓它自己規劃步驟做到交付。
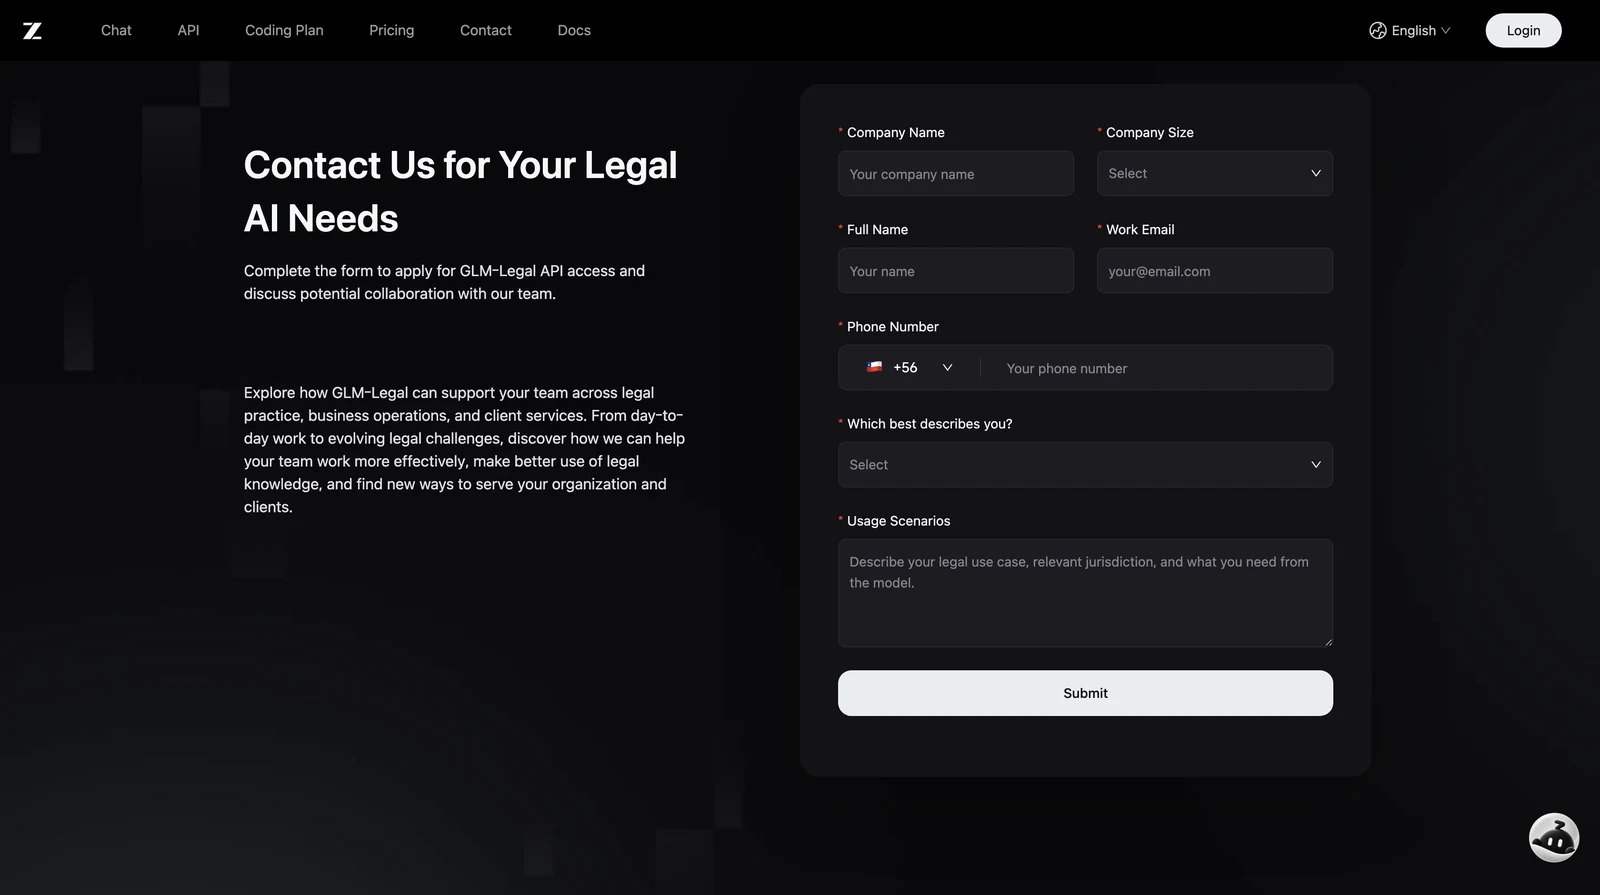
API 端的現況是一道申請牆。Beta 服務的入口是 z.ai/consultation/legal 的表單,要填公司名稱、公司規模、姓名、工作信箱、電話、身分類別與使用情境,表單點名的邀請對象是律所、法律科技公司、企業法務與獨立執業者。公開文件端查無此物:docs.z.ai 的文件索引與定價頁都沒有 GLM-Legal,模型文件頁直接 404,對照基座 GLM-5.3-Flash 有完整文件與公開 API,落差明顯。
權重端還有一個待解的矛盾。Vals 模型頁把 GLM Legal 標記為 open-weight(開放權重),但 Hugging Face 的 zai-org 帳號最新條目停在 8 月 25 日的 GLM-5.3 系列,搜尋 GLM-Legal 沒有任何結果,公告裡也沒有附權重下載連結。基座本身是 MIT 授權、320B 總參數與 18B 啟動參數的混合專家模型,原生支援圖文輸入;Vals 登記 GLM Legal 只接受文字輸入,圖片、影片與檔案都不支援。領域版相對基座收窄了輸入範圍,也收窄了取得方式,權重會不會釋出、何時釋出,官方沒有給時程。對照其他把開放權重當主打的新模型,這裡的安靜反而是需要留意的訊號。
在法律科技團隊的位置上,這是一個值得填表測試的候選:第三方榜單驗證過的領域增益、與基座相同的牌價、1M 上下文,都是實際的籌碼。拿到資格後的驗收,官方示範已經給了方向:先用自己的文件檢查引用可不可勾稽、該處理的問題有沒有漏、修訂能不能直接進工作流,不要拿示範影片當基準。
這則新聞有幾個會過期的點,列成追蹤清單:Vals 三張榜單持續更新,名次與分數會動;Hugging Face 何時出現 GLM-Legal 條目;docs.z.ai 何時長出文件與公開定價;AutoClaw 何時真的裝上 GLM-Legal。任何一項變動,上述判斷都要跟著重算。至於開放權重模型的下一步佈局怎麼影響法律垂直領域,等第一批權重或價格落地後會更清楚。