TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Oracle 與 Google 於 2026 年 10 月 27 日宣布 Google TPU 將進駐 Oracle Cloud Infrastructure,是 TPU 首次在 Google 以外的超大規模雲端提供。訓練用的 8t 與推論用的 8i 都在規劃內,2027 日曆年開始、多年期間擴展;價格與區域尚未公布,現在值得做的是把工作負載分流與資料位置盤點好,放進 2027 年的運算評估。
用 AI 摘要這篇文章:
2026 年 10 月 27 日,Oracle 在拉斯維加斯的 Oracle AI World 會場與 Google 共同宣布:Google 的 TPU 加速器將透過 Oracle Cloud Infrastructure(OCI)提供,這是 TPU 第一次出現在 Google 以外的超大規模雲端平台。時間表寫得很保守:2027 日曆年開始提供,之後在多年期間逐步擴展。換句話說,公告日與能夠下單的日子是兩件事,現在這是一份路線圖,不是一個可以馬上租用的服務。
這件事的定位,比時間表更值得看。過去十年,Google 的自研 AI 晶片幾乎只存在於 Google 自家體系內,外部團隊想用 TPU,就得把工作負載搬到 Google Cloud。這次合作代表這條界線第一次被跨過:晶片留在自己的軟體生態裡,但機房換成別人家的。對企業採購來說,AI 運算的比較單位正在從「選哪一家雲」慢慢轉向「選哪一種架構、放在哪一個場域」。
先看兩邊官方怎麼定位這次合作。
Oracle Cloud Infrastructure 總裁 Mahesh Thiagarajan 的說法是:「不同的 AI 工作負載有不同的運算需求。把 Google TPU 帶進 OCI,讓客戶在一個雲端內就能取用多種領先的 AI 運算架構,這種選擇權讓客戶能依每個工作負載在效能、輸送量與成本上的需求,挑到對的基礎設施。」
Google 這邊由 AI 與基礎設施部門的資深副總裁暨技術長 Amin Vahdat 表態:「下一世代的 AI 將需要多樣化的運算。TPU 為高需求的訓練與推論負載提供了一個強大且專門打造的選項。把 Google TPU 帶進 OCI,會讓更多組織取用到這項技術,在建立與執行最複雜的 AI 應用時擁有更大彈性。」
兩段話合起來看,分工很清楚:Google 出晶片與軟體生態,Oracle 出機房。新聞稿明寫,OCI 將提供部署 TPU 所需的電力、散熱與資料中心網路。對 Oracle 來說,引進別家的旗艦 AI 晶片,補的是自家 AI 運算組合的缺口;對 Google 來說,這是資料中心級 TPU 第一次走出自家雲端、成為跨雲輸出的產品線,而非 Google Cloud 的獨佔賣點。Google 在新聞稿自述投入客製 AI 晶片設計已超過十年;更早之前,Google 也已經計畫把 TPU 衛星送上軌道,測試太空資料中心的可行性。這一步等於把十年的累積拿去別人的場子變現。
把這次公告當成一個 diff 來看會更精確。
變動前:TPU 是 Google Cloud 的專屬產品,外部使用者想用,就只能用 Google Cloud 這個入口。變動後:2027 日曆年起,OCI 的客戶也能在自己的雲端服務組合裡選到 TPU。新聞稿的原文措辭是,這是 Google TPU 首次在 Google 以外的「超大規模雲端平台」提供,OCI 將是 Google 以外第一個提供 TPU 的超大規模雲端業者。
這個「首次」的範圍值得逐字看。公告掛保證的是「Google 以外的超大規模雲端平台」這個層級,講的是雲端租用這種服務形式;它不能自動延伸成「Google 的 AI 晶片技術第一次外流」之類的全稱命題。對讀者而言,實際的意義可以收斂成一句話:雲端租用 TPU 這件事,2027 年起多了一個 Google Cloud 以外的入口,僅此而已,其他延伸都超出公告的措辭。
時間軸也有兩層要分開。公告本身發布於 2026 年 10 月 27 日,Oracle 的官方帳號同日也在 X 上發文確認;但服務開始提供的時間是 2027 日曆年,而且只是一個年度區間,沒有月份,之後還要「在多年期間依客戶需求逐步擴展」。從公告到能夠評估實際方案,中間至少還隔著一段不短的等待期。
新聞稿末端還有一句多數轉述會漏掉的自我設限:所有資訊以 2026 年 10 月 27 日為準,Oracle 不承諾後續更新,與未來計畫相關的內容都屬於前瞻性陳述,實際結果可能因風險與不確定性而不同。這段法律文字對讀者的用途很實際:2027 日曆年與多年擴展都是計畫語氣,把它當成確定的供貨承諾寫進預算,風險自負。
這次計畫引進的是 Google 第八代 TPU,而且一次給了兩種架構:TPU 8t 針對訓練,TPU 8i 針對推論。要理解這個分流,得先知道兩種工作在吃什麼資源。
訓練是把大量資料餵給模型、反覆調整參數的過程,動輒連續跑上數週,重點在大量晶片之間的互連頻寬與整體輸送量;推論則是已訓練好的模型接收輸入、即時產生回答的過程,聊天機器人回一句話、文件摘要跑一遍,都是推論,在意的是延遲、同時服務人數與每次請求的成本。同一顆晶片兩種工作都能做,但長時間下來,把訓練與推論分別放在為其優化的架構上,成本結構通常差很多。這也是為什麼 Google 這一代直接拆成兩款產品。落實到評估,兩種負載該看的指標也不同:訓練端看完成固定訓練量要多久、中斷後能不能從檢查點續跑;推論端看第一個字多久出來、同一時間能撐多少併發請求、每千次請求成本多少錢。之後拿到任何報價,用這兩組指標去問,比看晶片型號有用。
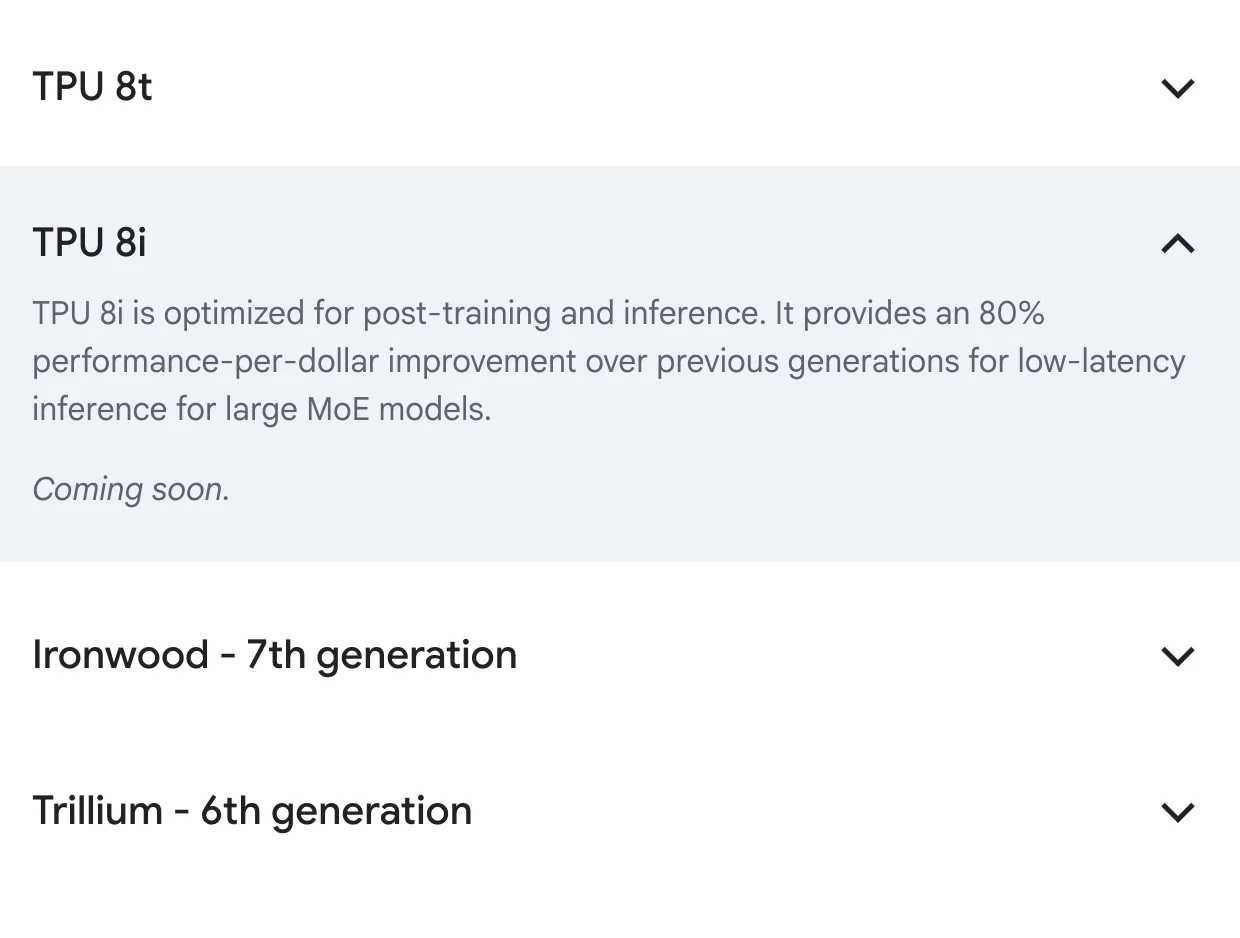
官方對兩款晶片的定位與數字如下。8t 用於大規模預訓練與嵌入(embedding)密集的工作負載,Google 的 TPU 產品頁寫明單一超級 Pod 規模可到 9,600 顆晶片;新聞稿則宣稱 8t 每個 Pod(多顆晶片組成、共同執行同一份訓練工作的部署單位)的運算效能較前一代接近三倍,並能把前沿模型的開發週期從數月縮短到數週。8i 針對後訓練與推論,產品頁給的數字是針對大型混合專家模型(MoE)的低延遲推論,每美元效能較前幾代提升 80%;新聞稿對它的描述是為「多個專門代理的反覆工作」而設計。這些效能與週期數字都是官方宣稱值,來自特定代際的比較條件,目前沒有任何第三方在同一條件下的實測可以對照。
至於用途範圍,新聞稿列得相當完整:大模型訓練與後訓練,涵蓋稠密模型與 MoE 架構,以及用於推理、代理式應用與長上下文的正式環境推論。換句話說,官方把這次合作定位成全生命週期的運算選項,而不只是推論端的補貨。
翻 Google Cloud 自己的 TPU 產品頁,會發現一件公告裡沒有張揚的事:TPU 8t 與 8i 在 Google 自家雲端上的狀態,目前都還標著「即將推出」,尚未正式供貨。現在在 Google Cloud 上真正能租到的 TPU,是第七代的 Ironwood 與第六代的 Trillium;產品頁給 Ironwood 的規格是每個 Pod 9,216 顆液冷晶片,以及相較 Trillium 每顆晶片四倍的效能。
這對讀者的判讀有兩層意義。其一,2027 這個時間點對上的不是「既有產品搬家」,而是下一代晶片的供應節奏:OCI 首波拿到的,很可能就是 8t 與 8i 這批連 Google 自家客戶都還在排隊的新晶片。其二,作為對照,Google 在自家雲端的規模宣稱是單一叢集最多可到一百萬顆 TPU 晶片,而 OCI 端會部署到多大規模、哪些配置先上,公告完全沒有給數字。首波規模是未知數,評估時不宜假設兩邊對等。
還有一層採購上的推論:如果團隊現在就要比較運算架構,能夠實際取得與計價的基準,只有 Google Cloud 上已正式供貨的 Ironwood 與 Trillium,以及 OCI 現有的 GPU 產品線。等到 2027 年 TPU 真的出現在 OCI,屆時對手的 GPU 也會前進一到兩個世代,所以這份公告改變的是「選項會變多」這個方向,而不是任何一組可以現在寫進投資報酬試算的數字。
受影響最直接的是 OCI 的既有與潛在企業客戶,特別是資料與核心系統已經放在 Oracle 生態內、未來一到兩年要規劃大模型訓練或大規模推論服務的團隊。對這群人來說,2027 年起的評估清單上會多一個非 GPU 的選項,而且不必先把資料搬出 Oracle 就能碰到 Google 的晶片架構。大型組織的運算採購多半跟著年度預算週期走,2027 年要上的服務,前置評估通常提前一年以上就開始,這也是為什麼一份還不能下單的公告仍然值得放進雷達。
反向也要講清楚。已經在 Google Cloud 上使用 TPU 的團隊,這次公告沒有改變任何現有服務;在 OCI 上使用 NVIDIA GPU 的客戶,既有的 GPU 產品線照舊。個人開發者與小型團隊短期內無感,因為 TPU 產品線本來就以大型工作負載為主,這次公告的對話對象也是企業採購,現在既沒有價格也沒有可下單的介面。
至於這項服務何時推進到亞太,答案目前是未知:公告沒有公布任何可用區域。如果訓練資料或服務對象有資料落地與跨境傳輸的限制,這些本來就該在評估清單上,區域資訊出來之前不必先做任何假設。
從公告事實能推出的實際影響,大概有三個方向,這裡明確標示為推論,不是官方說法。
一是架構選項的密度。過去在 OCI 內大型 AI 運算的主流選項是 GPU,TPU 進來之後,同一份資料、同一個帳務關係下可以比兩種架構,評估與議價的基底都變厚。Thiagarajan 那句「在一個雲端內取用多種領先的 AI 運算架構」,講的就是這個賣點。二是對 GPU 依賴的稀釋訊號。對必須控制供應風險的採購單位來說,多一個超大規模層級的替代架構,方向上是分散風險;但稀釋到什麼程度,取決於價格、區域與供應量,這些都還沒公布,現在談對市占的影響為時過早。何況需求端成長的規模感相當極端,先前貝恩的估算把 AI 擴建倒推成六兆美元等級的年收入帳單,供給側多一個入口,消化的是那個等級的需求。三是對 Google 自身的意義:這一步讓 TPU 的營收出口不再只綁在 Google Cloud 的成長上,與 Google 高層近期對算力擴張優先的表態方向一致,先前 Pichai 受訪時就說過雲端事業隨時願意為前沿 AI 放棄短期營收,算力會優先留給 DeepMind 與需求端。
需要保守看待的地方也一樣明確:跨雲部署不等於把模型搬過去就能跑。框架支援、版本相容、資料位置的傳輸時間與費用、帳號權限與監控體系的銜接,每一項都可能吃掉紙面上的效能優勢。這些細節在 OCI 端的正式文件出來之前,全部無法驗證。
多數讀者不需要做任何事。這是路線圖階段的公告,沒有期限、沒有強制變動、也沒有可下單的產品。
如果你在 OCI 企業客戶的規劃範圍內,現在值得做的只有一件:把團隊的工作負載分流盤點清楚,哪些是長時間的訓練、哪些是回應速度敏感的推論、各自的資料放在哪個雲哪個區域。這份清單在 8t 與 8i 的規格與價格公布時,就是能不能立刻評估的分水嶺;盤點本身不依賴任何未公布資訊,今天就能做。
如果你的重心在 Google Cloud,關注點是 8t 與 8i 何時從「即將推出」轉為正式供貨,那會是下一代晶片供應鏈就緒的訊號,也約略指向 OCI 端開放的節奏。至於採購與架構決策者,建議把對 Oracle 的具體問題列出來:可用區域、配置規模、計價方式、支援與服務等級由誰負責。這些問題在公告裡都沒有答案,哪一天文件補齊,哪一天才能做真正的比較。
截至目前,這次合作沒有公布的項目包括:OCI 端的價格、可用區域、配置與規模、正式上線月份、Oracle 與 Google 之間的支援與服務等級分工,以及 OCI 版本的配置是否與 Google Cloud 完全相同。任何一項公布,都會讓這份未知清單改寫。
這是一篇有保存期限的報導。建議的回查時點有兩個:Oracle 發布 OCI 端 TPU 的定價與區域文件時,以及 Google Cloud 宣布 TPU 8t 或 8i 正式供貨時。兩個訊號任何一個出現,這篇的評估建議就該跟著更新一次。