TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

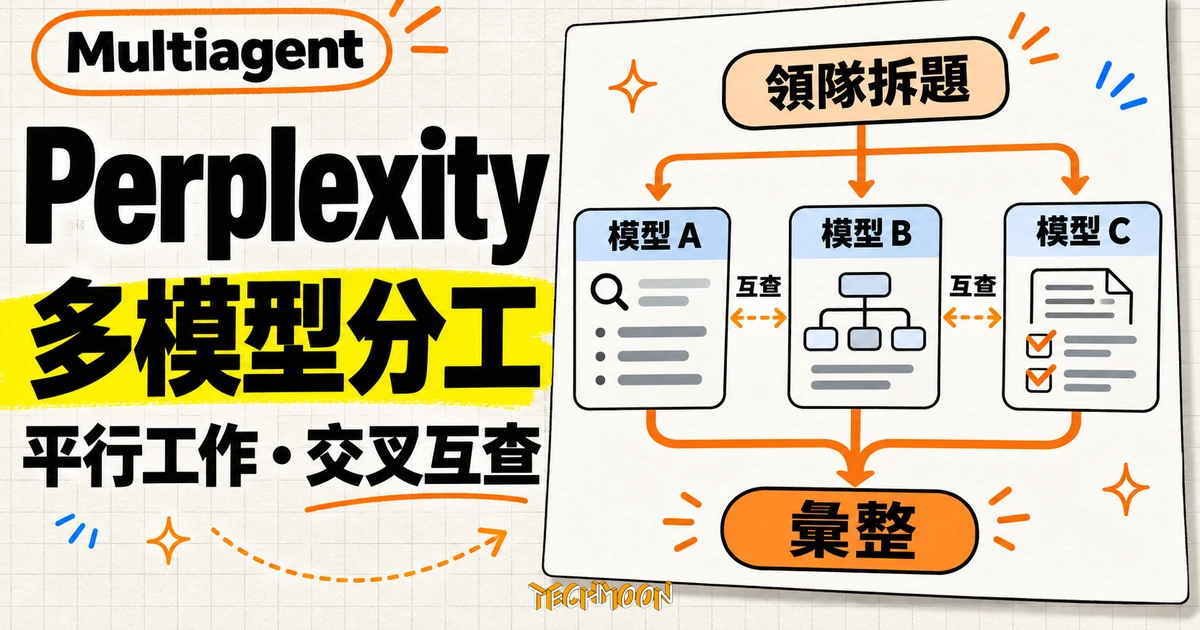
Perplexity 於 2026 年 11 月 17 日在 X 連發五則貼文並同步更新官方部落格,為 Computer 與 teammates 推出 Ultra 之上的新工作強度 Multiagent:領隊代理拆題,不同前沿模型的代理平行工作、互享發現並互相查核,領隊最多可指派 16 個代理。官方提醒它非常耗用點數,而基準數字同時顯示分數最高的混合團隊每輪成本反而低於四份領隊模型副本。
用 AI 摘要這篇文章:
Perplexity 在 2026 年 11 月 17 日(台北時間 18 日凌晨 0 時 28 分起)於 X 連發五則貼文,並同步更新官方部落格,推出 Multiagent:Computer 與 teammates 的新工作強度。一句話描述這個功能:使用者交辦任務後,領隊代理把題目拆成子任務,交給跑在不同前沿模型上的多個代理平行處理,代理之間直接交換發現、互相查核,最後由領隊把所有成果整合成一份答案。它排在既有最高段位 Ultra 之上,官方定位給「最複雜的工作」,並且明白提醒:非常耗用點數,只留給最重要的任務。開放範圍是網頁版的 Max 與 Enterprise Max 訂閱者,手機與桌面版列為即將推出。
發布的節奏本身就是資訊。UTC 時間 16:28:32 到 16:28:48 之間,Perplexity 官方帳號在 16 秒內連發五則貼文,依序交代功能定義、成本提醒、Terminal-Bench 4.1 成績、兩個基準的成本與時間數字;38 分鐘後再補一則說明可用範圍與入口。官方部落格同日上線標題為 Introducing Computer’s Multiagent effort level 的說明文,把機制與使用建議寫得更完整;官宣貼文另附一支約 40 秒的宣傳影片。
要看懂這次改了什麼,得先回到九月的地板。2026 年 9 月 Perplexity 為 Computer 推出努力程度滑桿,四段設定從 Light、Standard、High 到 Ultra,由系統為每段挑選模型與推理深度;當時的結構裡,無論選哪一段,都是一個領隊代理規劃任務、把部分工作委派給支援代理,而支援代理只向領隊回報。Multiagent 在這個階梯上往上加了一層:同樣有領隊,但代理之間直接分享發現、互相檢查對方的工作,並共同承擔交付內容。用官方部落格的話說,這讓 Computer 能從多個角度檢視複雜問題,在彙整之前先找出互相衝突的假設;Ultra 適合需要測試多種做法的開放式問題,Multiagent 適合子部分互相關聯、可以平行處理的大型交辦,例如資料室盡職查核或多情境財務預測。
同一天稍晚,Perplexity 另外發表了把模型路由做成 API 的 Orchestrator,兩者是獨立的事件:一個改 Computer 裡的工作強度,一個把多家模型包進統一 API。
依官方部落格,Multiagent 的預設編制是 Claude Fable 5.2 擔任領隊,負責規劃任務並分工;Claude Opus 5.5、GPT-6.1 Sol、Gemini 4 Carbon 三個模型跑支援代理。使用者可以在提問裡直接寫明想用的模型,不必另外找設定頁;Fable 5.2 與 GPT-6 Astra 只在使用者點名、或任務某一部分需要時才加入支援行列。
規模上有明確上限:領隊最多可指派 16 個代理,自己也同時分擔一部分工作。任務進行中,代理互相溝通並協調對共享檔案的編輯,官方舉的例子是財務模型裡一個代理更新了營收假設,會通知負責估值分析的代理採用新數字。追問時,領隊告訴受影響的代理哪些條件變了,團隊接著既有進度往下做,不用整批重跑;畫面上看得到每個代理跑的是哪個模型,停止執行緒等於整隊停工。
這些安排讓「多模型」停留在任務層:使用者面對的仍是同一個對話視窗,由領隊當單一介面彙整,省下手工拼接多份報告的工序。代價同樣清楚,最後答案畢竟出自領隊的合併,子任務之間的重要分歧可能在摘要時被壓掉,需要保留多方觀點的任務,最好在題目裡明確要求列出未解決的矛盾與各自依據。
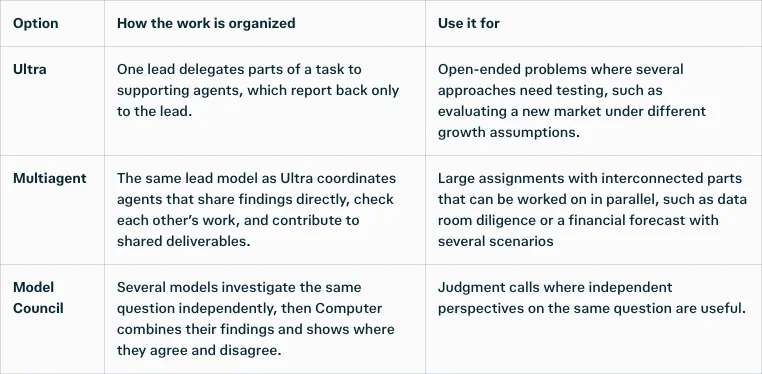
官方部落格用一張對照表把 Ultra、Multiagent 與 Model Council 分開:
| 選項 | 工作怎麼組織 | 適合的任務 |
|---|---|---|
| Ultra | 一個領隊把任務分派給支援代理,支援代理只向領隊回報 | 需要多種做法交叉測試的開放式問題,例如在不同成長假設下評估新市場 |
| Multiagent | 與 Ultra 同一種領隊模型,協調的代理互相直接分享發現、查核彼此的工作、共同產出 | 子部分互相關聯、可平行處理的大型交辦,例如資料室盡職查核或多情境財務預測 |
| Model Council | 多個模型就同一個問題各自獨立調查,再由 Computer 彙整相同與相異之處 | 需要獨立觀點彼此對照的判斷題 |
差異的重點在資訊流向:Ultra 的支援代理看不見彼此;Multiagent 的代理共享線索,買的是交叉查核;Model Council 刻意保持獨立,買的是不受彼此影響的觀點。同一個問題想被「一起查」還是「各自查」,對應不同選項,這張表把它變成可以照著挑的三欄。
Terminal-Bench 是公開的終端機任務代理評測,官方網站有自己的排行榜,題目設計讓代理在終端機環境裡完成多步驟工作;Perplexity 這次使用的版本標示為 4.1。官方公布了兩個基準的測試結果,實驗設計值得先看清楚。Terminal-Bench 4.1 上,五個前沿模型(Gemini 4 Carbon、Claude Fable 5.2、Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol)分別以單一代理、兩份相同副本、四份相同副本,以及帶領混合模型四人團隊四種形態受測。這組對照把兩種變因拆開:多幾份人手的幫助,以及換一批模型組合的幫助。如果只拿四個代理跟一個代理比,改善究竟從人數來還是從組合來,會說不清楚。
分數結果:每個混合團隊的成績都高於同一領隊的單獨作業與相同副本形態。Gemini 4 Carbon 領軍的混合團隊拿下 0.727,是全部組態裡的高標;與各自的四份副本相比,混合團隊的提升幅度落在 +0.008(GPT-6 Astra 領隊)到 +0.125(Claude Opus 5.5 領隊)之間。幅度最大的 Opus 5.5 是個有意思的案例:它的四份副本只拿 0.496,在五個領隊的副本形態裡排在後段,換成混合團隊反而衝到 0.621,模型多樣性對它的補救效果最明顯。
成本是這批數字裡最反直覺的一段。Terminal-Bench 4.1 上分數拿第一的混合團隊每輪成本 10.31 美元,低於四份 Gemini 4 Carbon 副本的約 13 美元;WANDR 上分數拿第一的混合團隊每輪 54.50 美元,也低於四份 Fable 5.2 副本的 66.41 美元。成本圖的橫軸採對數刻度,逐點標示的金額裡還能看到更便宜的組合:Terminal-Bench 4.1 上 Opus 5.5 領軍的混合團隊每輪 4.53 美元、GPT-6.1 Sol 領軍 3.18 美元;WANDR 上 GPT-6.1 Sol 領軍每輪 10.47 美元、Opus 5.5 領軍 11.52 美元。WANDR 圖上的四個混合團隊分數依序為 0.868、0.837、0.809、0.801,全都高於同模型的四份副本。
時間的改善則有明確但書,而且要看清楚量測的主體。官方貼文寫「團隊也更快完成任務」,時間圖畫的其實是同一個模型開四份副本對上單獨作業:四個模型的四份副本分數都高於該模型單獨作業,其中三個完成得更快,Fable 5.2 從每輪中位 64.3 分鐘縮到 48.2 分鐘、GPT-6 Astra 從 37.8 縮到 19.0 分鐘、GPT-6.1 Sol 從 33.3 縮到 17.3 分鐘,唯一變慢的是 Opus 5.5,從 14.7 分鐘微增到 15.9 分鐘。至於 Multiagent 混合團隊本身的每輪時間,官方圖表並沒有公布。「開了團隊就會更快」在官方數字裡的寫法是四個裡面三個,而且量的還不是混合團隊,這個差別值得留在心裡。
官方一方面在貼文裡直說 Multiagent 非常耗用點數、只用於最重要的任務,一方面又在基準數字裡展示分數最高的混合團隊每輪成本低於四份領隊副本。兩個說法並不衝突:比較對象是把同一個領隊模型開四份的燒法,混合團隊由不同模型湊成,每輪帳單沒有跟著領隊身價乘以四;但相對於平常在 Ultra 或更低段位跑一次任務,Multiagent 仍是點數消耗最重的一級。九月推出滑桿時官方就寫明,較低的設定使用較便宜的模型,點數用量取決於 Computer 實際執行的工作量,這條規則在新的最高段位上只會更陡。
對訂閱者來說,這裡留著一個官方沒有補齊的空缺:10.31 美元或 54.50 美元都是基準測試的每輪成本,不是使用者帳單的換算表。這些數字回答的問題是「同樣把題目做對,哪種組織方式花得少」,換不到「每個月會被扣多少點數」;Max 方案的點數怎麼按 Multiagent 任務扣、一次開滿 16 個代理會用掉多少額度,公告與部落格都沒有給公式。能確定的只有方向:官方把它放在所有段位之上,並親自提醒留給重要任務。
官方給了三個方向:預測、資訊密集的問題、後果重大的決策。部落格進一步列了五種工作樣態:財務預測與情境比較、年報審閱(報表、附註與管理層評論分頭檢查再對數字)、深度分析(對同一個商業或研究問題的競爭解釋互相比證)、併購資料室盡職查核、複雜報稅與年度規劃。共同點很清楚:任務拆得出互相關聯的子部分、值得交叉查核假設,而且漏看一個條件的代價高。
反過來說,改一句文案、查一個單純事實、整理一段已確認的文字,開 Multiagent 只會讓過程變重。這類任務留在較低的段位,把點數留給真正需要多角度的工作,是官方建議裡最實際的紀律。
從官方五種樣態回推,題目本身的形狀也決定 Multiagent 有沒有發揮空間:交辦時至少寫清楚要產出什麼(比較表、清單或報告)、驗收條件是什麼、資料範圍到哪裡,領隊才有可以把題目拆開的共同終點。題目寫得含糊,再多代理也只是把同一句話各寫一遍,點數照樣扣,角度卻沒有變多。
另外要分清楚改變的是什麼。Multiagent 改的是電腦端的工作分配,問題定義、資料界線與成果標準仍然由使用者給定;官方把它描述成為效能最佳化(optimized for performance),這是公司自己的定位詞,實際表現就用 Terminal-Bench 4.1 與 WANDR 那批官方數字檢驗即可,不需要照單全收。
UTC 時間 17:06 的補充貼文寫明,Multiagent 開放給 Perplexity Max 與 Enterprise Max 訂閱者,先在網頁版使用,手機與桌面支援即將推出;官方部落格結尾的寫法是所有 Perplexity Max 訂閱者,兩則官方訊息一致把範圍指向 Max 層級的網頁版。網頁先行其實是同一條產品線的既定節奏:九月滑桿上線時,官方同樣標明網頁版先開放、Android 與 iOS 隨後。開啟方式是在 Computer 的努力程度滑桿上選 Multiagent,對新任務生效;teammates 的長期工作也能用同一種強度交辦,讓常駐的 AI 隊友接手可拆分的部分。
WANDR 是第二個基準的名字,官方貼文與部落格都沒有說明它的出處、題目內容或計分方式;Terminal-Bench 4.1 的完整測試設定(題目清單、工具環境、允許步驟)也沒有隨公告發布,分數目前無法第三方重現,全部數字都屬於公司自測。五則貼文、部落格與圖表都是公司自製素材,宣傳影片屬行銷展示,目前也還沒有第三方對 Multiagent 的獨立評測可以對照。訂閱點數的計價公式、16 個代理的任務實際會消耗多少額度、手機與桌面版的時間表,都列為待補。基準圖表上還有一個細節:Terminal-Bench 4.1 有五個領隊,WANDR 的兩張圖只出現四個,Gemini 4 Carbon 領軍的團隊沒有出現在 WANDR 上,官方沒有解釋原因。
後續值得留意的訊號:手機或桌面支援上線、WANDR 出現公開說明、滑桿段位或模型清單調整,都是重新檢視這批數字與使用建議的時點。