TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

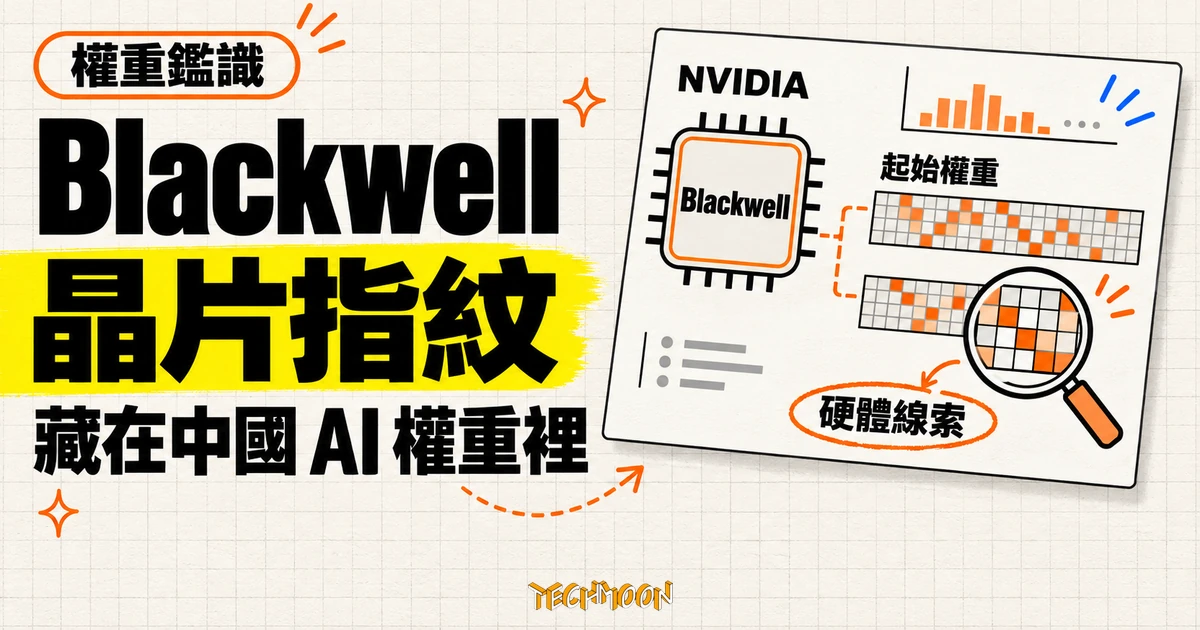
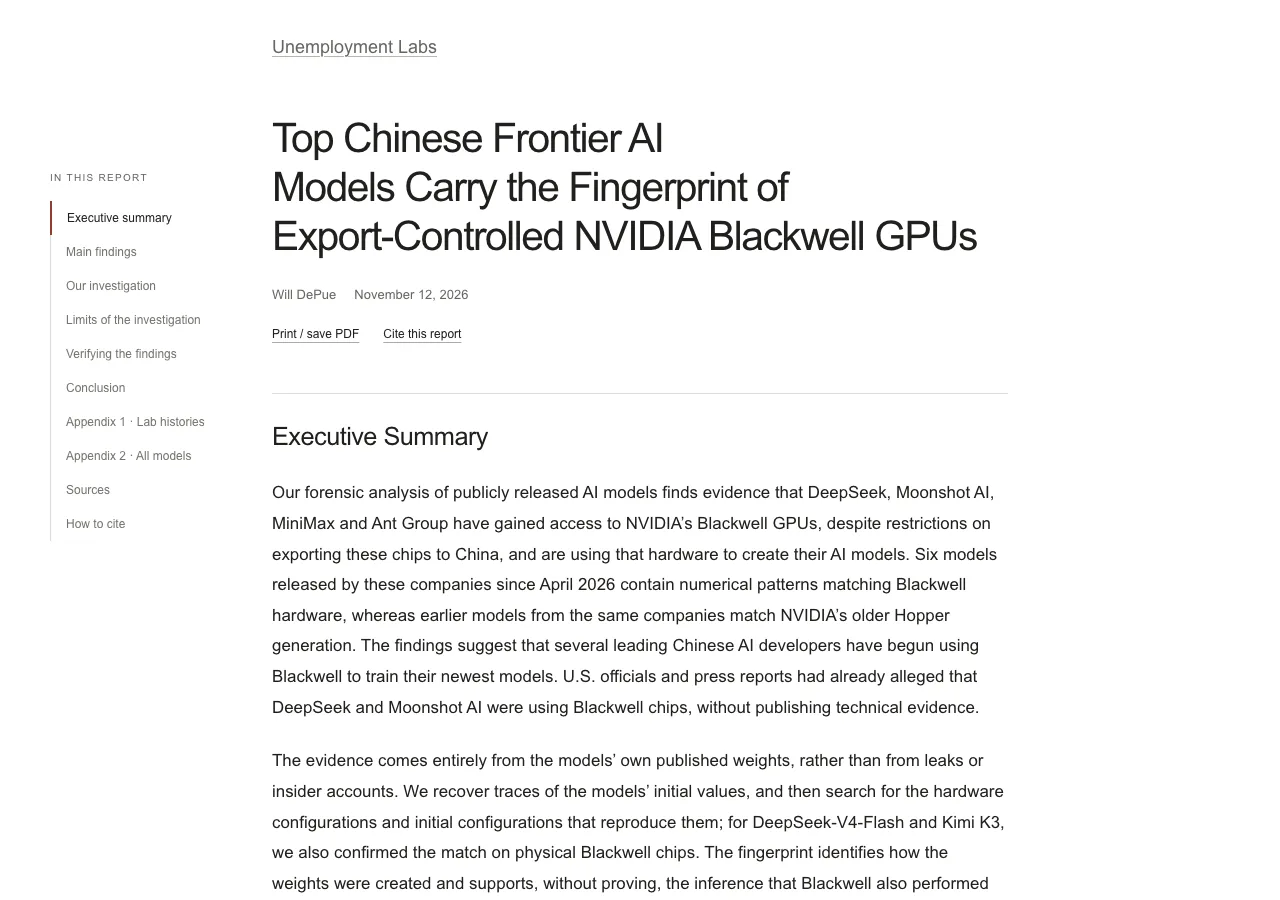
前 OpenAI 研究員 Will DePue 發布 Blackwell 指紋報告,指 DeepSeek、Moonshot、MiniMax 與螞蟻集團六款模型的起始權重排列吻合 NVIDIA 出口管制晶片。本篇實際重跑開源驗證碼重現比對結果,並整理報告自劃的界線:指紋證明起始權重在哪類 GPU 產生,晶片位置、取得方式與是否違規都不在其證明範圍。
用 AI 摘要這篇文章:
前 OpenAI 研究員 Will DePue 在 11 月 12 日發布的調查報告,把一個流傳已久的問題推進到有證據可查的層級:DeepSeek、Moonshot AI(Kimi)、MiniMax 與螞蟻集團這四家中國公司,自 2026 年 4 月起發布的六款開放權重模型,起始權重的數值排列吻合 NVIDIA 受出口管制的 Blackwell 晶片。此前美國官員與媒體多次指控中國公司使用 Blackwell,都沒有附上技術證據;這份報告的方法、種子與驗證程式碼全部公開,實際抓下來在筆電上執行,兩秒多就能重現報告隨附五款模型的排列比對。
不過「指紋」這個詞在轉述裡容易走音。報告提出的證據指向六款模型的起始權重「在哪一類晶片上產生」;至於晶片位在哪個國家、屬於誰、怎麼取得、是否違反出口管制,報告結論段明寫這些問題它回答不了。DePue 自己在 X 上的貼文用字比報告強,寫的是「結論性鑑識證據」;報告對六款模型的用語是「強力證據」,只對 DeepSeek-V4-Flash 一款用「結論性」,而且僅限起始權重那一層。要引用這份報告,這個落差得先分清楚。
這份報告最硬的部分,是它的驗證鏈可以被任何人重複檢查。報告附帶的 checkpoint-forensics 採 MIT 授權,把五款模型的保留權重列、每個模型的種子與雜湊值放進 repo,replay.py 會對每款模型掃過 16 到 256 的各種運算單元數,印出吻合度最高的排列。五款裡有四款正是被點名的模型,另一款 DeepSeek-V3 是 Hopper 世代的對照組。實際執行一次:兩秒多跑完全部五款,結果與說明文件完全一致。
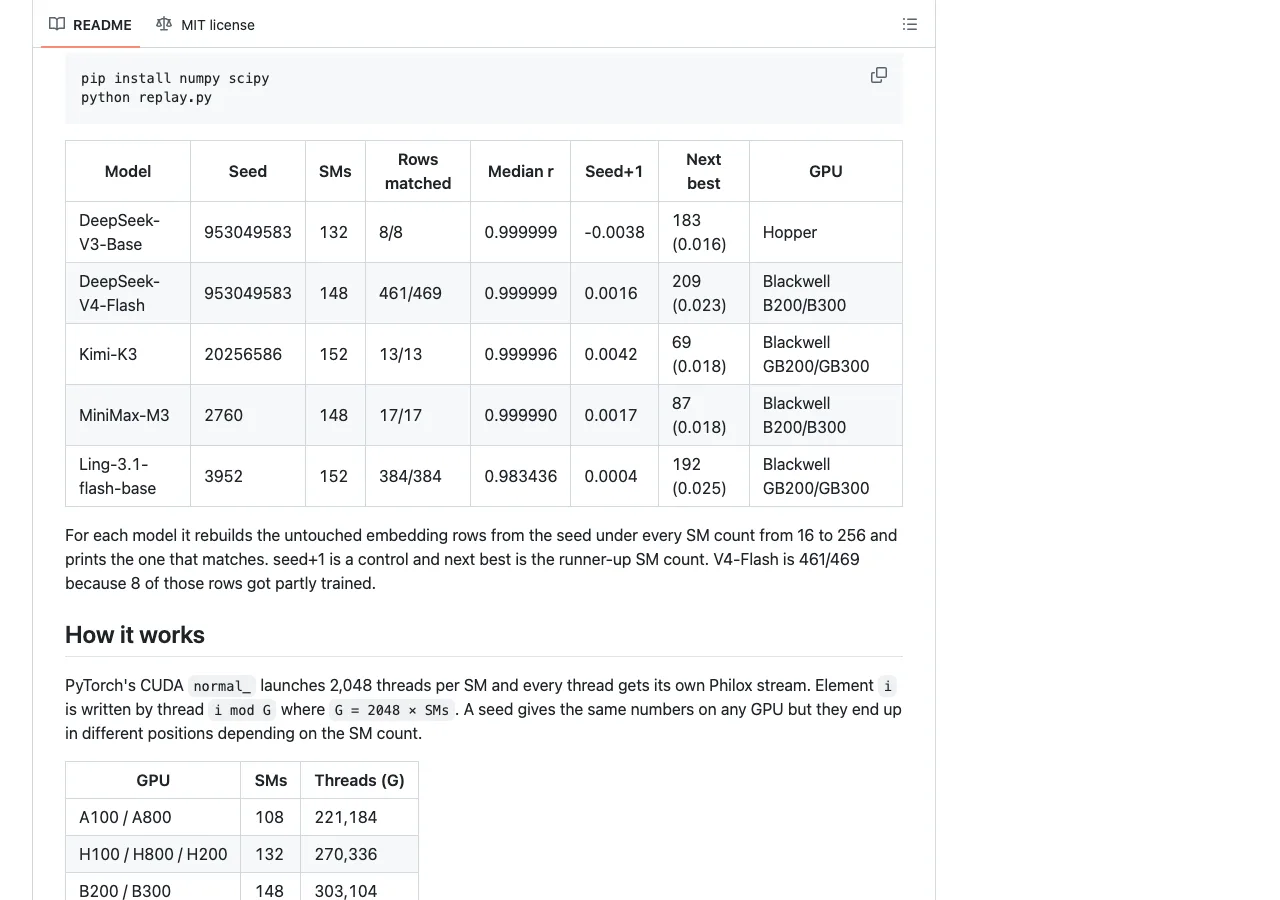
| 模型 | 種子 | 最佳排列 | 吻合列數 | 種子加一 | 次佳排列 |
|---|---|---|---|---|---|
| DeepSeek-V3-Base | 953049583 | 132 | 8/8 | -0.004 | 183(相關 0.016) |
| DeepSeek-V4-Flash | 953049583 | 148 | 461/469 | 0.002 | 209(相關 0.023) |
| Kimi K3 | 20256586 | 152 | 13/13 | 0.004 | 69(相關 0.018) |
| MiniMax-M3 | 2760 | 148 | 17/17 | 0.002 | 87(相關 0.018) |
| Ling-3.1-flash-base | 3952 | 152 | 384/384 | 0.000 | 192(相關 0.025) |
表裡有兩個對照數字值得停下來看。種子只加一,相關係數就全部掉到接近零,代表吻合不是亂數巧合;次佳排列的相關係數全部低於 0.026,代表每款模型只有一個排列說得通,132、148、152 三種排列不會同時吻合。repo 也沒有把「保留列真的來自這些模型」交給信任:抓取腳本支援直接從 HuggingFace 上釘選的模型版本重新下載指定列、核對 sha256 雜湊後再比對,實測五款全部對得上、結果相同。報告補充的統計基準是:在約六兆種種子與排列組合裡搜尋,純粹碰巧最強可以達到約 8 個標準差;六款模型最強的證據落在 49 到 1,385 個標準差,最弱的單項測試也有 20 個。這層數字的前提是統計模型正確描述隨機變動,報告把這句但書寫在正文裡。
程式碼之外,報告還做了實機驗證。用未修改的 PyTorch 在 H100 上重現 DeepSeek-V3 全部 57,344 個保留值,逐位元相同;換 B300 則重現 V4-Flash 的 469 個選定列中的 461 列,其中 445 列逐位元相同,另外 8 列是被訓練動過的部分;在租來的 GB200 上重現 Kimi K3 全部 13 個保留列。H100 與 B300 都重現不了對方的那款模型。另外拿 24 個廠商已公開訓練硬體的模型做已知答案比對,全數吻合,Meta 的 Llama 3.1 讀出 132、NVIDIA 自家的 Nemotron-3 Ultra 讀出 152;報告在附錄誠實註明,其中 11 個是初始檢查點、模型之間不獨立,所以這是完整性檢查,不算測出來的準確率。
指紋的原理用一句話講:同樣的亂數,放在不同數量執行緒的晶片上,會排進不同的位置。
大型模型訓練前,每個權重都要有初始值。PyTorch 用一種叫 Philox 的偽亂數演算法產生這些值,並把填值工作分給 GPU 上大量平行的執行緒。在報告檢視的 NVIDIA 晶片上,每個運算單元(SM)最多開 2,048 條執行緒,所以執行緒總數由 SM 數決定:Hopper 世代的 H100、H200 與 H800 是 132 個 SM、270,336 條執行緒;Blackwell 的 B200 與 B300 是 148 個 SM、303,104 條;GB200 與 GB300 是 152 個 SM、311,296 條。同一顆種子產生的數字序列相同,但執行緒數一變,這些數字落進權重矩陣的位置就整個平移。訓練會改寫大部分權重,可是對應從沒出現在訓練資料裡的詞彙的嵌入列,會原封不動保留初始值,直接比對即可。
最有意思的細節是 DeepSeek 的種子。報告找到 DeepSeek 用的種子是 953049583,而且 V3 與 V4-Flash 兩代用的是同一顆,差別只在排列:V3 對上 132 的 Hopper,V4-Flash 對上 148 的 B200/B300。換句話說,種子沒換、晶片換了,權重裡就看得到這次換機。報告也提到 Moonshot 用同一條規則推導各代模型的種子,所以每家實驗室的硬體軌跡可以沿著模型一代一代讀下去。
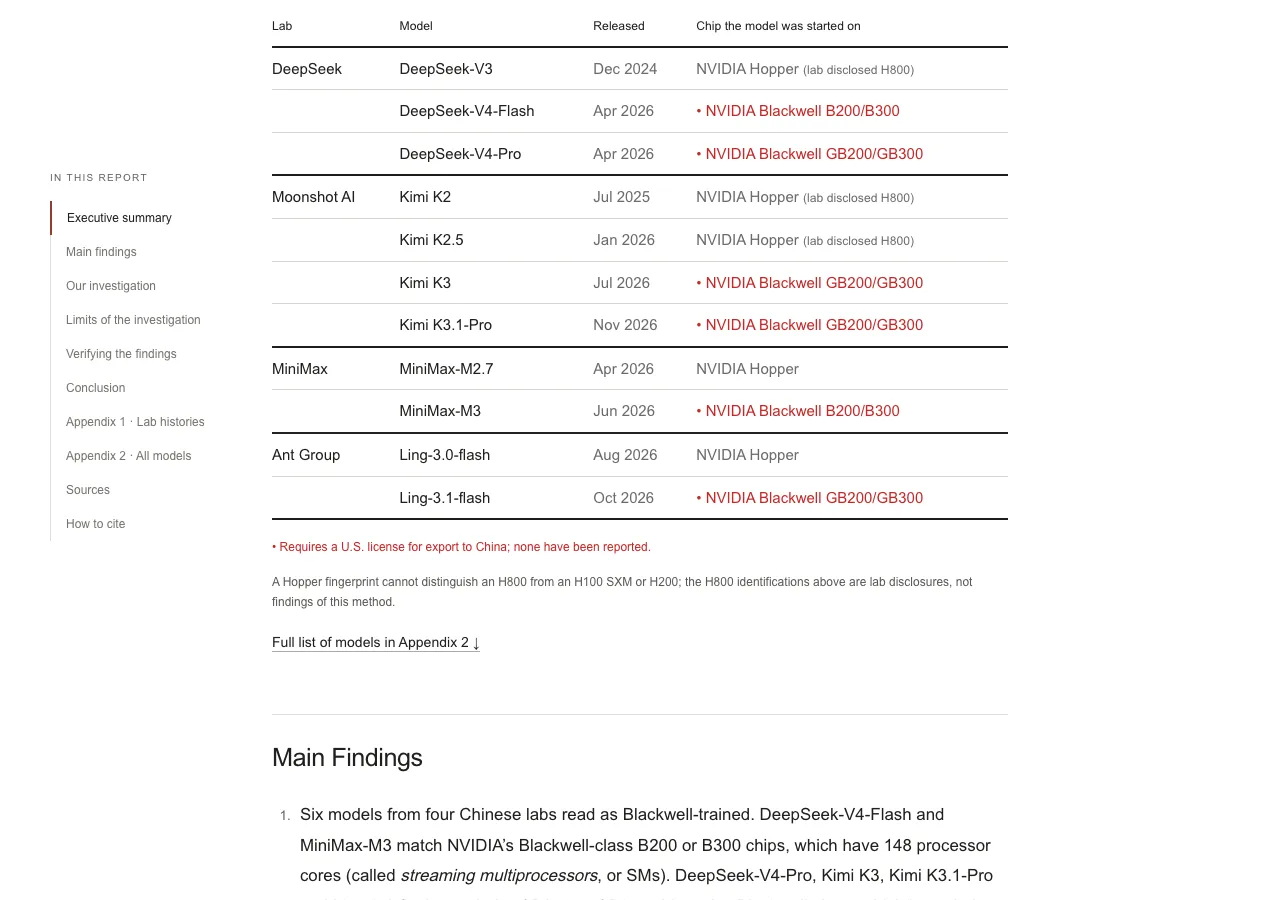
報告點名的六款模型,連同各家前代的讀數,拼出一條相當清楚的時間線。
| 公司 | 模型 | 權重公開 | 報告讀到的晶片 |
|---|---|---|---|
| DeepSeek | V3(至 V3.2) | 2024 年 12 月起 | Hopper(H800 為該公司自述) |
| DeepSeek | V4-Flash | 2026 年 4 月 | Blackwell B200/B300 |
| DeepSeek | V4-Pro | 2026 年 4 月 | Blackwell GB200/GB300 |
| Moonshot AI | Kimi K2.5 | 2026 年 1 月 | Hopper(H800 為該公司自述) |
| Moonshot AI | Kimi K3 | 2026 年 7 月 | Blackwell GB200/GB300 |
| Moonshot AI | K3.1-Pro | 2026 年 11 月 | Blackwell GB200/GB300(與 K3 同種子) |
| MiniMax | M2.7 | 2026 年 4 月 | Hopper |
| MiniMax | M3 | 2026 年 6 月 | Blackwell B200/B300 |
| 螞蟻集團 | Ling-3.0-flash | 2026 年 8 月 | Hopper |
| 螞蟻集團 | Ling-3.1-flash | 2026 年 10 月 | Blackwell GB200/GB300 |
幾個附帶讀數同樣值得記下。K3.1-Pro 與 K3 用同一顆種子,報告因此推測它可能是 K3 加上後訓練的檢查點版本,這與 Kimi K3.1 Pro 開放權重時的部署討論是同一批模型。Moonshot 還有一款 K2.7-Code 卡在中間:約八成保留列是繼承 K2.5 的 Hopper 排列,約兩成是新的 148 排列,而且每一列的混合比例一致,看起來像合併過的檢查點,所以沒算進六款名單。Hopper 的讀數本身有上限:H800、H100 SXM 與 H200 同為 132 個 SM,指紋分不出來,DeepSeek 與 Moonshot 公開過的 H800 說法是廠商自己的揭露,並非這套方法的發現。
沒被點名不等於沒用。報告能讀到的 Alibaba Qwen、智譜 GLM、騰訊、小米與 StepFun 的新近模型全部讀成 Hopper;美團的 LongCat-2.0 找不到 NVIDIA 指紋,該公司自述在 AI ASIC 超級伺服器上訓練,報告還在一個後來刪掉的微調設定裡看到 device_arch 設為 910,讀作華為昇騰。DeepSeek-V4.1-Flash 經過窮盡搜尋也沒有指紋。反過來講,閉源模型看不到權重就無從檢查,用 PaddlePaddle 框架訓練的 ERNIE-5.5 只回收得到種子、讀不出排列,在 CPU 上初始化的 Qwen3 部分模型也不留 GPU 痕跡。報告特別提醒:空白不代表沒用 NVIDIA。螞蟻集團的 Ling 系列過去多以模型能力亮相(Ling-3.2-flash 推出時主打文件與網頁視覺),這次 Ling-3.1-flash 被讀出的位置換成了訓練硬體這一欄。
讀這份報告最該帶走的是它對自身證據範圍的劃界,轉述時跳過任何一條都會把結論講過頭。
起始權重不等於全程訓練。指紋辨識的是「產生初始值的硬體」;實驗室可以在一套系統上產生權重、再搬到另一套系統訓練,或在混合叢集上接力。Kimi K3 至少有 64 個各自播種的程序留下同樣的 152 排列,支持起始階段用過 Blackwell,但報告明說無法據此斷定整段訓練都在上面。
位置與所有權查不到。Blackwell 系統可以向中國境外的資料中心租用,證據談的是「取得硬體的管道」,不能證明晶片被走私進中國,也不能證明出口管制被違反。
AMD 的替代解釋只排除了一款。MI300X 正常設定是 304 個運算單元,但可以切成 152 組或限制成 148 組,亂數序列也與 NVIDIA 相容;報告在實體 MI300X 上確認特殊設定確實能重現 Blackwell 排列。DeepSeek-V4-Flash 靠數值層級的差異排除了 AMD:377 個兩家結果不同的位置,363 個對上 NVIDIA、0 個對上 AMD。其餘五款沒做到同樣的排除,報告只說非常不可能,理由是要把整個叢集設定成跟 Blackwell 相同的單元數相當罕見。報告另外點出兩項公開佐證:螞蟻集團的 cuLA 儲存庫裡有 3 月 31 日在 GB300 上產生的 benchmark 結果;一位 DeepSeek 工程師在 2025 年 6 月的 GitHub 留言寫「我們沒有 SM100 的 GPU」(SM100 即 Blackwell)。還有一個容易被忽略的技術細節:中國市場的 Blackwell 顯示卡每個 SM 的執行緒數不同,兩種排列總數都生不出來。
報告從模型規模與訓練資料量推估五次最終訓練的硬體規模:合計約 12,000 張 Blackwell,區間 7,000 到 22,000 張,約等於 30,000 張 H100;兩個最大的 run,Kimi K3 約 4,500 張、DeepSeek-V4-Pro 約 3,000 張。報告引述華爾街日報關於馬來西亞安裝 3.6 萬張 Blackwell 供 ByteDance 使用的報導,換算每張約 7 萬美元,據此推得最大叢集約 2 到 3 億美元,五個加起來超過 5 億。
這組數字引用時要連同兩件事一起講。報告自己寫「我們對這些估計沒有把握」:效率假設(取 20%)、訓練 token 數、run 長度都是權重驗證不了的假設,run 長度砍半、張數就翻倍。而且初版對最大規模訓練給的數字是 2,000 到 3,000 張、最大叢集 1.5 到 2 億美元,因為假設 GPU 跑得出 NVIDIA 自家基準的效率;後來參照已公開的 Blackwell 訓練實績把效率假設下修,估計跟著上修,並補上 H100 等效值與天數,修訂發生在報告發布的同一天。報告拿兩個公開案例當對照錨點:Mistral 說 Mistral Large 4 用了 3,800 張 Grace Blackwell,Microsoft 說 MAI-Base-2 用 16,000 張跑了 38 天,照後者的效率,兩個最大的 run 需要 8,000 到 9,000 張。這些數字只涵蓋最終訓練,不含實驗、前置與推論。
報告不是憑空出現的第一個說法。路透社在 2 月下旬引述一位不具名的美國政府官員,稱 DeepSeek 即將發布的新模型用 NVIDIA 最先進的 Blackwell 晶片訓練,晶片可能集中在內蒙古的資料中心;白宮科技政策辦公室主任 Michael Kratsios 在 7 月 22 日點名 Moonshot 使用 Blackwell。兩者都沒有公開技術證據。這份報告的差別就在方法與程式碼公開,別人可以自己重跑。
回應面截至 11 月 16 日還是空白。TechCrunch 與 The Register 在 11 月 13 日的報導裡,都看不到 NVIDIA 或四家公司的回應;這幾天的新聞掃描也沒有出現任何一方公開表態。DePue 稱多位資深研究員(含獨立研究者與 OpenAI、Anthropic 等實驗室內部的人)已確認他的發現,The Register 報導轉述時把這句標為他本人的說法,沒有點名任何研究員。報告本身是 Unemployment Labs 自行發布,未見同行審查,也未見公開的獨立重現。報告頁面對新聞引用有一個明確請求:標明作者是 Will DePue 並連回報告原文,這也是轉述時最容易漏掉的一件事。
另外要分開的是合法性問題。CNBC 在 8 月 19 日的報導指出,美國出口管制聚焦在實體晶片的出口與所有權,遠端存取算力是還沒有被涵蓋的一塊,國會當時正在討論授權政府管制對受管制技術的遠端雲端存取。報告對「晶片怎麼來」沒有給答案,主管機關也還沒有對這份報告表態;想把「指紋」直接寫成「違規」,這一步不管是誰替報告走的,目前都沒有著落。
Blackwell 指紋到底是什麼?
模型起始權重的數值排列,與 Blackwell 晶片 SM 數對應的執行緒總數吻合。它是從公開權重倒推出來的線索,只能指出產生初始值的是哪一類 GPU。
這份報告證明 DeepSeek 或 Kimi 違反出口管制了嗎?
沒有。報告明寫證據不能確立晶片位置、所有權與取得方式,也不能證明出口管制被違反,因為 Blackwell 可以從中國境外的資料中心租用。
方法可靠嗎?有人獨立驗證過嗎?
方法可檢驗:程式碼與保留權重公開、實機重現與 24 個已知答案全數吻合,本篇實際重跑結果一致。但這是作者自行發布的報告,截至 11 月 16 日未見同行審查或公開的獨立重現,DePue 稱資深研究員已確認的說法也未見本人現身。
為什麼 Qwen 等模型沒被點名?
報告讀到的新近 Qwen、GLM、騰訊、小米與 StepFun 模型都是 Hopper 排列;部分 Qwen3 模型在 CPU 上初始化、ERNIE 用其他框架,本來就不留 GPU 指紋。沒有指紋不等於沒有用 NVIDIA。
這則新聞的後續比結論本身更有跟蹤價值。被點名的四家公司會不會公布訓練硬體,是對報告最直接的檢驗;有沒有人公開用不同硬體重跑同一套程式碼,決定「可驗證」能不能變成「已被驗證」;美國商務部或 NVIDIA 是否回應,則決定這條技術線索會不會進入政策或法律程序。在那之前,引用這份報告最穩當的寫法是維持它的分寸:起始權重的排列對上了 Blackwell,這一層有公開證據;再往外多講的每一層,目前都還是沒有著落的推論。對照美國國會正在審議的三個 AI 晶片出口管制法案,這份報告提供的是證據方法,管制該不該涵蓋遠端租用算力,仍是另一場還沒有結論的辯論。