TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

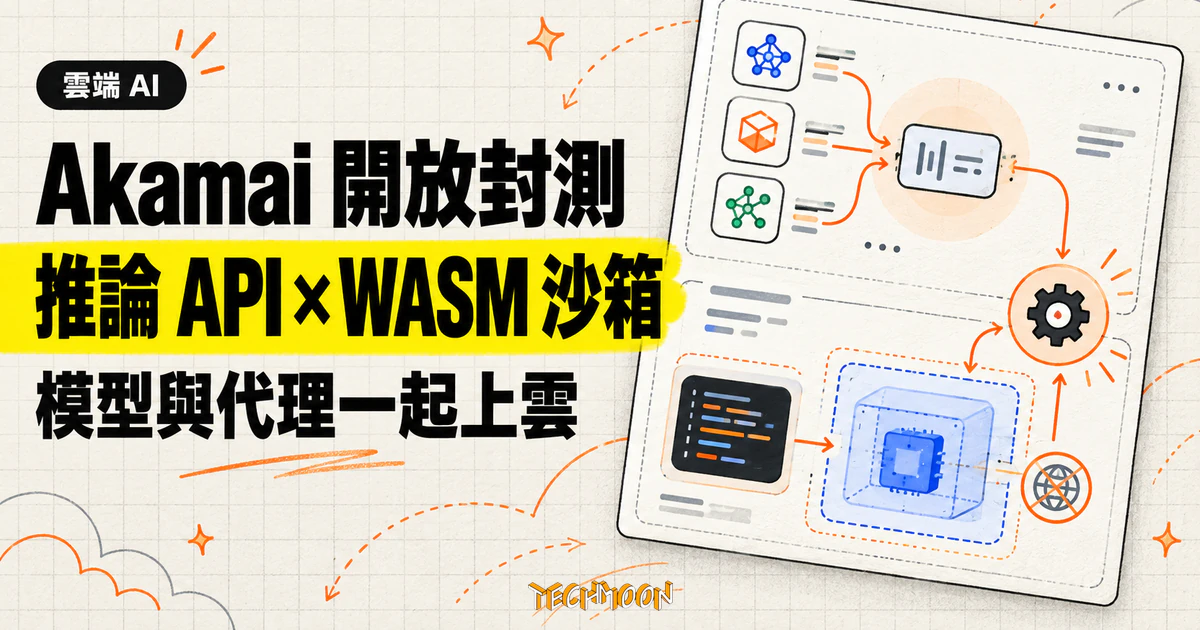
Akamai 於 10 月 27 日宣布 Inference 與 Agent Sandbox 兩項服務:前者以 OpenAI 相容 API 代管 12 個開放權重模型,測試期不計費但有每月 token 上限,且只收文字、不能指定處理區域;後者用 WebAssembly 為代理寫出的程式碼建立兩層隔離,對外連線預設全擋,目前只支援每步約一分鐘的間歇代理。OpenAI 相容介面換網址就能搬,零資料保留承諾寫進官方 FAQ,申請前值得先看清這些邊界。
用 AI 摘要這篇文章:
Akamai 在 2026 年 10 月 27 日從美國劍橋總部發出新聞稿,一次宣布兩項 AI 服務進入測試:Inference 負責代管開放權重模型的推論 API,Agent Sandbox 負責隔離 AI 代理寫出來的程式碼。先把結論說在前面:這是一場「承諾分兩層」的發布。新聞稿層講的是同一個平台從核心機房到邊緣節點都能跑 AI;文件層顯示今天真正開放的是一個範圍畫得很清楚的封閉測試,推論端測試期不收費但有每月 token 上限、只收文字、不能指定處理區域,沙箱端只收每步約一分鐘的間歇代理。時間軸上還有一個細節:官方文件在 10 月 20 日就記錄了 Inference 進入封測,10 月 27 日的新聞稿是對外的正式宣布。這次發布也延續了 Akamai 從內容傳遞網路跨入雲端運算的路線:管理介面與支援工單都掛在 Akamai 於 2022 年併購的 Linode 底下,沙箱的開源基礎 Spin 則是建立在 WebAssembly 技術上的 CNCF 專案。
Inference 的核心設計是相容 OpenAI 的 API 介面。官方文件給出的搬遷方式相當直接:如果你的程式本來就用 OpenAI SDK,只要改三個地方,base URL 換成 api.akamai-inference.com/v1、換上自己的 API key、把模型名稱換掉,其他程式碼不用動。FAQ 的原文說得很白:只需要「稍微」改一點。端點有三個:chat completions、embeddings,以及列出可用模型的 models,模型 ID 要以 Model Library 裡的細節頁為準,文件舉的例子是 gemma-4-26b-a4b-it 這類小寫格式。
部署形態分兩種。無伺服器形態按用量計費,Akamai 負責模型執行、請求編排與身分驗證,beta 先開放的就是這個形態;另一種是專屬部署,適合想自己掌控版本與汰換節奏的團隊。不想先寫程式的人,Cloud Manager 裡有 Model Playground 可以先下提示詞、調參數,測完再動工,Playground 會自動產生自己的測試 key;不過 Playground 只支援聊天模型,嵌入模型要直接打 embeddings 端點測。
API key 的設計有幾個實際的細節:前綴是 sk_aka_,建立時只顯示一次,Akamai 只儲存單向的 SHA-256 雜湊值,遺失只能撤銷重發;key 可以設到期日,也能限定只能用特定模型。對已經在用 OpenAI SDK 的開發者來說,嘗試成本主要不在改程式,而在接下來的條款與限制。
一個實際的坑:目錄裡多數模型支援思考模式,推理力道可以設定,而官方文件明載思考過程的 token 會計入輸出用量、也計入你設定的 max_tokens 上限,如果模型還在想就撞到上限,回應會在寫出答案前結束。串流回應則會先把推理內容丟出來,再送正式答案。
文件層的模型目錄比新聞稿具體得多。封測期共 12 個開放權重模型,供應商七家:DeepSeek、Google、Moonshot AI、NVIDIA、OpenAI、Qwen、Z.ai。新聞稿說參數範圍從 80 億到 2.8 兆,對照目錄,80 億那一端其實是嵌入模型 Qwen3-Embedding-8B,生成模型最小的是 9B 的 Qwen3.5;2.8 兆那一端是 Moonshot AI 的 Kimi K3。
| 模型 | 供應商 | 總參數 | 每token活躍參數 | 上下文 |
|---|---|---|---|---|
| Kimi K3 | Moonshot AI | 2.8T | 104B | 1M |
| DeepSeek V4 Pro 0813 | DeepSeek | 1.6T | 49B | 1M |
| GLM-5.3 | Z.ai | 744B | 40B | 1M |
| DeepSeek V4.1 Flash | DeepSeek | 552B | 8B~16B | 1M |
| NVIDIA Nemotron 3 Ultra | NVIDIA | 550B | 55B | 1M |
| GLM-5.3-Flash | Z.ai | 320B | 18B | 1M |
| DeepSeek-V4-Flash-0731 | DeepSeek | 284B | 13B | 1M |
| Qwen3.8-27B | Qwen | 27B | 密集架構 | 262K |
| Gemma 4 26B A4B IT | 25.2B | 3.8B | 256K | |
| GPT OSS 120B | OpenAI | 117B | 5.1B | 128K |
| Qwen3.5 9B | Qwen | 9B | 密集架構 | 262K |
| Qwen3-Embedding-8B | Qwen | 8B | 嵌入模型 | 32K |
12 個模型裡有 9 個來自中國大陸的實驗室:DeepSeek 三款、Moonshot AI 一款、Z.ai 兩款、Qwen 三款。這個組成本身就是選型事實,目錄裡最大與最小的生成模型都出自同一批供應商。目錄的結構性觀察還有幾個:284B 以上的七款大模型都有 1M tokens 上下文,GPT OSS 120B 是這批大模型裡唯一停在 128K 的;嵌入模型只有一個選擇,支援超過 100 種自然與程式語言,輸出維度可以從 32 調到 4,096,語意搜尋、程式碼檢索與分類聚類都能用它做;Qwen3.5 9B 雖小,文件標明支援 201 種語言與方言;Nemotron 3 Ultra 用的是混合 Mamba 與 Transformer 的架構,官方文件提到 Mamba 層讓長上下文的快取維持在有限範圍;GLM-5.3 的模型卡則把網路安全漏洞分析列為明確用途,Z.ai 模型的其他應用脈絡可以對照我們先前的GLM-Legal 法律模型報導。
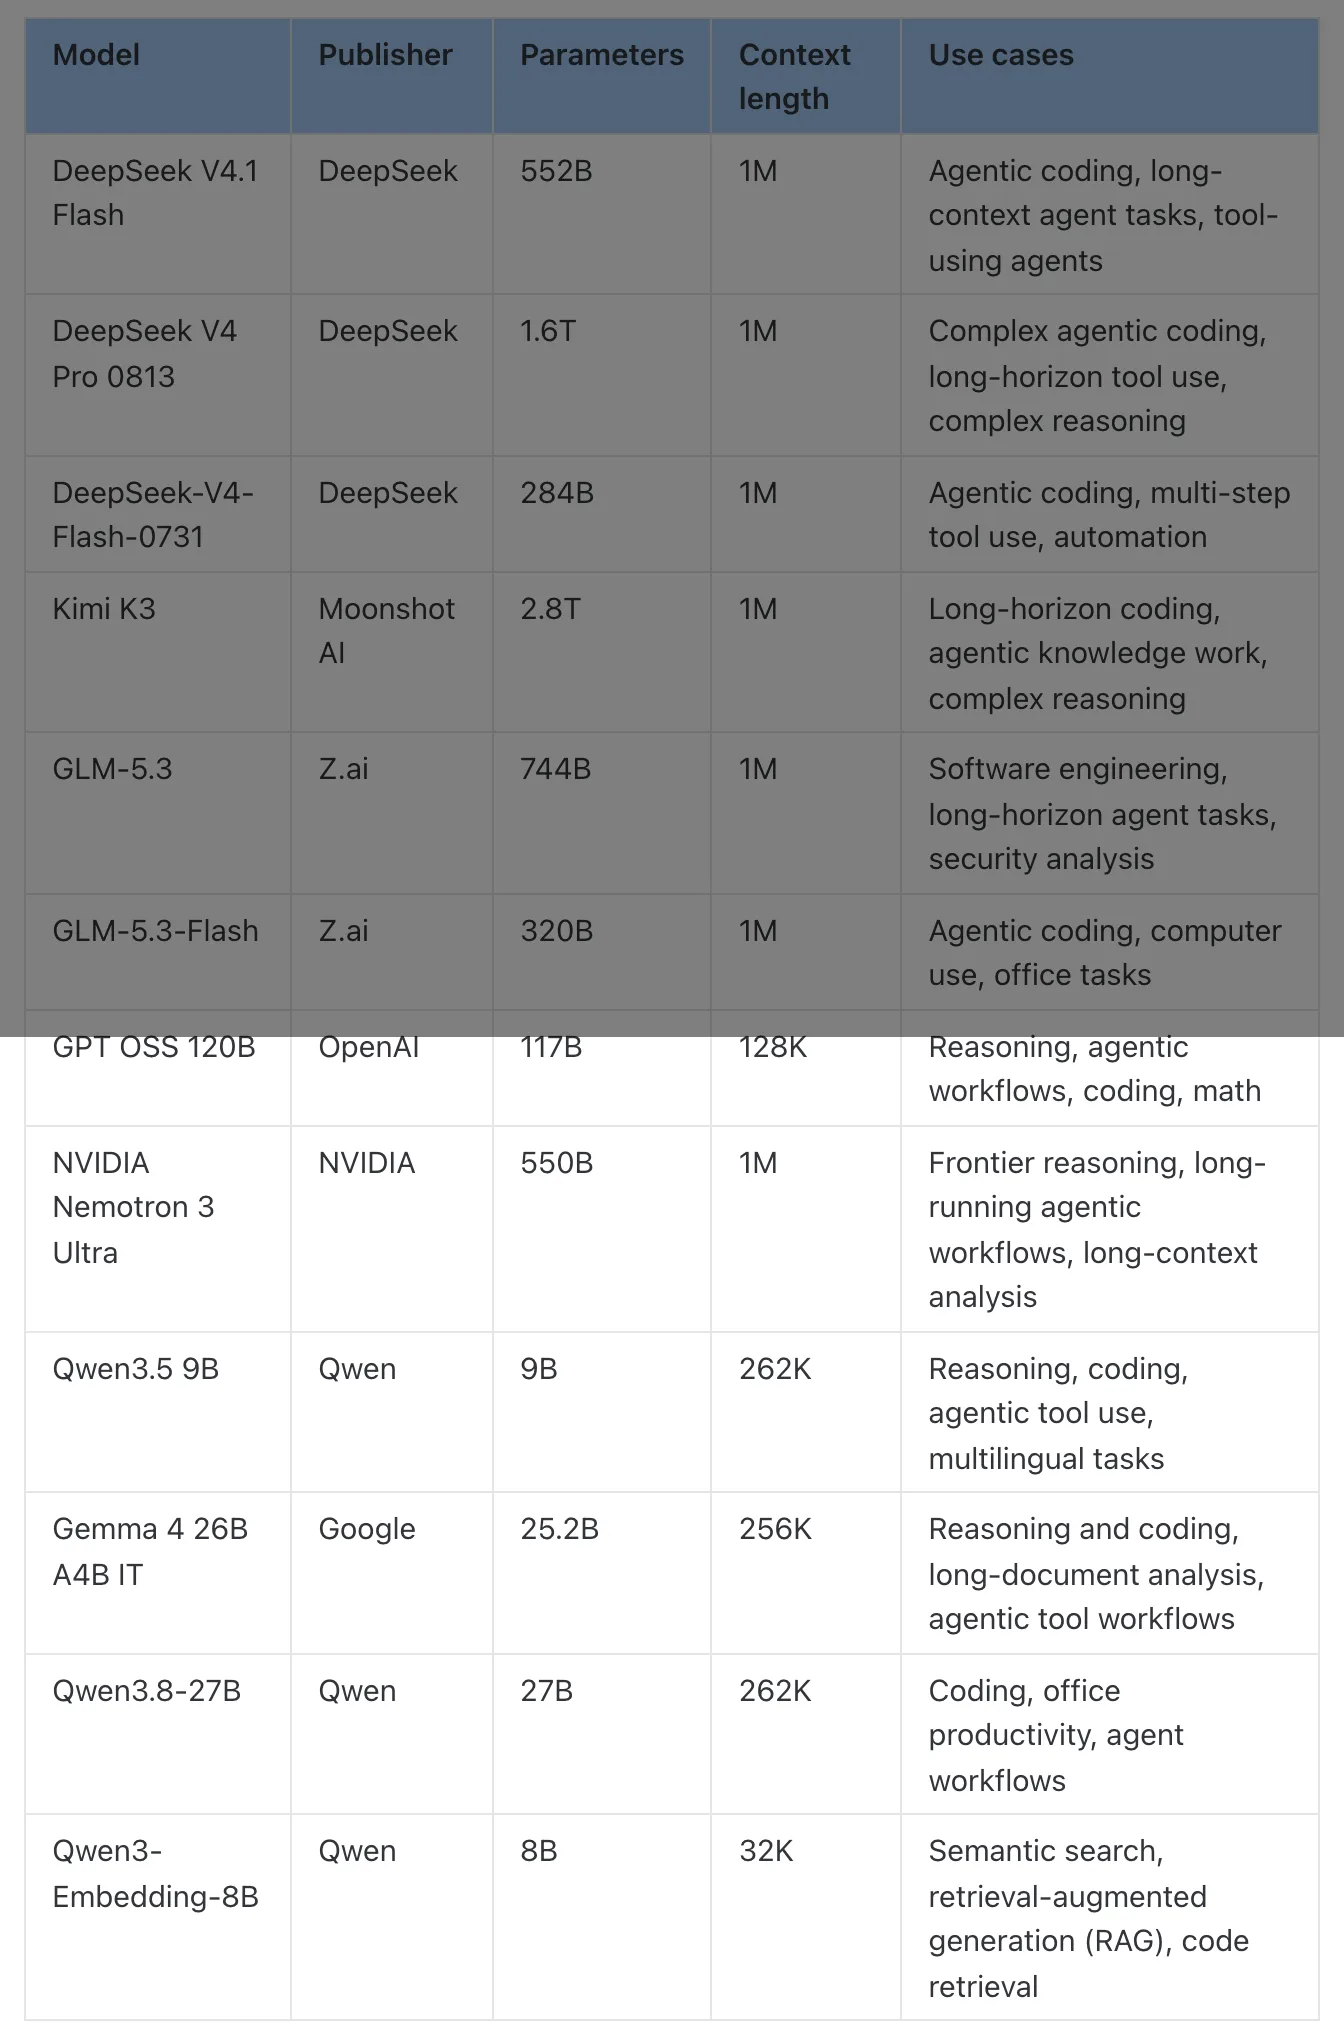
讀目錄時最該注意的陷阱是參數標示方式。文件特別說明,目錄裡多數模型採用混合專家架構(MoE):總參數很大,但每個 token 只活化其中一小部分。Kimi K3 總參數 2.8 兆、每 token 活躍 104B;GPT OSS 120B 總參數 117B、活躍只有 5.1B;DeepSeek V4.1 Flash 更極端,讀輸入時活化 8B、生成時 16B。文件對這類架構的說明是:總參數雖大,每個 token 實際動用的算力比同樣總規模的密集模型少。參數規模描述的是模型大小,不能直接當成品質、速度或成本的字面換算。與 DeepSeek V4.1 Flash 相關的背景,可以對照我們先前的發表報導;想在自己機器上跑同款模型的另一條路,參考12GB 顯卡自架實測。
beta 階段的經濟條款寫在文件裡而不是新聞稿裡:推論用量在測試期不計費,但每個帳號有每月 token 上限,數字在 onboarding 時由 Akamai 核定,到量之後 API 直接回 429 錯誤,想提高上限要透過支援工單申請,帳號內所有 API key 與模型共用同一個額度。除了每月總量,請求本身也有速率限制,超過一樣回 429,官方建議用指數退避重試,而 OpenAI SDK 預設就會自動重試這類錯誤。帳號能持有的 API key 數量同樣有上限,滿了要先撤掉不用的舊 key 才能再建新的。文件同時提醒,Akamai Cloud 的其他功能照合約費率計費,免費的只有推論用量本身。
每個模型的 per-token 價格目前只放在需要登入的 Model Library 裡,官方的定位是讓你估算正式計費後的成本,外部看不到具體數字。用量監控分得很細:token 與請求量可以按模型、按 API key 分組查看。受影響的族群很明確:想低成本試一輪 OpenAI 相容 API 的開發者,現在正是進場時機;需要跑大流量正規測試的團隊會先撞到每月上限,不屬於這次封測的目標對象。
有三條限制只存在於 FAQ 與文件頁,新聞稿完全沒提,但每一條都會直接改變採用決定。
最實際的一條:beta 只收文字。FAQ 寫明 image、audio、video 輸入都不支援,模型只接受並回傳文字。這裡有個對照:目錄裡 Kimi K3、GLM-5.3-Flash、Qwen3.5 9B、Qwen3.8-27B 的模型卡都寫著接受圖片或影片輸入,模型能力與服務層現況是兩回事。多模態應用現在搬不過來。
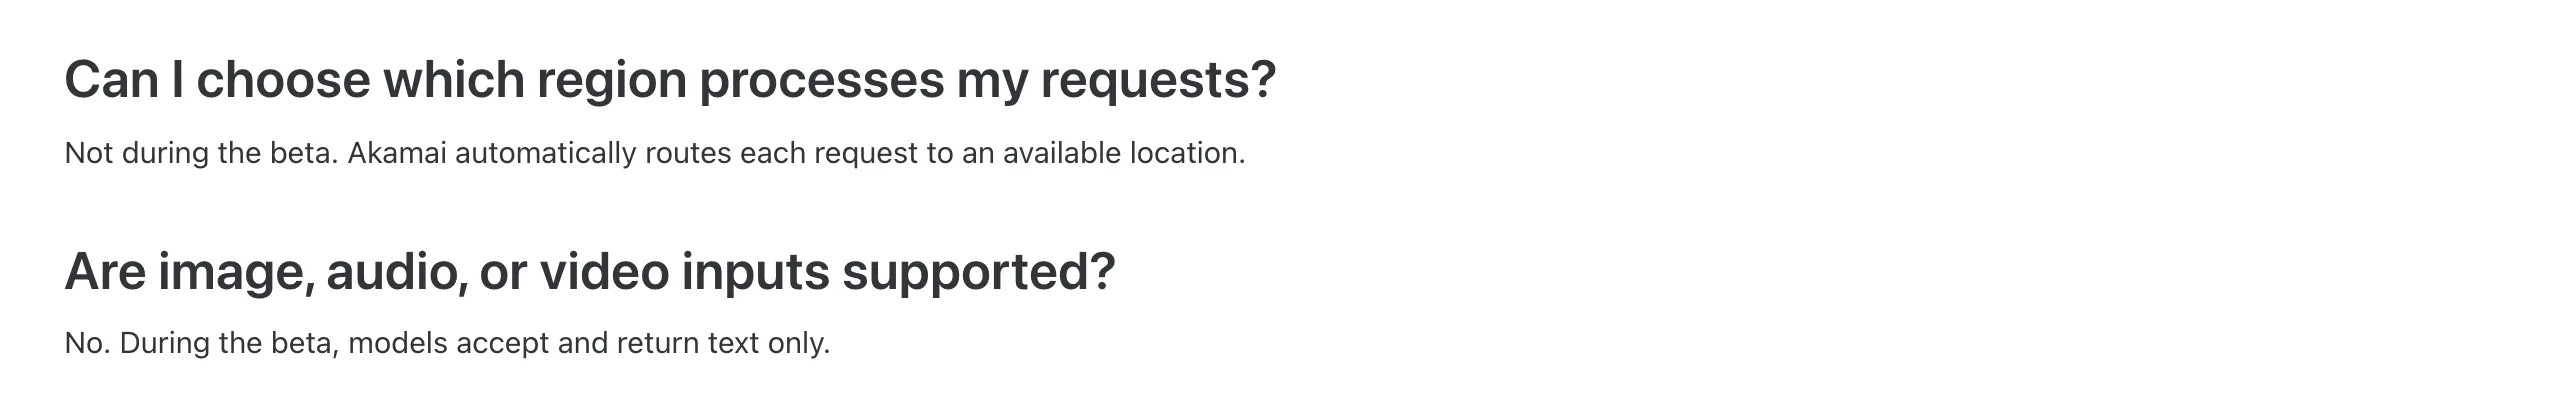
卡合規場景的一條:不能指定處理區域。beta 期間由 Akamai 自動把每個請求路由到可用節點,使用者無法選擇。對有資料落地需求的團隊,這條等於封測期無法做合規驗證;對一般應用,實際路由到哪裡、亞洲延遲多少,都要等實測或正式版才會知道。
三條裡唯一的正面訊號:零資料保留。FAQ 的原文是 Akamai Inference 屬於 ZDR 服務,提示詞與模型輸出不留存、不記錄。對要把客戶資料餵給模型的團隊,這是決策時最該問的那一條,而 Akamai 給了書面承諾。
Agent Sandbox 解決的是另一個問題:AI 代理會自己寫程式碼來完成任務,而程式碼一旦執行就可能連網、讀檔、佔用運算資源。Akamai 的做法是兩層隔離:代理本身是跑在 Akamai Functions 上的 Spin 應用,包在 WebAssembly 沙箱裡;代理寫出的程式碼,再放進巢狀於其中的受限 JavaScript 或 Python 執行環境,語言由代理自己選。產品頁 FAQ 有一句關鍵定義:隔離來自 WebAssembly 執行環境本身,不是在外面包一層監控。
限制的設計哲學是預設擋掉而非事後偵測。對外連線預設全部阻擋,代理程式碼碰不到遠端網站,資料帶不出去、惡意內容也抓不進來;執行限額在執行環境層強制,代理自己改不掉;有風險副作用的 Runtime API 直接從執行環境移除。代理的上下文與記憶存在 key-value 儲存裡,跨步驟延續。部署一次之後,每個請求由 Akamai 路由到最近的可用實例,不用自己規劃機房。
模型不綁死。沙箱可以接任何 OpenAI 相容模型,從一線供應商到自己架在 Linode Kubernetes Engine 上的模型都行,換模型不用重新建置。也就是說,沙箱與推論服務可以分開採用,不必兩個一起上。
官方列的目標對象有四種:做 AI 應用產生器的團隊、想給代理加上程式碼執行工具的開發者、需要按租戶隔離的多租戶 SaaS 團隊,以及既有的 Akamai 開發者(EdgeWorkers 或 Akamai Functions)。既有的 Spin 應用可以直接加上這組能力,不必另裝一套工具箱。
不過官方把責任講得很清楚。產品頁上的責任聲明寫著:你要為代理的行為與輸出負責,並遵守適用法律與第三方條款。沙箱擋掉的是非預期的技術風險,不會替你扛治理責任。雲端技術資深副總裁 Jon Alexander 在新聞稿裡的說法把兩個產品串了起來:企業不應該在速度與控制之間二選一,而「每個跑代理的團隊,都需要在代理寫出的程式碼周圍畫一條界線」。代理框架的市場脈絡,可以對照 OpenAI 先前的Agents API 公開測試。
Agent Sandbox 的實際階段比新聞稿的 beta 一詞更早期。產品頁把它定位為 tech preview,採申請制,而且只支援間歇代理:每一步約一分鐘完成,代理就停下來等下一個指令。能連續活好幾天、好幾週的有狀態代理,官方列為未來追加,還沒有時間表。新聞稿也預告了後續方向:增加控管代理可以連到哪些對象、以及外部可以怎麼連到代理的能力。想要全天候代理工作流的團隊,現在的產品形態接不上使用場景。
開源宣稱也需要分層看。產品頁說沙箱的 Spin SDK 能力以 Spin 擴充套件形式開源,Spin 是 CNCF 的 sandbox 專案。Spin 本身的狀態可以核對:Apache-2.0 授權、Rust 語言、在 GitHub 上約 6,560 顆星,最新版 v4.2.5 在 2026 年 10 月 23 日發布,比新聞稿早四天。至於 Agent Sandbox 擴充套件本體,至 10 月 27 日發布當天,Spin 專案的公開儲存庫組織裡還沒有獨立儲存庫可指認,開源範圍與時點以官方後續公布為準。
硬體配置把兩種使用者也分開了。低延遲推論用 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU;要自建、微調、自架模型的團隊走另一條路,Blackwell Ultra(B300)GPU 叢集,每個八卡節點單卡 288GB HBM3e 記憶體、整節點 2.3TB,官方說這個容量放得下前沿級模型,取得方式是經由業務洽詢管道。專屬叢集的賣點寫得很直白:沒有速率限制、沒有多租戶排隊,模型版本與汰換自己掌控。官方同時說正在為 2027 年準備 NVIDIA Vera Rubin 平台支援。
新聞稿裡的規模數字屬於公司宣稱層級:Akamai Cloud 的多年合約總值超過 140 億美元、超過 4,350 個邊緣節點。這兩個數字是公司自述的既成與現況規模,當參考即可。營運長兼 Akamai Cloud 總經理 Adam Karon 的定位說法是,AI 推論將佔企業投資的大宗,而客戶要的是在同一個平台上建置、執行並保護 AI。換句話說,Akamai 這場發布的賣點不是模型效能,是平台整合。
分流來看會比較清楚。適合現在就申請的,是想用最低成本試 OpenAI 相容 API 的開發者,特別是想試 550B Nemotron 3 Ultra 或 2.8T Kimi K3 這個量級開放權重模型的人:測試期不計費,搬遷只改三個參數,試錯成本低。代理開發者如果在找一個對外連線預設全擋的程式碼執行環境,也值得填表,前提是工作流能接受間歇式的每步一分鐘。
不適合現在投入的:需要圖片、影片輸入的多模態應用(beta 只收文字);需要指定資料處理區域的合規場景(beta 不能選區);需要穩定服務水準保證的正規流量(封測明言服務會中斷、API 端點會變)。做檢索增強應用的人還要留意一個工具面限制:Playground 只能測聊天模型,嵌入模型 Qwen3-Embedding-8B 要自己打 embeddings 端點驗證,沒有圖形介面可以試。
未確認事項留下四項:正式版時程、正式計費水準(per-token 價格在登入後的 Model Library 才看得到)、實際路由落點與亞洲延遲、沙箱開源擴充套件的儲存庫位置。官方文件明言模型會持續新增與汰換,所以這份模型目錄有保存期限,正式版或計費公告出來時需要回查;在那之前,以上描述的是 2026 年 10 月 27 日發布當天的封測樣貌。