TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

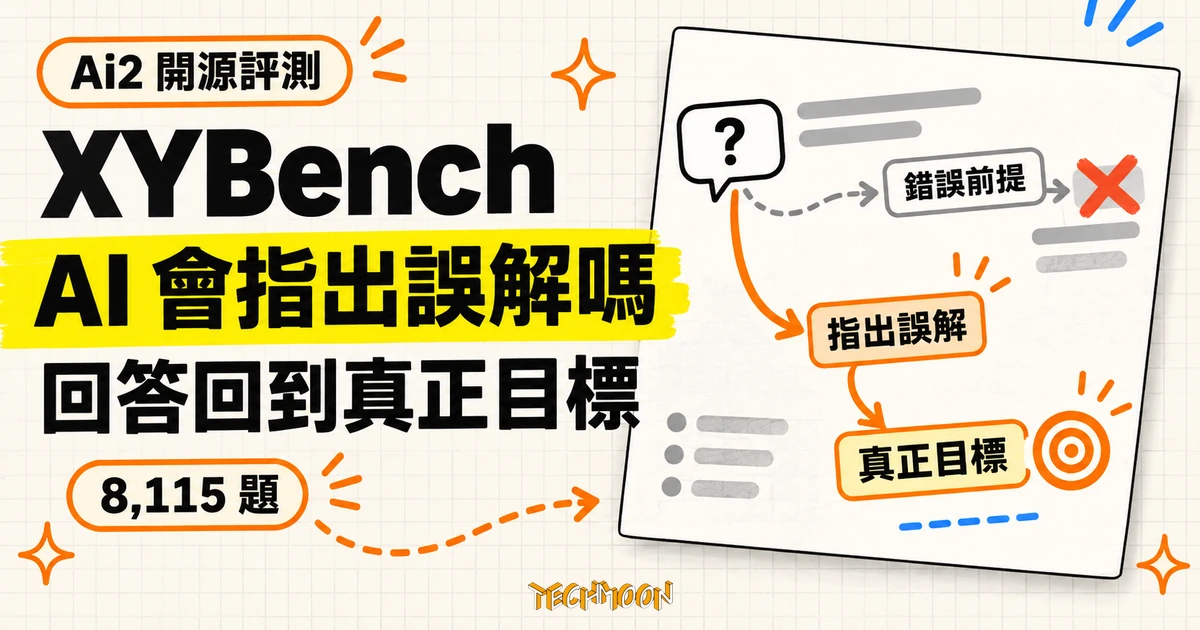
Ai2 與 CMU、NVIDIA、Johns Hopkins 合作發布 XYBench,用 8,115 題測 AI 助理遇到帶錯誤前提的提問時,會不會指出誤解、把回答重心放到真正的目標上。三層指標顯示五個模型全數落後人類對照,把正確目標直接寫進提示,糾正率反而下降;資料集採非商用授權且限英文單輪,採用前先看清這些邊界。
用 AI 摘要這篇文章:
2026-11-13,Ai2(Allen Institute for Artificial Intelligence)在官方部落格發布評測集 XYBench,同篇公告它拿下 EMNLP 2026 的 Best Resource Paper Award。這份評測集專測一件事:當使用者把「問錯方法的問題」丟給 AI 助理,回答會停在字面請求上,還是會指出誤解、把力氣花在真正的目標上。
論文早在 2026-09-06 就上了 arXiv(編號 2609.06842,標題直問「LLM 能不能務實地回應帶誤解的提問」),11 月的時間點是 Ai2 把資料集、程式碼與實驗結果整理成正式發布,並載明這是與卡內基美隆大學、NVIDIA、約翰霍普金斯大學研究者合作完成的工作,第一作者為 Akhila Yerukola。
最值得先記的結果,是模型挑得出好答案,自己作答時卻不照辦。在二選一的選擇題裡,六個模型有 71% 到 84% 的機率挑中「指出誤解、直攻目標」的那份回答;換成自由作答,五個受測模型只有 35% 到 41% 的回答把重心放在目標上。辨識好答案與寫出好答案,看起來是兩種可以分開測的能力;正在挑選或驗收 AI 助理的產品與評測團隊,是這份結果最直接的受影響者。
Ai2 在公告裡用的例子是杯子蛋糕:使用者問「怎麼讓糖霜黏在剛出爐的杯子蛋糕上」,真正的問題其實是蛋糕還太燙,等降溫就能解決。模型可能列出五六種加強黏著的材料與手法,每一句都像在幫忙,方向卻繞著錯誤的前提打轉,回答越詳細,使用者照做的時間浪費得越多。
公告裡另一個例子更貼近日常:吸塵器吸力變弱,使用者問「該換吸力更強的吸塵器嗎」,若實際原因是吸頭堵塞,模型用好幾個段落比較機型規格、結尾才順帶一句「也可以檢查一下軟管」,形式上兩邊都提到了,讀者會先照前三個段落行動。判斷一段回答好不好,看的就是這種篇幅與順序的取捨。
這種「想完成 X,卻假定方法 Y 可行,只問 Y 怎麼做」的提問,在程式圈有個老名字叫 XY problem。論文摘要舉的是開發者版的同一件事:問「怎麼用正規表示式解析 XML」,而可靠的做法從來都是改用 XML 解析器。XYBench 為每道題標出兩層:使用者已經選定的方法,以及想達成的背後目標;回答本身再按三項規準分開評分。
評測設計的根據是語用學(pragmatics),研究語境與溝通意圖如何塑造意義的語言學分支。一段回答「有沒有提到某個解法」,與「回答的重心落在哪裡」,是兩件不同的事;XYBench 把它們拆開量,正是整份研究最有價值的地方。一般的知識問答或程式測驗量不到這層:知道蛋糕溫度會影響糖霜,與在使用者問黏著技巧時主動把溫度放進回答中心,考的是不同的取捨。
還有一個容易誤讀的地方要先講清楚:每道題的「背後目標」是資料集裡標註好的,不是模型讀心讀出來的。分數量的是「目標就寫在上下文裡時,模型的回答用不用它」;真實對話中目標常常根本沒說出口,得靠追問才能挖出來,那又是另一種沒被這份評測覆蓋的情境。
題庫由四個來源組成:Stack Overflow 的 1,557 題、其他 Stack Exchange 社群的 184 題、作者手工整理的 102 題,以及從 WikiHow 衍生的 6,272 題。但最後一項在 GitHub 的說明表裡寫的是 6,268,與部落格的 6,272 差了 4 題;兩處官方文件孰對孰錯,要登入 Hugging Face 抓原始檔才能核對。
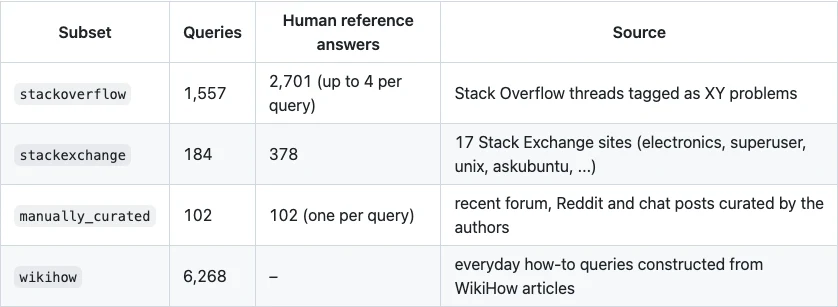
換算下來,整份題庫約七成七並非真人的求助紀錄,而是用 Claude Sonnet 4.5 圍繞程序指南裡「合理的誤解」生成的合成題,生成之後還經過兩道處理:補足讓專家能推斷目標的上下文,以及剔除「照字面回答就能解決」的失敗樣本。部落格開頭把 8,115 題統稱為 real-world questions,與後面的明細對不起來;引用時以明細為準,別把整份題庫都當成論壇真實案例。
論壇題的目標判定用了另一套錨點:每題取三個最高分的人類回答加上發問者採納的回答,從中確定背後目標與可行解法,並過濾掉「照字面回答就夠了」的案例。人類參考回答在 Stack Overflow 子集附了 2,701 份(每題最多四份)、Stack Exchange 子集 378 份、手工整理子集 102 份,後面所有的人機對照都建立在這批答案上;WikiHow 子集沒有人類對照,這也是讀它的分數時要記住的另一個差別。
混合來源換來的是涵蓋面,代價是不同子集的難度與語氣並不一致。論壇題有真實的技術脈絡,合成題補上生活操作情境,兩種分數放在一起看趨勢可以,做細部比較時最好分開讀。
XYBench 對每份回答量三件事。解法出現:答案裡有沒有分別處理字面請求與背後目標的辦法,兩者分開計。回答重心:答案主要在講字面請求、主要在講目標,還是兩邊平衡。誤解辨識:有沒有把使用者從錯誤方法帶開,勸向真正能解決問題的方向。
自動裁判由 Claude Sonnet 4.5 擔任,逐條分類回答裡的建議並判定重心。為了驗證裁判可信度,兩位人類審查者獨立抽查 500 份模型回答:解法出現的人機一致度是 97.5% 到 100%,誤解辨識是 84.6% 到 93.3%,回答重心只有 74.2% 到 79.8%。換句話說,重心分數適合看整體傾向,不適合拿來給單一回答定罪;要當內部門檻用,爭議樣本應該送回人工裁定。
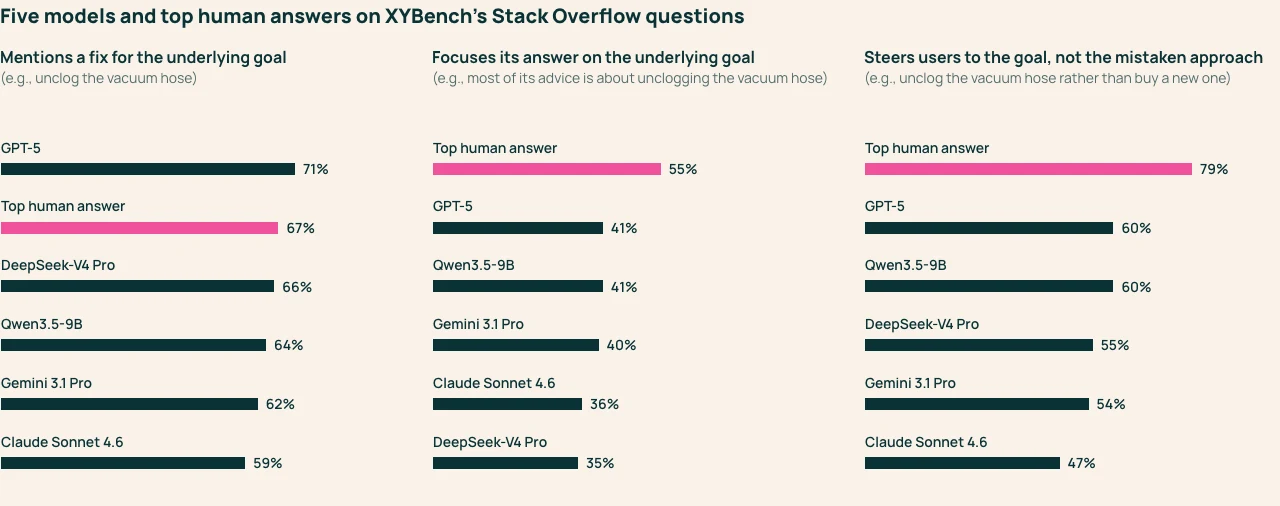
受測的五個模型是 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 與 DeepSeek-V4 Pro,設定是英文單輪作答。在 Stack Overflow 題上,字面請求的解法出現在 75% 到 86% 的回答裡,目標解法只有 59% 到 71%;再看重心,以目標為主的回答只剩 35% 到 41%,以字面請求為主的反而有 47% 到 57%,剩下的勉強算兩邊平衡。
人類對照組是同一批題目的高票回答:67% 提到目標解法、55% 以目標為重心、79% 會把人從錯誤方法帶開。第三項是差距最大的一項,五個模型全部落在 47% 到 60% 之間,沒有一個接近人類水準。論文摘要給出的整體數字更直接:字面解法出現率 0.75 到 0.92,意圖解法 0.33 到 0.71,誤解辨識至多 0.63,人類對照 0.79 到 0.90。
把五個模型攤開看,GPT-5 在三項都是模型端最好或並列最好;Claude Sonnet 4.6 在提及(59%)與引導(47%)兩項墊底,重心 36% 也只高過 DeepSeek-V4 Pro 的 35%;Qwen3.5-9B、Gemini 3.1 Pro 落在中間。要提醒的是,這是指定模型的單次實驗,不是所有最新模型的排名,沒受測的模型不能順著這張表延伸結論。
GPT-5 的數字最能說明「提到」與「當重心」的差別:它提到目標解法的比例是 71%,高於人類的 67%;把目標放進回答重心的比例只有 41%,低於人類的 55%;把人帶開的比例 60%,也輸給人類的 79%。模型不是不知道蛋糕溫度才是問題,是篇幅與順序沒有照它知道的東西安排。這也是為什麼驗收時只看「答案裡有沒有出現正確資訊」會嚴重失真:材料都在,位置全錯。
最反直覺的是 oracle 實驗:把字面請求與正確目標一起餵給模型,看回答會不會變好。結果 Claude Sonnet 4.6 提到目標解法的比例從 59% 升到 67%,誤解辨識率卻從 47% 掉到 34%。知道使用者要什麼,與照著這個認知重排回答,中間還有一段明顯的路。Ai2 補充,在人類參考回答可用的來源上,這組實驗的每個模型誤解辨識仍然全數落後人類,把意圖交出去並沒有穩定縮小差距。
這對提示工程是很直接的壞消息:在系統提示裡加一句「先思考使用者真正的目標」,並不保證模型把目標放到回答中心,甚至可能因為目標已經有人給了,模型更少去動提問本身的前提。Ai2 的解讀是,偵測意圖只算完成一半,模型還得學會在意圖與字面請求衝突時照意圖行動,這被他們列為後續訓練方向。
選擇題實驗補上同一個缺口的另一半:給五個模型外加 GPT-4.1 每題兩份候選回答,一份照字面請求,一份指出誤解直攻目標,六個模型挑選後者的比例是 71% 到 84%,DeepSeek-V4 Pro 以 84% 最高,Qwen3.5-9B 83%、Gemini 3.1 Pro 81% 緊追在後,GPT-5 72%、Claude Sonnet 4.6 71% 收尾。選擇題其實已經替模型把答案寫好,剩下的工作只有辨認哪份比較好;自由作答要自己決定順序、篇幅,還要在「照顧原問題」與「指出前提有問題」之間拿捏,難度完全不同。對照自由作答時 35% 到 41% 的重心比例,「理解有了、執行沒跟上」的落差一目了然;測影片代理「會推理仍然按錯按鈕」的 VibeVideoBench 也撞見過同款斷層。
對評測設計的啟示因此很具體:只用多選題評助理,會系統性高估它上線後的表現。這與把規則寫清楚餵給代理的思路互相呼應,Google 把代理說明拆成 AGENTS.md、DESIGN.md、SKILL.md 三份的出發點也是「先把正確資訊交給模型」;XYBench 的實驗提醒的是另一半,資訊給足了,模型怎麼行動仍要分開驗收。
該花時間的是兩種人。一種是挑選或驗收 AI 助理的產品團隊,尤其目前用多選題或關鍵詞命中當通過標準的;XYBench 的三層指標可以直接搬進驗收表,檢查第一個建議落在哪裡、限制多早出現、讀者分不分辨得出哪個方法適用,做法與把設計驗收寫成固定規則清單的 Impeccable 是同一個方向。另一種是做評測研究的團隊,資料集與評分程式都是現成的,人類參考答案也附在資料裡。
驗收紀錄的做法也值得跟著調整:保留模型回答的全文,不要只存最後的通過標籤。同一個「重心不在目標上」的結果,可能是模型完全漏掉原因,也可能是提醒寫了但埋得太後面,兩種問題的修法不同,前者要補資料或澄清,後者要調回答的安排方式,只有標籤的話事後分不出來。
一般終端使用者不需要因為這份評測做任何事。題目是英文、程序性、單輪;中文客服那種來回確認需求、查訂單、交接真人的流程不在涵蓋範圍,Ai2 也把多語言、跨文化與多輪情境明列為還沒做的方向。要套進中文場景,得自己準備一組保留原始措辭、背景與正確目標的案例,官方沒有現成版本;中文表達把目的放在句子不同位置的習慣,也代表直接翻譯題庫不是等價的測試。
授權要先看清楚再引用。程式碼在 GitHub 採 Apache-2.0;資料集在 Hugging Face 採 CC-BY-NC-SA-3.0,屬於非商用授權,而且要登入 Hugging Face 帳號、勾選授權條款後由系統自動放行才能下載,匿名連線會被擋在門外。商用產品想把題目放進內部評測流程,先確認這條授權線踩不踩得過。另外,安裝說明裡的 clone 網址指向第一作者的個人倉庫,Ai2 公告連的是組織底下的 allenai/XYBench,這類雙址情況照組織版走最穩;組織倉庫 2026-08-31 才建立,發布前一天還在收尾更新。
採用前還有幾件事該知道:EMNLP 獎項的敘述目前僅見於 Ai2 官方公告與 repo 說明;6,268 與 6,272 的出入待原始檔核對;資料集在 Hugging Face 顯示的最後更新是 2026-11-12,335 次下載與 2 個讚是 2026-11-15 當下的數字。這批分數全部綁定 2026-11-13 公告的實驗;等模型改版重跑、裁判換人,或 XYBench 補上多語言版本,這些數字就該重讀一次,屆時最值得回查的就是誤解辨識那一欄有沒有往人類的 79% 靠近。