TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

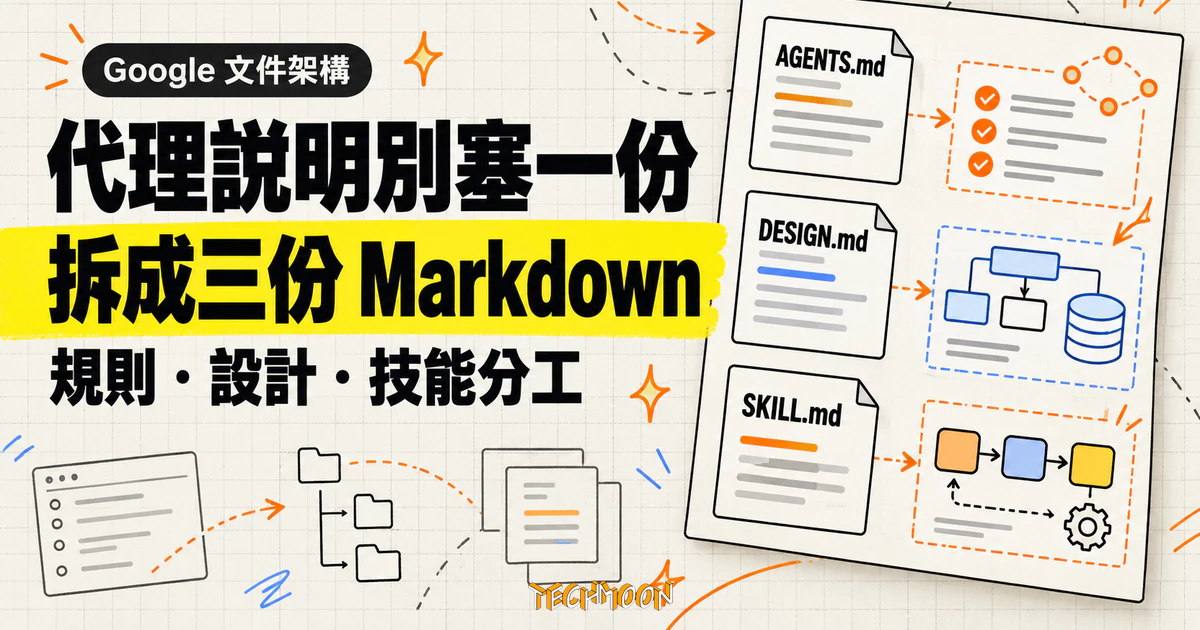
Google Cloud 在 X 發布長文,把給程式代理看的說明拆成 AGENTS.md、DESIGN.md、SKILL.md 三份檔案,分別管理全域規則、視覺設計與任務流程。文中引用的 AAIF 七月實測原文寫的是點數減少 24%,Google 轉述成 token 減少 25%;三份檔案裡也只有 DESIGN.md 是 Google 自家 2026 年 4 月推出、仍在 alpha 階段的新規格,AGENTS.md 與 SKILL.md 是多家工具已採用的開放標準。
用 AI 摘要這篇文章:
Google Cloud 的技術帳號在 10 月 23 日於 X 發布一篇署名長文,作者是在該團隊負責開發者行銷的 Tilde Thurium,主張把團隊餵給程式代理的指示拆成三份 Markdown 檔案:AGENTS.md 放整個專案的共通規則,DESIGN.md 放視覺設計系統,SKILL.md 放特定任務的操作流程。文章開頭的玩笑話下得很重:當代軟體工程最熱門的語言不是 Rust、Zig,也不是 Python,而是 Markdown,因為許多工程師花在寫提示與規格的時間,已經超過寫程式碼。這篇文章值得單獨講的原因有三個。三份檔案裡,只有 DESIGN.md 是 Google 自家今年才推出的規格,另外兩份是已經落地一陣子的開放標準。文中拿來佐證效益的實測數字,有一個跟原始報告對不上。而那份原始報告自己就警告,這種測量只跑一次,會得出方向完全相反的結論。
照 Google 文中的分工,三份檔案的責任邊界是這樣畫的:
| 檔案 | 管轄範圍 | 內容例子 |
|---|---|---|
| AGENTS.md | 全域共通規則 | 建置指令、測試跑法、哪些生成檔案不能動,每次對話都會讀到 |
| DESIGN.md | 視覺設計系統 | 品牌色票、字體、圓角與間距等設計值,加上一段風格描述 |
| SKILL.md | 特定任務流程 | 部署到某個平台、內容編修的逐步做法,需要時才載入 |
這個切的邏輯,對應的是代理使用文件成本的兩種型態。AGENTS.md 每一輪對話都會被讀,所以它必須短,內容要是幾乎每個任務都適用的規則;SKILL.md 只在任務對口時才整份載入,所以可以寫得又長又細,把一套流程從輸入、指令到完成條件交代清楚。Google 的說法是這樣能省 token、避免上下文被塞爆,讓代理不用一路揹著與當前任務無關的規則。DESIGN.md 獨立成一份,實務上的好處是變更互不干擾:品牌視覺的調整時程通常與程式邏輯不同步,各自存放,改色票不會碰到測試指令,加一條部署步驟也不必動到設計規範。
AGENTS.md 被官方文章定義為「給代理看的 README」。人的 README 講的是這個專案做什麼,代理要讀的版本還要加上環境怎麼建、測試怎麼跑、動到哪些檔案算越界,也就是「你會交代新同事的那些事」。Google 舉的範例是自家開源專案 adk-python 根目錄的 AGENTS.md:整份檔案三十行,開頭一句話交代這是做代理開發的 Python 工具包,接著用一張清單定義 Agent、Runner、Tool、Session 等核心元件,然後把架構細節與環境設定兩個主題,分別指到 .agents/skills/ 目錄下的兩份 SKILL.md。這份檔案本身就是頂層短檔把細節交給技能檔的活例子,讀者可以現在就打開對照。
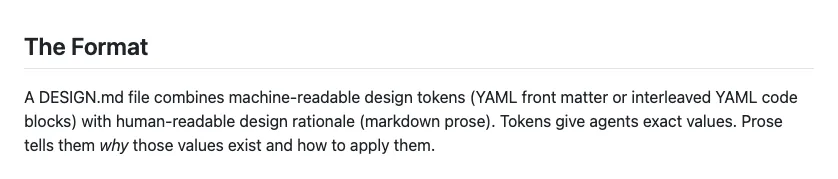
DESIGN.md 是三份裡最年輕的一份。它是一份格式規格,GitHub 上的規格庫建立於 2026 年 4 月,以 Apache-2.0 授權開源,格式分成兩層:上層用 YAML 寫機器可讀的設計值,下層用 Markdown 寫人看的風格理由。規格自帶的範例叫 Heritage,上層定義深墨色當主色、波士頓黏土紅當唯一的互動強調色、Public Sans 字體與各級字級;下層用一段文字解釋這套配色要走「建築極簡主義遇上新聞紙的厚重感」。Google 文中另外給了一個更精練的風格句,翻譯過來大意是「一份老牌大學傳統下、研究所等級的電腦科學講義」,一句話就讓代理知道成品該長成什麼氣質,色票與字級再交給上層精確指定。這份規格附了真的工具鏈:npx @google/design.md lint 會檢查 token 引用有沒有斷、元件配色有沒有低於 WCAG AA 的 4.5 比 1 對比標準,輸出是結構化的 JSON;diff 指令拿兩個版本互比,直接回報有沒有 token 層級的回歸;匯出則支援 Tailwind 設定與 W3C 設計 token 格式。代價是它目前標明為 alpha 版,規格文件自己寫著「預期會變動」。
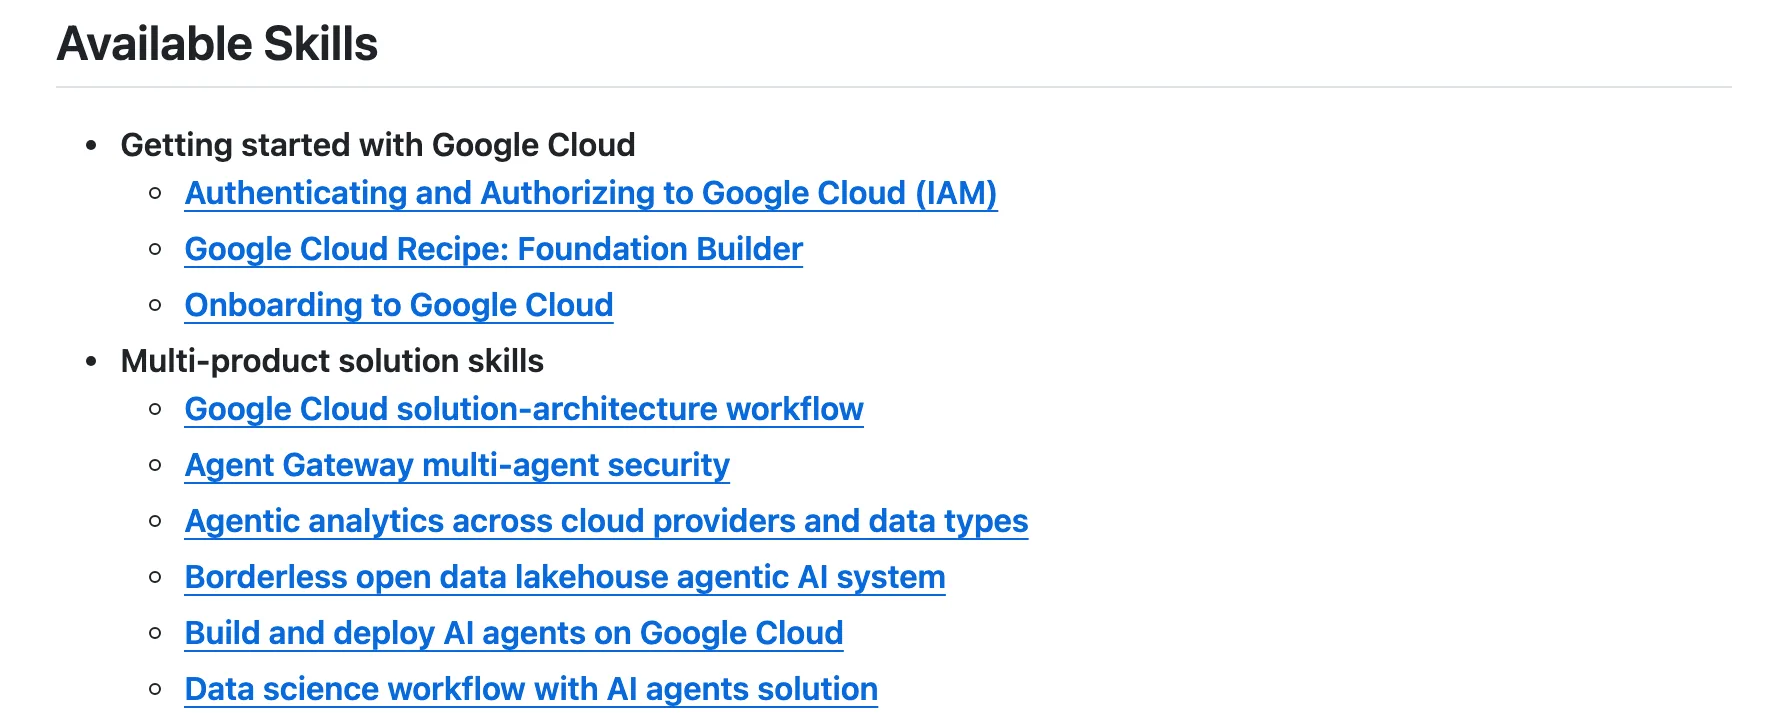
SKILL.md 管的是流程。逐步載入的機制讓代理平常只記得有哪些技能存在,接到對口任務時才把整份檔案讀進來,所以技能檔可以把前置檢查、執行順序與驗收條件寫得又長又細。這份也不必全部自己寫,Google 維護了一個名為 google/skills 的開源技能庫,以 Apache-2.0 授權,README 上列了 175 個技能連結,從 BigQuery 機器學習、資料科學工作流到一整排 GKE 叢集操作都有,一行 npx skills add google/skills 就能挑選要裝哪些、裝到專案還是全域。官方還提醒技能的用途不限於寫程式,品牌文案口吻、稿子校對、年終績效自評,凡是會重複用的指示都能包成技能。
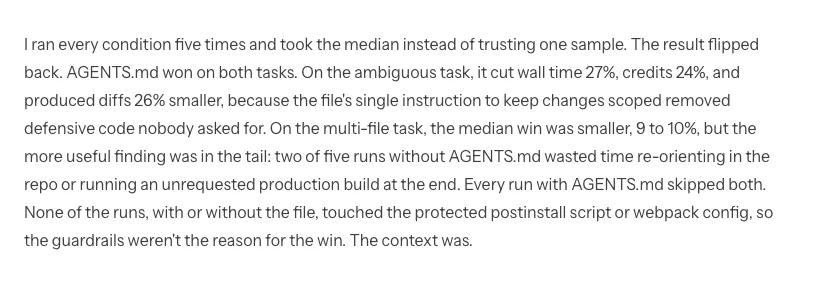
Google 文中替 AGENTS.md 的效益附了一份證據:引述 Agentic AI Foundation 在 2026 年 7 月的基準測試,寫出「模糊任務下 diff 縮小 26%、執行時間縮短 27%、token 用量減少 25%」三個數字。翻開 AAIF 的原始報告(7 月 22 日刊出,作者 Andrea Griffiths),實驗設計比一句結論扎實得多:拿一個真實的 VS Code 擴充專案 teamxray 做兩份相同複本,一份加十二行的 AGENTS.md、一份不加,用 GitHub Copilot CLI 的非互動模式跑同樣任務,每個條件跑五次取中位數。模糊任務的成果是執行時間少 27%、點數(credits)少 24%、diff 小 26%,贏的原因報告也給了:檔案裡一句「改動保持在任務範圍內」,把沒人要求的防禦性程式碼刪掉了。
問題出在剩下那個數字。原文寫的是點數減少 24%,Google 的文章把它寫成 token 減少 25%,單位和數字都對不上。AAIF 選 Copilot CLI 當測量工具的理由之一,正是它每次執行會同時回報點數、token 數與耗時三種量,但報告引的就是點數那一欄。差一個百分點或許是進位,把點數講成 token 則會誤導讀者拿這個數去估算 API 帳單。要引用這組數字,回到原文核對是最基本的動作。
原始報告裡比數字更有價值的,是方法學那段自白。作者初次測量時每個條件只跑一次,結果困難任務上看起來慢 44%、貴 41%,結論完全是反的;改成五跑取中位數才翻盤。換句話說,這種代理行為測量的單次噪音大到能憑空生出方向相反的結論,任何引用它的文章都該把這個前提講清楚,不然讀者拿到的其實是擲硬幣。
效益的真實面貌也更細緻。模糊任務的中位數贏面大,貼近日常功能開發的多檔任務中位數只贏 9 到 10%,真正的差別在尾部:沒有 AGENTS.md 的五次執行裡有兩次把時間浪費在重新摸索專案結構,或是多跑了一次沒人要求的正式版建置;有檔案的五次全部避開這兩種情況。報告同時註明,兩種條件下的執行都沒有人去動受保護的安裝腳本與打包設定,所以差距來自脈絡而不是圍欄。Google 文中「消除最壞情況」的說法,指的就是這個尾部效應,而不是每次都省四分之一。還要記得樣本規模:一個專案、一種代理、五次重跑,AAIF 自己都稱之為單一資料點,並在文末公開徵求更大規模的重測。
把這篇讀成「Google 教你寫代理文件」會錯置優先權。照 AAIF 的記載,AGENTS.md 起源是 OpenAI 為 Codex 設計的格式,Cursor、Amp、opencode、Warp、Claude Code、GitHub Copilot 的編程代理與 goose 這些工具沒有任何人強制,先後自己採用了同一份放在 repo 根目錄的純 Markdown 檔案,現在由 Linux Foundation 旗下的 AAIF 與 MCP、goose、agentgateway 一起管理。這對團隊的實際意義是可攜性:換一家代理工具,同一份指示檔不必重寫。Claude Code 原生讀的是自家的 CLAUDE.md,官方文件建議用一行 import 或符號連結把兩邊橋起來,維持單一真相來源。SKILL.md 對應的也是開放格式,Notion 先前把自家技能做成可下載的相容檔案,就是同一條路的應用。三份裡真正的 Google 原生規格只有 DESIGN.md。
檔案長度各家工具都有明確態度。Cursor 建議同類檔案五百行以內,Claude Code 的對應檔目標兩百行以內,Codex 預設把整條指示鏈合併上限壓在 32 KiB,超過就截斷,這條上限在 ChatGPT 桌面版的工作環境裡同樣適用,先前提過的說明檔分層整理可以對照著看。OpenAI 自己的官方提示詞指南也朝同一個方向走,把愈積愈長的規則刪成條件式、把技能描述截短。Google 文中「頂層 AGENTS.md 大約 12 行最理想」的講法,放回 AAIF 原文的語境是「十二行就夠起手」,是起步的最小值建議,不是經過驗證的最甜點。兩種讀法會導向不同的寫作策略,引用前值得分清楚。
內容怎麼寫才有效,AAIF 整理各工具官方文件的共識是:具體指令壓過空泛要求。「遵循最佳實踐」給不了代理任何可執行的東西,「改完原始碼跑 npm run lint」與「不要動 dist 目錄」才是能改變行為的句子。大型多包專案的對應做法是把 AGENTS.md 從單檔改成巢狀:根目錄放通則,子專案放各自的細則,越近的越優先,使用者當下的指示永遠蓋過檔案。
強制力是最容易被誤解的邊界。AGENTS.md 可以告訴代理不要動某個檔案,但它是指導,無法保證代理遵守,Amp 與 Claude Code 自己的文件都明寫了這條限制,真正的強制要靠 CI、分支保護與沙箱執行。技能檔同樣繼承這個風險,而且多一層供應鏈問題:Google 文中唯一的資安提醒是,不是自己寫的技能要先讀過內容再用,把它當成任何其他第三方依賴來對待。這句提醒放在一個鼓勵大家安裝開源技能庫的脈絡裡,份量比看起來重。
如果打算跟進,AAIF 給的起步順序比 Google 文更可操作:先寫十二行版本,內容只要套件管理器、幾條關鍵指令、一條生成檔案的邊界、一句「改動只在任務範圍內」;接著挑一個小任務,在有無檔案的狀況各跑一次,看代理在哪裡猜錯;再把每一個猜錯的地方變成檔案裡的一行。這個迴圈讓檔案長在真實錯誤上,不是長在範本上,也順便回答了「要寫多長」的問題:寫到猜錯不再出現就停。
視覺那份可以先試工具再決定深度。DESIGN.md 的 lint 檢查現成可用,對比不足、引用斷掉都會標出來,diff 指令可以在改版時擋住設計 token 的回歸;但格式還在 alpha,正式採用前要把匯出與驗證留在指令層,規格改版時才有退路。技能則可以直接從 google/skills 挑現成的,裝之前照官方提醒把內容讀一遍,這個動作對任何來源的技能檔都適用。
有幾件事目前沒有答案。DESIGN.md 與 SKILL.md 的效益沒有同等級的量化證據,AAIF 測的只有 AGENTS.md 一份,把 27% 類推到另外兩份是沒有根據的。十二行是起步值,不是科學上限。這套分工在多人大型專案上是否同樣成立,AAIF 明說還等更多人重測。本文的查核時間是 2026 年 10 月 25 日,DESIGN.md 規格與其 lint 規則在 alpha 階段都可能調整,採用前值得再看一次官方文件。
真正穩固的結論其實與百分比無關:三份檔案的價值在於讓每一份說明只有一個責任、一個維護者和一個版本,改品牌色不會動到測試指令,加一條部署步驟不必重寫全部規則。拿這個框架去整理已經亂掉的提示詞,幾乎穩賺;期待那三個數字在自己專案重現,則要自己跑五次才知道。