TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google 於 2026 年 11 月 10 日宣布 Cloud Pathways 在 GKE 正式開放,把訓練 Gemini 的單一控制器執行環境交給所有客戶:一個 Python 程式描述整份工作,資料搬移與多切片相依安排交給執行系統;官方宣稱前 90 天已承載超過 1.3 億 TPU 晶片小時,Slurm 整合仍在預覽。
用 AI 摘要這篇文章:
Google 在 2026 年 11 月 10 日透過 Google Cloud 部落格公告,把內部用來訓練與服務 Gemini 的分散式機器學習執行環境 Cloud Pathways,正式開放(GA)給所有客戶在 Google Kubernetes Engine(GKE,Google 代管的 Kubernetes 叢集服務)上使用。前一天,開發者部落格先刊出長篇架構說明,由十位具名作者執筆,涵蓋軟體工程師、產品經理與開發者關係團隊。這次變動一句話:原本只有 Google 自家前沿模型用得到的訓練執行層,變成 Google Cloud 產品目錄上的一員,官方定位是 AI Hypercomputer 運算架構的核心 runtime。公告裡的歷史註腳是,這套系統由 Google DeepMind 為了訓練與服務自家前沿模型而打造,如今每個 Google Cloud 客戶都能用到同一套單一控制器 runtime、共享記憶體的 sidecar 容器與彈性容錯。
公告同時帶出一個規模數字。Google 宣稱,過去 90 天已有領先的 AI 公司與全球企業用 Pathways on GKE 累積處理超過 1.3 億個 TPU 晶片小時,橫跨多個 TPU 世代。這是供應商自己的統計,沒有第三方查證;它能證明這套系統承載過大量真實工作負載,但不能換算成加速倍數,也推不出客戶數量。其中一家官方未具名、被描述為全球最大消費科技公司之一的客戶,每季在 Pathways 上消耗超過 1 億晶片小時,跑的是批次與強化學習推論。
這次 GA 有明確的範圍邊界,先看自己在不在裡面。適用的硬體是 TPU v5e、v5p、Trillium(v6e)與 Ironwood(TPU 7x),官方說法是在所有支援這些 TPU 的 Google Cloud 區域開放;軟體需求是 JAX 0.10.1 以上,Google 以版本化容器映像檔的形式發布。值得留意的是,這份 GA 清單到 Ironwood(TPU 7x)為止,11 月剛發表的第八代 8tx 與 8i Max 並沒有出現在上面(第八代兩款系統的定位可對照我們先前的整理);打算用最新硬體搭配 Pathways 的團隊,部署前應先向 Google 確認支援狀態。要留意各區域支援的 TPU 世代不盡相同,鎖定特定晶片部署前,仍以目標區域的供應清單與配額為準。TPU 的取得途徑也在變多,除了 Google Cloud,2027 年起會透過 Oracle Cloud 開放企業租用,不過官方文件列出的 Pathways 入口,目前只有 Google Cloud 的 GKE 與 Cluster Director 兩條路。
真正該花時間研究的是工作負載形態。官方架構文章把痛點寫得很具體:當工作從「每台設備跑同一份程式」變成「多份不同程式要接續合作」,例如流水線訓練的前後段、強化學習裡的取樣器、評分模型與訓練器,協調就會變成主要成本。在 GKE 上跑這類多程式組合的 TPU 團隊,是這次開放的主要受影響者。
反過來說,三種團隊可以完全不動。工作負載是單一 SPMD 程式(所有設備跑同一份程式、以集合通訊同步)的團隊,既有的 JAX 多控制器模式照常運作,官方也明說這種情境本來就合適;不以 GKE 為部署環境的團隊,這次開放暫時碰不到;而 Pathways 執行的是 JAX 程式,容器映像檔的版本要求也綁著 JAX,從官方文件看,以 PyTorch 為主的團隊這次沒有直接切入點。
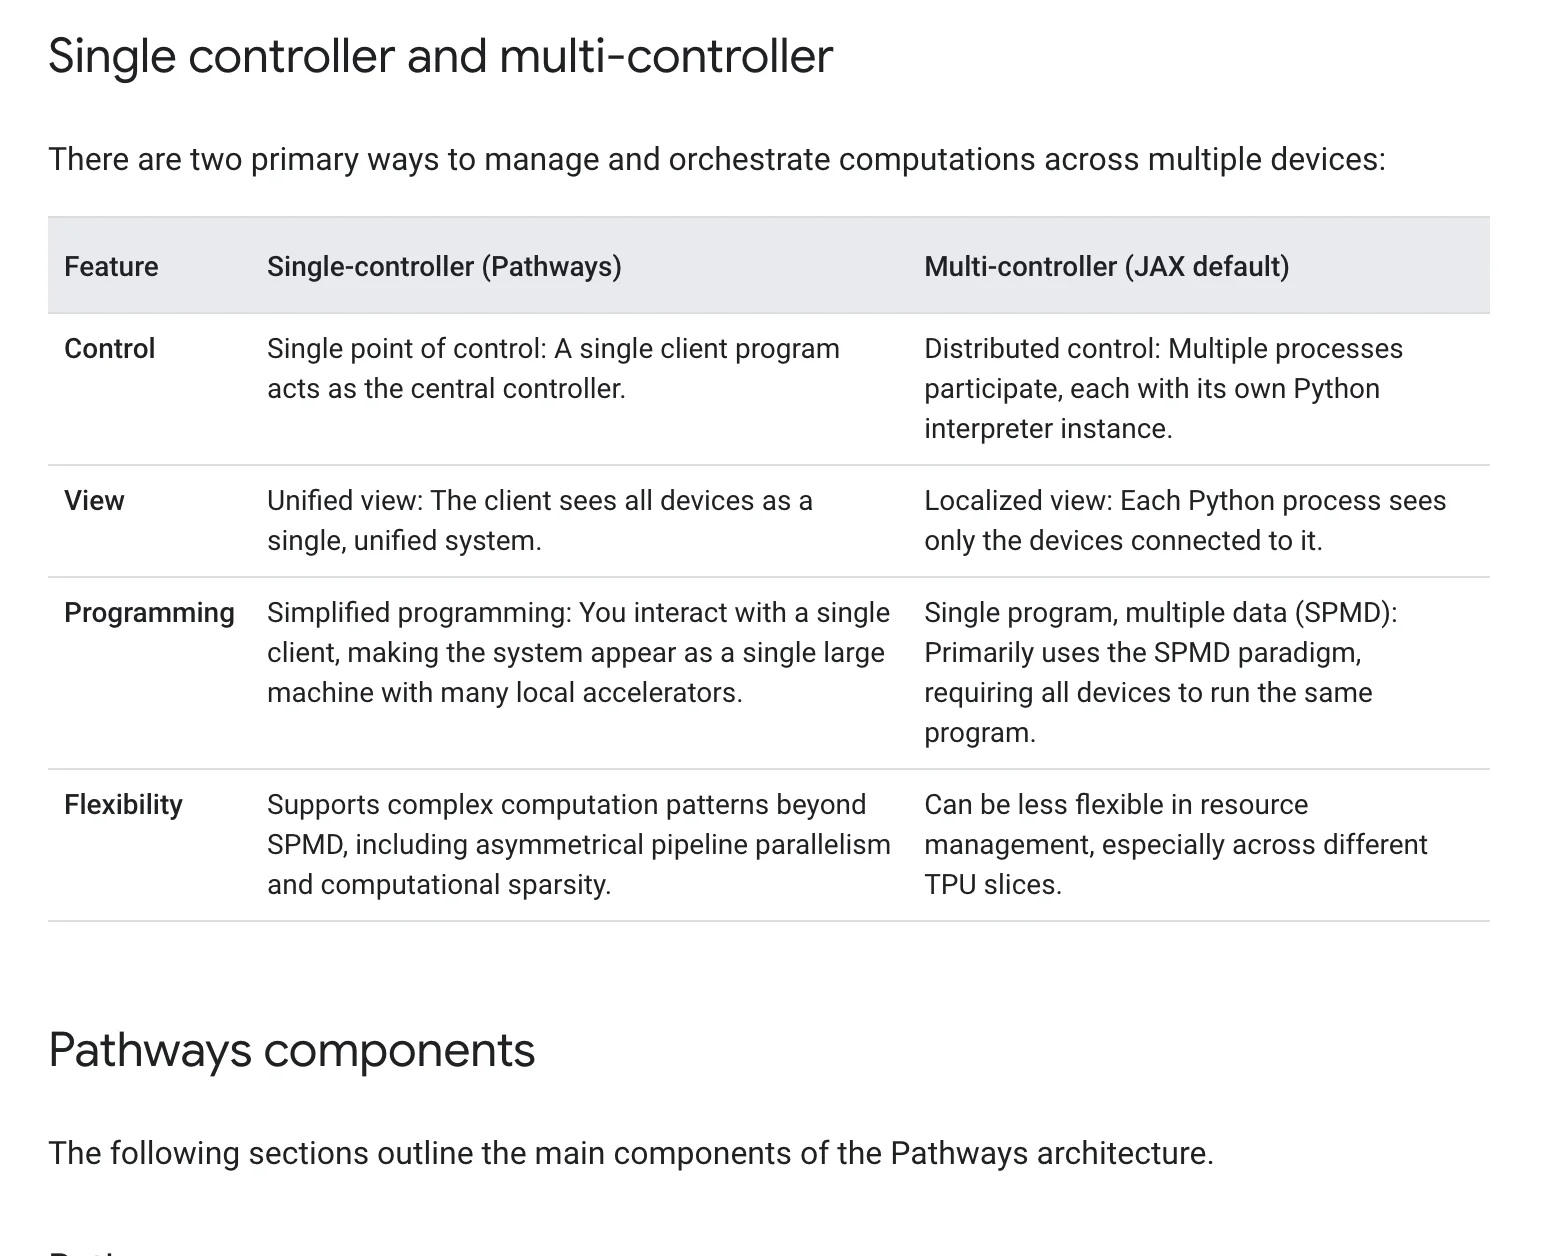
要理解 GA 前後的差異,得先看原本的方式。官方公告對現況的描述是:預設的多控制器 JAX 裡,每台 TPU 主機各跑一個獨立的 Python 直譯器,只看得到自己相連的設備,所有設備以 SPMD 模式同步執行同一份程式。這種架構在程式一致的場景很有效率,可是一旦工作變成多程式、多切片的組合(官方縮寫 MPMD),跨切片的資源管理就變得複雜而脆弱。開發者文章用具體例子說明卡住的地方:流水線把模型拆成前後段後,第一段在算第一批資料時,後面幾段設備只能等;強化學習迴圈裡,取樣器產生答案、獎勵模型評分、訓練器更新參數,三份程式長短不同,若只能一段接一段跑,忙碌階段旁邊的硬體就是閒置的。
多控制器還有兩個結構性代價。每個行程從頭到尾占住自己的加速器,工作結束前誰也不能還,於是需求小的階段留著多餘晶片空轉,團隊共用叢集時只能切成一個工作一個配置;而且一旦某台機器故障,集合通訊卡死,整份工作回退到上一個檢查點重來,也不能中途加減設備。
Cloud Pathways 換掉的是控制架構。公告原文的說法是:以開源的 Interim Framework Runtime(IFRT)為基礎的統一單一控制器架構,設定 JAX_PLATFORMS=proxy 並搭配 pathwaysutils 之後,單一個 JAX client 可以把多個大型 TPU 切片當成全部接在本機一樣編排。講白一點,開發者在一台普通 CPU 機器上寫一個 Python 程式,描述整份計算怎麼拆、每塊跑在哪、輸出送到誰手上,資料搬移、相依順序與硬體映射交給執行系統處理。
背後有幾個搬動的零件值得認識。程式碼指向的是虛擬設備,由資源管理器把它映射到實體晶片,故障時可以重映射,這也是彈性訓練的基礎;因為程式只認虛擬設備,編譯甚至可以在實體晶片到位前先開始,讓準備與資源開通重疊。派送採非同步,上一塊還在算時,系統就先替下一塊保留緩衝區、排好傳輸路徑,讓資料搬移與計算重疊,控制端因此不會卡在關鍵路徑上。至於多個設備同時就緒時誰先誰後,由集中排程器給出一致順序,避免各自挑工作造成集合通訊互相等待。數值計算本身仍分散在各晶片上跑,單一控制器掌握的是描述與安排,資料不必先繞回控制端。
GA 公告列的另外兩項能力補上了執行層的周邊。單一控制器同時負責圖評估、雲端儲存空間上的編譯快取(同樣的計算不必每次重編譯),以及跨切片的非同步 XLA HLO 派送;與 TPU 主機同住(colocated)的 Python sidecar 容器則支援共用記憶體,把分散式資料載入、檢查點寫入這類吃 CPU 的 Python 邏輯直接放到 TPU 主機上執行,不用繞經遠端呼叫。
GA 公告列出的四項能力裡,彈性訓練對長時間工作的成本影響最直接。開發者文章揭露的背景數字很有說服力:Gemini 2.5 的訓練曾經每小時被硬體故障打斷多次。在 SPMD 模式下,一台機器故障會卡住整個集合通訊,工作只能回退到上一個檢查點整份重來;大規模訓練的檢查點間隔若是以小時計,每次故障代表的就是可觀的算力白費。
Cloud Pathways 的對策是用主機記憶體快照做動態重分片,官方說明是硬體故障時可以把訓練縮到剩下的 N-1 個切片繼續跑,客戶端程式不必崩潰重啟。公告裡的客戶案例 ZenteiQ 用它跑科學基礎模型,技術堆疊是開源訓練框架 MaxText 搭配強化學習函式庫 Tunix,透過 Cluster Toolkit 部署在多切片 Trillium 叢集上;創辦人 Sashikumaar Ganesan 的說法是,搭配主機快照後,中斷的復原時間壓到最低,工程師不必再花時間盯著工作健康狀態、手動重啟。這段是客戶在供應商公告裡的現身說法,採用時仍應以自己環境的復原演練為準。前述那家未具名的消費科技巨頭,則被描述為與 Google 共同設計了彈性原語,並計畫從批次與強化學習推論擴展到預訓練,這是官方敘事裡最接近大型落地案例的一段,同樣屬於供應商口徑。
同一節還有兩個對日常開發有感的設計。互動模式讓使用者從筆電或終端機直接連上叢集,在同一個 Python 程序裡設中斷點、檢查每個設備上排隊的工作,偵錯體驗回到單機時代;這對照的是多控制器模式的除錯負擔,官方描述是:腳本要用啟動器推到每台主機、有些協調臭蟲只在跨機時浮現、卡住時每個行程停在不同的集合通訊上,沒有任何一個地方看得到整份工作的全貌。Shared Pathways Service 則把一池 TPU 切片當成長駐服務,多個使用者按需取用、用完歸還,研究團隊共用一個叢集的容量不必各自拉起整套環境。不過官方也明講了邊界:每顆晶片都忙的時候,下一個工作就得排隊,共享池並沒有創造額外容量。
回到開頭那個規模數字,值得拆開來讀。開發者文章給了一組頻寬對比,說明協調為什麼是瓶頸:TPU v5p 每顆晶片在組內有 1,200 GB/s 的雙向頻寬,跨出組、走向資料中心網路只剩約 50 Gb/s(約 6 GB/s),差了約兩個數量級。設備越多的工作,通訊跨越組界線的次數越多,每一步的等待時間直接進入步驟時間,這也是加晶片不等比例變快的結構性原因。Pathways 解的是這段等待的安排問題,至於每種工作負載實際省下多少,官方只提供了示意動畫與概念說明,沒有給可套用的加速保證,動畫裡的時間比例不能拿來估算自己的訓練。
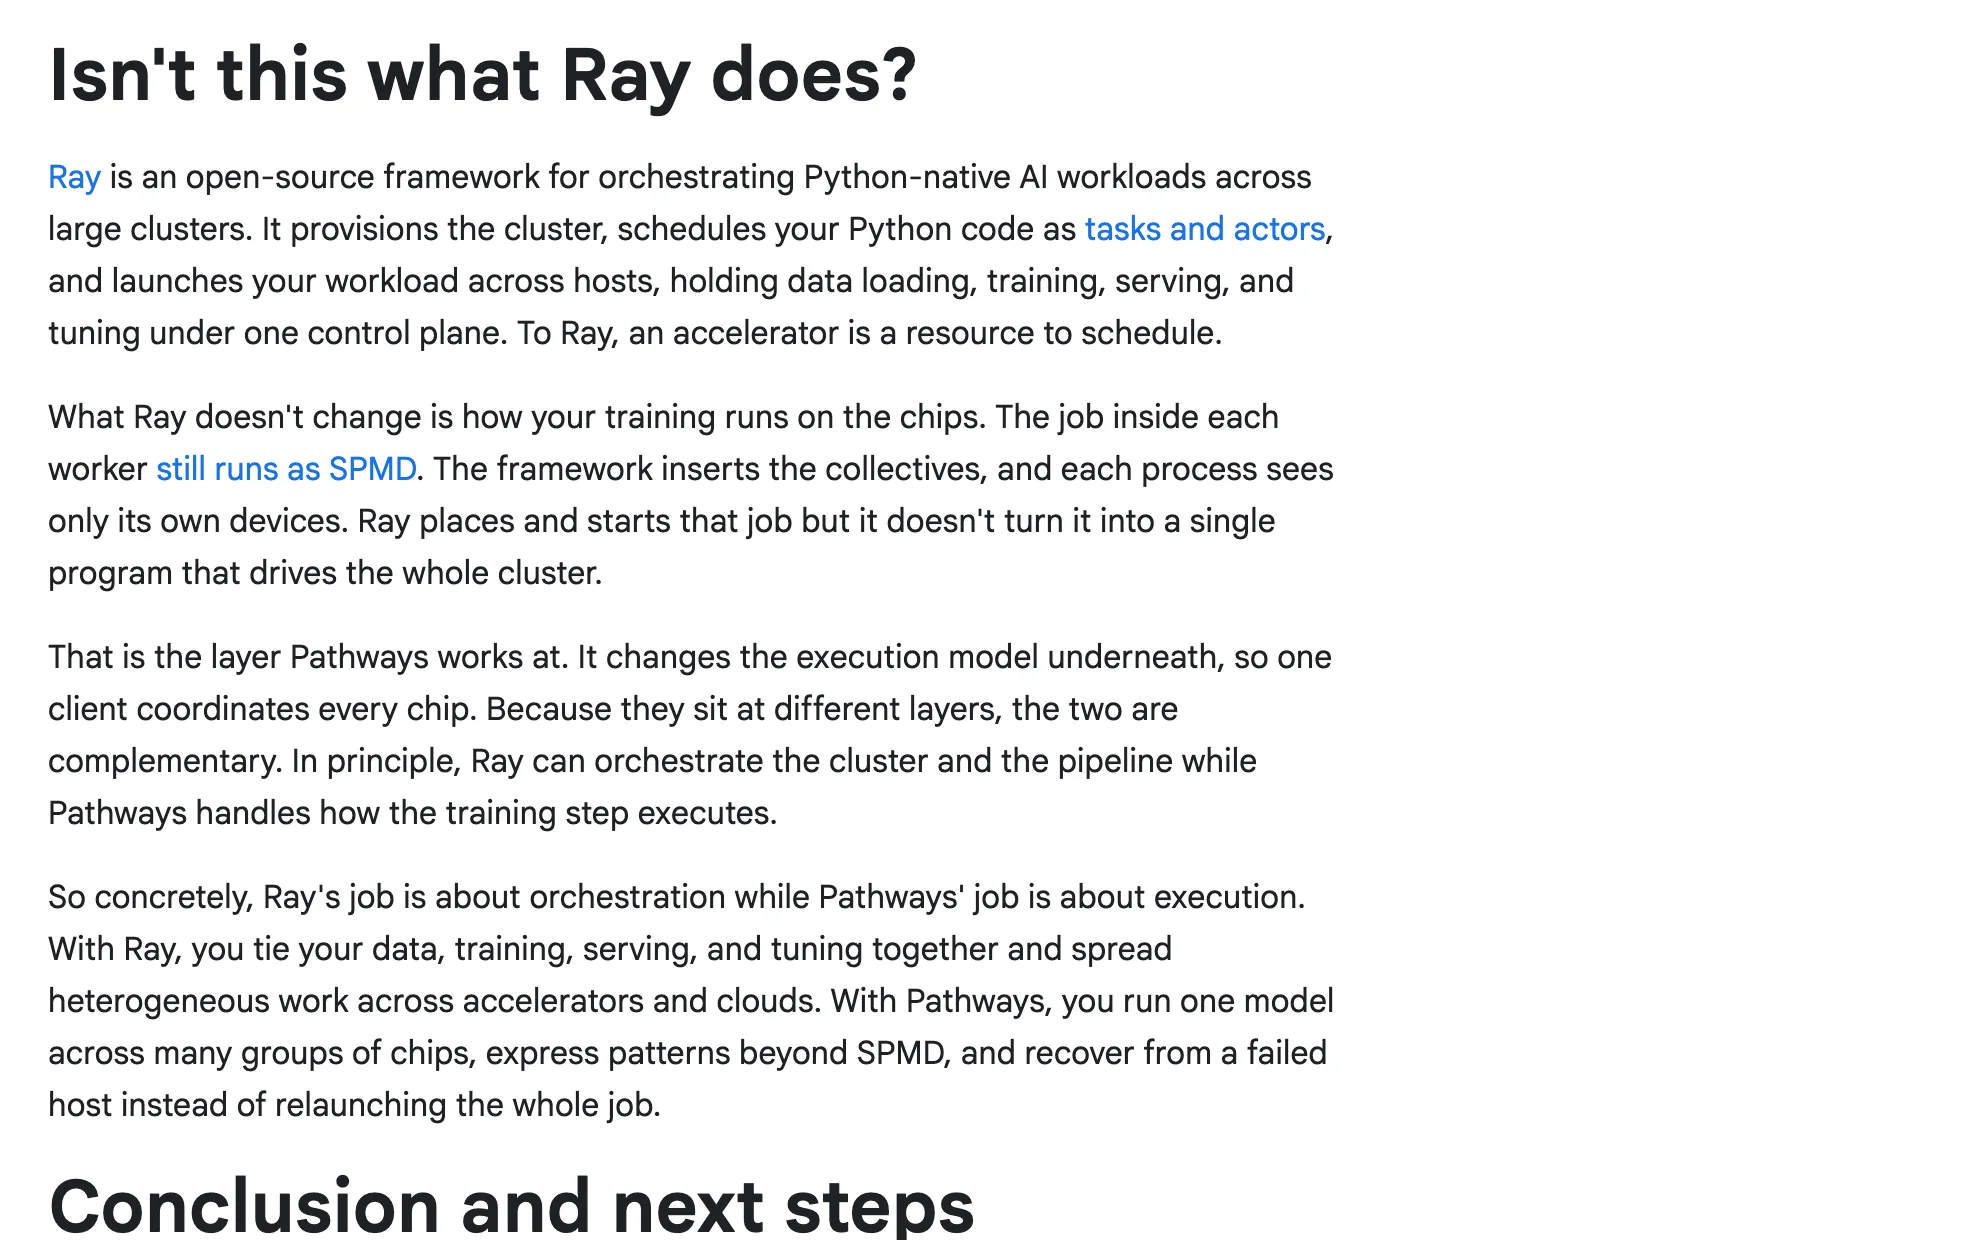
已經在用 Ray 的團隊不必緊張。開發者文章特別用一節回答「這不就是 Ray 做的事」,結論是兩者互補:Ray 管的是編排層,把資料載入、訓練、服務、調校綁在同一個控制面下調度,在 Ray 眼中加速器只是一種可排程的資源;Pathways 改變的是晶片上的執行模型,讓一個 client 驅動整個叢集。官方的分工說法是 Ray 的工作在 orchestration,Pathways 的工作在 execution,兩層可以疊著用,不需要拆掉既有 Ray 工作流。我們先前在 TPU 8tx 與 8i Max 的發表整理提過,Pathways 當時以軟體更新之姿隨硬體消息登場,這次 GA 等於補上了完整文件、生產指南與正式支援的承諾。
多數團隊的答案是暫時不用動。如果目前的工作是單一 SPMD 程式、利用率正常,既有模式沒有問題,遷移單一控制器架構不會自動帶來收益,官方也沒有宣稱如此。
值得動手的族群,判斷順序建議是先量再換。從既有訓練日誌確認各階段之間的等待占整體時間多少,等待占比高、階段長短不均、或故障復原成本高的工作(多日預訓練、強化學習迴圈、多階段流水線),才是單一控制器可能發揮的場景。確認之後照官方文件的 GKE 建叢集指南(支援 gcloud 與 Cluster Toolkit 兩條路)小規模起一個可重播的工作,固定輸入條件量步驟耗時、設備利用率與故障復原時間,再決定要不要擴大採用。官方這次也把生產指南一次備齊,涵蓋批次工作、互動筆記本、彈性訓練、多主機推論、JAX 工作搬移與疑難排解;想在進叢集前先理解系統,Pathways 的架構出自 2022 年公開的論文,配套工具 pathwaysutils 與 MaxText 都放在 GitHub 上開源。至於以 Slurm 為排程器的 HPC 團隊,Cluster Director 上的 Pathways 整合仍在預覽,公告沒有給轉正式的時間表,依賴預覽功能前值得先向 Google 確認支援範圍。
兩件事在這批官方文件裡找不到答案。其一是計價:GA 公告與文件都沒有提及 Pathways 本身怎麼收費,客戶目前能確定的成本仍是 TPU 與 GKE 的既有計價,導入前的總成本應向 Google Cloud 帳號團隊核對。其二是時程:Slurm 整合的預覽轉正式沒有日期,支援的 TPU 清單與 JAX 版本門檻未來也可能調整。
這兩項邊界都會跟著 Google 後續公告變動:Slurm 整合轉正式、出現獨立計價資訊、或支援硬體清單調整時,上述範圍就不再成立,採用前應以當下的官方文件為準。