TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

webAI 於 2026 年 11 月 4 日(台北 11 月 5 日凌晨)開放 8.8B 推理模型 TwIL-8B 完整權重,以 IBM Granite 4.2-8B 為底座,提供長思考 verbose 與短思考 balanced 兩份模型。官方成績表中 MATH-500 的 98.2 分屬短思考版,LiveCodeBench 的 81.6 分屬長思考版且測量版本未紀錄;每題近兩萬 token 的輸出預算與非商業授權,是下載前要先算的兩筆帳。
用 AI 摘要這篇文章:
台北時間 11 月 5 日凌晨 2 時 53 分,webAI 在 X 上貼出一則公告:8.8B 參數的推理模型 TwIL-8B 開放權重,而且開的幅度相當徹底。推文的第一句就寫明了這個模型的主張:「完成任務的成本,比執行任務的模型的原始智力更重要。」
這個模型從 IBM 的 Granite 4.2-8B 底座做全參數後訓練,能力集中在可以檢查答案的任務:競賽數學、寫程式與指令遵循。實際規模是 87.9 億參數的密集架構(dense,40 層、隱藏維度 4096、32 個注意力頭搭 8 個 KV 頭),生成時全部參數都會參與運算,跟生成時只啟動部分專家的混合專家模型相比,不能用總參數直接比大小。真正少見的地方在於,webAI 一次開出了兩份都要完整下載的權重:長思考的 verbose 版,以及推理軌跡偏短的 balanced 版。兩份模型共用同一套架構與分詞器(詞彙表 100,352),差別只在訓練後段加的那段長度獎勵。
對想在自家硬體上研究推理行為的人,這是很好用的對照材料;對想直接放進產品的人,模型卡與授權條款把邊界畫得很清楚:用途限非商業研究與教育,知識題與代理能力都明說不在它的守備範圍。下載之前,這張成績表有幾個問題值得先弄清楚:每個數字來自哪一份權重、省下來的 token 是跟誰比、以及 5 GiB 的檔案下載後還需要什麼。
TwIL-8B 的兩個版本寫在儲存庫的檔案配置裡。用 transformers 的 from_pretrained 直接載入,拿到的是 balanced;要長思考版得指名 verbose/ 資料夾。換句話說,這是兩份各自完整的模型,可以把想省思考的需求和想衝正確率的需求分開安裝。
訓練流程分三段。先把整份模型在數學、科學與指令遵循的推理範例上做全參數微調;接著用強化學習(GRPO/DAPO)獎勵答對,得到傾向寫長推理過程的 verbose;再往後還有一段帶長度條件的強化學習,獎勵用更短的路徑解題,得到 balanced。兩份權重都直接合併輸出,不需要先抓底座再套用調整檔。
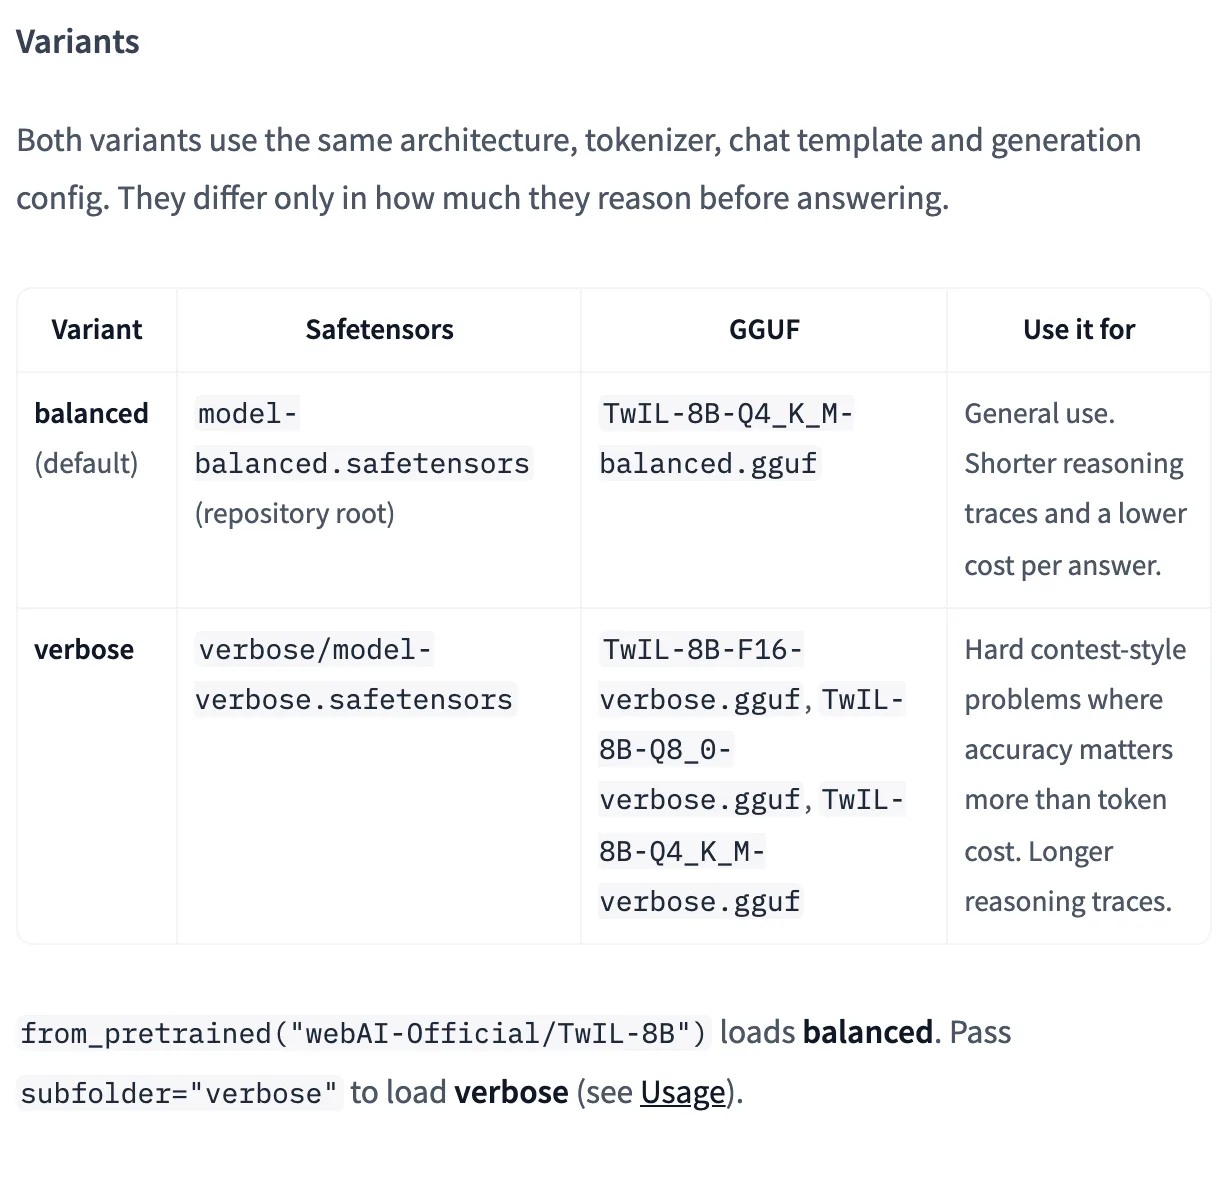
所以 balanced 這個名字要當成配方選擇來讀。它不是「精簡版」或「關閉思考模式」,而是把「提早收筆值不值得」這個取捨直接訓進權重裡。官方在兩份權重上的建議也不同:一般用途用 balanced,難題衝正確率用 verbose。下載時要注意儲存庫一次放著兩份完整權重,官方指令靠資料夾過濾只抓其中一份(例如排除 verbose/ 或排除 GGUF),全抓下來硬碟會一次少掉 60 GiB 以上。
webAI 同一個 TwIL 家族先前還開過 TwIL-LM3 與 TwIL-LM3-Pro,那是 3B 參數的形式邏輯模型;這次的三條線(數學、程式、指令遵循)延續了「挑可驗證任務做深」的路線。近期的開放權重模型多半也走這種單一任務聚焦,像 PLaMo 3 Translate 開放權重把本機翻譯做成可以指定術語的專用模型,是同一種打法。
模型卡的成績表用一個小小的劍號(†)標出讀法:打記號的項目是在 verbose 上測的,還沒在 balanced 上跑。這記號涵蓋的範圍不小:程式類全數在內(LiveCodeBench 81.6、HumanEval 93.2、MBPP 93.7、CRUXEval 97.1),指令遵循的 IFBench 74.4,知識類的 MMLU-Pro 76.5 與 HLE 12.6 都是。沒打記號、屬於 balanced 的,有 MATH-500 的 98.2、AIME 與 HMMT 這幾項競賽數學,以及 GPQA Diamond 與 IFEval 兩項。
這個區分直接影響怎麼讀公告。推文裡「對 Qwen3.5-9B 拿下 16 分領先」指的是 LiveCodeBench 的 81.6 對 65.6,而那是 verbose 的數字,預設下載的 balanced 還沒測過這項。模型卡的限制段甚至自己提醒:TwIL 這次測量用的 LiveCodeBench 版本與出題日期範圍沒有留下紀錄,競品標的是第六版,引用這個差距前應該先確認。
另一層但書是誰在跑這些數字。TwIL 的成績全部來自官方內部評測(開思考、高努力設定、單一評測環境);競品數字則取自各廠模型卡與第三方評測,模型卡註明取得日期為 11 月 3 日,沒有重新執行。HLE 那欄還多一層:TwIL 用選擇題方式計分,引用的競品是文字作答再由裁判評分,作答形式不同,分數只能粗略對照。
把整張表讀完,輸贏其實很平均。對大小最接近的 Qwen3.5-9B(官方標 9.7B 參數),13 個共同項目是 7 勝 6 負;對參數量約 3.5 倍的 Gemma 4 31B,是 3 勝 11 負。整張表它排在最前面的有三項:MATH-500(98.2,對 Qwen 的 96.6 與 Gemma 4 31B 的 87.9)、AIME 2025(88.3,對 Gemma 4 31B 的 87.1)與 LiveCodeBench†;IFEval 91.8 則與 Qwen 的 91.5 幾乎打平。領先的項目集中在程式與指令遵循,知識類全數落後:GPQA Diamond 70.2,落後 Qwen 11.5 分、落後 Gemma 4 31B 14.1 分。模型卡自己下的註解是「它不是知識模型」,這類題目吃的是隨參數量縮放的儲存知識,長度獎勵補不上來。
模型卡也給了對前緣的自算涵蓋率:推理類項目達前緣最佳成績的 88% 到 93%(LiveCodeBench 93%、IFBench 92%、HMMT Nov 2025 90%),最難的 HMMT Feb 2026 只有 69%,GPQA Diamond 75%,HLE 26%。這組對照有個時間點細節:模型卡挑的 GPT-5.5、Claude Opus 4.8、Grok 4.3,已經是最後一批還公布這組題目的前緣模型,更新的 GPT-6.1 Sol、Claude Opus 5.5、Grok 4.7 只在 HLE 一項還找得到數字,這類對照表往後只會更難湊齊。
「每題成本」是 TwIL-8B 的核心主張,模型卡給了一張把長度和正確率放在一起的表。
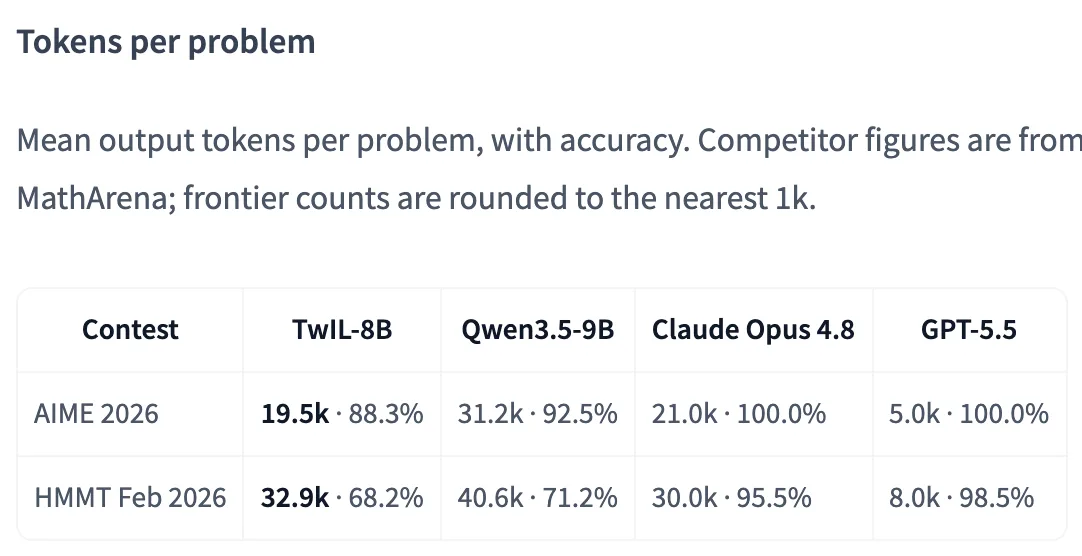
| 競賽題組 | TwIL-8B(balanced) | Qwen3.5-9B | Claude Opus 4.8 | GPT-5.5 |
|---|---|---|---|---|
| AIME 2026 | 19.5k・答對率 88.3% | 31.2k・92.5% | 21.0k・100% | 5.0k・100% |
| HMMT Feb 2026 | 32.9k・答對率 68.2% | 40.6k・71.2% | 30.0k・95.5% | 8.0k・98.5% |
對 Qwen3.5-9B,省 token 的帳成立:AIME 2026 每題 19.5k 對 31.2k,少了 38%;HMMT Feb 2026 每題 32.9k 對 40.6k,少了 19%。代價也寫在同一張表上,正確率分別少了 4.2 和 3.0 分。只引用「省 38%」而不提那 4.2 分,等於把取捨刪掉一半。表裡的 TwIL 數字來自 balanced;verbose 的推理軌跡只會更長,官方沒有另外提供它的每題統計。
對前緣模型,這筆帳就翻過來了。GPT-5.5 解同樣的 AIME 2026 題目,每題只要約 5k token 而且全對;Claude Opus 4.8 用 21k 也是滿分。模型卡自己算了這筆帳:balanced 每題的 token 消耗約是 GPT-5.5 的 4 倍。所以「省」的基準是同級開源模型,拿到雲端旗艦旁邊比,它反而是話多的那一邊。
兩個閱讀上的緩衝也值得記住。競賽題組只有 30 到 33 題,一題就值約 3 個百分點,個位數的輸贏在統計雜訊範圍裡;各家模型的分詞器切字方式不同,同樣一段推理會被算成不同的 token 數,官方因此把這組比較定位為方向性參考,不是同一把尺的測量。
檔案大小這層可以直接核對。完整精度的 bf16 每份 16.38 GiB;量化版方面,下載連結回報的實際大小,balanced 的 Q4_K_M 是 4.98 GiB(5,347,917,568 bytes),verbose 的 Q8_0 是 8.70 GiB,verbose 另有同為 4.98 GiB 的 Q4_K_M 與 16.38 GiB 的 F16 可選。對照近期其他開放權重模型動輒得檢查檔案、硬體與授權三道門檻(例如 Kimi K3.1 Pro 的開放),TwIL-8B 的容量負擔算是親民。
但容量數字描述的是下載檔,推理時的空間帳要另算。官方對 4.98 GiB 版的定位是給 CPU 或顯示卡記憶體有限的機器使用,沒有提供任何消費級硬體上的速度或記憶體實測,跑起來快不快要自己試。上下文上限 131,072 token 沿用底座設定;官方程式範例把最多可新生成的 token 設成 32,768,llama.cpp 的示範指令同樣給了 3 萬多的生成預算。原因就在前面的每題統計:balanced 解一道競賽題平均要寫 1.9 萬到 3.3 萬 token,預算給得太短,截斷的會是推理中段,最後答案還沒寫出來。輸入題目、已寫出的思考、最終作答,全部要放得進上下文與輸出額度裡。
還有一個容易誤會的開關。聊天模板預設打開 <think> 推理區塊,也允許用參數關閉思考或調低推理努力來換速度。模型卡講得很直白:低努力模式的分數會明顯下降,卡片上所有數字都不是在這些模式下測的。把「關掉思考的速度」和「開著思考的分數」放進同一句話,就湊出了一個沒被測量過的組合。另外出廠的生成設定是取樣式的(溫度 1.0、top-p 0.95),同一題兩次跑可能走不同路徑,單次快慢不足以代表這份權重。
至於量化版要留意:全部成績都來自 bf16 權重,官方明說 GGUF 會有偏差,Q4_K_M 最可能。量化名稱同為 Q4_K_M 的檔案有兩個(balanced 與 verbose 各一),下載時要在指令裡指名檔名,拿錯邊不會有任何警告。
知識是寫明的弱項。GPQA Diamond、MMLU-Pro、HLE 三項全部落後給更大的模型,HLE 12.6 只達前緣最佳成績的 26%。推理訓練把「想得更久」換成分數,但換不到存在權重裡的知識存量。對使用者的意義很實際:拿它當通用問答或知識庫,是用錯了地方。
代理能力則整段空白。SWE-bench、SuperGPQA、工具使用、完整代理任務都沒有評測;模型也沒有在 Granite 4.2 攜帶的調校之外,另外接受安全、偏好或工具使用訓練。程式題的高分只證明它能在指定題目上寫出對的答案,讀檔案、選工具、看錯誤訊息、持續修正這些代理工作,中間沒有證據可以接。把它裝進聊天介面,不會自動補出這段空白。
訓練資料的清理範圍也有一條誠實的線。數學、科學與指令遵循的訓練池以連續 13 個單位的序列(13-gram)比對做了清理,覆蓋 AIME 各年、兩場 HMMT、MATH-500、GPQA Diamond 等評測集;但 HMMT Nov 2025 和 HumanEval、MBPP、CRUXEval 不在清理集合裡,程式訓練資料的清理紀錄也沒有提供。這當然可以讀成「部分題庫不在保證範圍」,而不是任何作弊暗示,引用高分時把這條邊界一起帶上會更準確。另外模型卡的語言欄位只列英文,中文任務的表現要自己驗,沒有官方數字可以引。
授權條款是這次開放最容易誤讀的部分。TwIL-8B 的後訓練權重採用 webAI Non-Commercial License ver. 1.0,第 3.3 條寫得明確:這份作品與其衍生作品,僅可用於非商業目的,而條款對「非商業」的定義是「非商業的研究與教育用途」。在營利組織內部把模型接進日常流程,並不在條款列舉的範圍裡,那是需要另行取得授權的地帶。要對外散布,得附上完整條款並保留原有聲明;自己的衍生作品可以另定條款,但用途限制必須跟著帶過去。
底座的情況是另一套。IBM 的 Granite 4.2-8B 採 Apache 2.0,儲存庫裡也確實附了 Apache 2.0 的授權文字與 IBM 的歸因。Apache 2.0 允許衍生作品改用不同條款,只要保留歸因,這正是這個儲存庫同時放兩份授權檔的原因。換句話說,「公開下載」與「可以商用」在這裡是兩件事:研究與教學可以自由進行,放進付費產品需要另外的授權依據。近期的開放權重模型在授權邊界上差異很大,Mistral Large 4 的 MEOW 條款就是另一種畫法,下載前逐份核對已經是標準動作。
條款裡還有一條商標限制:不得用 webAI 的名稱或標誌暗示它替你的衍生作品背書。對要對外分享成果或寫論文的人,引用歸因沒問題,宣傳措辭上要留這條線。
給研究者的建議很具體:把題組、取樣參數與輸出預算固定,兩份權重各跑同一組題目,答對率、每題輸出長度、實際耗時三個數字一起記,再對照模型卡的統計。這正是這次開放最有價值的實驗設計,兩份只差一段長度獎勵的權重,把「多想一步值幾分」變成可以在本機重現的問題。給考慮商用的人,紅線也很清楚:先取得授權,再談整合。
幾個未定案的事項值得設個回查時點。所有打 † 的項目在 balanced 上的成績,官方還沒跑,補上之後這張表的讀法會再變一次;LiveCodeBench 的測量版本、程式訓練資料的清理紀錄、量化版的實際分數,都還是空格。模型卡本身也在持續更新,公告後四天(11 月 8 日)儲存庫還有修改紀錄,競品數字的取得日期停在 11 月 3 日。到 11 月 9 日,儲存庫累積了 241 個讚與超過 2.2 萬次下載,熱度有了,獨立的第三方重測還沒有跟上。引用任何單一數字前,回模型卡看一眼那個 †,是最不花時間的自保動作。