TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

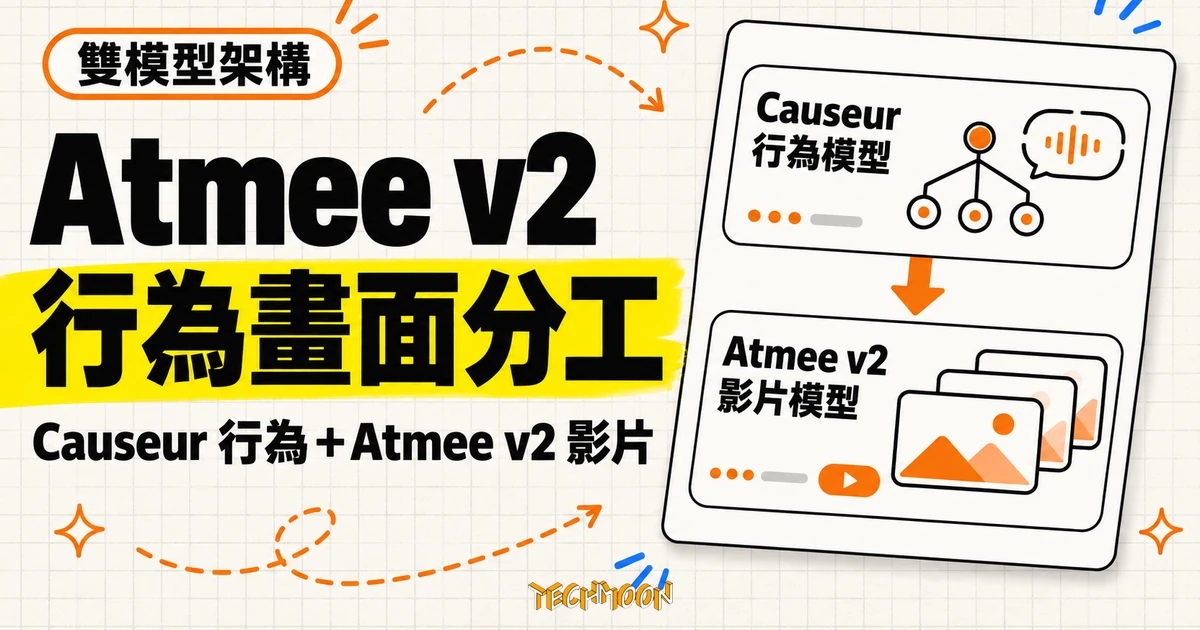
Atmanity 於 2026 年 11 月 4 日發布 Atmee v2 即時數位角色模型,把對話行為判斷交給 Causeur、畫面生成交給 Atmee,提供全包對話、只接畫面與純語音三種整合模式。v2 全包每分鐘 2 點、只接畫面 1 點、純語音不分模型 1 點,每點單價依方案落在 0.105 至 0.150 美元;建立 v2 角色需 Growth 以上方案或邀請碼,與既有角色對話則完全不需要資格。
用 AI 摘要這篇文章:
2026 年 11 月 4 日,Atmanity 發布即時數位角色模型 Atmee v2。這次更新最關鍵的變化有兩個:把「決定怎麼反應」的行為模型與「把反應畫出來」的影片模型正式拆開,以及讓開發團隊用三種接法自選要保留系統的哪一段。費用跟著分層:v2 全包對話每分鐘 2 點,是 v1 同模式的兩倍;只想替既有語音代理加上一張臉的團隊,可以走只接畫面模式,每分鐘 1 點。
Atmanity 是 2024 年 10 月在美國加州聖克拉拉成立的公司,由六位 AI 博士組成,成員來自哈佛、密西根大學、Google、Apple 與 NEC 實驗室。共同創辦人 Chen-Ping Yu 先前創辦的 AR 新創 Phiar 已在 2022 年被 Google 收購,他在發布貼文裡把這次的方向總結為:文字與語音能用,就像 DOS 之於 Mac,但最直覺的介面仍是面對面。Atmee v1 已經在 atmee.ai 上線服務,v2 是第二代模型。
官網的架構圖把整套系統拆成兩個模型。輸入只要 1 張肖像照與 15 秒的聲音樣本;行為模型 Causeur 負責個性、情緒、開口時機與主動聆聽;影片模型 Atmee v2 負責把臉、身體、細微表情、情緒與周圍環境畫出來,最後合成一段在單張 GPU 上即時呈現的角色影片。官網首頁也列出團隊的研究成果,包含 2026 年發表於 NeurIPS 的聆聽頭部生成研究 GLARE,與行為模型的訴求相互呼應。
拆開的意義可以從 v1 與 v2 的畫面差別看出來。v1 是一張肩部以上的說話頭,512×512 方形、僅限正面,唇形與聲音同步,但表情與手勢不跟著對話變化。v2 換成行為驅動的算繪:表情、手勢與肢體語言跟著對話走,角色在你說話時也會有聆聽反應,支援 1:1、4:3、3:4、16:9、9:16 五種畫面比例,可以呈現全身與各種角度。標準 v2 解析度為 512×512,更高階的 v2 HD 是 640×640,僅提供企業版客戶。
用預錄口播來對照最容易理解:預錄影片可以事先排好每句話與每個動作,即時通話卻要面對使用者接下來才說出的內容。官方把「角色何時該回應」交給 Causeur、把「當下畫面長什麼樣」交給 Atmee v2,兩層可以整套採用,也可以只拿畫面層接上自己的對話系統。行為模型在全包與純語音兩種模式裡作用;只接畫面的模式則由你自己的代理決定行為,用不到 Causeur。
這家公司對訓練素材從哪來也有自己的說法:官網指出 atmee.ai 平台每月回饋數千小時的真實對話,做為模型訓練的資料引擎。這類敘述一樣屬於廠商說明,但至少點出了即時互動資料是這類模型的關鍵輸入,也是行為模型要持續變好的前提。
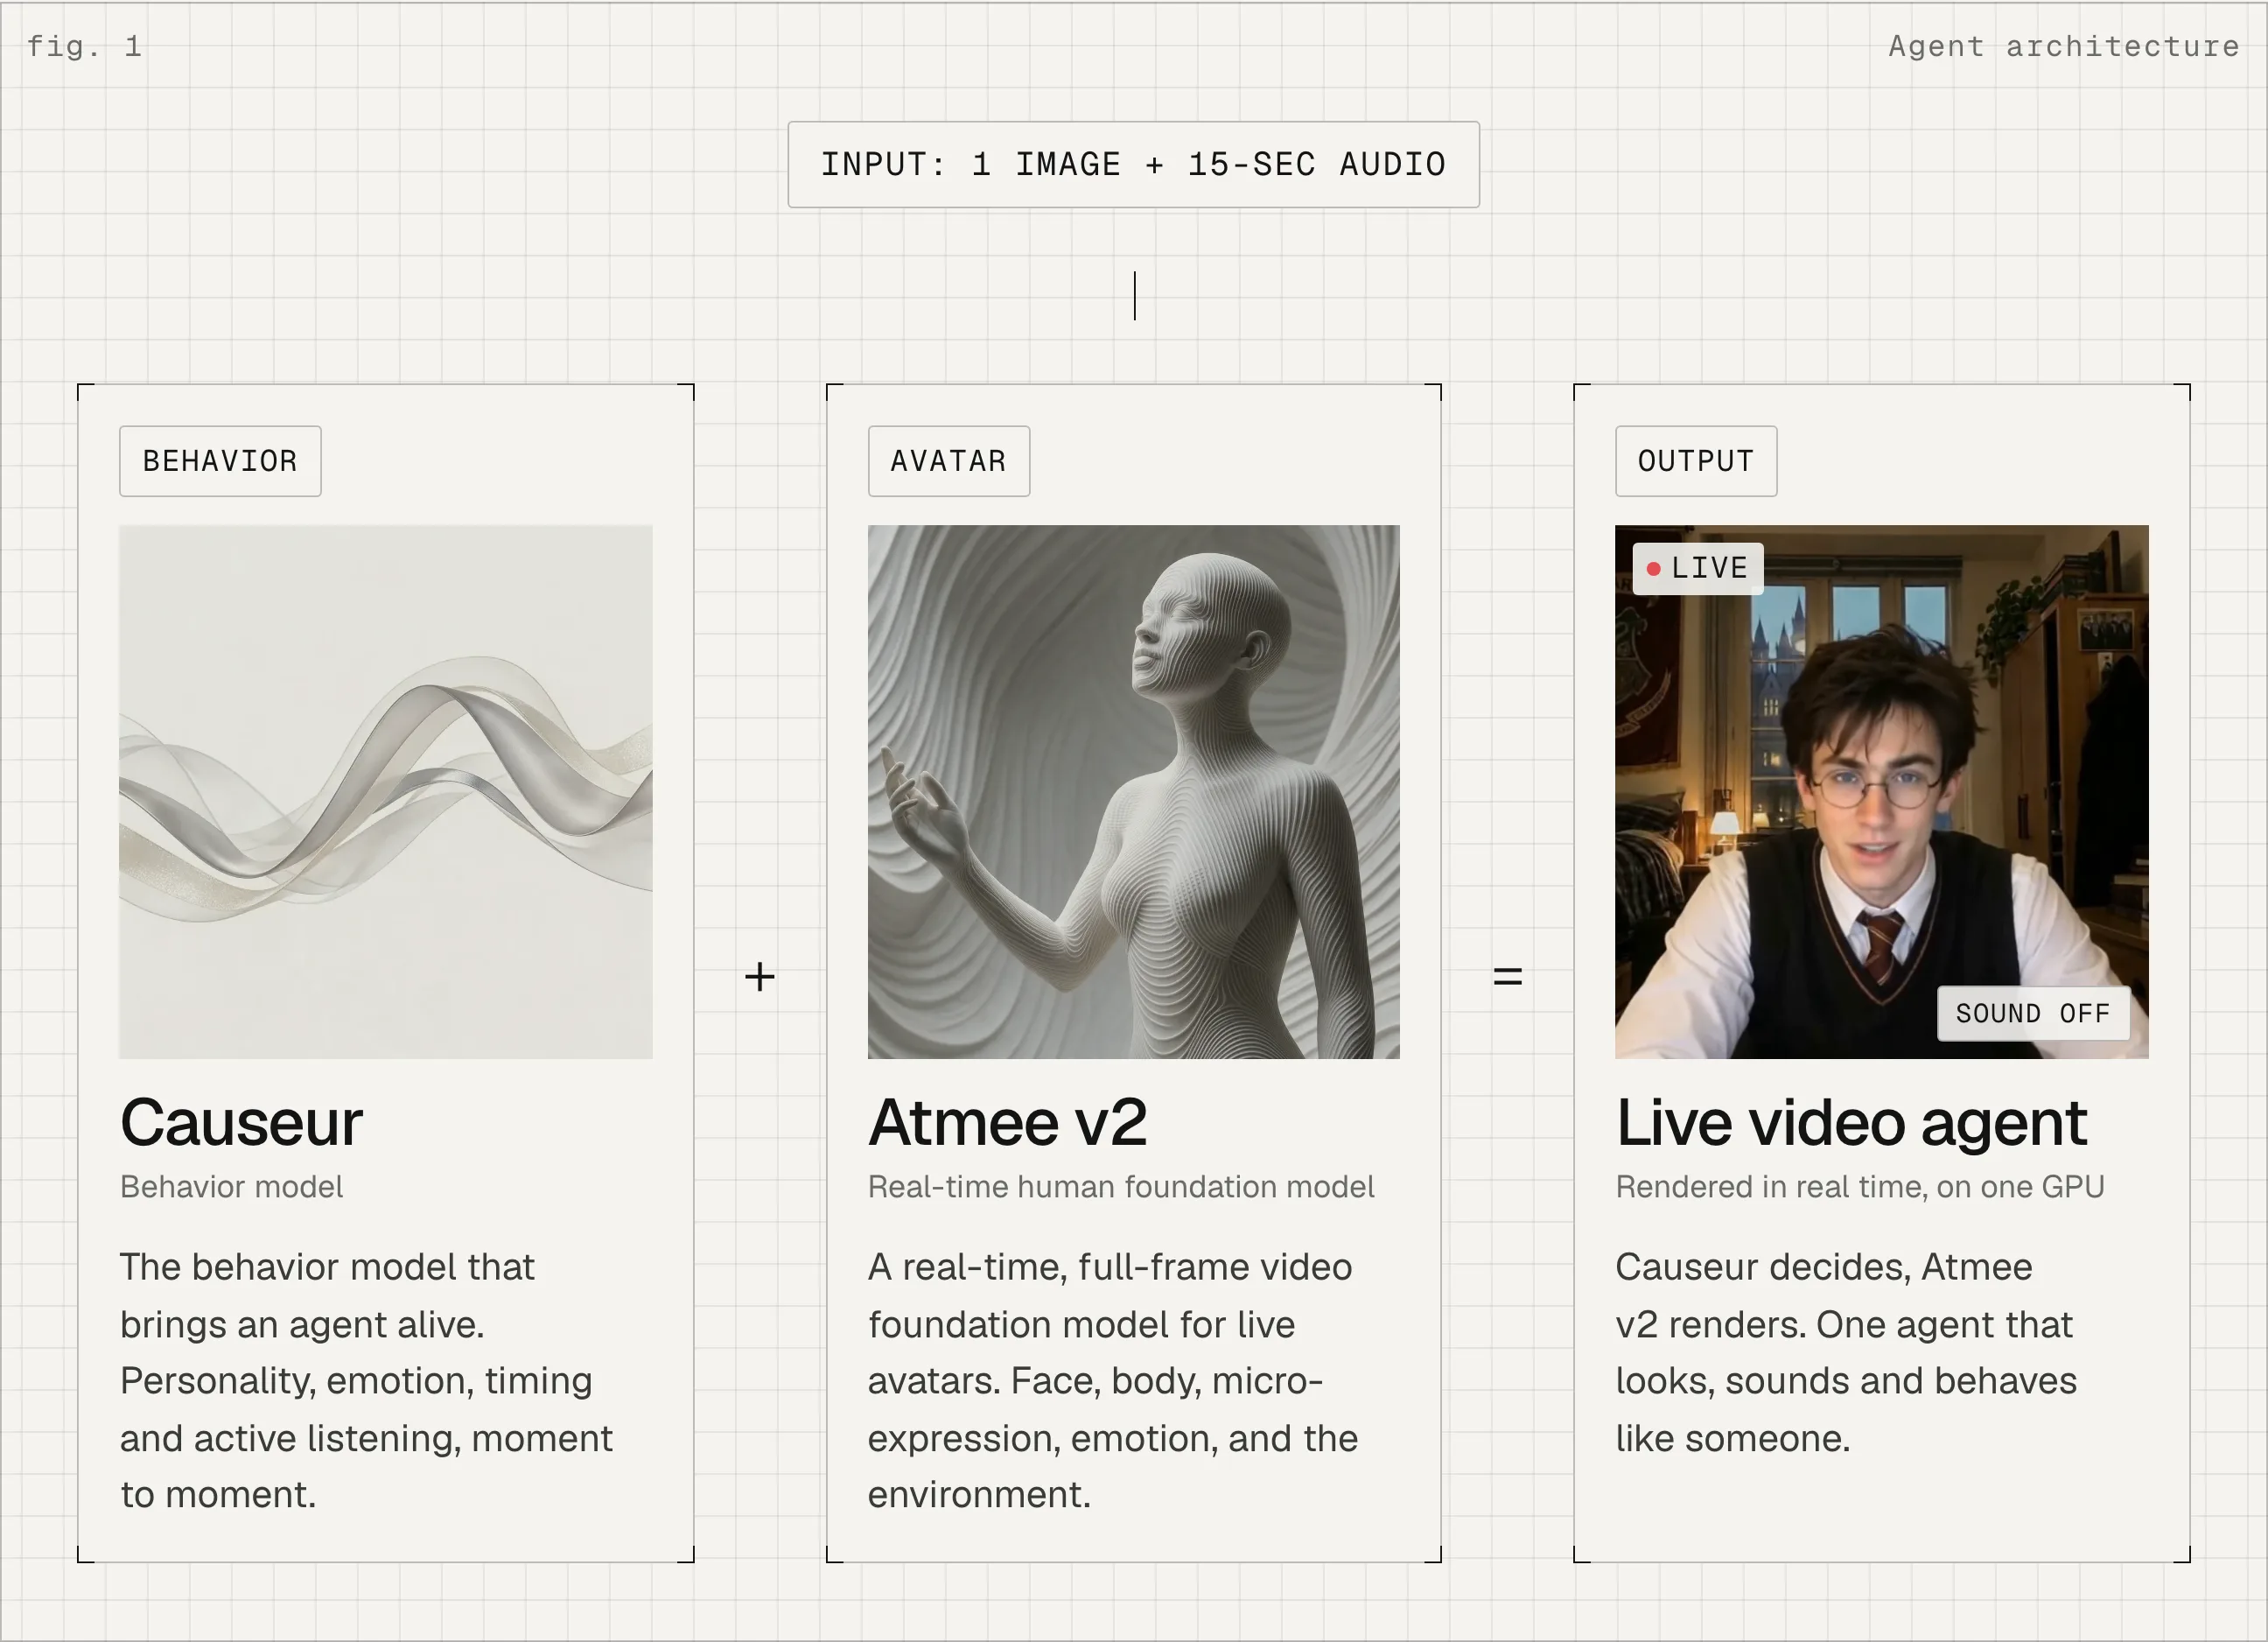
建立 v2 角色時,平台會拍下多個候選版本讓建立者挑一個最接近預定人設的,這個選擇發生在建立流程裡,與通話中動態換模型是兩回事。角色可以從肖像與聲音樣本起家,再補上名字、個性、需要談論的範圍,需要查自家文件的角色還能掛知識檔案。
全包模式(Behavior-driven Full-stack)由 Atmee 管整場對話,行為、語言模型、語音辨識、聲音與臉全部由平台執行,你的頁面只要加入視訊房間。這條路適合還沒有語音系統、想從角色設定一路做到互動介面的團隊。全包模式還能接收應用狀態與事件、讓角色呼叫你的工具,或照預排的議程進行,角色因此可以銜接產品當下發生的事。
只接畫面模式(Avatar-only)把範圍縮到角色呈現。語音辨識、語言模型與聲音由你自己的代理提供,Atmee 依代理的音訊同步渲染畫面,不決定代理要說什麼。代理與畫面在 LiveKit 的視訊房間裡相遇:官方提供 LiveKit Agents 外掛(Python 套件),讓代理一邊說話、一邊把畫面帶進同一個房間;沒有自己的 LiveKit 專案時,也可以省略房間設定讓 Atmee 代管。已經安排好提示詞、工具與對話紀錄的團隊,可以完整保留原有流程,只為畫面付費。
金鑰的設計也反映了「三種模式共用一套資源」的思路。同一把 API 金鑰可以啟動三種模式,金鑰上設定的消費上限與並行上限對每種模式一體適用;要分開管控時,就為不同用途開不同範圍的金鑰。
純語音模式(Behavior-driven Voice-only)由平台管行為、語言模型與語音辨識,使用角色自己的聲音對話,但不顯示影片,客戶端透過 WebSocket 雙向串流音訊,適合電話線、智慧音箱或畫面外的遊戲角色。工作階段會回傳短效連線資訊,客戶端要在 60 秒內連入,連線中斷後就得重建工作階段;沒有聲音的角色在這個模式會直接收到 avatar_has_no_voice 錯誤。
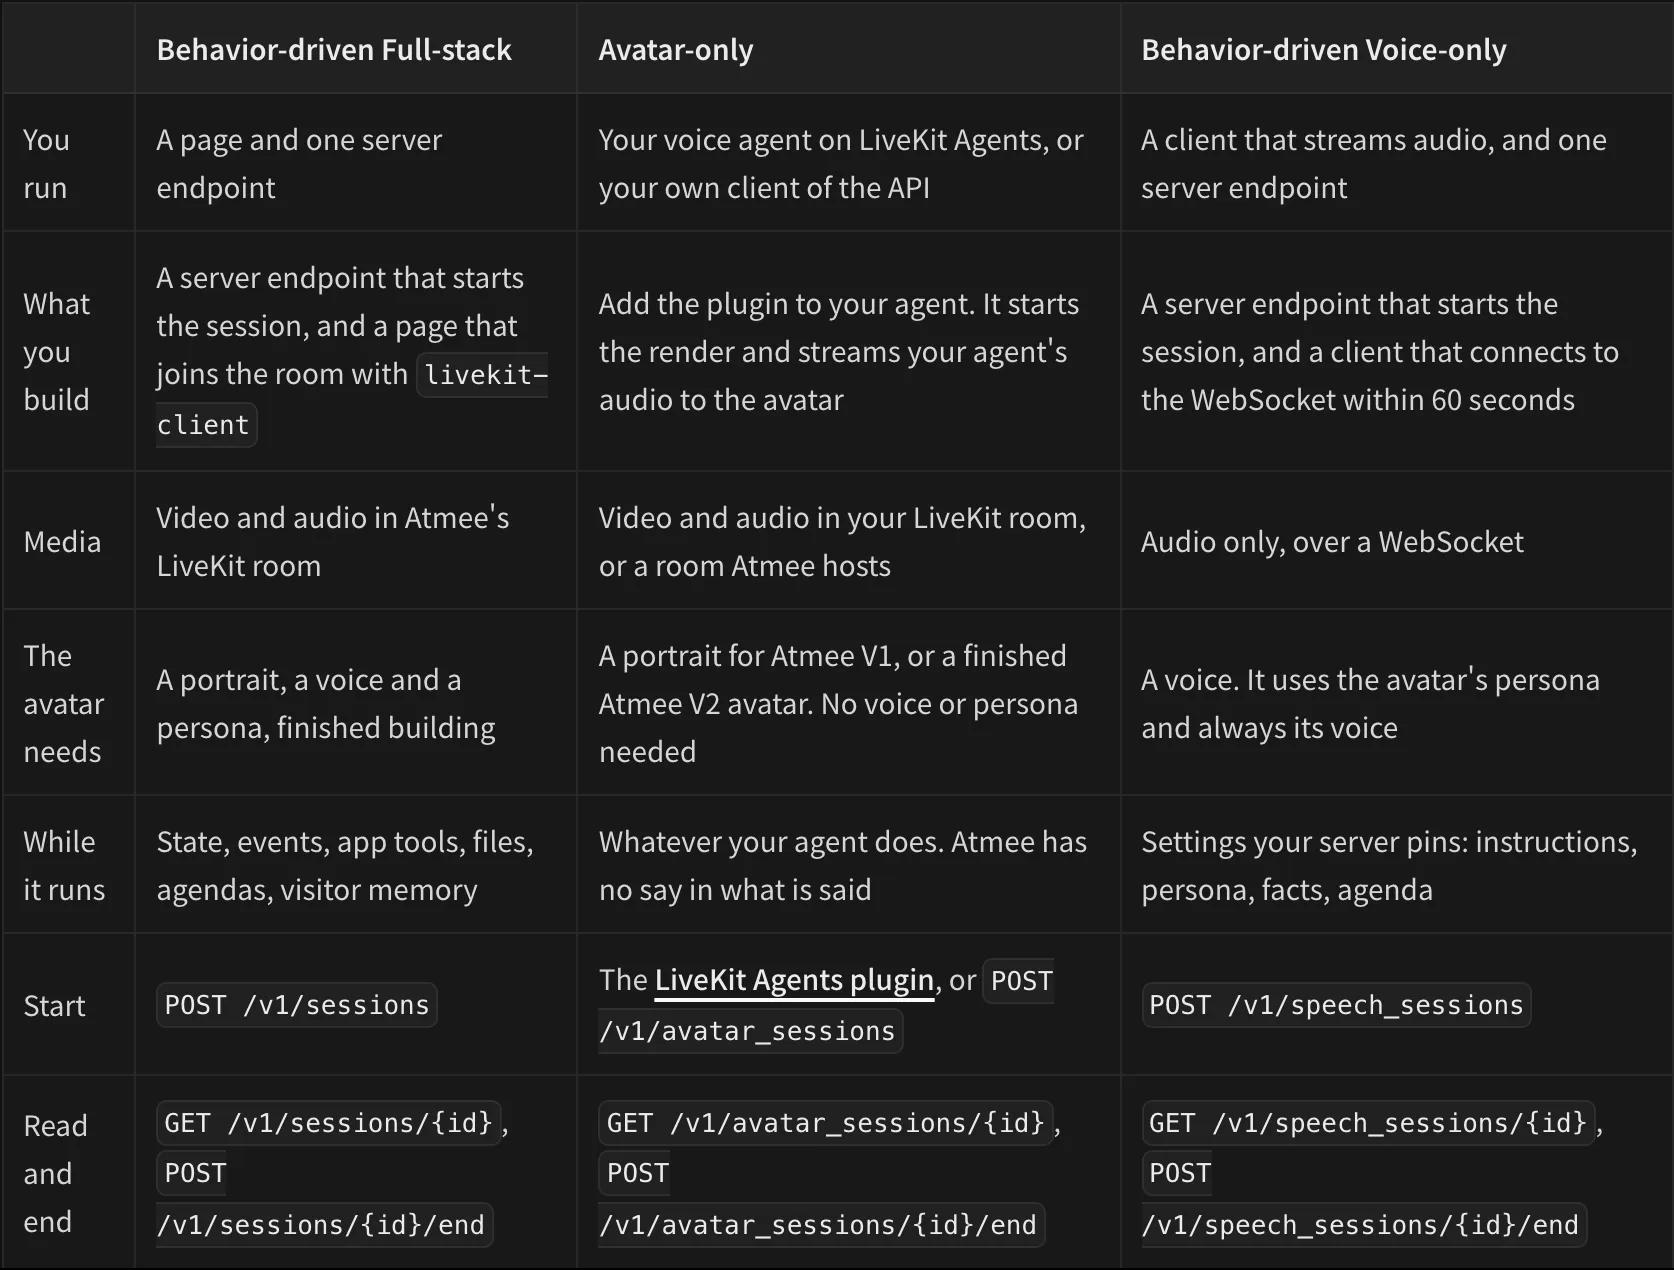
計費與容量有幾個容易漏看的細節。只接畫面模式從角色看見代理進入房間那一刻開始計費,直到代理離開、房間關閉或應用結束工作階段為止,費用跟著連線時間累積,不能只按實際說了幾句話估算。同一個角色同時只能有一段即時影片對話,忙碌中再開一場會收到 avatar_busy 錯誤,多人服務要把角色數量與互動容量一起規劃。結束工作階段的呼叫具有冪等性,重複結束只會回報既有狀態,可以放在各種收尾路徑裡重複觸發。
模型在建立角色時就決定了。想把同一張肖像與聲音從 v1 換到 v2,要用同樣素材重新建立角色,建立時省略引擎設定會預設使用 v1。所有端點開頭的 /v1 指的是 API 版本,與角色用哪代模型無關,兩代角色走同一套介面。還有個順手的設計:只為 v1 上傳一張肖像建立的純畫面角色,之後補上聲音,就成為全包模式可用的完整角色。
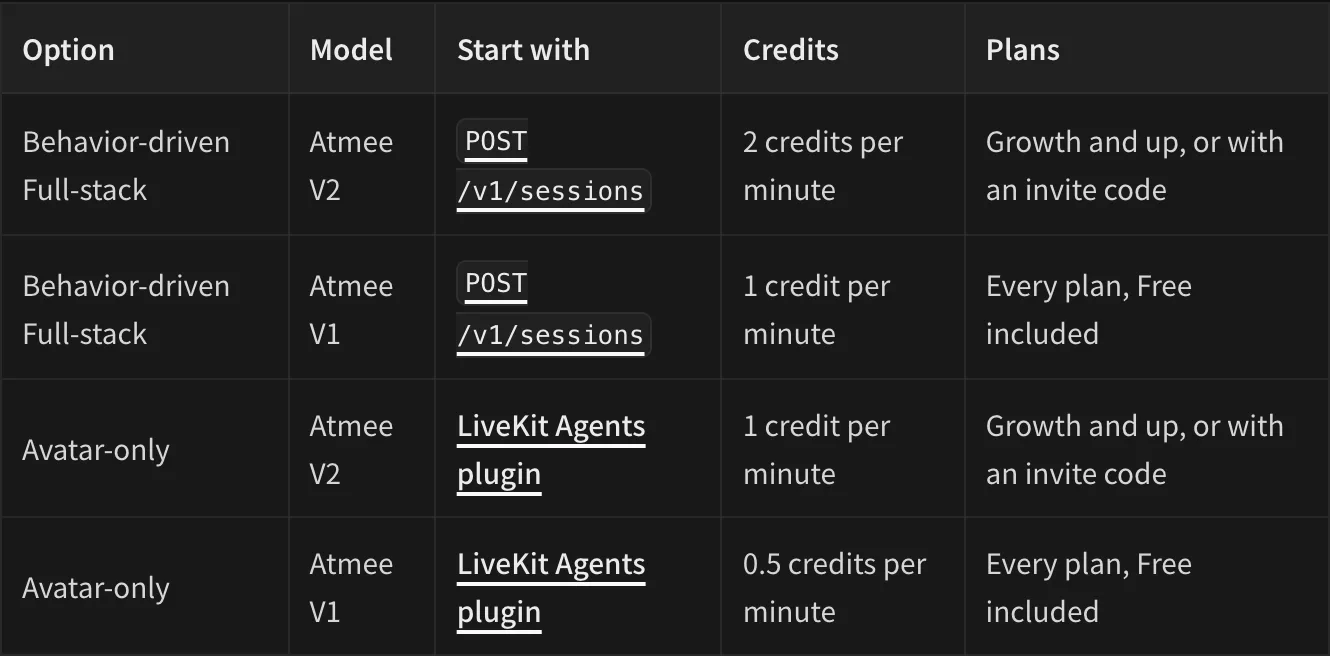
先看每分鐘點數。三種模式與兩代模型的費率如下:
| 模式 | 模型 | 每分鐘點數 |
|---|---|---|
| 全包對話 | Atmee v2 | 2 |
| 全包對話 | Atmee v1 | 1 |
| 只接畫面 | Atmee v2 | 1 |
| 只接畫面 | Atmee v1 | 0.5 |
| 純語音 | 不分模型 | 1 |
費用按秒計算,從同一個帳戶餘額扣除。同一個角色可以在不同模式之間輪流開工作階段,網頁端開影片、電話端走純語音,各按各的費率,模式之間切換不另外收費。
點數本身不等於美元,每點價格依方案而異:Starter 每點 0.150 美元、Growth 0.134 美元、Pro 0.120 美元、Scale 0.105 美元。臨時加值的點數包(10 美元 50 點、25 美元 140 點、50 美元 330 點)換算下來每點約 0.150 到 0.200 美元,比月費內含的點數貴上一截。換算之後差距很具體:v2 全包在 Scale 方案上每分鐘約 0.21 美元,用最小的 10 美元點數包補點數時每分鐘要 0.40 美元,同一段對話的成本差了將近一倍。
用月費內含的點數也可以很快估出用量上限。以 Growth 的 365 點為例,全包 v2 一個月約可談 182 分鐘,只接畫面則有 365 分鐘;Growth 的單場通話上限是 30 分鐘,等於全包模式一個月大概撐得起 6 場完整對話。這個數字也解釋了為什麼高用量的正式服務會需要往上跳方案:點數、單場時長與並行數三個限制是綁在一起放寬的。
| 方案 | 月費 | 每月點數 | 每點單價 | 單場通話上限 | 同時通話 | 建立 v2 角色 |
|---|---|---|---|---|---|---|
| Free | 0 美元 | 10 | 另計 | 5 分鐘 | 1 場 | 需邀請碼 |
| Starter | 9 美元 | 60 | 0.150 美元 | 15 分鐘 | 3 場 | 需邀請碼 |
| Growth | 49 美元 | 365 | 0.134 美元 | 30 分鐘 | 5 場 | 可以 |
| Pro | 199 美元 | 1,660 | 0.120 美元 | 45 分鐘 | 10 場 | 可以 |
| Scale | 599 美元 | 5,705 | 0.105 美元 | 60 分鐘 | 15 場 | 可以 |
| 企業版 | 客製報價 | 大量點數 | 客製 | 無上限 | 客製 | 可以,含 v2 HD |
建立 v2 角色與生成短片需要 Growth 以上方案,或在較低方案持有邀請碼,邀請碼向官網申請後在控制台的 API 頁兌換。這道門檻只限制建立者:與既有角色對話不需要任何方案或邀請碼,應用訪客也不必申請 Atmee 帳號,通話全程由建置應用的帳號扣點。想向終端使用者收費,商業流程得自己安排。
免費方案每月 10 點、每場通話上限 5 分鐘、同時 1 場、畫面含浮水印;Starter 起移除浮水印並放寬通話時長與並行數。Growth 以上多了離線短片生成,每支 0.1 點起,單支最長 15 秒,由照片、提示詞與選配的音訊生成,可以串接成較長的影片。平台還內建了分潤機制:把角色以招牌角色發布在 atmee.ai 上,有人付費交談時,建立者每分鐘獲得固定的 0.05 美元。順帶一提,定價頁直接以繁體中文呈現,官網首頁與技術文件則是英文。
創辦人隨發布貼文附上一支示範影片,拿「生成 10 秒影片」當例子:投影片顯示 Seedance 需要 189.4 秒、233.6 秒到 379 秒(不同素材),Atmee v2 則是 3.5 秒,總結字卡寫著「up to 50 times faster」與「up to 100 times cheaper」。這些是廠商在自家發布影片上的宣稱,畫面與數字都屬官方示範,影片沒有附上測試條件、硬體與方法的說明,拿來估算自己專案的成本前,值得先做一輪同條件的實測。Seedance 是 ByteDance 的影片生成模型,站上先前介紹過它被用作 AI 電影實驗的案例。
同樣沒有給的還有延遲。官方文件與定價頁找不到適用所有角色、硬體與網路條件的固定端對端延遲數字,官網只表示整套系統能在單張 GPU 上即時呈現。延遲敏感的應用,例如線上客服的即時追問或語言教學的來回對答,導入前應該先用自己的角色與網路環境量一輪,再決定要用哪種模式與方案。
把視野拉寬一點,這條產品線走的是「畫面先行」的路線。Meta 的 Muse 語音代理把重心放在代辦任務與授權防護,ElevenLabs 的語音代理研究則顯示對話拉長後語音模式的成功率反而穩定,兩者都以聲音為介面;Atmee v2 把差異化押在臉與全身畫面,對應創辦人「最直覺的介面是面對面」的定位。哪種介面先被大量採用,目前各家都還沒有公開的採用數字可以佐證。
官方入門文件把接入順序寫得很直白:先建立角色(肖像、聲音樣本、人設與知識檔案),由自己的伺服器帶著 API 金鑰開工作階段,前端的頁面再加入視訊房間顯示角色。金鑰留在伺服器端,可以設定作用範圍、可使用的角色與消費上限,最終使用者全程接觸不到金鑰。文件還有一個少見的設計:整份文件與 API 規格以純文字檔的形式公開,附上 MCP 伺服器與命令列工具,讓 Claude Code、Codex 這類編碼代理直接讀規格、建角色甚至兌換邀請碼,團隊可以讓代理把整合的樣板程式碼先寫出來再人工檢查。
已有語音系統的團隊,先拿只接畫面模式試一段有明確目的的對話,例如產品導覽、語言練習或櫃檯詢問,變更範圍最小,每分鐘點數也只有全包的一半,而且自有代理的提示詞、工具與紀錄全部保留。還在從零規劃的團隊,再連同全包模式的知識檔案、個性設定與互動介面一起評估,並把建立 v2 角色的方案門檻或邀請碼一次算進成本。點數費率屬於會變動的內容,導入前以官方文件的數字為準;文內表格對應 11 月 9 日的頁面內容。