TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Ricursive Intelligence 於 2026 年 11 月 4 日開放 Ripple-65B Preview 權重,65B 稠密模型以 12 兆 token 從零預訓練,Terminal-Bench 2.1 達 80.5 分,官方並公布 3,200 萬美元整體研發成本。本文核對各版本的下載條件、Terminus 2 換框架後的分數變化,以及它在 SWE-bench Verified 與工具使用項目仍落後的範圍。
用 AI 摘要這篇文章:
美國晶片設計新創 Ricursive Intelligence 在 2026 年 11 月 4 日開放 Ripple-65B Preview 的模型權重,採 Apache 2.0 授權,任何人都可以從 Hugging Face 下載,或經 OpenRouter 直接呼叫。這是一個 65B 參數的稠密模型,官方稱以 12 兆 token 從零預訓練,最長支援 1,048,576 token 的上下文。伴隨模型一起公布的還有兩個行銷數字:Terminal-Bench 2.1 代理編碼測試 80.5 分,官方稱在美國開放權重模型中登上榜首;以及從零訓練到釋出的整體研發成本 3,200 萬美元。
Ricursive 自我定位是全端人工智慧實驗室,主業是自家的 AI 晶片設計平台,這次釋出的 Ripple 是內部模型的通用版本,官方在部落格稱它為平台專用模型的開放切片。這兩個數字在官方文件裡都附了口徑說明,而且攤開的程度比多數同業完整。80.5 分是自報值,模型卡另外列出官方測試框架 Terminus 2 的對照分數;3,200 萬美元的帳單明列包含失敗實驗與配方開發,「成本約為前一個領先開放模型的十分之一」則標明是廠商估算。把說明連數字一起讀,才能看清 65B 稠密這條路線實際換到了什麼,以及哪些宣稱還沒有第三方驗證。
Hugging Face 上目前有四個 repo:BF16 指令版、NVFP4 低精度版、只做預訓練的 Base 版,以及 8.1 GB 的 DFlash2 投機解碼草稿模型。以 API 實際清點主要版本,BF16 指令版的權重共 16 個分片、129.6 GB;NVFP4 版 6 個分片、57.2 GB;Base 版同樣是 129.6 GB。截至 11 月 8 日,三個 repo 的下載量分別約 5,100、2,500 與 340 次,主 repo 的模型卡在 11 月 6 日仍有更新,文件面還在活躍修訂。發布當天 Ricursive 同步發出第一封官方通訊,並在 X 與 LinkedIn 宣布,時間軸以 11 月 4 日的官方宣布貼文為準。
下載前有兩個技術細節要知道。repo 附上自家的 modeling_ricursive.py 與 configuration_ricursive.py,並標示 custom_code,表示載入時需要執行作者提供的自訂程式碼,這在企業環境要先過安全評估;另外 repo 附了 SGLang 推理伺服器腳本,以及自家對話格式的推理與工具呼叫解析器,自架服務可以從這裡起步。不想搬 57 GB 以上權重的人,OpenRouter 已經上架 ricursiveai/ripple-65b-preview,API 回應的上下文長度同樣是 1,048,576 token,每百萬輸入 token 收 0.2 美元、輸出 0.6 美元,快取讀取 0.05 美元,以輸入輸出各一百萬 token 計約 0.8 美元。官方公告另列 Together AI、GMI Cloud 與 Fireworks 等平台,各平台定價與限流需要自行核對。
稠密模型與專家混合模型的差別,在於每次生成時有多少參與計算的參數。稠密模型的主要網路全部一起動;專家混合模型把網路拆成多個專家,每次只挑一部分上場,用總參數換容量、用啟用參數控制每個 token 的成本,兩個數字因此是分開的。
模型卡的對照表把這件事攤得很清楚:Ripple 總參數 65B、啟用參數也是 65B;Reflection Beam 501B 總參數更大,但每次啟用約 23B;Meta Muse Spark Open 816B 啟用約 42B;NVIDIA Nemotron 3 Ultra 550B 啟用約 55B。換句話說,Ripple 每生成一個 token 動用的參數其實比列出的對手都多,「65B 打贏 500B」的說法不能解讀成每個 token 的計算量更省。稠密路線省的也不是帳單上的訓練總量,而是工程複雜度:不需要為專家路由寫客製化基礎設施,分片策略單純,出問題時比較容易收斂原因。
官方的說法是整個預訓練與後訓練維持 40% 的 MFU(模型算力利用率指標),只靠簡單分片、沒有自訂 kernel、訓練全程 BF16 不量化;模型形狀走窄而深的路線,d_model 5120、共 80 層,並從 Olmo 3 的類 Llama 架構換成類 Gemma 3N 的設計來換取大規模訓練的穩定性,另加入閘門注意力與值殘差等提升推理表現的架構改動。模型卡另提到,這個模型從 1 人團隊開發起步,期間成長到 5 人。這些都是官方單方陳述,但與稠密路線降低工程複雜度的動機一致。
對照表裡四個競爭對手清一色是專家混合架構,Ripple 是唯一稠密模型。在主流實驗室相繼把總參數推向數千億的此時,這個選擇明顯逆著產業方向;官方明說的動機是降低訓練與後訓練的基礎設施複雜度,並稱稠密架構能提供低延遲的生成速度,在算力高、記憶體頻寬相對受限的本機裝置上好發揮,這也是它後來能放進 DGX Spark 這類單機的架構基礎。
官方對成本的定義寫得明白:3,200 萬美元是「從零開始的整體研發成本」,包含預訓練階梯開發、資料混合、評測、除錯、合成資料生成、後訓練配方開發,以及最終的主訓練與後訓練。把它當成最後一次訓練的 GPU 帳單會嚴重誤讀;反過來說,這張帳單也誠實承認了研發路上的試錯都算在裡面。
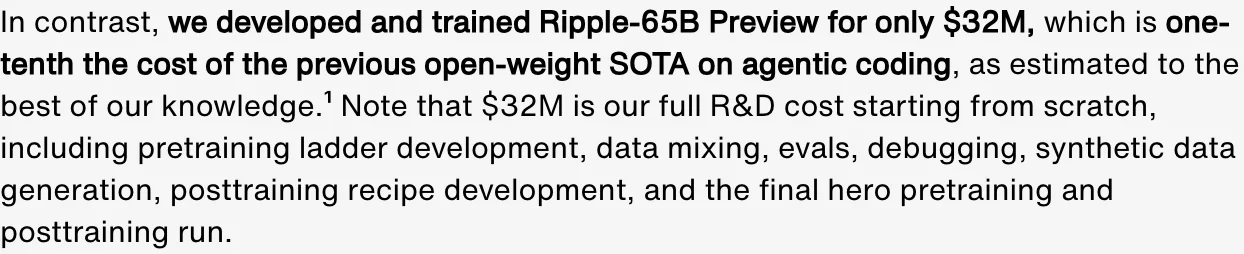
「十分之一成本」的依據在部落格文末註解:報導指出 Reflection 承諾每月 1.5 億美元的算力在 SpaceX Colossus 訓練其模型,而 Reflection 自己公布 Beam 的預訓練與後訓練各花 4 週。以兩個月換算,對手的訓練支出約 3 億美元,與 3,200 萬美元的十倍關係大致吻合。但官方同時標明這是「就我所知程度的估算」,並沒有取得對手相同會計口徑的帳單,研發人力、折扣與其他資源是否一致也未被證明。
支撐這個成本結構的是小模型階梯實驗:從 Allen Institute for AI 的 Olmo 3 模型階梯出發,先在小規模測試每項改動能不能隨規模放大,再決定要不要放進大訓練。官方列出的版本演進中,有一步把批次與學習率換成 StepFun 縮放律,有一步引入隨規模平滑調整網路形狀的新階梯,前期神經網路的正規化配置也在 4B 規模才顯出效果;另一項雙流結構在小模型上表現好、放大到 4B 沒有繼續改善,於是被捨棄。最終配方的程式碼指標計算效率在 4B 規模改善最高 16 倍,完整主訓練的優勢最高到 55 倍,預訓練語料也換成自製資料並大幅拉高程式碼占比。
後訓練走同一套省算力邏輯。官方稱沒有購買任何後訓練資料,全部用自建合成資料管線、品質過濾與覆蓋率指標;強化學習配方使用截斷重要性採樣、分數中心化與線性長度懲罰,並隨模型進步持續加入更難的任務,避免讓模型重複刷已經熟悉的簡單題。官方公布的數字是 140 萬次 rollout 達到 80.5 分,約為 Reflection Beam 的七十分之一;rollout 指一次完整展開的任務嘗試,可能包含多步推理與工具呼叫,不同任務長度的成本差異很大,次數不能直接換算成總算力;換算下來 Beam 的 rollout 量級約在 9,800 萬次。這些倍數都是廠商回報值,第三方尚未重現,但方法本身把昂貴的試錯搬到小模型執行,對小團隊的參考價值比數字本身高。官方也在文末致謝 Olmo 團隊、Prime Intellect、RadixArk 與 NVIDIA 的開源貢獻,這條路線等於把開放研究成果再回饋成新的開放模型。
Terminal-Bench 是在終端機環境解決多步驟任務的代理測試,Terminus 2 則是其官方指定的測試框架。模型卡的方法論段落直說:重現代理測試的分數很困難,許多因素都會讓分數移動,他們觀察到的實例是換框架與摘要設定時分數就變。官方發現用 Terminus 2 框架、128K 上下文加摘要設定重測時,各家分數普遍變低,只有 Muse Spark Open 例外。對照表因此並列兩欄:自報值與 Terminus 2 值,全部模型以 BF16 全精度與最大努力設定測試。Ripple 在兩欄都是 80.5;Beam 從 80.1 掉到 70.8,跌 9.3 分;Muse Spark Open 反而從 76.4 升到 78.7。哪個框架更接近真實使用,官方沒有給定論,只說這是盡力求公平的比較。表中缺漏的測項由官方自行補測,並以斜體標示來源不同。
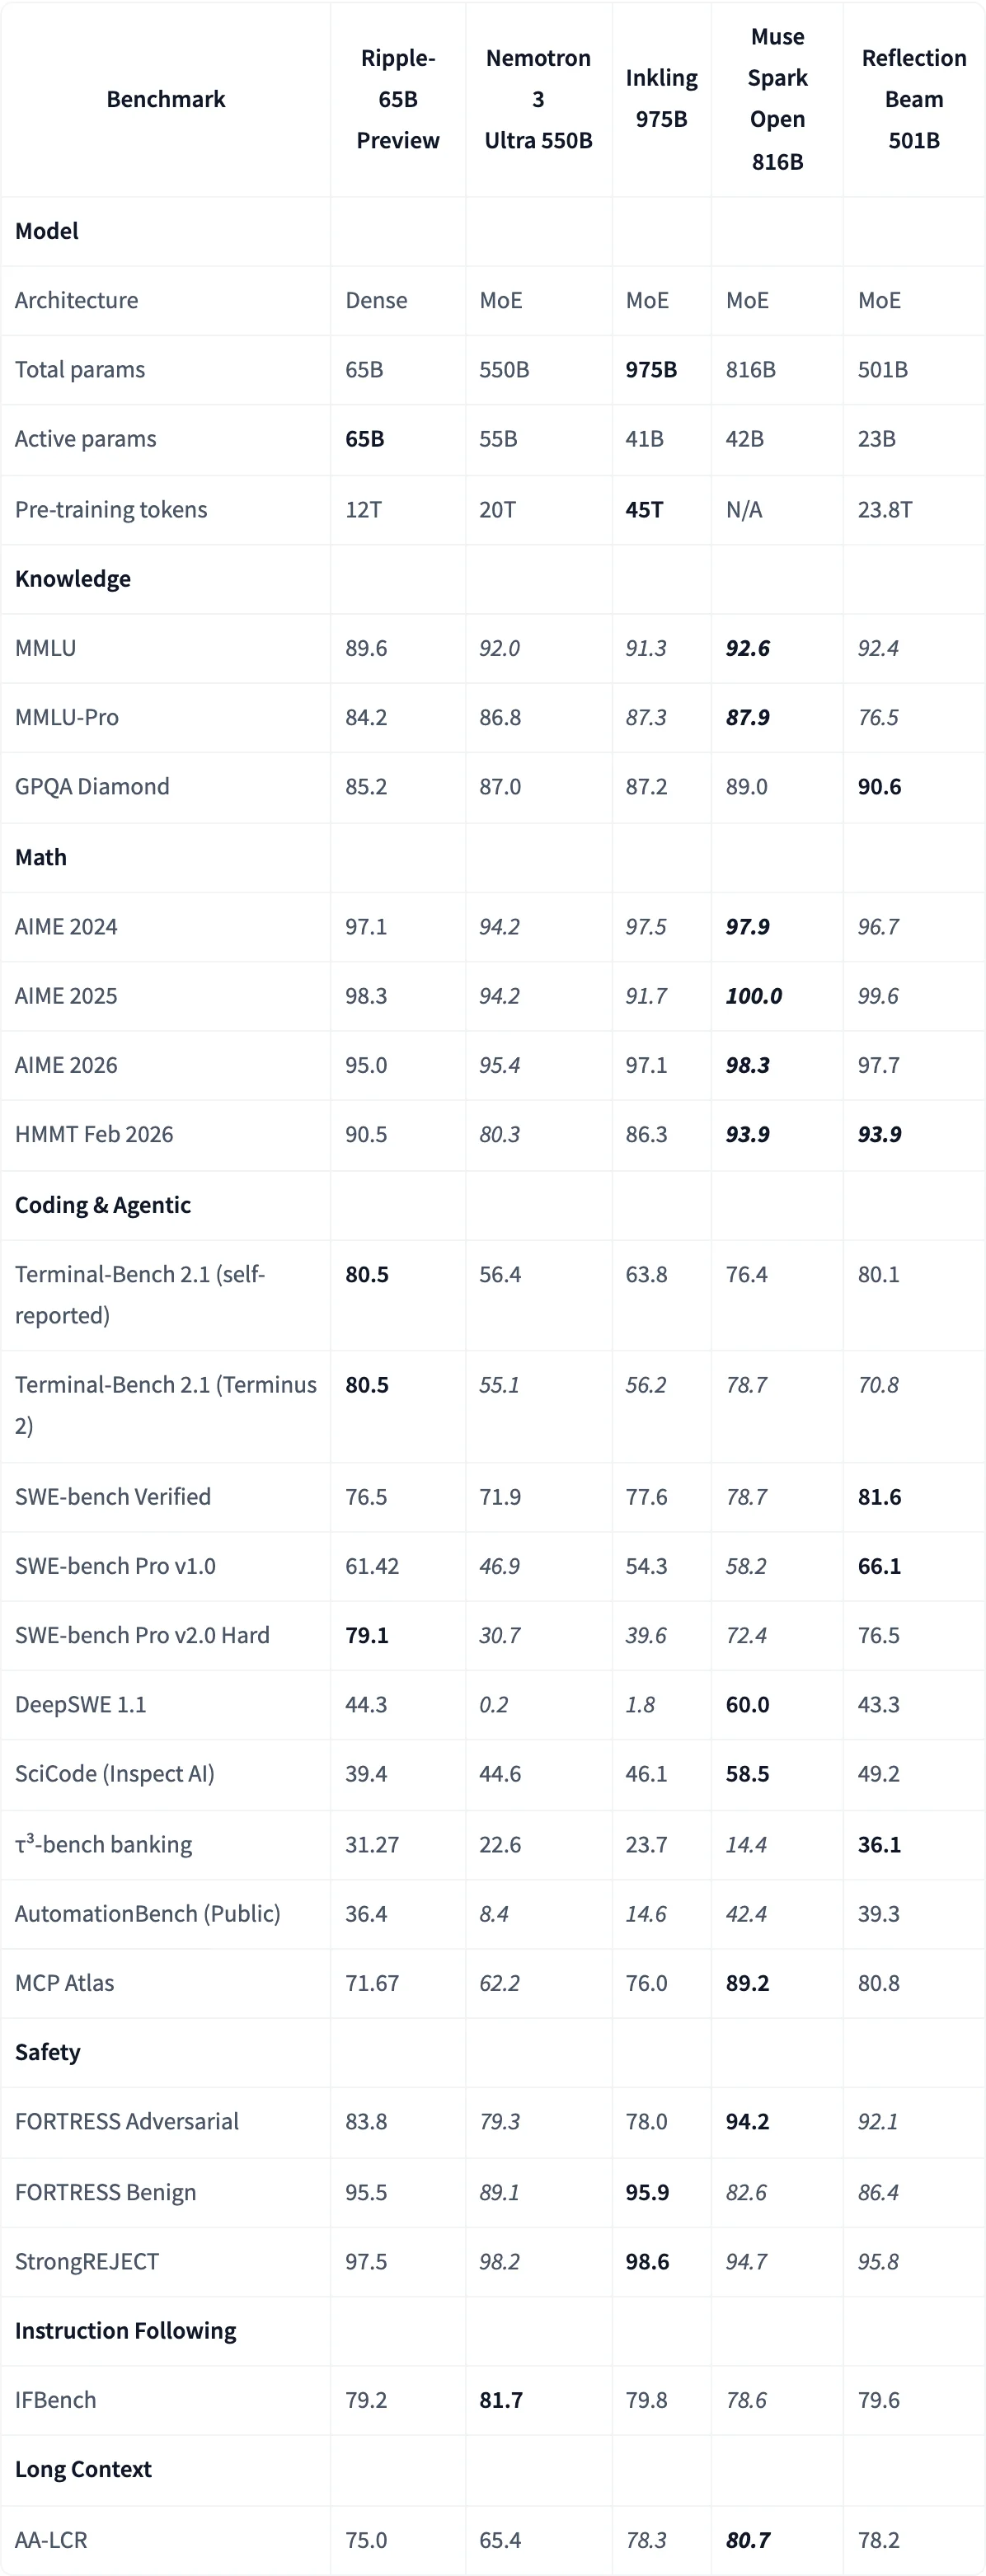
分項成績則顯示 Ripple 並非全面領先。它贏的是代理編碼主場:Terminal-Bench 2.1 之外,SWE-bench Pro v2.0 Hard 拿 79.1 分高於 Beam 的 76.5 與 Muse 的 72.4,真實軟體倉庫修錯的 DeepSWE 1.1 也以 44.3 分領先 Beam 的 43.3。但在 SWE-bench Verified 它是 76.5,落後 Beam 的 81.6 與 Muse 的 78.7,舊版的 SWE-bench Pro v1.0 也以 61.42 分落後 Beam 的 66.1;MCP 工具使用測試 MCP Atlas 是 71.67,遠低於 Muse 的 89.2;銀行場景對話的 τ³-bench、科學程式的 SciCode、長上下文的 AA-LCR,以及安全對抗的 FORTRESS,全都低於至少一個對手;指令遵循 IFBench 的 79.2 分排在五個模型中偏後,僅高於 Muse,MMLU、GPQA 等知識測驗則全數居後。Base 模型的對照表同樣顯示,Nemotron 3 Ultra 在傳統預訓練測驗大幅領先,官方分析是對手大量使用任務導向的合成資料,但這些優勢沒有轉換成代理任務的表現。
還有一個範圍限制:這份比較表只收美國開放權重模型,DeepSeek 等中國團隊的模型只出現在 Base 模型的對照表,不在代理編碼的比較之列。先前在代理任務拿過多項官方最佳成績的 DeepSeek V4.1-Flash,以及表內的 Meta Muse 系列,都不在「美國開放權重榜首」這句話的射程內。選型時先把這條邊界畫清楚,再比較分數才有意義。
從 API 試用入門是最便宜的第一步。以 OpenRouter 的標價計,先用自己的一批代理任務樣本測分數夠不夠用,再決定要不要自架,會比一開始就搬權重更省。自架的門檻取決於版本:BF16 指令版 129.6 GB 的權重,單張 80GB 加速卡放不下,至少要兩張起跳,還得預留快取空間,實務上是多卡工作站或伺服器等級的部署;NVFP4 版 57.2 GB,比純 4 位元換算的約 33 GB 大上不少,從檔案大小可以推測部分層維持了較高精度,以 NVIDIA 公開規格中 DGX Spark 的 128GB 統一記憶體推算放得下。官方也確實把 NVFP4 版定位在這類本機裝置,並附上 Colab 筆記本供入門。量化版權重下載前先核對檔案、硬體與授權的流程,與先前 Kimi K3.1 Pro 開放權重 的檢查清單相同。
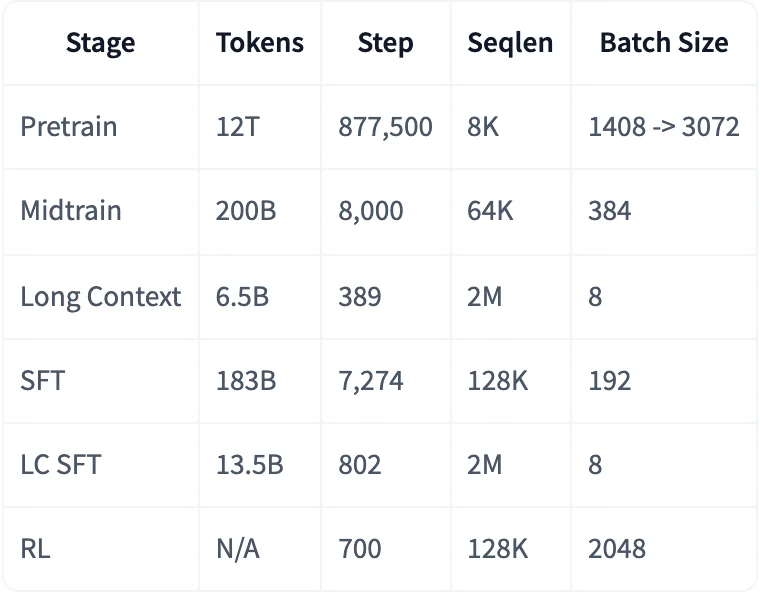
效能預期也要對齊口徑。官方公布 250 token 每秒的生成速度,條件是兩張 B200、批次 8 的伺服器吞吐,不是單一使用者在工作站上的回應速度;長上下文開滿時,KV 快取還需要額外記憶體,1Mi 上下文是模型能力上限,各平台實際供應的視窗以端點文件為準。另外要記得這是 Preview:官方模型卡自述後訓練相對輕量、聚焦代理編碼,訓練階段表顯示它在 12 兆 token、8K 長度、87.75 萬步的預訓練之後,才逐步加入 200B token 的 64K 中期訓練、6.5B token 的 2M 長上下文擴展、183B token 的指令微調,最後是 700 步的混合強化學習;Base 版完全沒有中期訓練與合成問答資料,適合做繼續訓練的研究底座,不適合直接當對話模型用。
這篇發布最誠實的地方,是官方自己標出了未定事項,但這也代表讀者要帶著幾個問號使用。競品的分數全部未經第三方同條件重現,官方自己也說重現困難;成本比較沒有相同會計口徑的驗證;單一使用者的延遲、Together AI 與 GMI Cloud 等平台的實際價格與限流,都要以各端點文件為準,官方通訊稱 Fireworks 在發布當天晚些上線。Preview 這個名字也提醒:後訓練還在早期,正式版推出時能力會再變動。兩個具體的回查時點:第三方用 Terminus 2 在相同設定下重現各家分數,以及 Ricursive 釋出完成完整後訓練的正式版;任一件事發生,上述分數與成本結論都應該重新計算。
發布事件是 2026 年 11 月 4 日,文中的下載量與 OpenRouter 定價取自 11 月 8 日,這類數字會持續變動。如果你正在評估自架代理編碼模型,先花不到 1 美元在 API 上跑自己的任務樣本,等第三方 Terminus 2 重現結果或正式版發布再做出重大結論,會是風險最低的路徑。