TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

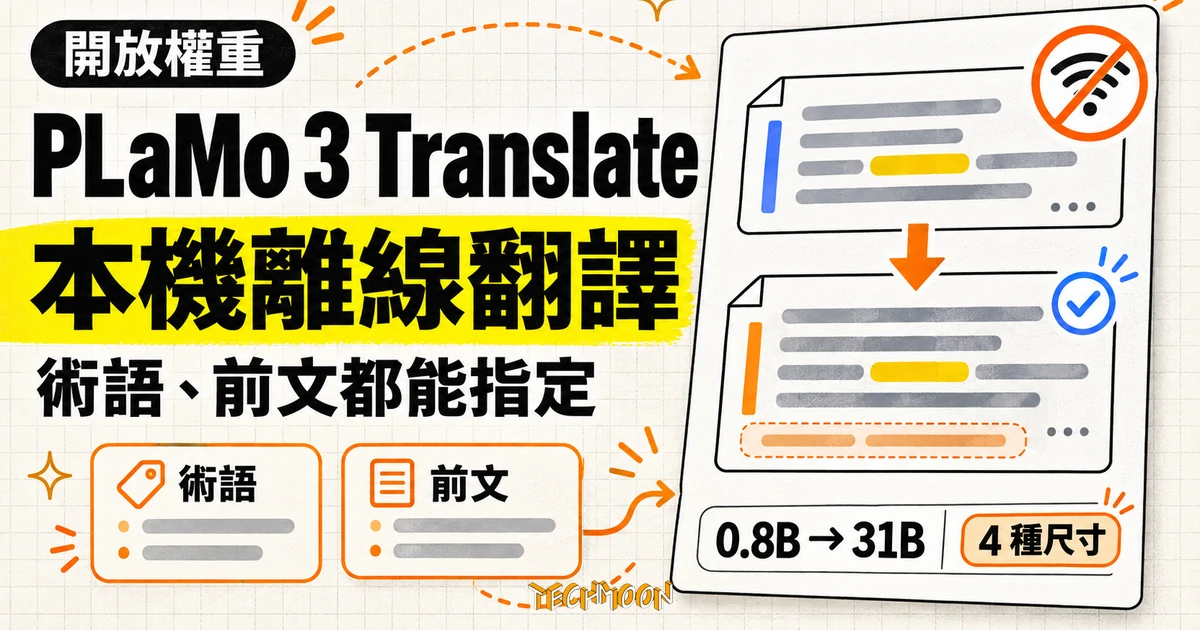
Preferred Networks 於 11 月 5 日開放 PLaMo 3 Translate 翻譯模型權重,0.8B 到 31B 四種尺寸可完全離線執行,支援含繁體中文的 53 種語言,並能用詞彙表與翻譯歷史控制譯法;商用前需完成登記且營收不超過 10 億日圓。
用 AI 摘要這篇文章:
2026 年 11 月 5 日,日本 AI 公司 PFN(Preferred Networks)宣布開放翻譯專用模型 PLaMo 3 Translate 的權重,一次放出 0.8B、2B、8B、31B 四種尺寸,全部放在 Hugging Face 供人下載。這批模型原本是 PFN 自家翻譯服務在用的,開放之後把一件事變成可能:整個翻譯流程搬進自己的手機、筆電或公司內部伺服器執行,原文與譯文都不必離開自己的設備。手上握有合約、研發文件或客戶往來紀錄的單位,以及在意資料外送的個人,是這次發布最直接的受影響者;PFN 自己則預期這批模型會被用在觀光、企業內部與災害應變這類對機密性與回應速度有要求的場景。
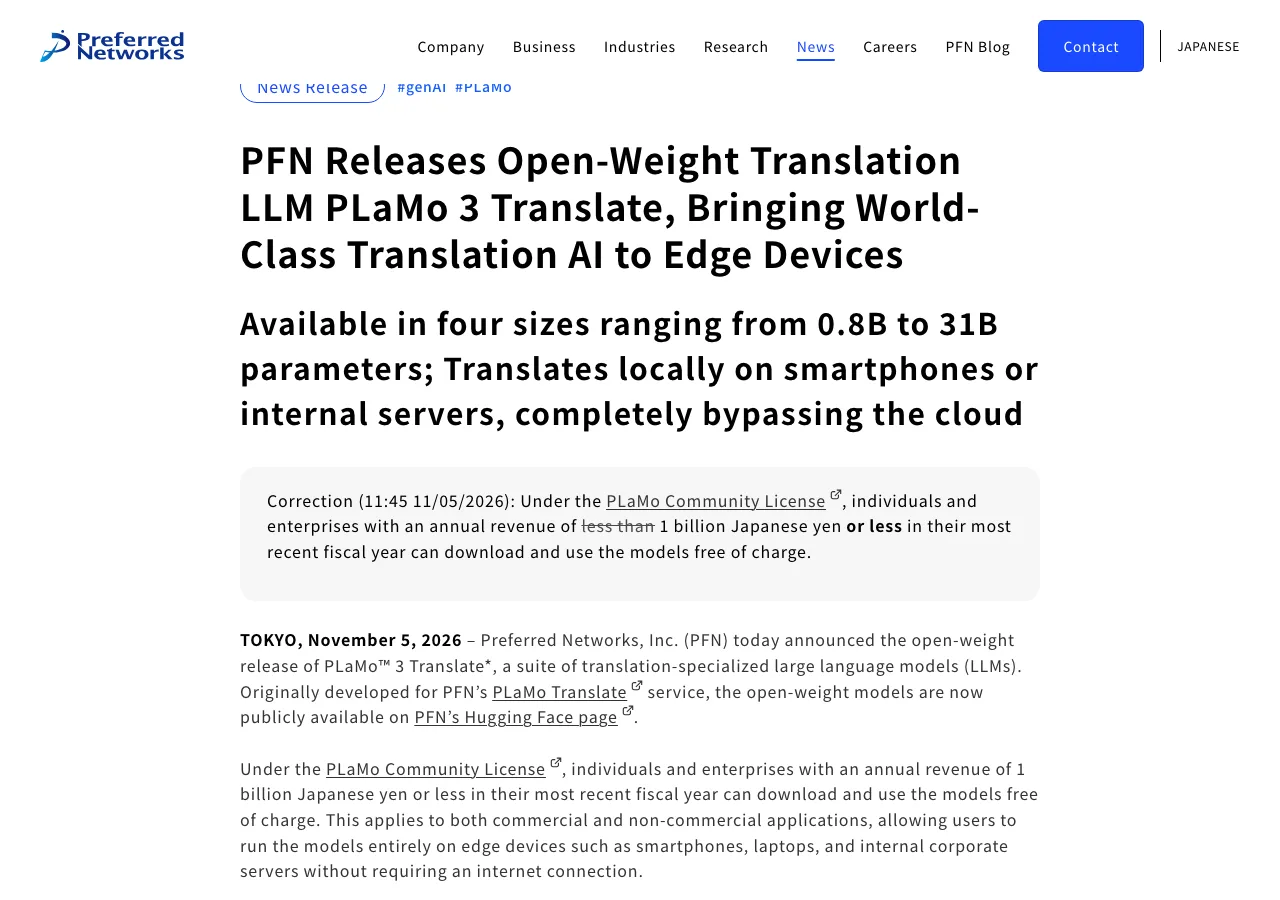
先說清楚下載到的東西是什麼。權重(weights)是模型訓練結束後學到的數值,不是一套裝了就能用的翻譯軟體;要讓原文變成譯文,還需要執行程式與足夠的硬體。官方新聞稿展示了 0.8B 最小版在手機開飛航模式、完全斷網的狀態下即時翻譯,但那是在內部環境的示範,這次並沒有跟著推出可直接安裝的手機 App 或現成翻譯介面。開放出來的是材料,成品要自己組裝。本站先前介紹 Underdog Woof 開放權重語音模型時的處境類似:權重到手之後,執行環境與前端整合都是部署者自己的工作。
從中文使用者的角度,第一個要確認的問題是中文支援。官方模型卡列出 53 種支援語言,簡體與繁體中文分開計算,繁中用的是 zh-hant 這個代碼。這裡有個容易誤會的細節:Hugging Face 的介面把中文合併成單一語言顯示,所以模型頁面上看到的是 52 種,並非官方少開放了一種。
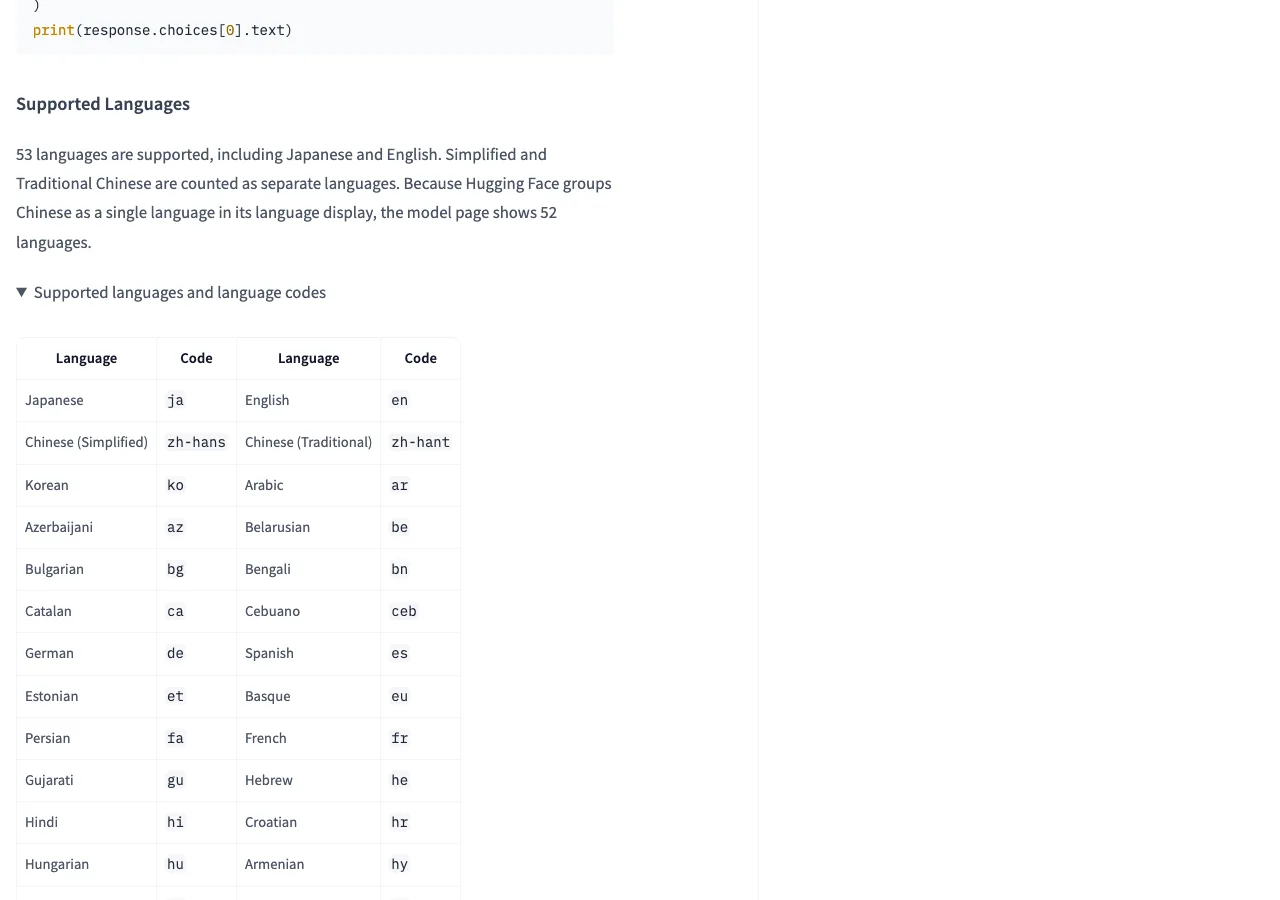
但支援與測過要分開看。官方的多語評測從 53 種語言裡挑了 15 種做 FLORES+ 雙向評測,繁簡中文都入選,同批還有韓文、泰文、越南文、印尼文、西班牙文、德文、法文、俄文、阿拉伯文等,評測方式是以日文或英文為中心,各自對其餘 14 種語言互譯;日英軸另外有 PFTB、SaaS、WMT24++ 等基準,其中 PFTB 與 SaaS 是 PFN 自家的內部基準。也就是說,品質證據最厚的地方是日英與日英對多語,繁中對其他語言的表現,官方沒有單獨給成績。要拿它做繁中主力流程的單位,用自己的文件實測,比引用任何評測分數都可靠。想在手機上先試離線翻譯手感的人,先前介紹過的 RTranslator 開源離線翻譯 App 是現成可裝的另一條路,兩者定位剛好對照:一個是成品 App,一個是開放材料。
這套模型對文件流程真正有差異的地方,在請求裡可以放進去的東西。除了原文與目標語言,模型接受三種輸入:前後文(context)用來說明整份文件的情境,例如這是什麼性質的頁面、名詞屬於哪個領域;詞彙表(glossary)成對指定原詞與譯法,產品名、部門用語、人名都適用;翻譯歷史(history)則把前面的原文與譯文成對傳入,讓模型翻下一段時沿用前面已經確定的用詞與文體。
官方文件給了一個把三者合併使用的完整範例,可以直接看懂各自的分工:翻一份文件翻到第三句時,程式把前兩句的原文與譯文當成歷史傳入,附上這一頁的頁面類型當前後文,再用詞彙表把日文的原詞固定成指定的譯法,模型就只翻第三句,而且用詞跟前兩句一致。官方同時明講了各自的生效範圍:前後文作用於整次請求,詞彙表只作用於本次翻譯,歷史不會回頭改寫已完成的舊譯文,也不會自動永久保存,每次請求要由程式自己帶入需要的部分。
對長文件來說,歷史與上限要一起算。歷史本身也算輸入,官方要求整個輸入加上輸出控制在 32,768 個 token 以內,超過時建議先丟掉最舊的段落、保留最近的;官方提供的 vLLM 部署範例把單次輸入加輸出的上限設成 16,384,這是該範例的部署參數,可以依硬體調整,不代表模型的能力上限就到那裡。段落切分因此有明確目的:保留足以維持用詞一致的歷史,同時讓本次譯文有空間完整收尾;把輸出上限設得太小,結果只會是把譯文截斷,省不了多少空間。
另外,輸出目標語言是日文時,可以指定普通體或禮貌體,這項文體設定官方只提供給日文輸出,其他語言沒有對應選項;這些控制都要放在專用參數裡傳,混進待翻原文是行不通的。部署介面有三條現成路徑:Hugging Face transformers 的直接呼叫、vLLM 部署,以及 vLLM 起一個 OpenAI 相容的 API 伺服器讓既有程式對接,對已經在跑其他模型的團隊來說,第三條路的改動成本最低。把推理留在使用者的設備上執行,也是瀏覽器端正在走的方向,Opera WebAI 預覽版已經讓網站能直接借用你電腦裡的模型。
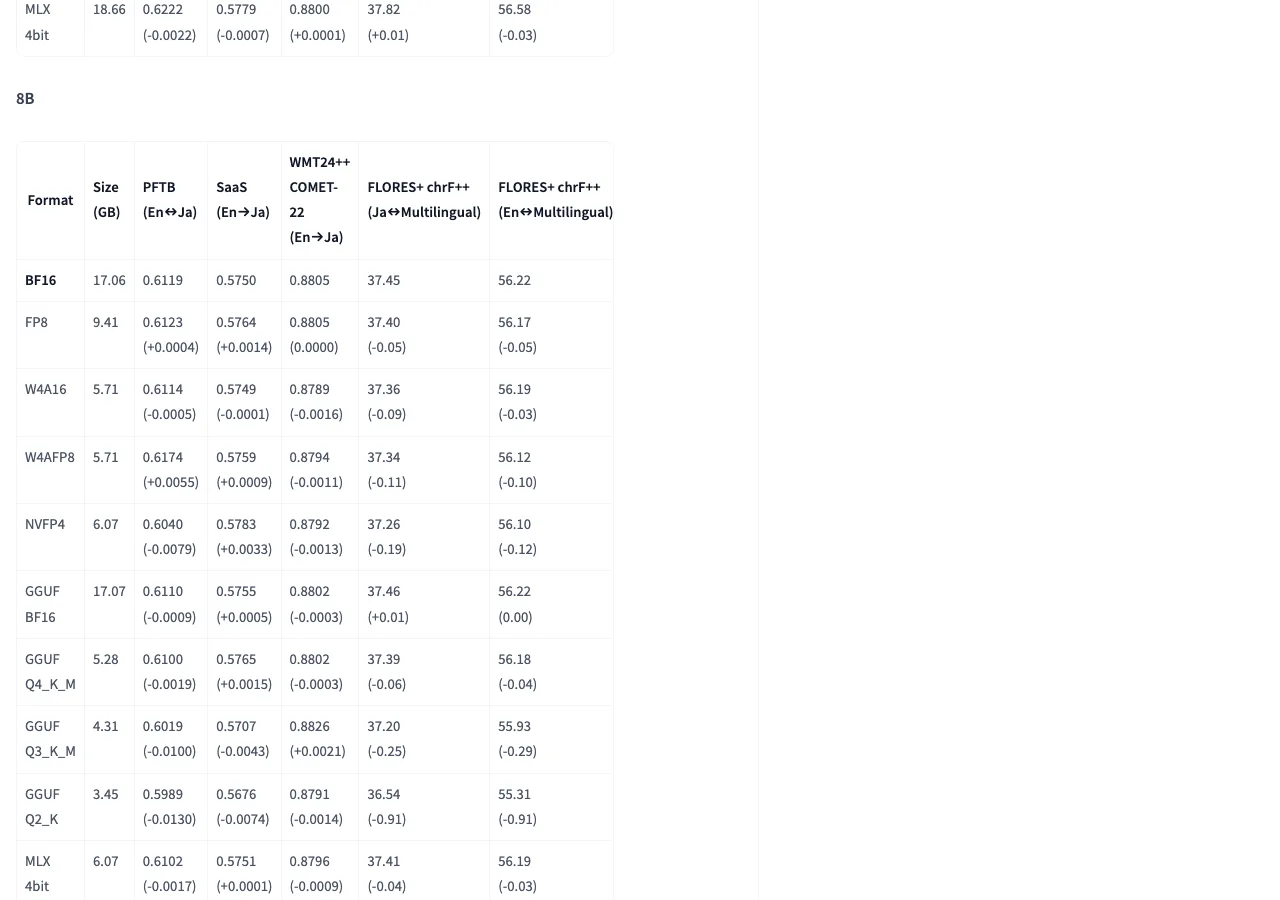
尺寸之間的落差先看最大與居中兩級:31B 的 BF16 完整權重約 63.51 GB,是伺服器等級的部署;8B 的 BF16 約 17.06 GB,GGUF Q4_K_M 四位元格式約 5.28 GB,MLX 4bit 約 6.07 GB。Hugging Face 上每個尺寸都另外提供 FP8、W4A16、NVFP4 等量化變體與 GGUF、MLX 版本,GGUF 是 llama.cpp 生態系的格式,MLX 則是 Apple Silicon 上的執行路徑,Mac 使用者有現成的跑法。官方同表附了各格式與 BF16 的評測分數差異,8B 的 Q4_K_M 在日英 PFTB 上只少 0.0019、WMT24++ 幾乎持平,各量化格式在日英指標的差距多在小數點後三位以內;但官方自己點名了例外:GGUF Q2_K 在部分指標的分數明顯下降,其餘格式才維持接近 BF16。這組數字回答的是容量取捨,但要提醒一件事:檔案大小與完整記憶體需求是兩回事,執行環境、輸入與輸出另外占空間,長文件還會隨歷史累積,官方也從未把檔案數字當成硬體需求宣稱。
小模型為何能撐住翻譯品質,官方部落格給了訓練側的答案:大量功夫花在資料提煉,用錦標賽式資料合成、回譯(back-translation)與迭代自我蒸餾做出高品質翻譯資料,再把能力蒸餾進小模型。模型卡另外載明,8B 的底座是 PLaMo 3 NICT,這是 PFN 與日本情報通信研究機構(NICT)共同研究的預訓練模型,翻譯能力是在這個底座上再訓練出來的。這些是官方對自家方法與來源的說明,採用時可以據此理解它的能力邊界來自翻譯資料的分布,而不是通用語言能力。
新聞稿裡最顯眼的宣稱,是 0.8B 最小版在日本語與英語、以及日語與其他語言的翻譯上勝過現有翻譯專用模型,點名的對照組包含 Google 的 TranslateGemma 與騰訊的 Hy-MT2,官方部落格進一步說這包括參數量超過 30 倍的模型。跟自家前一代比也有明確的進步幅度:上一代 PLaMo 2 Translate 的權重同樣放在 Hugging Face 上開放下載,這次官方說最小的 0.8B 在日英翻譯上超過上一代的 8B 版,等於用十分之一的參數量勝過大上十倍的模型。訓練方法也換了路線:官方說明 PLaMo 2 當時的進步主要來自後續的 DPO 階段,這一代則靠細煉後的資料在 SFT 階段就拿到主要增益。
這些數字全部出自 PFN 自己的評測,而且評測組合裡含自家內部基準(PFTB 與 SaaS),獨立第三方的評測到本文撰寫時還沒有出現。把宣稱的來源交代清楚,比轉述結論重要:在獨立驗證出現之前,這些成績應該當成廠商自述,採購決策用它當線索可以,當依據不夠。
授權是這次開放最需要睜大眼的部分。PLaMo 3 Translate 採用 PLaMo Community License,個人與學術用途免費;商用的定義很寬,條款寫明個人與學術以外的一切使用都算,包括公司內部營運、開發產品、透過 API 或託管服務提供功能。換句話說,公司只在內部翻文件、沒有對外收一毛錢,在條款下仍然是商用。
商用要合法免費,得同時滿足兩個條件:先在 PFN 官方頁面完成登記,而且使用者或其關係企業的年度營收不超過 10 億日圓(依使用者所在地的貨幣換算)。門檻包含剛好 10 億日圓的情況,超過就必須另外向 PFN 取得商業授權。一個細節值得記下:PFN 在新聞稿發布當天上午 11 點 45 分修正過這段措辭,目前版本寫的是 10 億日圓以下,讀到早期報導的人可能拿到舊說法。
要把模型再散布出去,義務還有三條:提供條款副本給取得者、在相關網站介面與文件標示 Built with PLaMo、衍生 AI 模型的名稱裡要保留 PLaMo 字樣。公開展示模型輸出時,要說明輸出來自模型或衍生模型;用輸出再去訓練其他模型,訓練出來的模型一律視為衍生模型,受同樣條件約束。對想把模型包進產品的團隊,這幾條直接影響交付方式與命名。
風險分配也值得看一眼再簽。條款載明模型與輸出以現狀提供、不做任何擔保,PFN 對使用者的賠償責任上限是 500 日圓,而且一旦用於業務目的,PFN 不負任何賠償責任;條款同時要求使用者就第三方向 PFN 提出的求償負補償義務。準據法是日本法,爭議由東京地方法院專屬管轄。對個人試用這些條款影響不大,對要把它放進商業流程的團隊,這幾行小字比模型分數更值得讓法務看過一遍。
如果讀者的情境對得上,現在能做的評估很具體:挑一批自己的文件樣本,用同一批內容比較 8B 的 BF16 與 Q4_K_M 版本,看四位元在自家語對上的實際差異;繁中流程把詞彙表與歷史參數一起納入測試,因為這兩項是它對文件翻譯最主要的控制點;商用單位同步對照營收門檻與登記流程,把標示義務算進交付成本。這些動作都只依賴已經公開的權重與條款,不需要等任何人。
兩種人可以先省下這趟工。只想偶爾翻幾句旅遊對話或網頁段落的個人用戶,現成的翻譯 App 或雲端服務安裝與維護成本都低得多,本機權重的優勢要檔案量與機密性上來之後才會顯現;營收已經超過 10 億日圓又想把模型放進產品的團隊,下載之前該做的是先去找 PFN 談商業授權,條款裡沒有先上車後補票的選項。
還沒有答案的也一樣清楚:繁中語對的獨立評測還沒有人做,商用授權的方案與價格 PFN 未公布,條款本身允許 PFN 日後修改,門檻與義務都可能變動。後續值得留意三個訊號:第三方評測出現、PFN 公布商業授權方案、或條款出現修訂。在那之前,這次開放最有把握的讀法是:可完全離線、可指定術語與前文的翻譯模型第一次免費到手,但它免費的邊界畫在授權條款上,畫在營收 10 億日圓那條線上,不在下載按鈕上。