TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

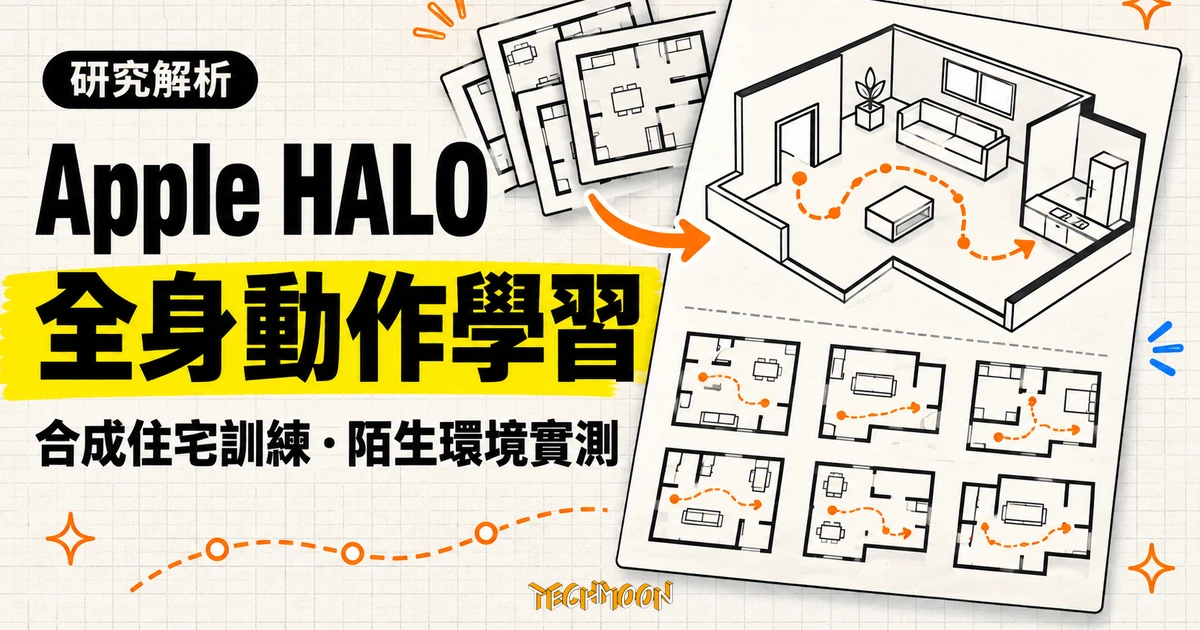
Apple 團隊發表 HALO 人形機器人系統:不收集真人遙控示範,改在一千個程序生成的合成住宅中產生視覺語言動作配對資料,訓練走向指定物件、坐椅子、側身過門、蹲下爬行與推箱子等全身技能,並在六個未建圖的真實環境完成 360 次測試、論文回報平均成功率 91%,序列任務則降到 70%。
用 AI 摘要這篇文章:
要讓人形機器人學會「看著客廳、聽一句話、坐下」這種全身動作,業界過去靠真人示範:遙操作平台或穿戴式捕捉設備,一小時的資料至少得花掉一小時的人力。Apple 團隊 11 月 4 日提交到 arXiv 的論文換掉了這個單位。研究命名 HALO,訓練語料全部在模擬環境合成:250 張 H100 GPU 跑約 48 小時,產出約 300 小時配對好的第一人稱影像、文字指令與全身動作軌跡,資料來源是一千間程序生成的住宅,沒有任何一間經過掃描或人工建模。
這條路徑能不能跨進物理世界,論文給的驗收方式比多數同類研究直接:六種技能,放到六個從未見過、也未曾建圖的真實環境,每項各測十次,合計 360 次實機測試,作者回報平均成功率 91%。同一套協議在 100 個模擬環境跑 6,000 次,平均也是 91%。研究程式已在 11 月 5 日上線 GitHub,官方專案頁附示範影片與三維重播。
資料生成流程拆成三段,全部不需要真人上場。
動作這端先來。團隊把每個任務拆成幾段動作片段,交給名為 Kimodo 的運動擴散模型生成,例如「坐上扶手椅」會拆成向前走、轉身、坐下三段,終點對準椅面的關鍵姿勢。擴散模型只管運動學,生成結果可能滑步、穿進地板或憑空跳動,所以每段會生成多個候選,用正向運動學的幾何驗證器檢查腳底滑動、地板穿透與關節極限,只留分數最高的那一個。坐椅子任務設 33 項檢查,步行段落從 16 個候選裡取最佳;爬行與蹲下的關鍵影格來自手機影片,經動作重建模型轉換後,每段 21 項檢查、20 選 1。
各技能的資料量並不均勻。走向物件最多,50,000 段;坐椅子 25,349 段、穿門 29,207 段、爬行 19,066 段、蹲下 19,369 段、推箱子 19,707 段,合計 162,698 段,平均每段只有 6.6 秒。
場景這端用開源工具 Infinigen 程序化生成一千個室內空間,涵蓋客廳、辦公室與臥室三類,格局與家具各不相同。接著把驗證過的動作軌跡連同目標家具一起擺進場景:系統在二維佔用網格上抽樣擺放位置,接受第一組不與家具碰撞的配置。最後用貼近實機的魚眼鏡頭設定渲染第一人稱畫面,加上色溫、曝光、動態模糊與感測器雜訊的域隨機化,讓模型別過度依賴某一種乾淨的模擬外觀。
整套語料合計 296.3 小時,論文行文取整寫 300 小時。生成過程無人介入,瓶頸從人力換成運算。論文也把帳算得清楚:生成資料用 250 張 H100 約 48 小時,動作生成器訓練用 64 張 B200,追蹤器訓練用 4 張 H100。
HALO 的自主堆疊分三層,跑在機器人身上,三層用三種頻率各做各的事。
最外層是任務編排器,約每兩秒跑一次。它是現成的視覺語言模型,讀取廣角相機畫面與使用者的指令,把「坐一下」這種沒講明目標的要求拆成一串子任務,成功了往前推進,失敗就重試。論文預設讓它在機身上的 Mac mini 跑 4 位元量化的 Qwen3.6-35B-A3B,因此不連網也成立,需要更強推理時可改路由到雲端模型。
中層是動作生成器,約每秒三次。它把眼前的畫面與當前子任務變成一份五秒的全身動作計畫:30Hz、150 幀、每幀 36 個數值,包含 29 個關節角度與骨盆位置。模型主體是一個凍結的 Qwen3.5-2B 視覺語言編碼器,接上從零訓練的 DiT 擴散解碼器,以流匹配取樣 15 步完成。五秒計畫只承諾執行前半秒,新畫面進來就重新規劃,避免身體在計畫交接時瞬間換一套姿勢。
最內層是動作追蹤器,每秒 50 次。它讀取深度與機器人自身姿態,追著上層計畫輸出關節目標,跑在機器人原廠的 Jetson Orin NX 上,用 C++ 即時程式實作,核心在 PREEMPT_RT 核心上保證控制循環不被阻塞。訓練走三階段:先為每類技能訓練看得到特權資訊的 PPO 專家,再蒸餾成只吃機上感測的單一學生,最後帶深度做多批評者強化學習收尾。工程細節不放過馬達:訓練時模擬命令延遲、對深度影像加掉幀與斑點雜訊,獎勵函式還直接懲罰膝蓋過大的負機械功率,避免策略依賴模擬器默默裁掉、實機馬達卻給不出來的力矩。
論文附有三層延遲的量測。動作生成器單獨跑約 152 毫秒,與編排器共用推理引擎約 155 毫秒,幾乎不掉速;編排器的子任務轉換單獨跑約 0.72 秒,與生成器共處時拉長到約 1.46 秒。這也解釋了頻率的分工:轉換慢,所以兩秒一次;規劃快,所以每秒三次接力。
硬體是 Unitree G1,加了兩處改裝:頭頂一支 OAK-1W 廣角相機負責 120 度彩色視野,背後掛一台 Mac mini M4 Pro(64GB 統一記憶體)跑編排器與動作生成器。深度感測用機身原廠向下 55 度的 RealSense D435i,團隊繞過它原生雜訊偏多的深度輸出,把原始紅外立體影像對直接餵給 Jetson 上的 TensorRT 立體匹配模型重算深度。Apple 做研究,機身用他廠的 G1,運算用自家的 M4 Pro,這個組合本身就是消息。
六種受測技能是走向指定物件、坐椅子、側身穿過半開的門、蹲下與爬行鑽過低矮障礙、推箱子,全是移動與全身姿勢的配合。論文回報的實機分項成績:蹲下 100%、穿門 93%、走向物件 92%、爬行 90%、坐椅子 85%、推箱子 88%。
成功判準寫得很硬。摔倒直接判定失敗:骨盆傾角超過 60 度、或骨盆高度低於 0.30 公尺持續一秒即算;坐椅子要求終點坐在距椅子 0.9 公尺內、軀幹直立 40 度以內;推箱子要求箱子至少移動 0.3 公尺;穿門要求不撞門板、站定在門的迴轉範圍外。環境全是訓練時沒見過的,也沒有事先掃描建圖,量的是對陌生空間的遷移,不是沿著預錄路線重播。
評測協議的對照也值得記一筆。論文整理的前作資料顯示:VLK 只在兩間掃描過並拿來訓練的房間裡測,TANGO 的實機測試是 3 個房間共 45 次,GRAIL 沒揭露環境數。HALO 的 360 次、6 個未建圖環境,在同類工作裡屬於協議較嚴的一檔。這是作者自己做的整理,讀的時候記住它對比的是協議涵蓋範圍,與前作之間並不存在同一基準的頭對頭評測。
單項技能接成連續任務,數字就往下走。三種序列在實機各測十次:穿門後走向目標 100%、蹲下後坐下 60%、蹲下後走向目標再推箱子 50%,平均 70%。分母合計三十次,與單項測試回答的是兩個問題,這裡量的是一個步驟結束時留下的姿態,能不能撐起下一步。
論文對失敗的歸因相當具體。最長那組序列的 5 次失敗裡,有 3 次是蹲下結束時頭沒有朝向箱子,目標根本不在視野裡,機器人接著被其他物件分散注意;蹲下後坐下的案例中,有兩次因為蹲完的朝向,把右邊的沙發當成要坐的椅子。模擬側的穿門鏈也出現同一機制:門的姿態決定出口朝向,穿門本身在鏈內成功率 85%,但目標物件可能因此完全離開視野,走向物件的條件成功率降到 83%,整鏈只剩 71%。
作者開出的藥方是補上基本恢復行為:搜尋與原地轉身。看得到的世界決定下一步能做什麼,這個失敗模式對所有分層式機器人系統都適用,也是這篇論文留下來最耐讀的一段分析。
場景多樣性值多少錢,論文用固定其他變數、只改場景數的方式回答:在未見過的模擬環境測坐椅子,場景從 1 間加到 100 間,成功率從 43% 升到 81%;再加到 1,000 間,只再多 3 個百分點到 84%。多樣性前段收益大,後段趨緩,這對想跟進的團隊是直接的預算參考。
另外三個消融各對應一個設計選擇。計畫接續性:訓練時就把已承諾片段當條件輸入,坐椅子 84%;改成只在推論時用修補式接續,66%;完全不處理,24%。解碼器:把流匹配 DiT 換成同規模的回歸解碼器,掉到 19%,而且離開訓練分布後計畫只剩粗略路徑、關節細節消失。深度感測:追蹤器拿掉深度只剩本體感覺,74%。接續機制與深度感知是這套系統的兩面載重牆。
GitHub 上的 ml-halo 儲存庫收錄資料生成、動作生成器、追蹤器、編排器與閉迴路系統等程式目錄,加上 Unitree G1 的機器人模型檔與文件,含模擬與實機的啟動腳本,論文的方法都有對應程式。但把「程式可讀」讀成「人人能重現」會踩到三個邊界。
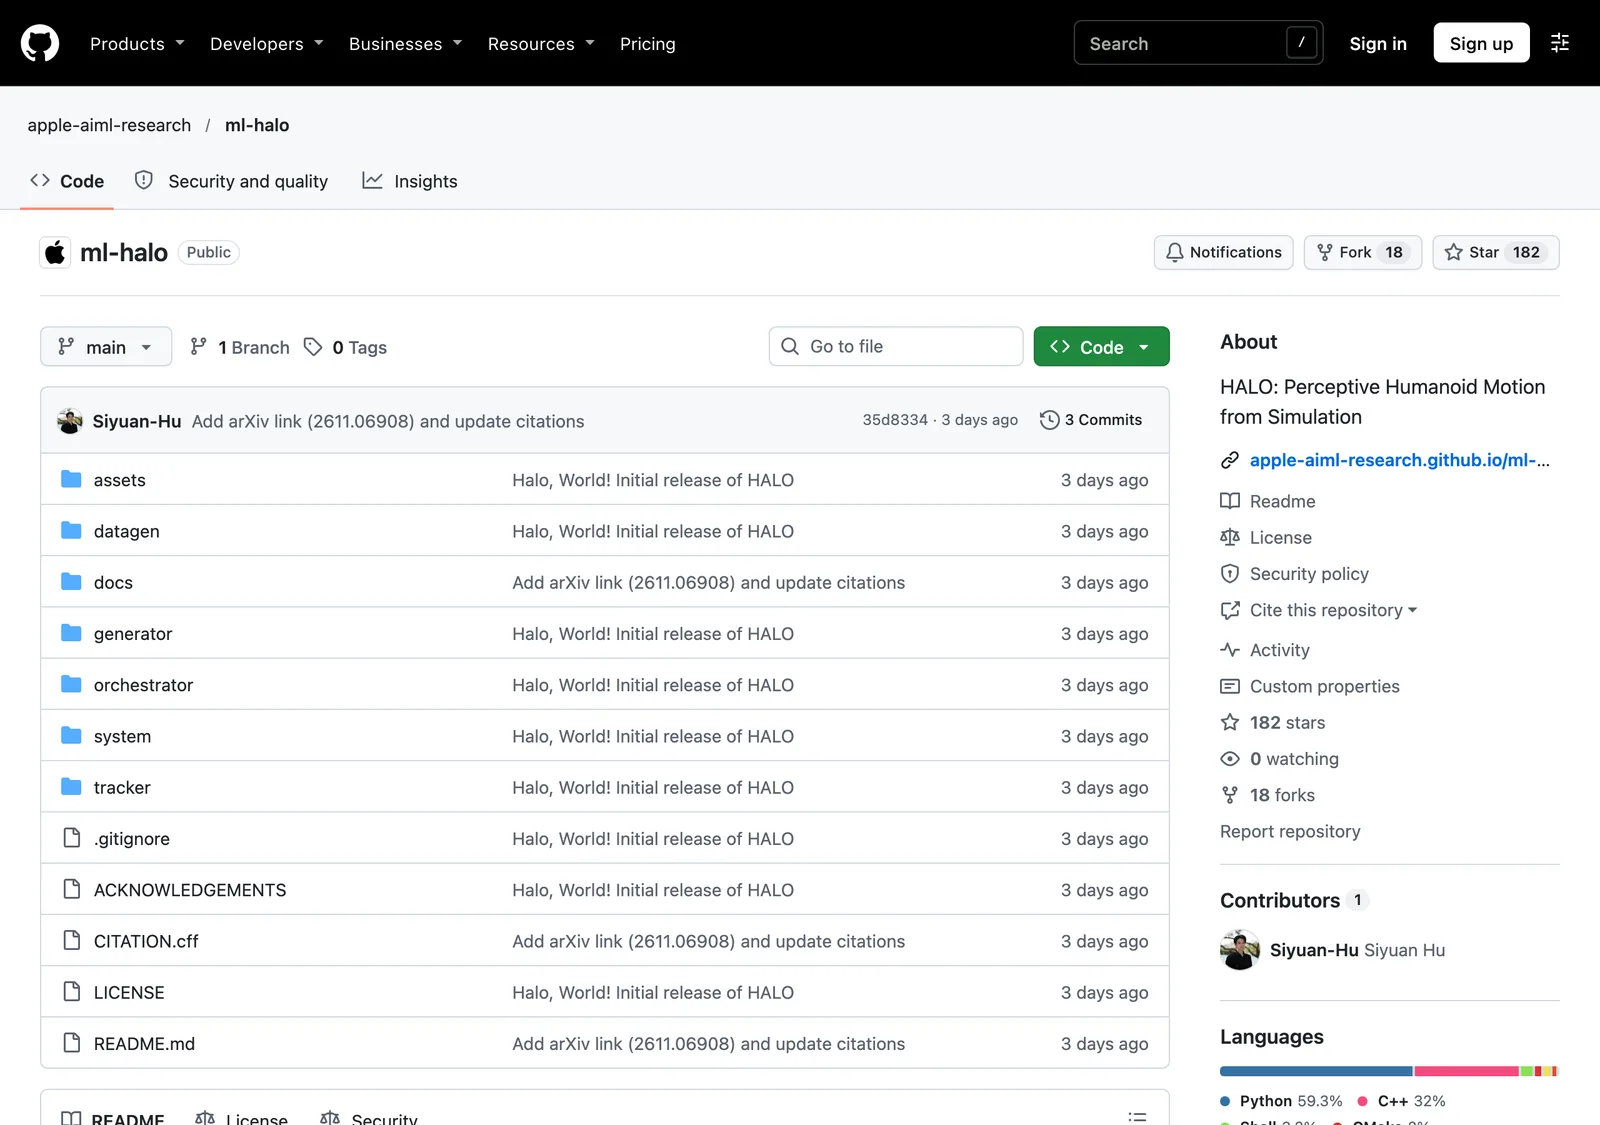
授權不是 OSI 認證的開源條款,而是 Apple 自家的授權文件:個人、非專屬授權,允許使用、修改與再散布,商標使用與專利權利不在授予範圍。程式之外,repo 未隨附訓練好的追蹤器權重,追蹤器要照訓練流程自己練。硬體更不在程式庫裡:重現需要 Unitree G1 機身、改裝的相機與背包電腦,以及對應的訓練運算。
論文自己也畫出方法的邊界。任務目錄比「自由語言」四個字聽起來窄得多:整套語料其實只有十條固定指令,例如坐扶手椅、走到垃圾桶、鑽到桌下、推箱子,編排器在執行時把使用者的自由說法對應到其中一條。新增任務仍需要人撰寫提示與動作關鍵影格,目錄成長的速度受限於人。視覺之外沒有觸覺,物件離開視野或被遮擋後系統就失去它在哪裡的訊號,接觸密集的任務會跟著退化;追蹤器只負責跟隨計畫,不知道計畫的目的;編排層相對簡單,任務一多就需要更進一步的代理式設計。
編碼器的取捨也值得記下。動作生成器的 Qwen3.5-2B 編碼器刻意凍結不微調,附錄交代了原因:微調後反應更快更平順,但訓練資料裡跟隨的人只有一種人物模型,微調過的編碼器就只認得長得像那個模型的人,凍結版本反而靠預訓練的常識認得各種人;微調版本還會學到捷徑,畫面裡有椅子就忽略指令直接去坐。要兩者兼得,就得重渲染更多不同人物的訓練資料。把「常識保留」與「反應速度」分開標價,這段誠實的附錄比主結果更值得後續研究細讀。
這是一篇預印本,尚未經過同儕審查,結果與結論仍可能隨會議版本修訂,追蹤器權重會不會日後釋出也沒有承諾。對「合成資料能不能撐起實機人形機器人」這個問題,HALO 給出的證據明確但不完整:單項技能在陌生環境的遷移已經有 360 次實測支撐,長序列、接觸判斷與任務目錄的擴充方式,是接下來三道還沒過的關。
把視野放寬一點看,資料效率的競賽正在多線推進:單卡就能訓練的人形機器人策略、以配對評測橫跨一百多個真實場地的評測網,以及多機械臂資料生成,都在從不同方向擠壓「示範資料靠人力」這個舊瓶頸。HALO 的位置是把單位換算做成最徹底的一家:連示範都不收,資料從第一間程序化生成的房子開始算。