TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Moonshot 於 2026 年 11 月 4 日開放 Kimi K3.1 Pro 權重下載:Hugging Face 儲存庫列出 96 個分片、合計約 1.56TB,路由專家權重採 MXFP4 量化、其餘為 BF16。本文核對官方儲存庫、vLLM 部署指引與 Kimi K3.1 Pro 授權條款,整理自架前要確認的檔案、硬體與授權三件事。
用 AI 摘要這篇文章:
Kimi K3.1 Pro 的模型權重在 11 月 4 日開放下載了。Moonshot 官方帳號於台北時間 11 月 5 日凌晨 0 點在 X 發文宣布「Releasing the model weights of Kimi K3.1 Pro」,連往 Hugging Face 上的 moonshotai/Kimi-K3.1-Pro 儲存庫。這是 10 月 23 日模型以 API 形式上線時官方承諾的兌現:當時 Moonshot 表示完整權重會在 11 月 4 日前釋出。
不過「權重可以下載」和「你家跑得起來、可以拿去商用」之間還有三段距離。截至 11 月 5 日,官方儲存庫、模型卡與 vLLM 部署食譜指向三道門檻:一份 96 個分片、合計約 1.56TB 的下載;一份以八張資料中心 GPU 為基線的部署需求;以及一份自訂授權裡的兩個數字界線。想自架的團隊照著這三件事逐一核對,比先看榜單分數更實際。
先把時間線釐清。Kimi K3.1 Pro 在 10 月 23 日登上 Kimi 平台的 API,當時模型還是封閉權重狀態,外界只能透過 API 呼叫。英國開發者 Simon Willison 在上線當天記下了官方的承諾:完整模型權重會在 11 月 4 日前釋出,同時記下的還有每百萬輸入 token 2 美元、輸出 token 10 美元的上線定價。
11 月 4 日 16:00(UTC),官方 X 帳號 @Kimi_Moonshot 貼出權重釋出公告,全文只有兩句話:釋出 Kimi K3.1 Pro 的模型權重,並表示會持續推進開放智慧。換算成台北時間是 11 月 5 日凌晨 0 點,剛好壓在承諾期限的最後一天兌現。
Hugging Face 儲存庫本身的建立時間其實更早:公開 commit 紀錄顯示儲存庫在 11 月 2 日就有第一次提交,11 月 5 日又更新了編碼相關的程式碼檔案。從公開 API 沒辦法判讀儲存庫在中間這兩天是公開還是私有狀態,所以權重「實際可下載的精準時刻」以官方宣布時間為準。
截至 11 月 5 日傍晚,這個儲存庫已經累積超過 11,000 次下載與近 800 個收藏。對照 11 月 2 日獨立評測機構 Artificial Analysis 上架 HLE-Diamond 榜單時,Kimi K3.1 Pro 還被標註為「權重未發布」的開放權重模型,這一週內狀態確實翻頁了(該榜單的細節可參考我們先前的整理)。
打開儲存庫檔案列表,這次釋出的主體是 96 個 safetensors 分片,連同索引與組態檔,整個儲存庫逐檔加總是 1,561,355,878,965 位元組,以十進位換算約 1.56TB。單一分片大多落在 16.6 到 17.0GB 之間;第一片只有 2.3GB,最後三片也是明顯較小的收尾分片。除了權重本體,儲存庫還帶了授權條款、模型卡、組態設定,以及一份需要 --trust-remote-code 才能執行的自訂程式碼(configuration_kimi_k3.py 等),載入時引擎會一併讀取。
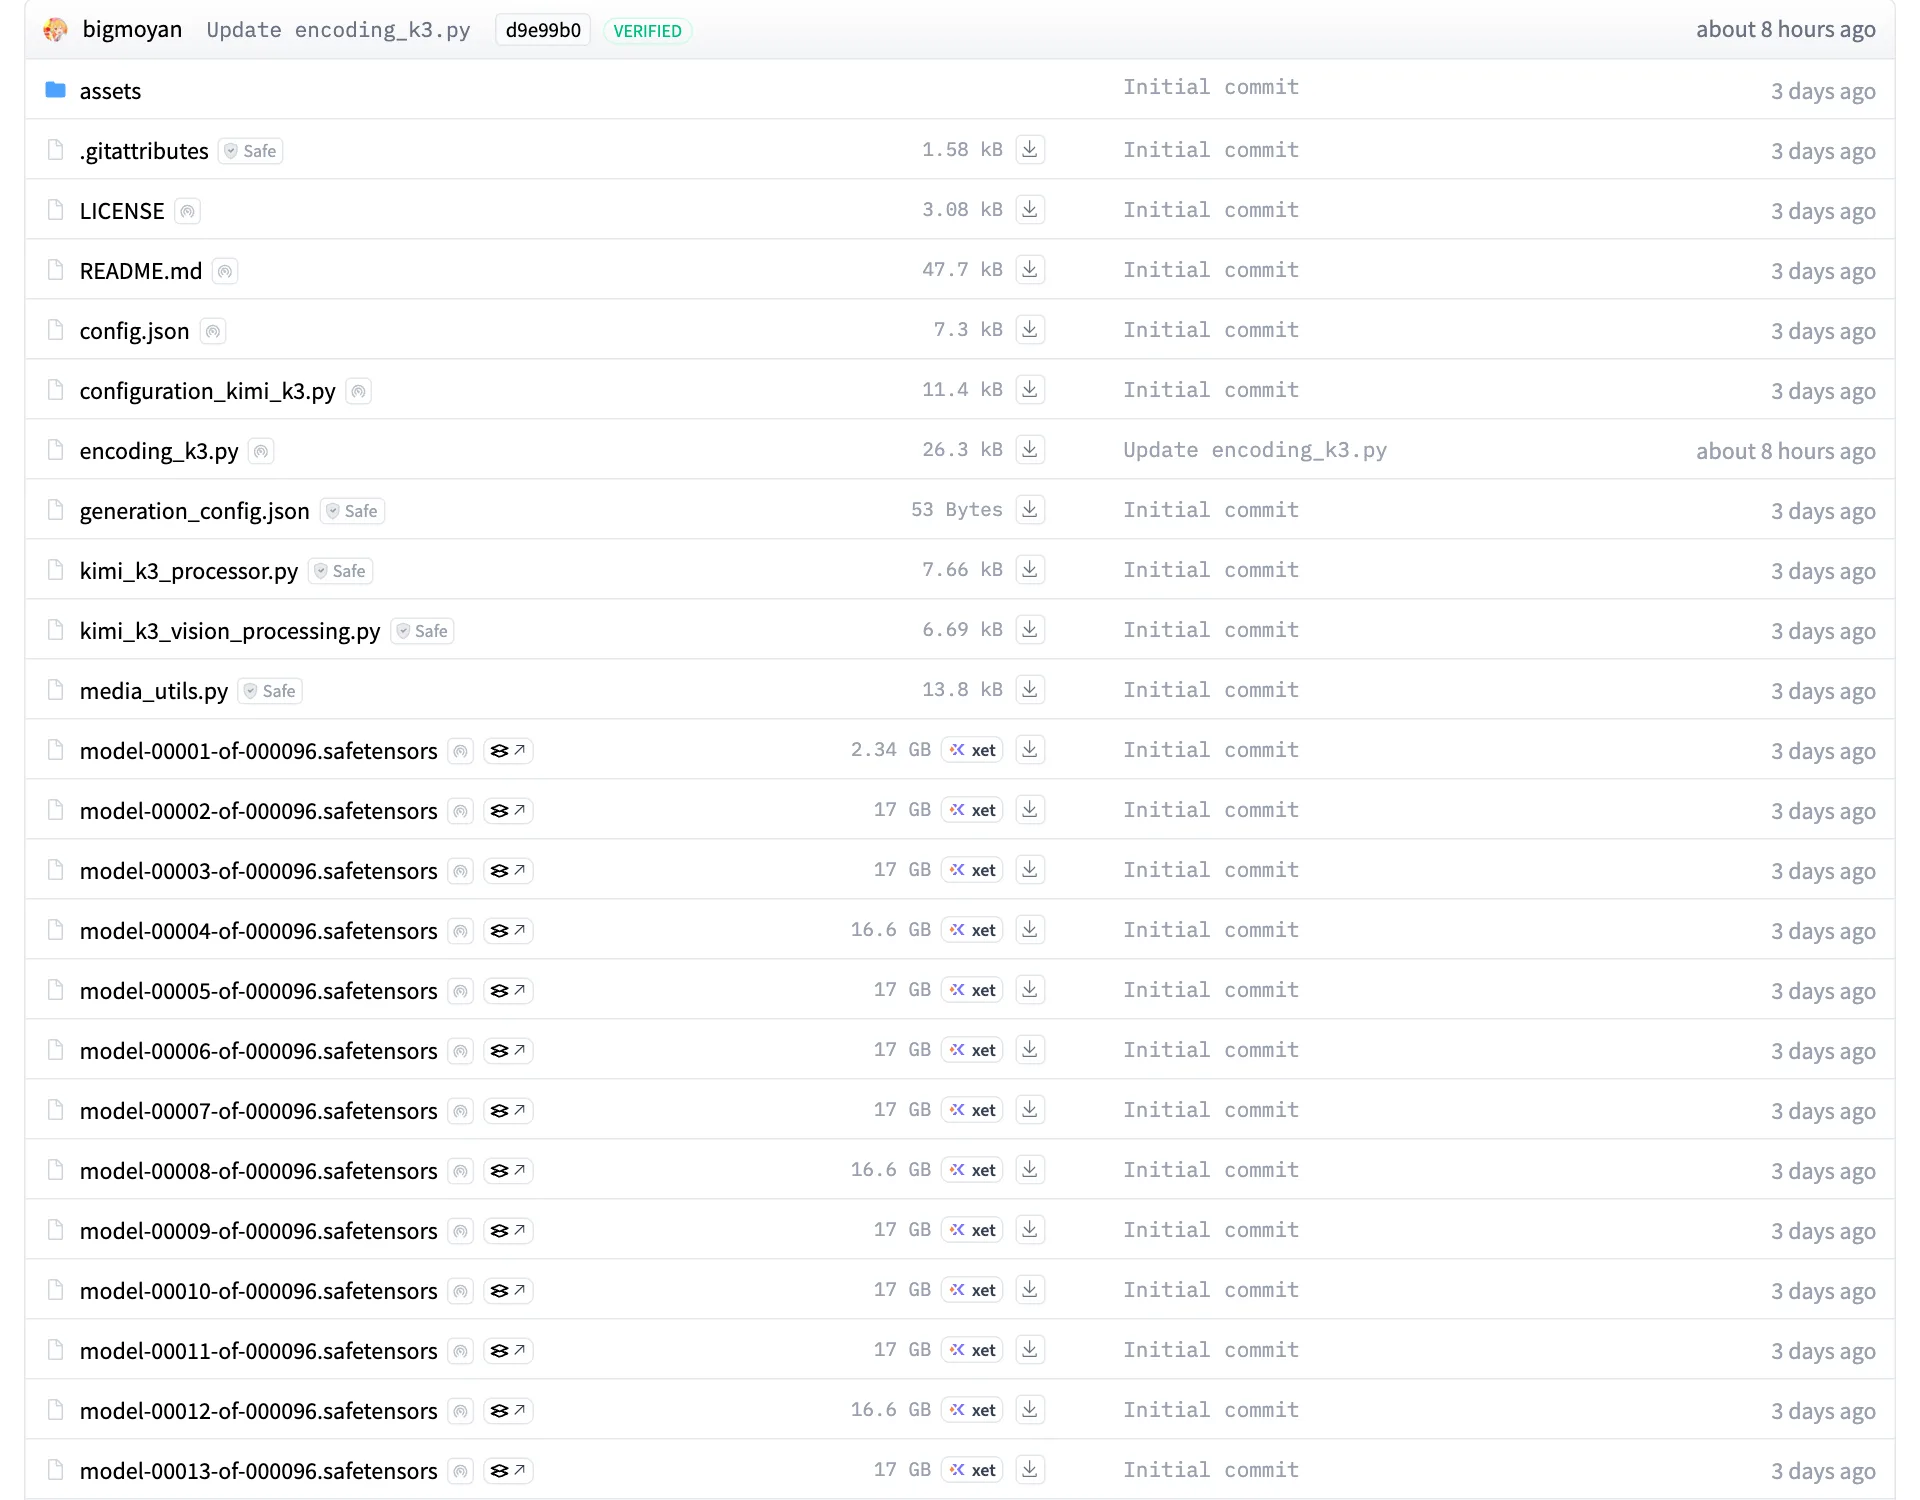
分片是一種把大檔案切成好處理段落的儲存方式。真正要注意的是這些分片裡的數值格式:官方模型卡載明這次釋出採用 MXFP4 權重與 MXFP8 活化值,並使用量化感知訓練。用白話說,MXFP4 是一種用比較少的位元保存數值的格式,能直接壓低儲存與搬移成本;活化值則是模型運算過程中間層的輸出,以 MXFP8 保存。量化感知訓練的意思是模型在訓練階段就預先適應了這種低精度保存,而非訓練完再硬壓。
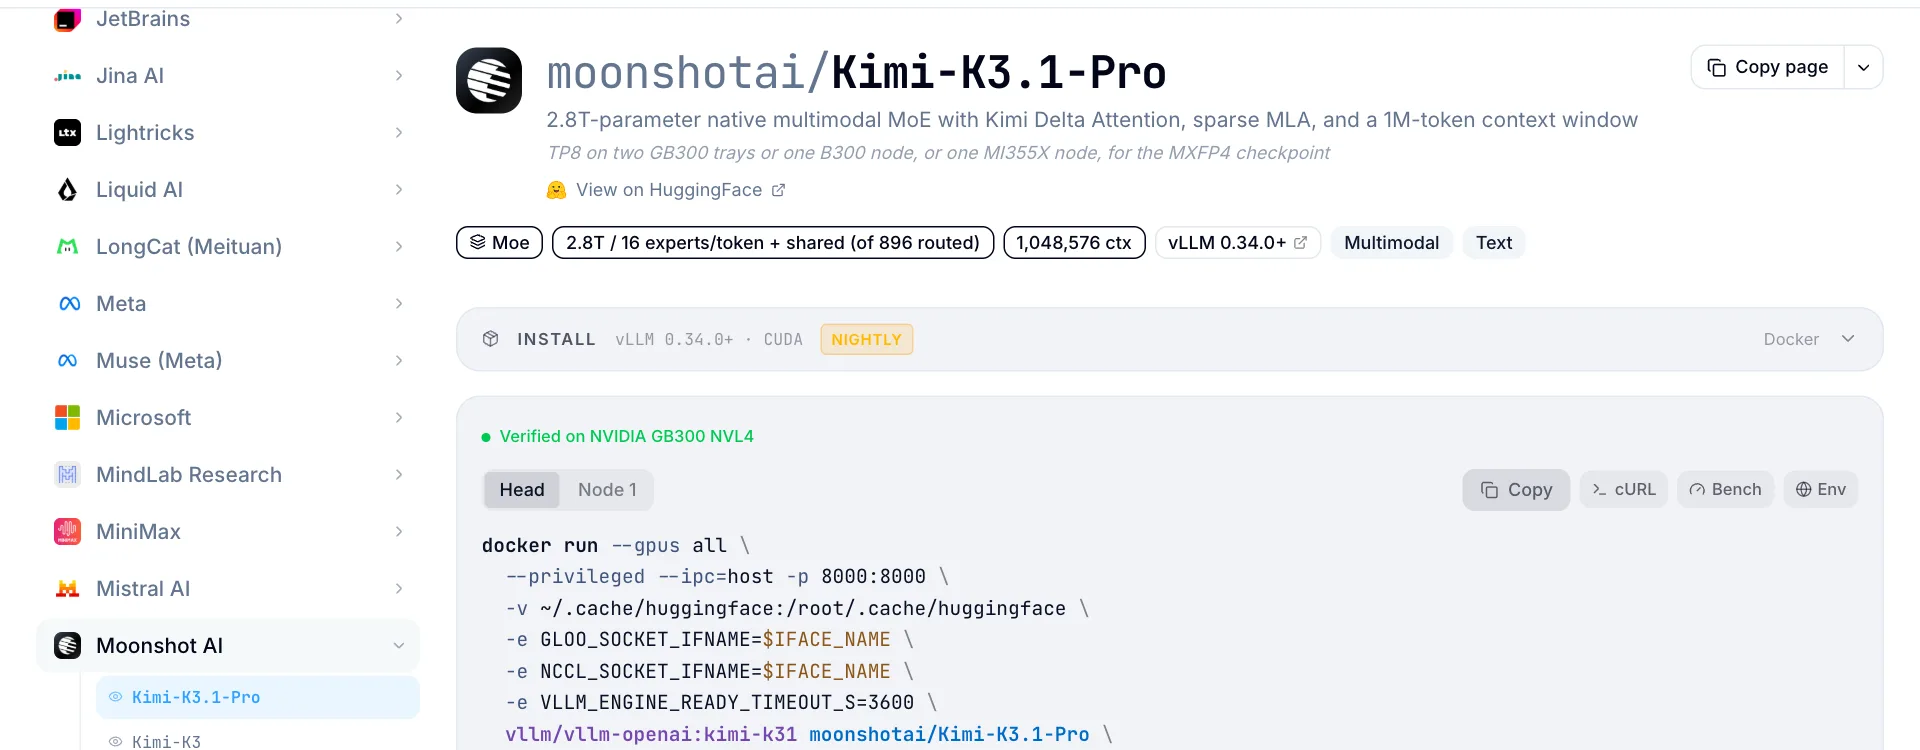
vLLM 官方食譜補了一個容易誤會的細節:整份檔案並非全部都是 MXFP4。只有路由專家的權重採用 MXFP4,其餘部分仍是 BF16。這裡的路由專家是混合專家架構裡「按需上工」的那一批參數:模型共有 896 個路由專家,每次運算由路由機制挑出 16 個,另外加上 2 個每次都在場的共享專家。換句話說,這是一份混合精度的檢查點,1.56TB 的體積正是這個混合結果,而占大頭、也最值得壓縮的正是那 896 個專家。能不能跑、跑得多快,取決於推論引擎對這些格式的支援程度,這直接連到下一道門檻。
對要動手下載的團隊,兩個務實提醒。先固定版本:儲存庫 11 月 5 日就又更新過程式碼檔案,同一個儲存庫名稱將來可能指向不同內容,記下修訂版識別碼才有共同的比較基準。磁碟則要按完整檔案準備:模型是混合專家架構,官方規格為 2.8T 總參數、每個運算只啟動其中 104B,但沒被啟動的專家權重仍然是檔案的一部分,下載與儲存都要按 1.56TB 全額規劃。
規格表上有三個數字值得順手記下:上下文長度 104 萬 8,576 token,在開放權重模型裡屬於最長的一級;這是原生多模態模型,文字與影像輸入都走同一套權重,影像編碼器 MoonViT-V2 有 401M 參數;與前代 Kimi K3 相比,這代把 24 層注意力換成了閘控式稀疏注意力(Gated DSA),官方說明這是為了長情境的運算效率,其餘骨架沿用 K3 的配置。也就是說,K3.1 Pro 的總參數規模與 K3 相同,這次的重點在權重釋出本身與新的注意力配置。
模型卡列出三個官方建議的推論引擎:vLLM、SGLang 與 TokenSpeed,各自配有部署文件。其中 vLLM 的食譜寫得最具體,也需要 0.34.0 以上版本,食譜註明這個版本尚未正式發布,需以 nightly wheel 安裝。
基線配置是八卡張量並行:NVIDIA 這邊是兩個 GB300 tray(每個 NVL4 四卡),或一個 B300 節點;AMD 這邊一個 MI355X 節點就能以同樣的 TP8 布局跑起來。張量並行是把模型每一層的運算切到多張卡上同時做的平行策略,TP8 就是切八份,也因此入場票固定是八的倍數。食譜還列出 VR200 預覽版(搭配專用容器映像檔)、AMD MI355X 上的 AgentX 調校組態,以及中國振武 PPU 的兩條多節點路線。啟動指令本身不複雜,重點參數是 --tensor-parallel-size 8、--load-format fastsafetensors,以及 --tool-call-parser kimi_k3 與 --reasoning-parser kimi_k3 這兩個解析器,分別讓引擎正確解析模型的工具呼叫格式與思考內容格式。
工程面還有一個容易踩坑的細節,自架和呼叫 API 都適用:Kimi K3.1 Pro 的推理強度用 reasoning_effort 參數控制,支援 low、high、max 三檔,預設 max。做多輪對話或工具呼叫時,官方要求把前一輪 API 回傳的完整助理訊息原樣傳回 messages,包含思考內容與工具呼叫紀錄,不能只挑文字部分。官方模型卡的範例特別示範了這件事:先讓模型在心裡列五個數字、只講出三個,下一輪追問剩下兩個,模型答得出來的前提是思考內容有被傳回去。
食譜裡有三個效能數字可以直接抄進採購評估。在同一個 B300 節點上,張量並行加上專家並行的策略可以把單一請求的預填時間從約 15 秒壓到約 10 秒。開啟解碼情境平行(DCP8)之後,快取改為跨八張卡分片共享,容量約放大七倍(FP8 快取下約 1,850 萬 token 對 260 萬 token),代價是解碼步驟慢 7% 到 25%。NVFP4 快取則把每層每 token 的儲存從 576 位元組壓到 352 位元組,容量約 1.5 倍,官方在 GB300 上驗證 GSM8K 為 96.1%,與 FP8 的 96.2% 幾乎持平。
把這些換算成採購語言:消費級顯示卡與這份模型暫時無緣,入場券是八張資料中心級 GPU 組成的節點或 tray。食譜也誠實標註這些數字「吞吐未經調校」,屬於可用性驗證,性能調校還沒有做。另一條路是不自己買硬體:Kimi K3 的同門先前已經出現在 Akamai 的託管推論目錄裡,託管推論服務未來把 K3.1 Pro 納入目錄是合理預期,但目前尚未見到官方公告。
這次釋出採用的是自訂的 Kimi K3.1 Pro License,不是 MIT 或 Apache 這類標準條款。條款給的權利本身很寬:免費、可商用、可修改、可轉授權、可出售副本。真正要畫重點的是兩個數字界線。
界線之一是兩千萬美元。如果你的團隊或關係企業經營「模型即服務」業務,讓第三方能實質控制模型呼叫的輸入、參數或訓練資料,而且合併營收在任意連續 12 個月超過 2,000 萬美元,就必須先和 Moonshot 簽另外的協議,才能把這套權重用在商業用途上。條款對「模型即服務」的定義劃得算清楚,並且排除了兩種情況:把模型能力包進自家產品特定功能的終端產品不算,純粹把請求轉發給別人託管的模型也不算。界線之二是顯示義務:如果你的商業產品或服務月活躍用戶超過 1 億,或月營收超過 2,000 萬美元,介面上必須顯著標示「Kimi K3.1-Pro」字樣。
條款也留了兩個豁免:純內部使用(不對第三方開放模型能力與輸出)不受上述兩條限制;透過 Moonshot 官方產品或認證推論夥伴使用的人,同樣不受這兩條數字界線限制。對照其他開放權重模型的授權設計,這種「寬授權加上特定規模才觸發的額外義務」正在成為一種可辨識的模式,Mistral 的 MEOW 條款走的是另一種路數,有興趣比較的讀者可以看我們之前的拆解。
對多數台灣團隊的實際意義:內部使用與嵌入自家產品功能(不開放第三方直接操控模型)都不會觸發額外義務,真正需要找律師與 Moonshot 談的,是做到一定規模的模型服務生意。
官方模型卡附了完整的自評成績單,全部以推理強度 max 檢測。看整份表格,K3.1 Pro 的優勢集中在「帶工具」的任務上:HLE-Full 開放工具輔助拿到 70.0,是表列六個模型中最高;BrowseComp 92.1、SWE Marathon v1.1 拿 51.7 也都是表列最佳。長時間工程任務的 Terminal-Bench 4.0 拿 65.7,略低於 Claude Opus 5.5 的 66.4,屬於貼身肉搏。
弱項同樣清楚。拿掉工具之後,HLE-Full 掉到 51.1,落後 Opus 5.5 的 59.8;封閉知識題型的 HLE-Diamond 只有 39.4,對比 GPT-6 Astra 的 65.8 與 Opus 5.5 的 60.9,差距超過 20 分;科學推理題的 GPQA-Diamond 拿 94.2,也小幅落後 Astra 的 96.1。電腦操作類的 OSWorld V2.1 拿 79.6,與 Opus 5.5 的 81.8 屬於同一梯隊。這個方向與獨立榜單一致:Artificial Analysis 在 11 月 2 日給過 37.3%,兩個來源指向同一個短板,也就是這個模型的知識儲備明顯弱於它的工具使用能力。
資安相關的兩項基準也值得看。ExploitBench(漏洞利用能力檢測)K3.1 Pro 拿 74.7,低於 GPT-6 Astra 的滿分 100 與 Opus 5.5 的 91.0;內部幻覺檢測 Kimi Hallu Bench Hard 開工具後的錯誤率 8.3%,優於多數對照組。前者可以視為 Moonshot 在模型能力上的主動收斂,後者對要把它接進生產流程的團隊是好消息。
照例提醒:這些是作者自評數字,模型卡自己也附了但書,例如某項檢測是在 H20 而非 H100 上跑的。引用時保留「官方自評」的框框,結論才不會過度延伸。
這次釋出後仍有幾件事沒有官方答案。權重從儲存庫建立到官宣之間的可下載狀態無法從公開管道回溯;官方吞吐數字全部標註未調校;蒸餾版或可微調的較小版本尚未有任何公告;託管推論平台何時納入也未知。
對照 API 路線,自架的價值在於版本固定、資料不出門與成本可控,代價是八卡起步的硬體與維運。如果讀者的需求是偶爾試用,官方平台 platform.kimi.ai 上選 kimi-k3.1-pro 就能用,而且同時提供 OpenAI 相容與 Anthropic 相容兩種 API 端點,既有程式碼大多改個網址與模型名就能接上。10 月上線時每百萬輸入 2 美元、輸出 10 美元的定價是門檻低得多的起點,這個價格是上線當時的記錄,實際採購前以平台現價為準。
之後值得回查的三個訊號:vLLM 食譜若更新更低階硬體的配置,入場門檻就會下降;Hugging Face 儲存庫若出現修訂版變動,固定版本的團隊需要重新對齊;Moonshot 若發布微調或蒸餾版本,自架成本結構會是另一篇故事。短期內想動手的團隊,建議先把儲存庫網址、修訂版識別碼與授權條款三樣東西存進自己的部署文件,再開始排下載頻寬。