TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Hidden Word 是開源的 Unicode 文字浮水印工具,實測把授權記號藏進 24 字中文,輸出與原文一模一樣、解碼完整還原。本文整理它的變體選擇器原理、容量計算、平台清洗風險,以及官方網站已無法解析後的自架使用方式與清除鈕邊界。
用 AI 摘要這篇文章:
文章被內容農場整篇搬走,是很多寫作者遇過的事。搬走的人通常會刪掉作者名,換上自己的,你搜尋自己寫過的標題,前幾筆是別人的網址。有一種反制思路是反過來利用「複製」這個動作:在文字裡預先藏一個看不見的記號,對方搬得越完整,記號跟得越牢,事後把文字丟回工具解開,手上就有了這段字從哪裡流出去的線索。寫到這裡,真正想用的人通常會問三件事:藏得住嗎?抄走之後驗得出來嗎?對方拆得掉嗎?我把 Hidden Word 的原始碼抓下來在本機跑了一輪,三個答案都能用實測結果回答。
答案是:藏得住,輸出與原句肉眼分不出來;抄走後驗得出來,我一個字一個字比對過;但拆,也拆得毫不費力,這套工具自己就內建了一個清除鈕,按下去浮水印就不存在了。還有一件使用前必須知道的事:GitHub 專案頁上指向的官方網站,我查詢時已經查不到任何 DNS 記錄,等於不存在,所以現在要用它,得自己把原始碼跑起來。一句話定位:它給你的是事後驗得出的舉證線索,而非事前防得住的保護。
把這個定位放進實際情境會更具體。你授權兩個網站轉載同一篇文章,各自藏入不同序號;一個月後文章出現在某個內容農場,你把農場版解碼,解出其中一個序號,流出點當場確認,接下來無論是撤稿談判還是存證,手上都有東西。反過來說,若你期待的是「裝了之後別人就不能抄」,它幫不上忙,複製貼上在任何環節都沒有被擋住。
我在 macOS 上 clone 主分支、安裝依賴、建置成功,用無頭瀏覽器把編碼與解碼介面實際操作了一遍,另外把它的編碼、解碼、清除三個核心函式單獨抓出來跑了七項測試,全部通過。
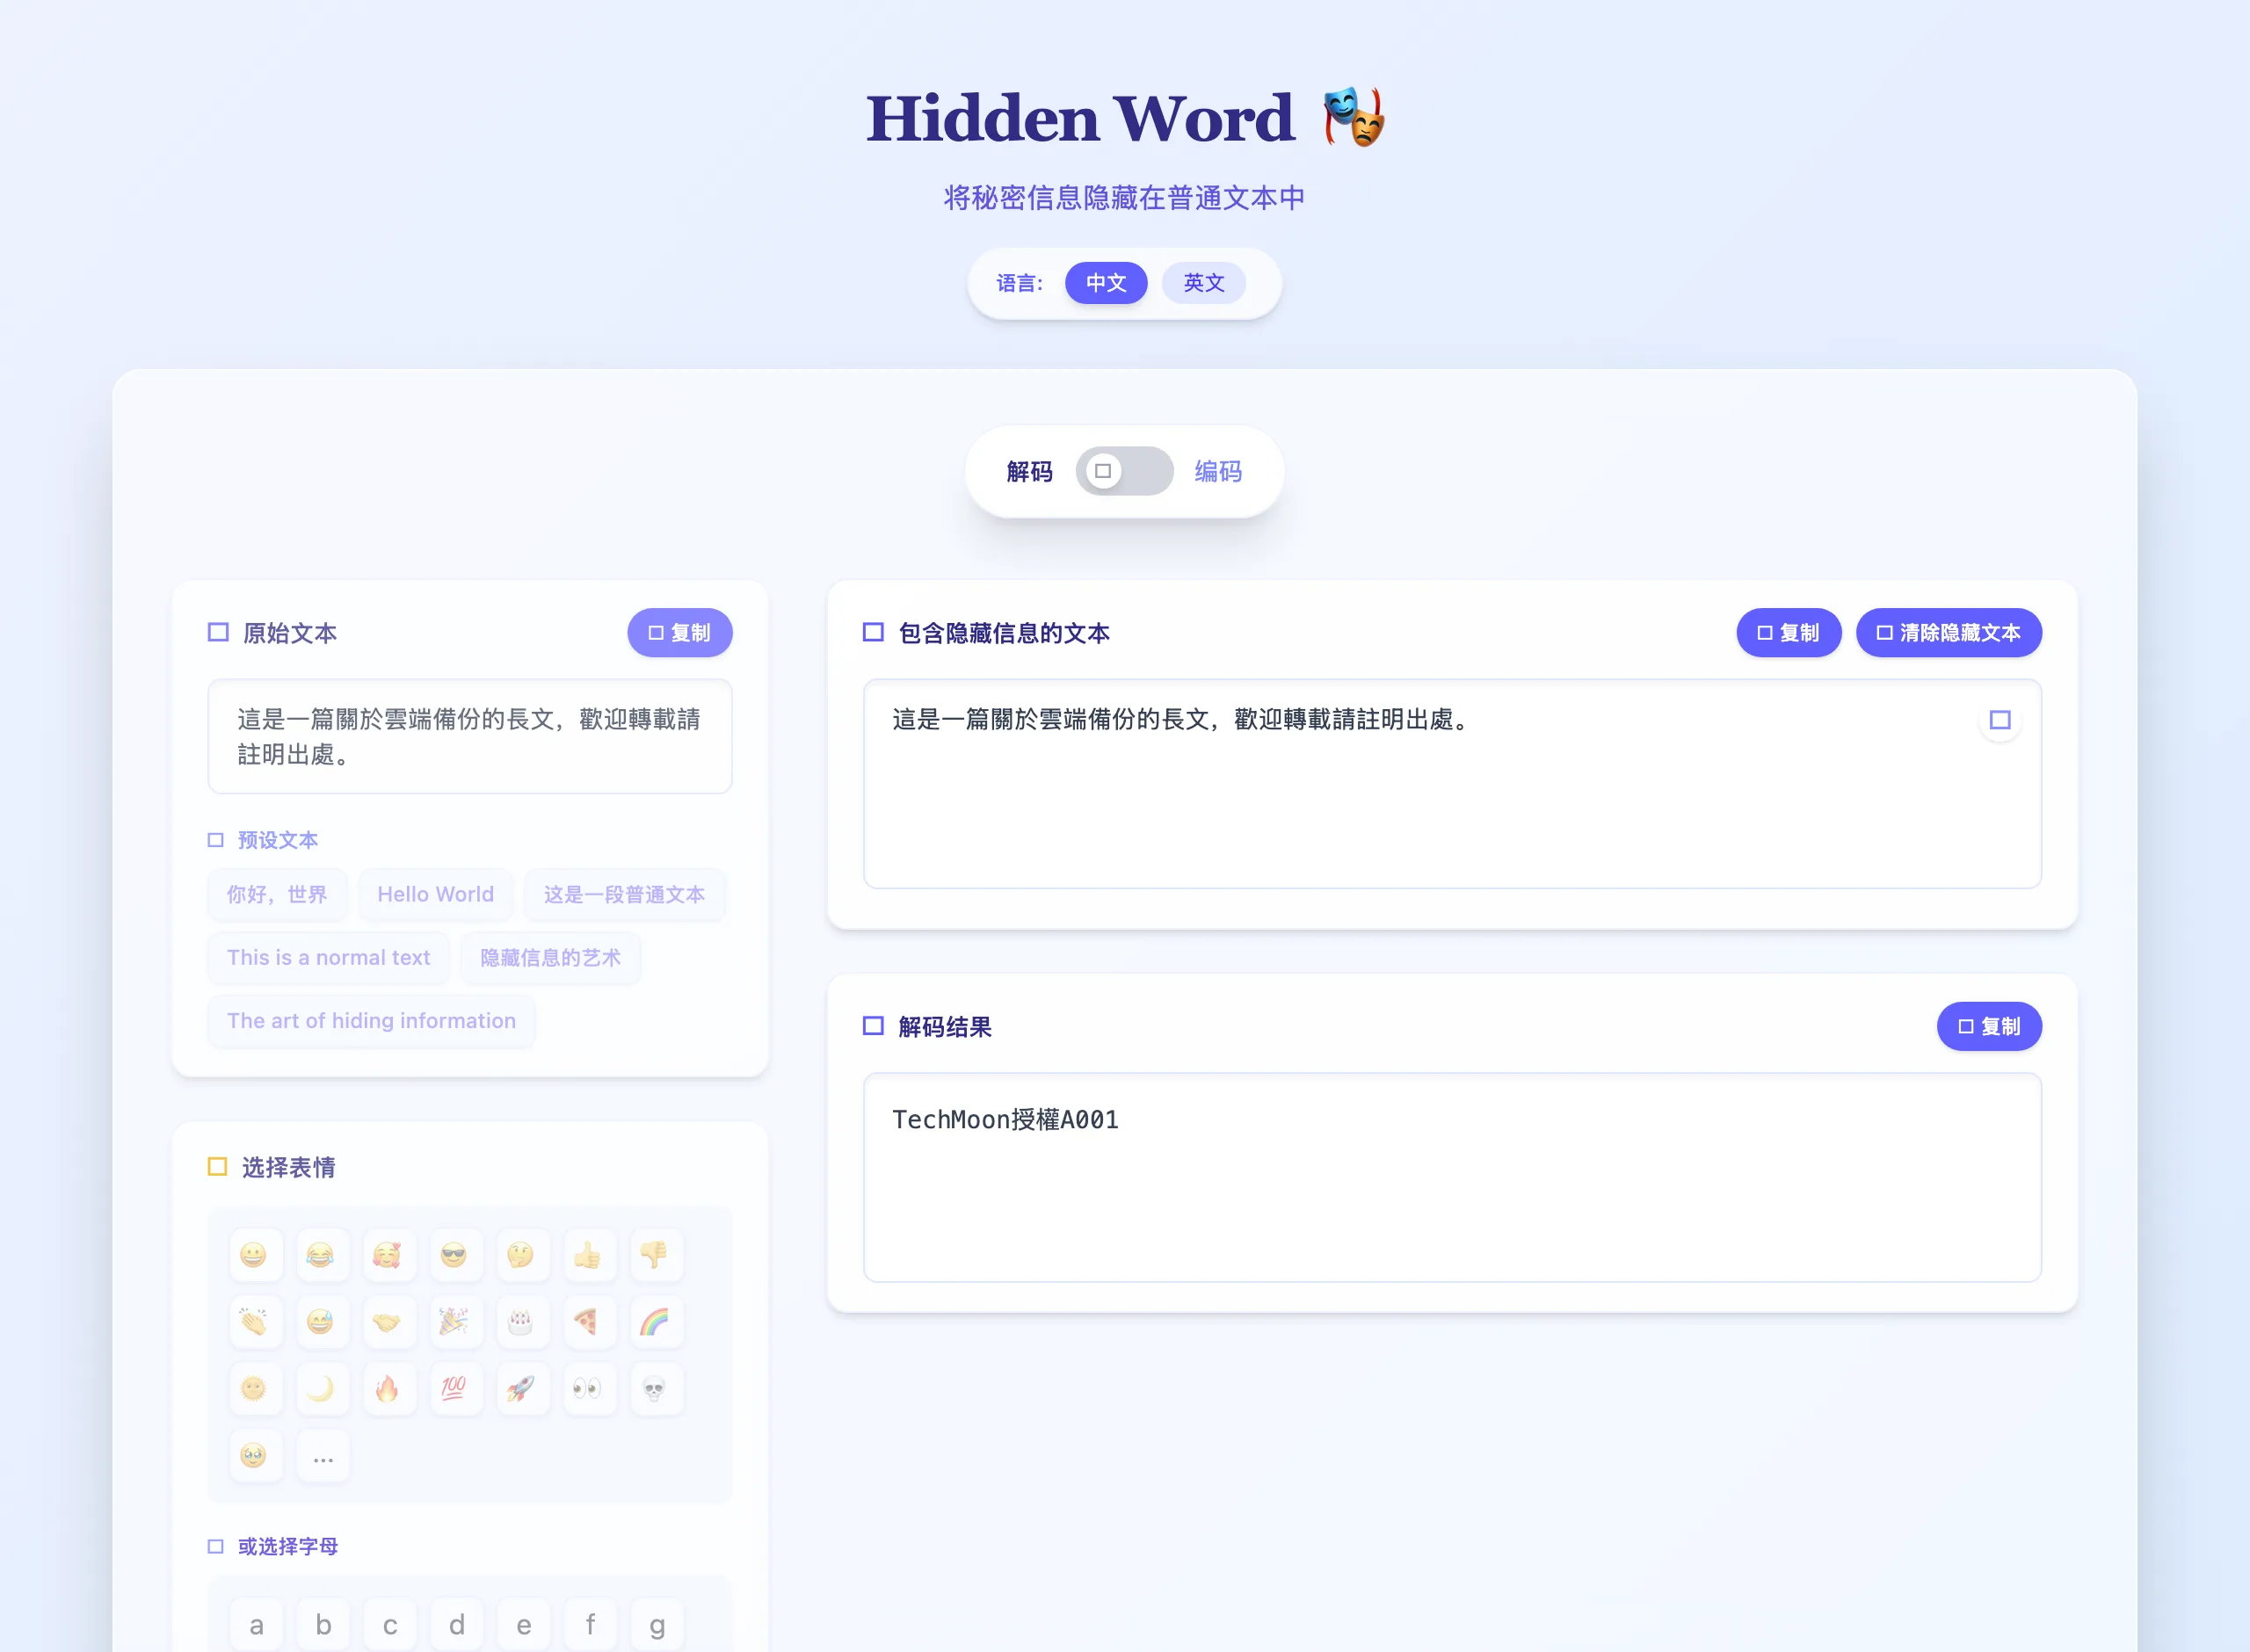
實測用的載體是「這是一篇關於雲端備份的長文,歡迎轉載請註明出處。」,共 24 個字。要藏的記號是「TechMoon授權A001」。在編碼畫面把兩段文字分別填進左右兩個輸入區,結果即時出現:輸出與原句長得一模一樣,肉眼找不到任何差異,但字元數從 24 個變成 42 個,多出來的 18 個字元就是記號本體。「TechMoon授權A001」以 UTF-8 編碼恰好是 18 個位元組,工具把每個位元組換成一個看不見的字元,一個位元組對一個,數字對得乾乾淨淨。輸出區的呈現方式也很直白:看不出任何異狀的一段文字,旁邊一顆複製鈕,抄走全文的人拿到的就是這串 42 字元的字串。
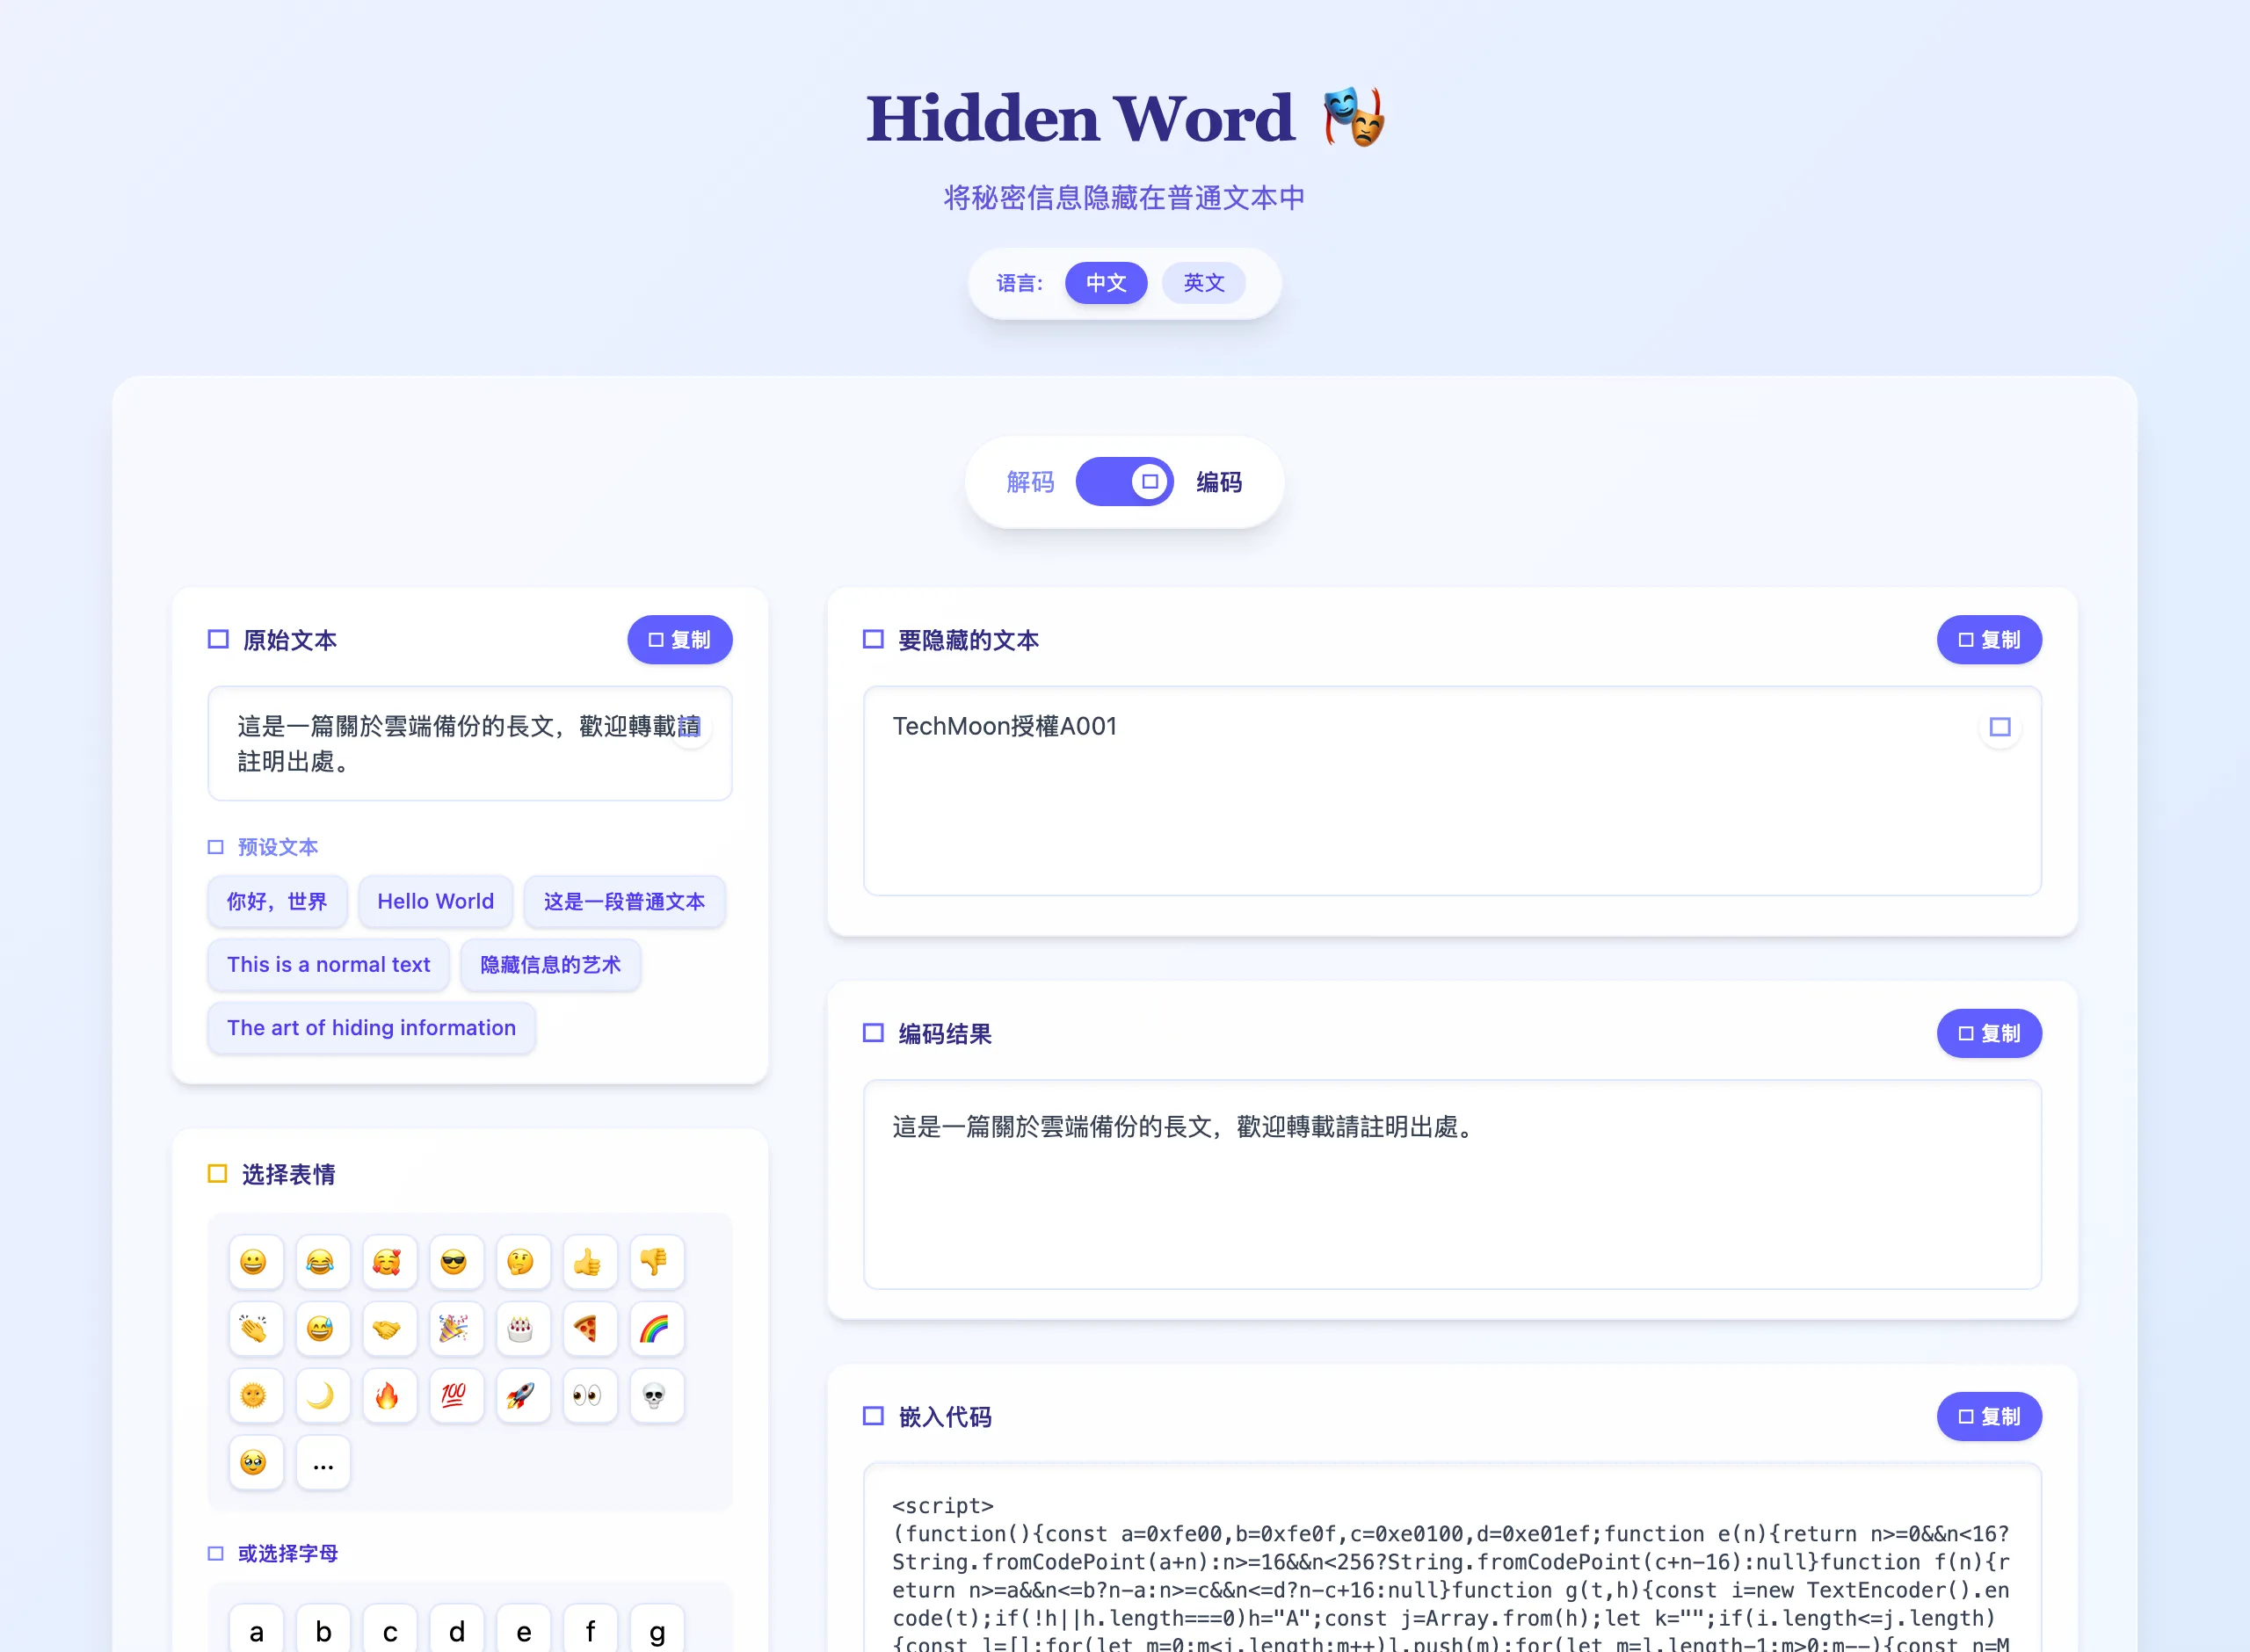
操作上沒有多餘步驟。畫面中央一個開關切換編碼與解碼模式,左欄放載體,右欄放要藏的文字,輸入內容一改,結果立刻跟著重算,沒有按下產生的動作;要藏的字或載體清空時,結果區就跟著清空。這種即時運算的設計側面印證了它純瀏覽器運算的本質,所有計算都在你眼前發生。
把輸出複製、切到解碼模式、貼回去,畫面立刻解出完整的「TechMoon授權A001」,一個字不差。我另外用命令列直接跑它的編碼函式做同樣的來回,結果一致;甚至反過來只給一個字的載體、塞 25 個位元組的長記號,照樣完整還原。全流程都在瀏覽器裡完成:這個專案是純前端程式碼,沒有後端,編碼只用了瀏覽器內建的文字編碼 API,你貼進去的東西不會被送到任何伺服器。這一點對拿它處理未發布草稿的人有實際意義,投稿前先在自己留底的版本藏記號,文字不會因為經過這個工具而外流。
介面左側還有一排表情符號按鈕,這個設計有它的道理:emoji 與各種 Unicode 符號一樣是 Unicode 字元,都能當載體。把藏好記號的表情符號貼進任何支援 Unicode 的輸入框,等於用一個 emoji 就把記號帶進了對方的系統,比一整段文字更低調。對追蹤來源這個用途來說,越小隱形的載體,被察覺的機會越小。
多出來的 18 個字元是什麼?我把樣本逐字元攤開檢查,碼位全部落在 U+E0100 到 U+E01EF 這個區間,也就是 Unicode 標準裡的變體選擇器補充區。這種碼位本來的用途是字形顯示的附加指示,例如同一個愛心符號後面接上不同的變體選擇器,系統會挑選不同的樣式來呈現,它本身不佔顯示寬度,排版引擎會直接忽略它。這就是肉眼看不見的原因:並非被什麼演算法藏起來,而是文字系統天生不渲染這種碼位。
對照原始碼,映射方式很工整。要藏的字串先轉成 UTF-8 位元組,位元組值 0 到 15 換成 U+FE00 到 U+FE0F 的 16 個碼位,16 到 255 換成 U+E0100 到 U+E01EF 的 240 個碼位,16 加 240 恰好 256 個,把一個位元組的每種可能都對到一個專屬碼位。以我的樣本為例:記號的第一個字母 T,ASCII 碼是 84,映射後落在 U+E0144,正是樣本裡第一個出現的記號字元。接著這串碼位被隨機打散,分散插在載體文字的字與字之間;位元組數超過載體字數時,多出來的全疊在最後一個字後面。解碼就是反向掃描:由左到右收集所有落在這兩個區間的碼位,還原成位元組,再組回字串,所以藏在亂數位置裡的記號,順序仍然完整。
容量同樣由這個設計決定。分散模式下每個載體字元攜帶一個位元組,一篇兩千字的文章能把兩千個位元組均勻攤進內文,再多的會疊到文末,沒有硬性上限;中文字在 UTF-8 佔三個位元組,換算約六百多個中文字,純英數的授權序號更省。實務上要藏的只是「授權對象、日期、流水號」這個量級,一般文章的空間綽綽有餘,反過來要藏整段聯絡資訊也塞得進去。
跨平台的能力也來自同一個機制。變體選擇器是 Unicode 標準的一部分,收文字的人不需要安裝任何軟體,只要他們的系統照標準處理字串,記號就會原樣存在;這也是這類工具敢宣稱在任何支援 Unicode 的環境都能用的底層原因。代價是兩面刃:標準讓記號四處能活,也讓任何照標準寫出的清理程式四處能拆。
記號能不能撐過「被抄」這件事,取決於複製的方式。整段選取、複製、貼上,字串裡的所有字元會原封不動跟著走,記號也在其中,這是機制保證的行為,也是我把 42 字元樣本複製、貼回解碼框完整驗過的部分。滑鼠從頭拖到尾的選取範圍涵蓋看不見的字元,複製到的就是帶記號的完整字串,抄家拿去做任何全文搬移,記號都會一路同行。真正會讓記號消失的環節是平台清洗:有些系統在儲存或顯示貼文時,會主動過濾不可見字元,記號就死在那一關。我沒有逐一實測每個社群平台,這一條屬於機制推論,所以實際做法很簡單,發布之後自己從目標平台複製回來解一次,解得出一樣的記號,再信任那個管道。
它的正確用法是追蹤。給每一位獲得授權的轉載者藏不同的流水號,A001 一份、A002 一份,自己留一張對照表;將來哪個版本出現在沒授權的地方,解開就知道是哪一份流出去的。這對談授權、收稿費的寫作者是實際有用的能力,舉證時拿得出具體線索,而不是只憑語感指控。另一個變化是分渠道發布:同一篇文章投往三個平台前,各藏一個渠道代號,事後哪個渠道的版本被搬走,解開就有答案,這比逐字比對文章差異省力得多。
設計序號時有一個小提醒:藏在文字裡的內容,任何拿到這套工具的人都解得開,所以序號裡不要放姓名、信箱這類個人資料,放代碼就好,對照表留在自己手裡,兼顧追蹤效果與隱私。
它的上限也要先講清楚。對方若不複製貼上,而是整篇重新打字,任何藏在文字裡的記號都會消失,這屬於文字這個載體的共同限制,沒有任何工具能救。圖片走的是另一條路,後面會對照。
實測到這裡最反直覺的部分來了:這套工具的介面上,就有一個一鍵清除隱藏內容的按鈕。把任何文字貼進去按一下,所有變體選擇器被刪得一乾二淨,我拿清除後的文字再解碼,得到空字串。換句話說,抄你文章的人只要也跑這套工具,或用任何會清掉不可見字元的工具過一遍,浮水印就沒了。開發者等於把「這種記號擋不住懂的人」直接做成了功能,這是很誠實的設計,但把它當保護牆的人會錯意。
文案上倒有一處該校正的話術。嵌入程式碼的預設訊息寫著 Hidden Word 已把內容加密,介面說明也說它會自動為網站上所有文字加密;但翻遍編碼的原始碼,裡面沒有任何加密,只有碼位替換,任何人用同一套工具就能解開,而可以被解開正是它的用途。所以別拿它藏真正的秘密,它藏的是給驗證者看的標記,保不了密。同一組操作在瀏覽器與命令列環境都能重現,門檻低到談不上門檻。
這套機制反過來也提醒了一件事:你從別處轉貼來的長文,同樣可能被這樣藏過東西。介面上的清除鈕這時就派上用場,轉發前清一次,把看不見的內容濾掉再送出。工具本身是中性的,方向由拿著它的人決定。
原始碼裡還有一個給網站主用的功能:產生一段嵌入腳本,放進網頁後會自動走訪頁面上所有文字節點,略過程式碼與樣式區塊,把指定的訊息藏進頁面上的文字裡,等於全站自動上浮水印。訊息內容可以自訂,站方一句話就能讓全站文章同時帶記號。這個功能我讀了實作但沒有部署到真實網站驗證,效果以原始碼行為為準,網站主想用的話,建議先在測試頁確認輸出。
GitHub 專案頁上指向的官方網站 hidden-word.top,我查詢時用三個不同的 DNS 解析服務都查不到記錄,GitHub Pages 上也沒有鏡像。想用的人有兩條路:本機跑,指令如下,或者建置成靜態檔案丟到任何靜態託管空間。
git clone https://github.com/Ackites/hidden-word.git
cd hidden-word
npm install
npm run dev
我實測安裝與建置各一次成功,這類純前端小工具沒有環境地雷;建置會產生一包靜態檔案,可以放到任何靜態託管空間。README 另附一鍵部署到 EdgeOne Pages 的按鈕,不想碰命令列的人可以走那條路。
專案的體質要設對期待。GitHub 上有 766 顆星、53 次 fork,MIT 授權,但全部開發史只有 6 次提交:2025 年 3 月中開案,主要程式碼兩天內寫完,7 月初只改了 README 的部署說明,之後就靜止了。三個公開議題加一個 PR 從 2025 年 5 月放到現在,沒有得到任何回覆。這是一個能用、但別等官方修的專案;好消息是核心演算法兩百行不到,MIT 授權隨你改,自己接手維護的負擔很小。細節上還能看到早期碼的痕跡:編碼函式裡留了一行除錯輸出,每次藏字都會在瀏覽器開發者工具的主控台印出中間結果,功能不受影響,但看得出這是個人週末專案的成熟度。
介面有中文選項,不過是簡體字,而且會跟著系統語言自動切換,繁中系統開起來看到的是簡中介面。附帶一提介面也內建幾段預設載體文字與全英文介面可選,用起來不至於卡住,知道就好。
文字藏記號這條路,先天就比圖片脆弱。圖片有盲浮水印這種做法,把資訊寫進影像的頻域裡,縮圖、截圖、加濾鏡之後通常還驗得出來;照片類的內容也有把拍攝參數嵌進圖檔的工具,例如 Copicseal 對 EXIF 的處理,思路相同,都是留下可驗證的線索而非上鎖。移除與反移除的攻防在圖片那邊早已是整個市場,HitPaw Watermark Remover 這類工具的免費額度與付費牆就是縮影;文字這邊,敵不過清除,更敵不過重打字,能依靠的只有「對方懶」這個現實:內容農場以複製貼上為商業模式,逐篇重打太貴,這正是文字浮水印仍然值得藏的原因,它賭的是抄家的成本結構,而非技術強度。
幾個限制集中在這裡說清楚。我只在 Chromium 一種瀏覽器環境測過介面與演算法,其他瀏覽器的行為沒有驗證;平台是否清洗不可見字元,我沒有逐一實測,發布後自行複製回測是唯一可靠的做法;至於解出來的記號在著作權爭議裡能扮演什麼角色,工具只負責還原字串,法律效果視個案而定,這條邊界我不越權代答。大原則可以提:著作權在作品完成當下就存在,浮水印的角色不是創造權利,而是讓「這份字是誰的、何時流出去的」多一條可驗證的痕跡,真要主張權利時,它與發布紀錄、原始稿檔搭配著用,比單獨存在更有說服力。
所以誰該自架一份?三種情境對得上就值得。常態授權轉載的人,給每份授權藏序號,爭議發生時有線索可拿;同文多渠道發布的人,渠道代號能直接回答「農場版是從哪個平台流出的」;在公開作品裡放作者記號的人,一句短語、一個代碼,都能在不干擾閱讀的前提下常駐在每一段文字裡。它值三分鐘的安裝成本,成功標準也很明確:藏好記號、發布、從發布處複製回來解一次,解出一模一樣的字串就是成功;解不出來,表示那個管道會清洗字元,記號改藏在自己留底的版本裡就好,至少內部對照表仍然成立。期待它是防複製機制的人會失望,那個需求往授權條款、侵權通知與搜尋引擎下架申請走,或者,把要保護的內容做成圖片,走浮水印那條路。