TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

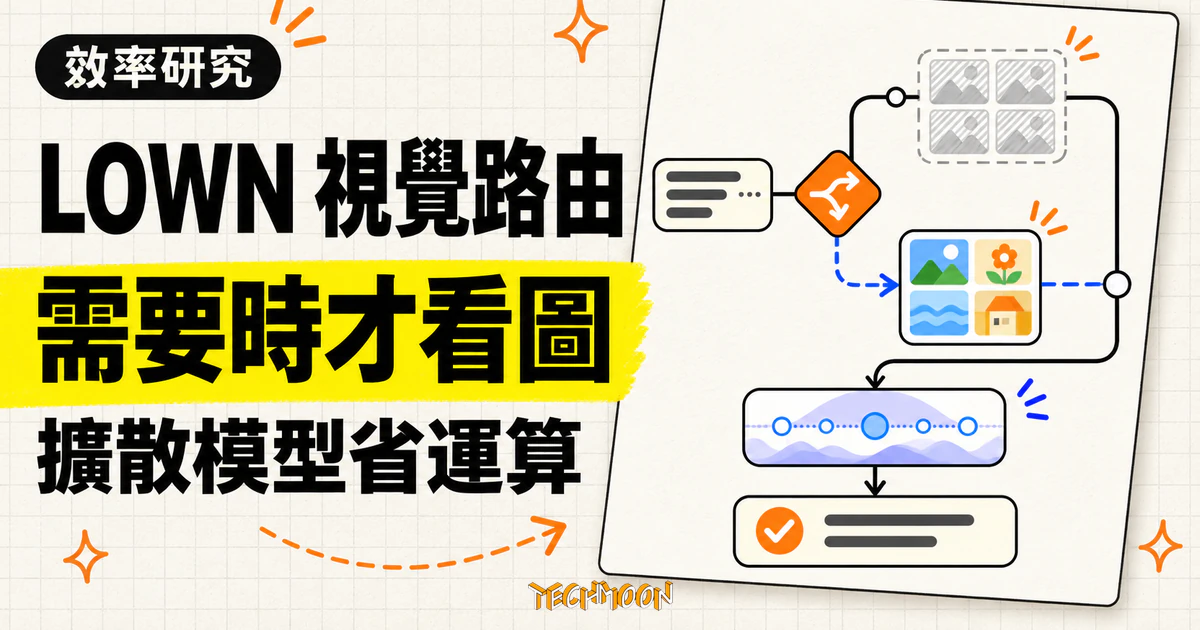
KAIST 研究團隊的 LOWN 讓擴散式視覺語言模型在生成時自己判斷這一步要不要看圖:純文字預測與上次看圖結果一致就沿用,出現分歧才重讀。十項基準平均保留 LLaDA-V 99.6% 分數、解碼運算量降到 35.3%,實際生成時間平均少 57.4%;certificate 在演算法裡的意義、各基準差異與快取疊加的品質代價,是解讀這三組數字前要先對齊的量尺。
用 AI 摘要這篇文章:
要讓視覺語言模型回答圖片問題時省一點運算,過去幾年的主流努力都朝同一個方向:刪。視覺 token 剪枝把每次要看圖時傳入的圖片資訊刪掉一部分,換取每一次計算變便宜,十月介紹過的TTR-Compressor 視覺 token 壓縮就屬於這一族。韓國 KAIST 研究團隊 10 月 27 日放上 arXiv 的 LOWN 研究換了一個問題:與其每次看少一點,能不能少看幾次?答案是用平均 35.3% 的解碼運算量,保留基準模型 99.6% 的分數,而且這兩條路不互斥,可以疊加。
這份論文全名「Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs」,四位作者都掛 KAIST,通訊作者 Eunho Yang 同時隸屬首爾醫療 AI 公司 AITRICS,全文 24 頁直接公開,專案頁還附了一分鐘解說影片與逐字稿。它在 Hugging Face 每日論文榜拿下 2026 年 10 月 30 日當日第一,累積 118 張向上投票,比第二名多 16 張。要注意的是,它處理的模型種類很特定:以擴散式語言模型為骨幹的視覺模型,論文稱為 DVLM,量測主角是 LLaDA-V。如果你在用的是 GPT-4V、Qwen-VL 這類逐字生成的模型,這份研究的方法不能直接搬,後面會說明原因。
一般聊天模型回答問題,是一個字接著一個字生成,已經算過的部分可以快取起來。擴散式模型的解碼方式更像填空卷:答案一開始是一整排空格,模型每一輪同時預測多個空格該填什麼,再逐步把確定的位置定案。這一代擴散式語言模型已經能把成績追到同等規模的自回歸模型,並從純文字延伸到圖片與影片理解,代價是解碼方式天生吃運算。填空式解碼靠雙向注意力,每個位置都要看得到其他所有位置,所以自回歸模型那種「算過就存起來」的 KV 快取在這裡用不上,標準做法是每一輪都把完整輸入重算一次。
完整輸入裡最大的一塊正是圖片。論文量測十項基準,視覺 token 占 LLaDA-V 輸入的 89% 到 97%。換句話說,模型每一輪重算的東西,幾乎都是同一張從頭到尾沒變的圖,就算眼前這一步只是在補一句通順的開場白,也照樣把整張圖重讀一遍。每項基準要生成的答案長度與步數也不同,例如 MathVista 生成 100 個 token 分 50 輪、DocVQA 32 個 token 分 16 輪,答案愈長、輪數愈多,同一張圖被重讀的次數就愈多,成本跟著放大。
研究團隊先做了一個很便宜但關鍵的量測:沿著模型的標準生成軌跡,每一步同時跑「有圖」與「沒圖」兩種計算,記下兩邊對每個空格的第一順位預測與信心,再比較拿掉圖片會不會改變這一步要定案的文字。軌跡本身完全由含圖計算決定,純文字那邊只記錄、不干涉,所以量出來的就是「圖片實際發揮作用的頻率」。結果在十項基準裡,被定案的位置有 83.4% 拿到相同的預測,移除圖片只改變 22.8% 步驟的定案 token,最低的基準(MMBench)只占 7.9%。更關鍵的是這個比例隨任務差異很大:MMBench、ScienceQA、MME、GQA 都在一成上下,圖表、文件與開放式描述類一路走高,ChartQA 24.5%、CapArena 32.7%、DeCapBench 33.4%、LLaVA-Bench 37.8%、DocVQA 43.8%。大多數步驟根本不需要圖,而且需要的比例因任務而異,這就是 LOWN 用「當場判斷」取代固定規則的原因。這個量測本身也值得記住:想知道自己的視覺模型有沒有同樣的浪費,沿軌跡做有圖沒圖的對照就能算出來,不需要任何訓練。
定位上,它補的是既有加速方法沒問的問題。視覺 token 剪枝讓每次看圖便宜一點,KV 快取類方法重用算過的中間狀態,還有一族方法設法少跑幾輪解碼;這些方法都讓「看圖」這個動作更便宜,沒有一個問「眼前這一步到底需不需要看圖」。LOWN 問的正是這一句,論文把它跟其中兩族(剪枝與快取)疊加示範,後面會看到疊加的帳。
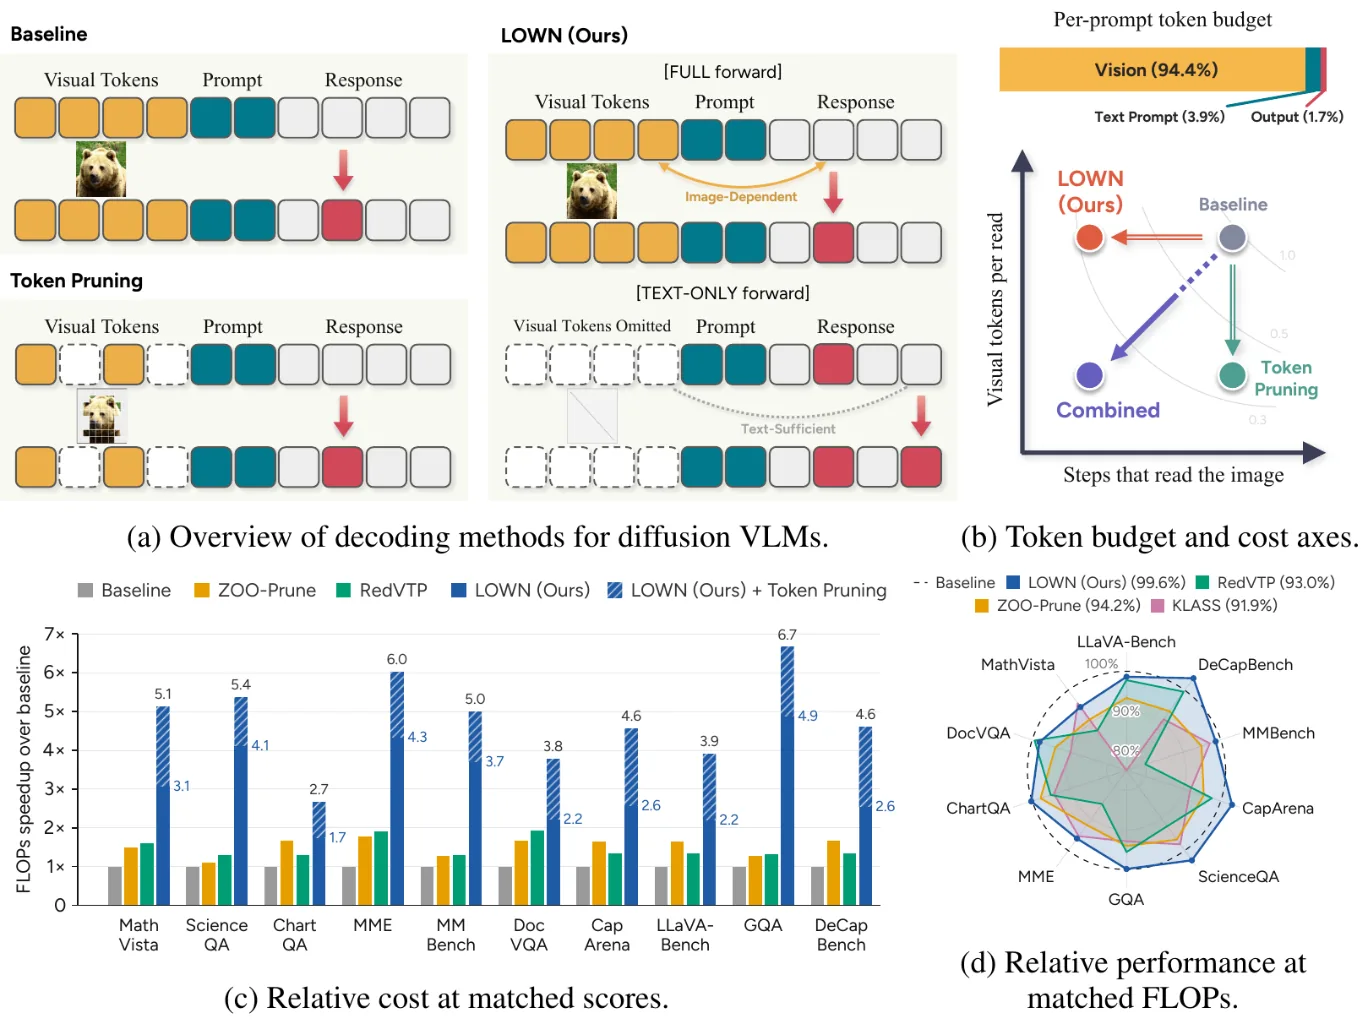
LOWN 的判斷規則可以用填空卷來理解。原始模型每一輪看著圖,從最有把握的空格裡固定挑出幾個定案;LOWN 改成先把那次「看著圖做出的預測」記下來當參考點,論文稱為錨點(anchor)。接下來每一步先做一次便宜許多的純文字預測,把結果跟錨點對照:如果一致,代表上次看圖的判斷還撐得住,直接沿用;一旦一致的前綴短於這一步原本該定案的名額,就重做一次含圖的完整計算,並用新結果替換錨點。純文字計算之所以便宜,是因為拿掉圖片後,輸入長度縮短約 9 到 33 倍,而且兩種計算共用同一套位置編號,不會因為少了圖就讓文字的位置關係跑掉。
沿用多少也由同一個對照決定。純文字預測會沿著信心高到低的順序跟錨點比對,最長的一致前綴有多少個位置,這一步就揭開多少個 token,第一個分歧出現在哪裡,接受長度就停在那裡。官方解說影片把這一刻演得很具體:模型先照一致的字一路寫下去,直到下一個該定案的字「brown」與猜測不合,才回頭看圖重算。所以每一輪揭開幾個空格不是寫死的數字,而是由當下的輸入與狀態決定,看圖的時機與揭開的數量用同一條規則一起解決。
兩個設計選擇讓這套規則好部署。它不需要重新訓練模型,也沒有要調的門檻參數,一條規則用到底;對照組 KLASS 得到類似加速時,每項基準都要回報各自的門檻值。它也不是固定「每幾步看一次圖」的排程。論文在 MathVista、LLaVA-Bench、DeCapBench 三項上比較了固定週期與隨機排程:每兩步看一次圖,分數勉強接近但運算量比 LOWN 高 14% 到 66%;拉長到每八步看一次,運算量雖然壓得更低,分數卻從 56.00、57.40、34.43 掉到 48.50、41.30、19.09;隨機排程同樣預算下也各掉約三到四分。需要圖的時機隨任務與輸入變動,只能讓模型當場自己判斷。
官方一分鐘解說影片用一張北極熊照片把效果演了一遍:原本 48 次看圖縮到 12 次,生成時間從接近十秒壓到三秒內。README 裡也攤出同一段的兩句輸出,LOWN 生成的描述與基準模型用詞不同(黑鼻子、深色眼睛,對照厚毛、突出鼻子),兩句都算合理描述。這個細節值得記下:它省的是運算,輸出本來就不會跟基準模型逐字相同。
論文把「純文字預測與錨點一致」稱為 certificate,中文直譯是證書。這個詞容易讓人讀成「這些字被證明是對的」,但它在演算法裡的意義只是「找到一個可以沿用先前預測的判斷訊號」,跟答案對錯沒有關係,也跟任何外部事實查核無關。
論文自己把這條誠實線畫得很清楚。拿新的完整看圖計算回頭檢查,對照一步之前留下的錨點,會推翻其中 4.1% 到 11.0% 的定案 token;在 LOWN 自己的生成過程裡,純文字步驟沿用的位置事後被推翻的比率是 2.2% 到 4.7%,隨任務不同。錨點愈舊,被推翻的機率愈高,DocVQA 上錨點放到八步舊時,推翻率升到 25.3%。實務上錨點很少變舊,因為每次完整看圖都會替換它,92% 到 97% 的定案 token 用的都是前一步剛更新的錨點,最舊不超過五步。
所以「一致性」是省運算的判斷依據,不是品質保證。論文的成果是在十項基準平均只掉 0.4% 相對分數的前提下,把這個判斷訊號用到了極致,讀的時候不要把它反推成每個答案都經過驗證,它驗證的從來只是「上次看圖的記憶現在還合不合」。
這份研究有三個常被並列的數字,量測範圍各不相同,放進同一張表會更清楚:
| 數字 | 實際量測的東西 | 量測範圍 |
|---|---|---|
| 99.6% | LOWN 分數相對基準模型的平均保留率 | 十項基準,各項相對分數再平均 |
| 35.3% | LOWN 解碼 FLOPs 相對基準的平均比值 | 解碼器與 LM 頭,不含視覺編碼器 |
| 57.4% | 實測生成時間的平均減少幅度 | 十項基準,H200 單卡 batch size 1 |
先把 99.6% 拆開。它是十項基準各自算出相對分數再平均的結果,其中 ScienceQA、ChartQA、CapArena、DeCapBench 四項的分數還高於基準模型。把高於 100% 的部分截在 100% 再平均,會得到 98.6%,論文主動附上這個更保守的讀法。同時,在同樣運算量下,LOWN 的 99.6% 高於兩種視覺 token 剪枝方法 RedVTP 的 93.0%、ZOO-Prune 的 94.2%,也高於排程方法 KLASS 的 91.9%。
35.3% 只算解碼階段的浮點運算量,包含解碼器、LM 頭和方法需要的矩陣運算,不含每個樣本只跑一次的視覺編碼器(它約占基準解碼成本的 0.16% 到 1.89%,各方法相同),也不含 softmax 這類非矩陣運算。十項基準橫跨的任務型態很廣,從數學推理、科學常識、圖表問答、綜合感知、文件問答、視覺推理,到開放對話與圖片描述,正好可以看「省多少」隨任務怎麼變。分布比平均值得看,把需圖占比、運算量與分數並排放:
| 基準 | 需圖步驟占比 | LOWN 相對運算量 | 分數(LOWN 對基準) |
|---|---|---|---|
| MMBench | 7.9% | 0.270 倍 | 69.93 對 70.88 |
| ScienceQA | 8.2% | 0.243 倍 | 78.83 對 76.50,高於基準 |
| MME | 10.6% | 0.231 倍 | 1655 對 1719 |
| GQA | 10.9% | 0.205 倍 | 53.24 對 53.31 |
| MathVista | 17.9% | 0.325 倍 | 56.00 對 59.10 |
| ChartQA | 24.5% | 0.576 倍 | 78.36 對 78.16,高於基準 |
| CapArena | 32.7% | 0.388 倍 | -85.67 對 -88.67,勝負得分高者佳 |
| DeCapBench | 33.4% | 0.391 倍 | 34.43 對 33.18,高於基準 |
| LLaVA-Bench | 37.8% | 0.454 倍 | 57.40 對 58.20 |
| DocVQA | 43.8% | 0.452 倍 | 82.31 對 83.91 |
大方向是輸入愈依賴圖片細節、省得愈少,但對應不完全:ChartQA 的需圖占比不是最高,運算量卻是十項最高。論文自己的成本式是「LOWN 成本等於完整看圖步驟占比,加上純文字步驟占比乘上該基準的純文字成本比」,按這個式子回推,ChartQA 約有 56% 的步驟仍跑了完整看圖;論文補充,同樣以實際執行的步數計,ChartQA 真正會因拿掉圖而改變結果的步驟占 32.3%,重看頻率仍高出二十多個百分點,其中一部分就是判斷訊號偏保守、寧可重看的成本;各基準的純文字成本比本身也不同,從 2.54% 到 10.07%。主力工作就是把文件餵給視覺模型讀的產品,例如Zerox OCR 這類把 PDF 轉 Markdown 的作法,這份分布正是採用前要先衡量的成本結構。論文附錄把最壞例子攤開:一題要從預算表格裡找「來自消費者的金額是多少」的 DocVQA 問題,LOWN 十五步裡有十四步回頭看圖,運算量仍是基準的 0.90 倍,答案 183,000 雖然答對,等於幾乎沒省到;對照 DocVQA 全基準平均的 0.45 倍,單一輸入的變異可以差到兩倍。
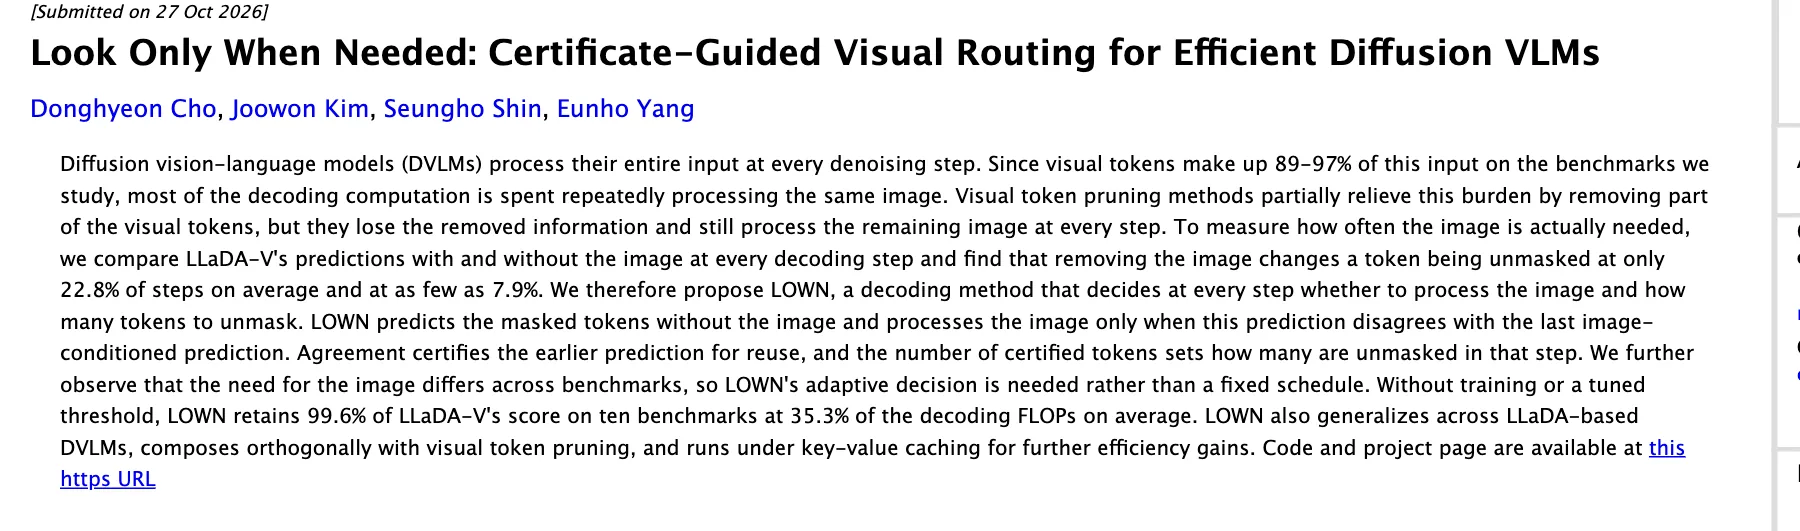
57.4% 是實際秒數。附錄載明量測條件:同一台 H200 伺服器、單 GPU 一次只跑一個實驗、批次大小 1,計時範圍包含生成呼叫內的解碼、多模態準備與視覺編碼,不含模型載入與結果評分;每項基準的平均來自整套評測跑一次的所有樣本秒數,與快取的對照則用 MathVista 一千題、LLaVA-Bench 六十題、DeCapBench 四百題。十項基準平均省 57.4%,最多的一項省 73.2%。這三個數字不能互相換算:運算量剩 35.3%,時間省 57.4%,兩者涵蓋的範圍本來就不同,任何帳單折扣的聯想都是自己的推算。
量測用的推理設定也交代得很白:貪婪解碼、溫度與無分類器引導尺度都設零、低信心位置重新遮回,獨立比較時不開任何快取,圖片只在開頭編碼一次,含圖計算重用的是同一份視覺特徵。也就是說,這些數字量的是同一套固定條件下的相對差異,換成抽樣生成或不同批次大小,幅度不保證一樣。
LOWN 與視覺 token 剪枝是兩條正交的軸線:一條管每次看圖帶多少 token,一條管這一步要不要看圖。論文把兩者疊起來驗證:與剪枝或 KV 快取任一種夥伴搭配,LOWN 再砍掉夥伴 1.8 到 2.5 倍的運算量。這代表已經部署剪枝的管線多了一層可選的加速,彼此取代不了。
跟快取的組合代價更明顯。Fast-dLLM 是一種區塊式近似 KV 快取,論文把它跟 LOWN 疊加,在三項基準上比 Fast-dLLM 單獨使用再省 38.1% 到 50.1% 的生成時間,合計比原始模型快 5.6 到 7.0 倍。以實測秒數走一遍:MathVista 從原始模型的 7.56 秒,換 Fast-dLLM 剩 2.14 秒,再疊 LOWN 剩 1.23 秒;LLaVA-Bench 是 6.99 秒、2.02 秒、1.25 秒;DeCapBench 同樣的三階段是 14.64 秒、4.22 秒、2.10 秒。但三項的分數全部低於 Fast-dLLM 單獨使用,其中 LLaVA-Bench 掉了 5.0 分,而且那 5 分的來源有點微妙:原始模型 58.20 分,Fast-dLLM 單獨反而衝到 63.00 分,疊上 LOWN 回到 58.00,等於把快取多賺的分數還了回去。只引用倍數不提分數變化,就是只講了帳的一半;這個教訓跟Particle-1 省 token 模型一樣,節省幅度最終都要回到自己的任務與帳單重算。
方法本身也不是只對單一模型有效。同一條規則原樣搬到 LaViDa,平均保留 99.7% 分數、運算量降到 17.4%,其中 MMBench 拿 77.18 對基準的 76.95 還略升,GQA 56.54 對 56.69 只差不到半分,兩項運算量都只剩不到十分之一;疊上剪枝後在 99.5 與 99.8 的品質指數下再砍 77.3% 與 72.2% 的運算量。搬到處理影片的 VidLaDA-8B,在 EgoSchema 與 MLVU 兩項基準分別用 25.5% 與 27.2% 的運算量,分數 60.2 對 60.6、43.3 對 41.8,後者還略高於基準。
LOWN 的前提是「模型每一輪重複處理同一張圖」。這個前提只在擴散式解碼器上成立,因為雙向注意力讓它無法使用自回歸模型的 KV 快取,只能每步全量重算。GPT-4V、Qwen-VL 這類逐字生成的自回歸視覺模型本來就有 KV 快取,圖片的視覺 token 算過一次就留在快取裡,不存在 LOWN 要解的重複看圖成本。論文也沒有對自回歸模型做任何實驗,把 35.3% 或 5.6 到 7.0 倍搬到它們身上,沒有證據支持。
還有兩個實務邊界。「訓練免」指的是不用更新模型參數,推理程式仍然要整合純文字與含圖兩種計算路徑、錨點管理與揭開數量的計算,這是工程量,可大可小。節省幅度依輸入而變,無法事先承諾固定折扣,部署前值得先量自己流量的視覺相依度,論文那個「逐步比較有圖沒圖」的量測本身就是可以抄的起手式:拿一批代表性問題,算出每項輸入裡「拿掉圖會改變定案」的步驟占比,像論文那樣畫成分布,如果你的流量多數落在 DocVQA 那一端,這套方法能省的本來就有限。
程式碼公開在 GitHub 的 hyeon9698/LOWN,包含 demo.py、evaluate.sh 與核心的 lown.py,第一次執行會下載公開的 LLaDA-V 與 SigLIP2 權重,跑一張內建圖片並把基準與 LOWN 的輸出和 FLOPs 對照寫進結果檔;要換自己的圖與提示詞,在 evaluate.sh 補影像路徑與描述要求兩個參數就可以。但倉庫目前沒有附授權條款,GitHub 的授權欄位是空的,這表示程式碼可以看、可以試,能不能商用或修改再散布,權利狀態未定,正式導入前要先把這件事問清楚。硬體門檻是 Linux、Python 3.11 與一張 32GB 記憶體以上的 NVIDIA GPU,環境用 PyTorch 加 CUDA 12.6。
對部署擴散式視覺模型的團隊,這份研究給了一個新的設計軸:把「這一步要不要看圖」交給模型自己判斷,而且證據顯示這條軸與刪 token、快取都不衝突。採用的順序論文其實已經示範過一次:先量輸入的視覺相依度,確認省得動,再上路由,最後才考慮疊快取,每疊一層都回頭核對分數。對暫不碰擴散式模型的其他讀者,它至少留下三個可帶走的判斷習慣:看到單一加速數字先問量的是分數、運算量還是秒數;看到平均先問分布,DocVQA 那個 0.90 倍運算量的最壞例子就是分布的尾巴;看到「認證」「保證」這類字眼,回頭找它們在演算法裡的實際定義。論文目前是 v1 版,專案倉庫到 11 月 2 日都還有新的提交紀錄,後續修訂值得回頭追。