TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Ollama 於 10 月 24 日為本機模型執行環境加入語音生成,首發模型是 Gradium 的 Phonon,終端機一行指令就能把文字念成聲音,OpenAI 相容端點同步開放。首波限定 Apple Silicon Mac 與英法德西葡五種語言,中文文字會被以錯誤發音念出,商用授權只跟著 31M 英文模型走,40M 系列全部限非商業用途。
用 AI 摘要這篇文章:
在 Mac 上用 Ollama 跑本機模型的人,遲早會撞到同一個斷點:模型把回答寫好了,想讓它念出來,就得把這段文字再送進另一個語音服務。流程裡每一步都留在自己電腦上,唯獨聲音這一步常常得外送。Ollama 這個把模型裝到個人電腦上執行的工具,在 10 月 24 日的官方公告補上了這一塊:語音模型正式上線,第一個支援的是 Gradium 的 Phonon,終端機一行指令就能讓電腦把文字念出來,OpenAI 相容的語音端點也同時開放。嚴格說,這組模型的權重早在 10 月 19 日就登上了 Hugging Face,能跑的環境遠比 Ollama 多;10 月 24 日真正的事件,是這條本機工具鏈把語音生成收成自己的原生出口。入口統一了,但三條線決定你用不用得上:語言、平台、授權。
文字轉語音(TTS)做的就是把指定文字念出來,和把人說的話轉成文字的語音辨識是相反方向的兩件事。這次更新之前,Ollama 只負責文字的生成與對話,聲音要靠外部服務補;更新之後,同一個執行環境直接多了聲音輸出。官方公告的第一句話就很直白:Ollama can now turn text into speech。
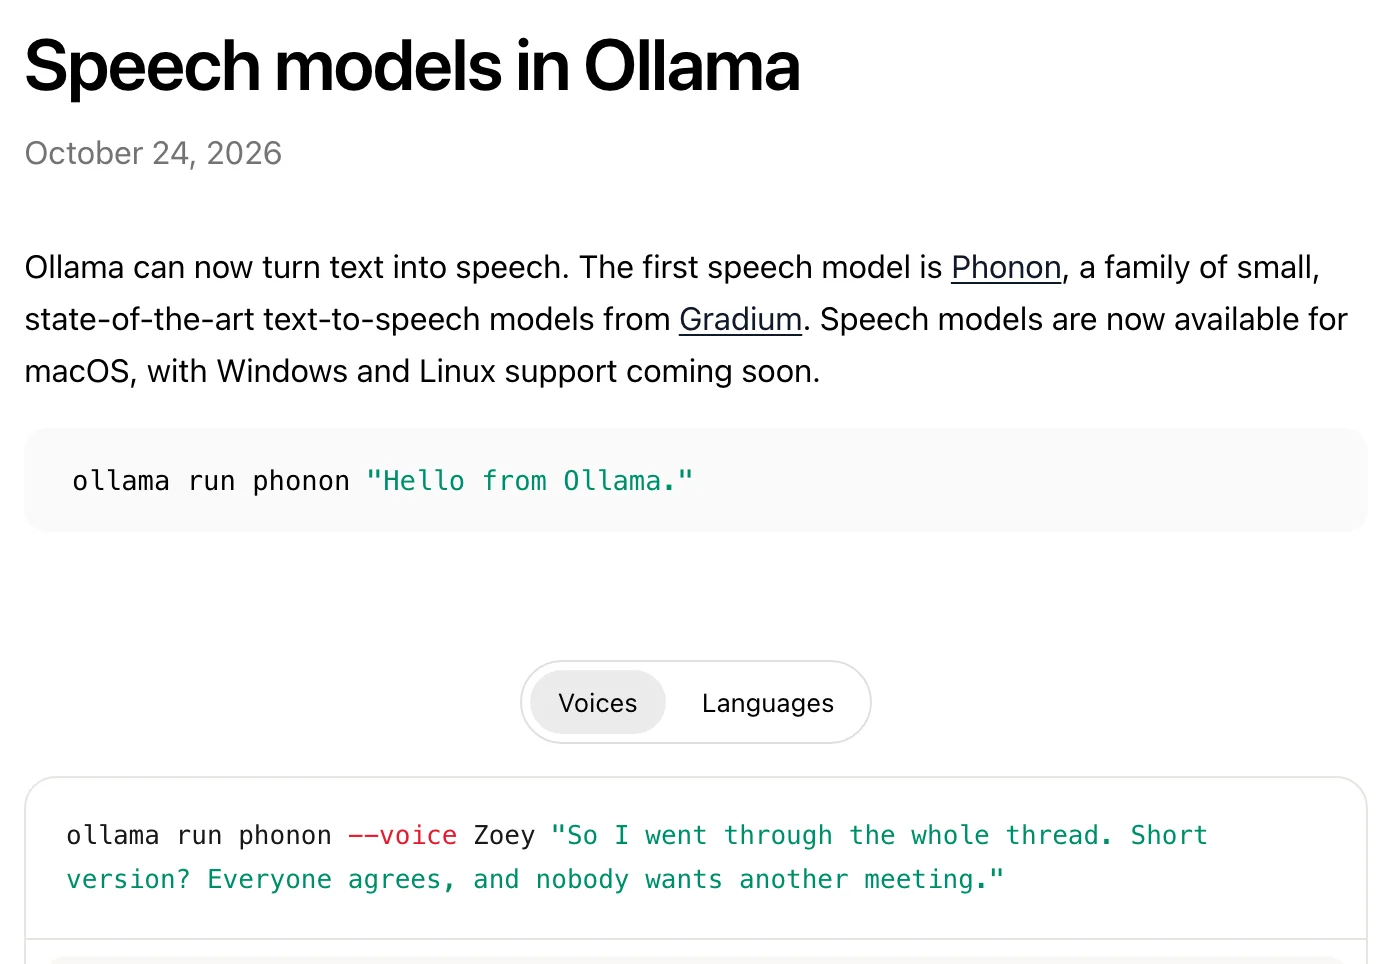
終端機的使用方式刻意做得很少:
ollama pull phonon
ollama run phonon "Hello from Ollama."
pull 那行把模型抓下來,run 那行讓喇叭直接播放。想要留檔,把輸出轉向就是一個 WAV 聲音檔;不帶文字執行,會進入逐行輸入的模式,按下 Enter 念一行。這些都是官方文件的原始範例,不是什麼進階技巧。
比較有意思的是管線。聊天模型的輸出可以直接餵給語音模型,官方給的例子是把 gemma4 的回答管道給 phonon:
ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon文件寫明,管道送來的文字會邊抵達邊念,所以聊天模型的回答會在頭一兩句生成完畢後就開始播放,不必等整段寫完。想在自架聊天介面(例如先前介紹過的 Open WebUI)底下接朗讀,同一套相容端點也派得上用場,聲音與文字都留在自己機器上。
寫程式的人這邊更省事。語音走的是 OpenAI 相容的 /v1/audio/speech 端點,官方的說法是「已經使用 OpenAI SDK 的程式只需要換一個 base URL」。也就是說,本機預設位置換成 http://localhost:11434/v1,原本呼叫雲端語音的程式碼大結構不用動,聲音就改由本機生成。回應也是邊生成邊串流傳出,文件甚至示範了直接把串流接進 ffplay 播放器即時播放。官方在 curl、Python、JavaScript 三種語言的範例裡用的都是同一組基本欄位:模型名稱、文字與聲音,Python 與 JavaScript 範例再多帶一個回應格式,沒有額外的本地端參數。遠端的玩法也寫進了文件,把 OLLAMA_HOST 指向另一台機器再執行同一行指令,聲音會在指令執行的那台電腦上播放;對沒接喇叭的雲端主機來說,這個細節很實際。
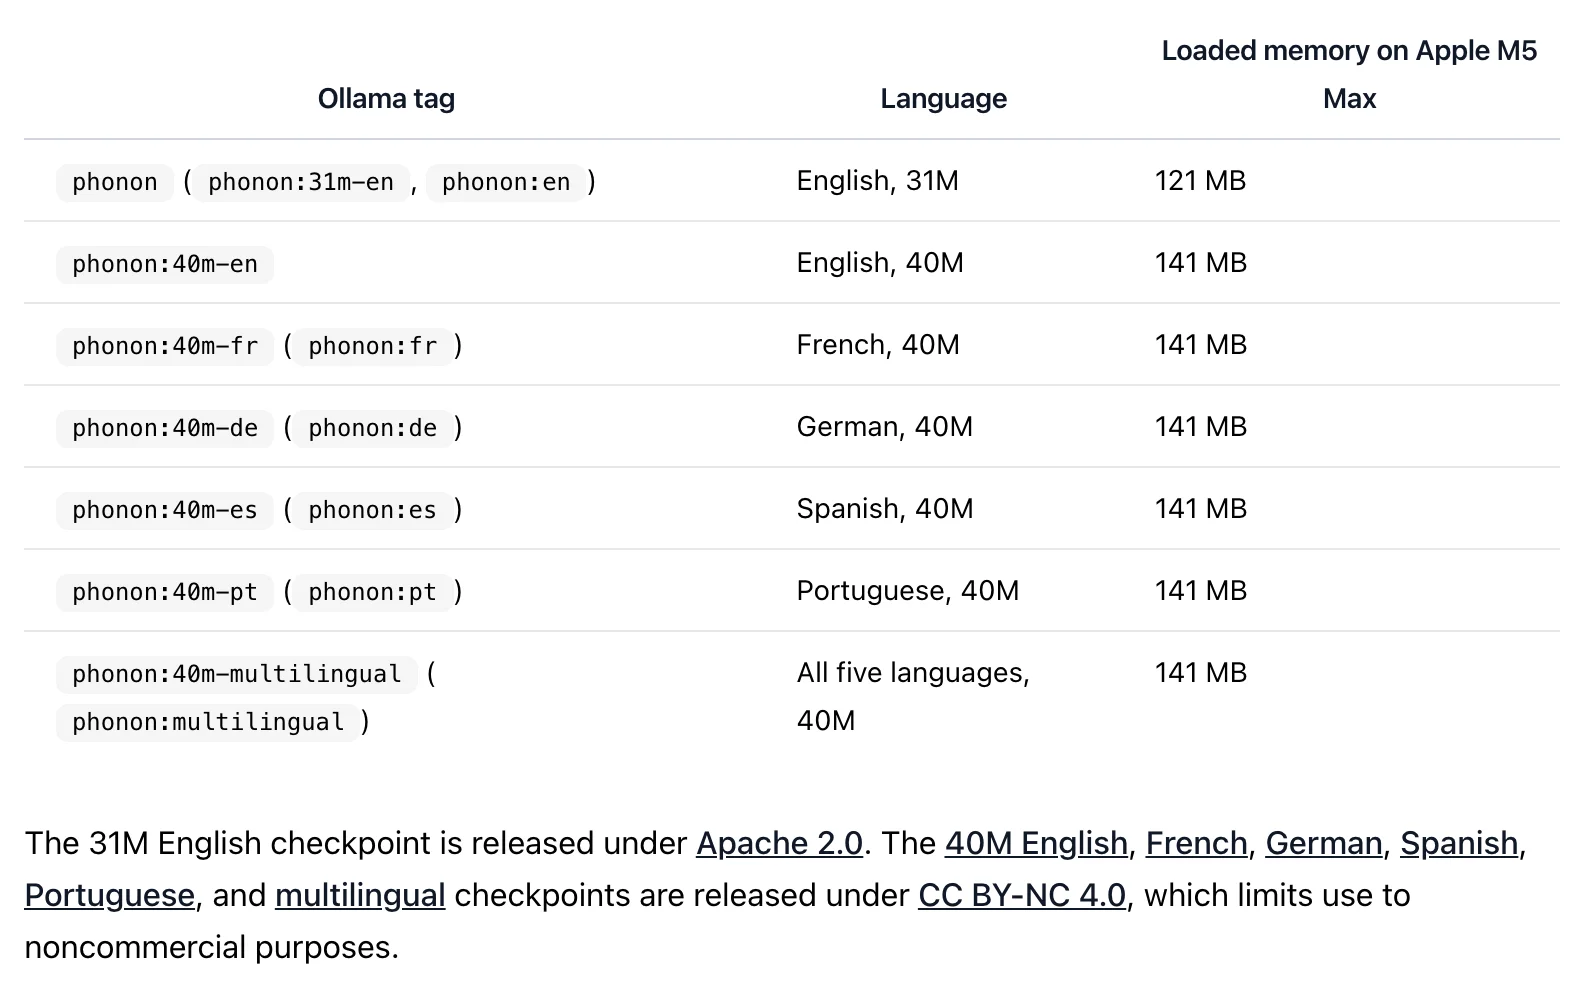
公告列出的語言清單很明確:英文、法文、德文、西班牙文、葡萄牙文五種,外加一個包含全部五種的多語標籤。中文不在任何一個標籤裡,繁體中文也沒有例外。
更需要知道的是中文文字丟進去之後的下場。Gradium 在模型卡的限制段寫得直接:模型只會念清單上的語言,其他語言的文字會以錯誤的發音念出來。換句話說,中文稿送進去不會被擋下來,而是被以錯誤的發音念出來,實務上不可用。多語標籤的「多語」是這五種語言的組合,不是更多語言的意思。
數字與日期怎麼念,同樣跟著語言走。模型卡在限制段寫明,文字在合成前會先做正規化,把數字、金額、日期、信箱等展開成適合念出來的文字,而這一步需要配對正確的語言。對拿它念英文文件、練外語聽力的人,這代表發音規則乾淨不混雜;對中英夾雜的稿子,這套以英文為中心的規則只會讓結果更混亂。
| Ollama 標籤 | 語言 | 參數量 | 授權 |
|---|---|---|---|
| phonon(同 31m-en) | 英文 | 31M | Apache 2.0 |
| phonon:40m-en | 英文 | 40M | CC BY-NC 4.0 |
| phonon:40m-fr | 法文 | 40M | CC BY-NC 4.0 |
| phonon:40m-de | 德文 | 40M | CC BY-NC 4.0 |
| phonon:40m-es | 西班牙文 | 40M | CC BY-NC 4.0 |
| phonon:40m-pt | 葡萄牙文 | 40M | CC BY-NC 4.0 |
| phonon:40m-multilingual | 前述五種 | 40M | CC BY-NC 4.0 |
需要中文旁白的人,現階段仍以雲端服務或支援中文的其他模型為主。雲端路線先前介紹過 Gemini 3.8 Flash TTS 的做法,把配音當成可以逐句下指令的導演工作;本機路線裡做語音輸入(把話轉成字)的工具例如 CapsWriter 也早已成熟,但「本機把中文字念出來」這一格,Phonon 還填不上。
授權是這次更新裡最容易踩坑的一條線,而且它跟著標籤走。上表已經看得出來:預設拉下來的 phonon 是 31M 的英文模型,走 Apache 2.0,可以商用;一旦換成任何 40M 標籤(包含英文的 40m-en),授權就變成 CC BY-NC 4.0,只能用於非商業用途。同一個模型家族、同一行 pull 指令,商業授權的答案完全不同。
Gradium 的自評排行榜還給出一個尷尬的交叉:英語的偏好分數最高的是 40M 英文版(2117 分,對 31M 版的 2098),但念含數字、日期、代碼的難句時,念錯率反而是 31M 版較低(1.5% 對 2.3%)。兩個版本各贏一項,差距都不大,很難說一般聽感分得出來;但產品要上線的人沒有選擇空間,因為品質分數較高的那一個恰恰禁止商業使用,取捨直接從品味問題變成授權問題。
模型卡把分工寫得很細:這個 repo 的權重、tokenizer 與聲音都是 Apache 2.0;Gradium 自家的執行環境是另外的專案,走 MIT 或 Apache-2.0 雙授權。Ollama 側的模型頁則提醒,這些包裝要求 Apple Silicon(Apple 自家晶片)與 0.40.9 以上版本。數字口徑要分清楚:從 Ollama 下載的檔案約 104 到 148MB,裝進 Apple M5 Max 後佔用記憶體 121MB(31M)或 141MB(40M),而 Hugging Face 上的 8 位元量化權重檔是 64.5MB 與 74.6MB,三種數字量的是不同的東西。
聲音的來源也有講究。Gradium 在 Hugging Face 經營一個約一百個聲音的型錄 repo,同樣走 Apache 2.0;即時聲音複製與聲音設計這類功能,官方放在 Gradium 自家的 studio 產品裡。至於 Ollama 這邊實際能用到的聲音有幾個,官方兩個頁面的說法對不上,下一節一起攤開。聲音名稱的填法倒是寬鬆,文件明說大小寫隨意、有無重音符號都認得,示範裡的 Hadley、Zoey 都來自 Gradium 的型錄。
要動手升級的人,先看這節。同一個功能,三個官方頁面給了三個不同的最低版本:OpenAI 相容文件在 /v1/audio/speech 條目註明「Added in Ollama v0.40.8」;語音文件的操作段落寫「Start Ollama v0.40.9 or later」;公告本身則要求「Download Ollama 0.40.11 or later」,示範音檔也是在 0.40.11 上錄的。三份文件都出自官方,數字就是不一致。實務上直接升到 0.40.11 以上,三個說法就都滿足了。
聲音清單也有一組矛盾。Ollama 模型頁的說明寫,預設的 31M 英文模型「只包含一個名為 default 的聲音」;語音文件卻寫,它附帶 Zoey、Easton、Freya 等 Gradium 英文聲音,省略 voice 參數時才用 checkpoint 自己的預設聲音。哪一個才是現況,文件層面分不出來,官方給的裁決方式是在自己機器上跑 ollama show phonon,列出實際安裝的聲音清單。
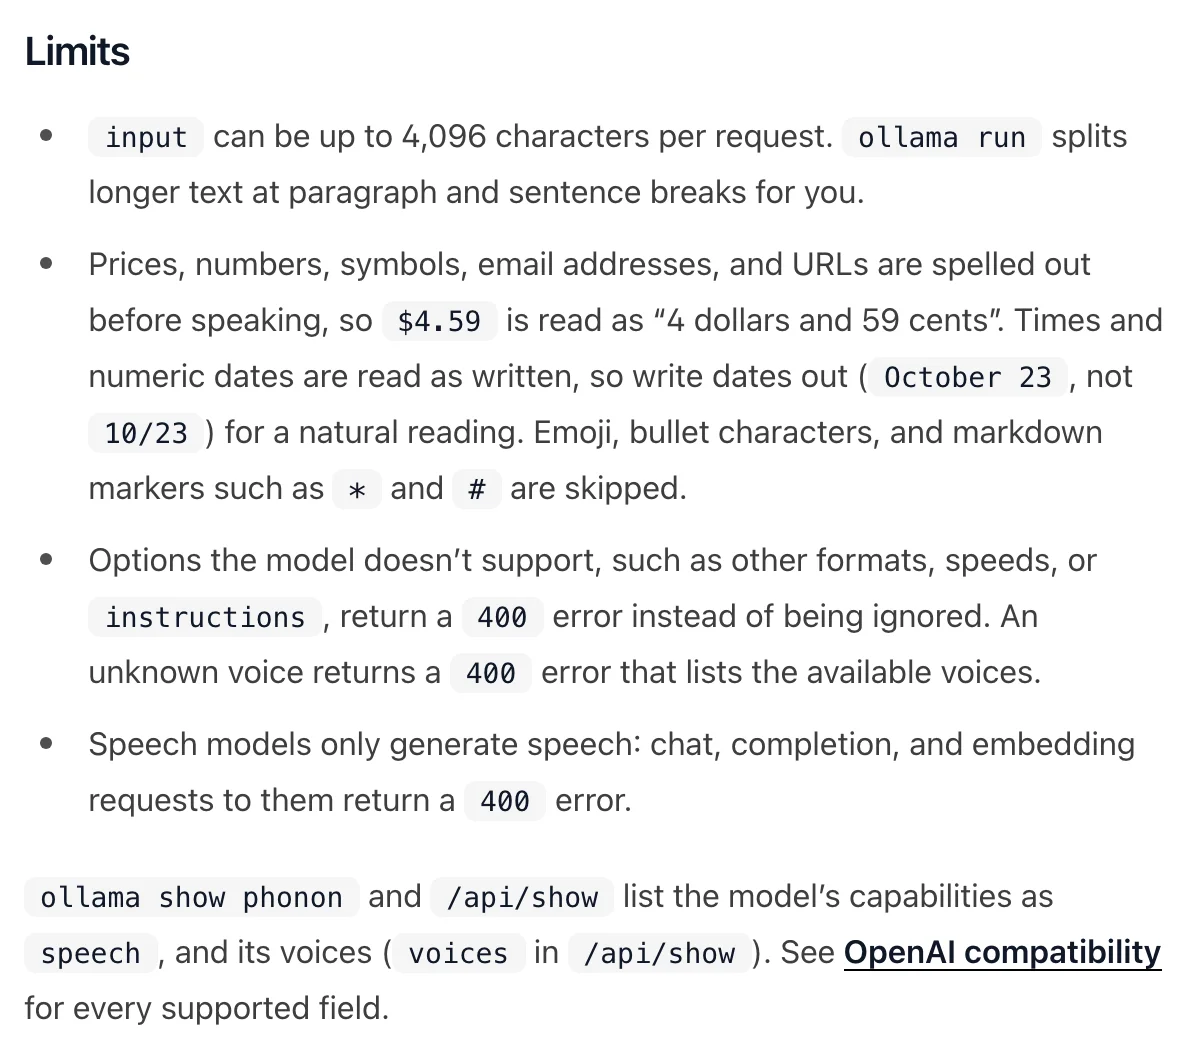
還有一個更實際的陷阱:模型頁上方自動產生的快速開始範例,是對 phonon 送出 /api/chat 的聊天請求。而語音文件的白紙黑字寫著,語音模型只生成語音,對它送聊天、文字補全或嵌入請求都會收到 400 錯誤。照著模型頁範例抄的人會直接撞牆,正確的入口是 ollama run 與 /v1/audio/speech。
輸出格式只有兩種:預設的 WAV,以及沒有檔頭的原始 PCM,都是 16 位元、24 kHz 的單聲道。檔案層面還藏著一個工程細節:串流回應在總長度確定前就得寫出檔頭,所以 WAV 檔頭裡的長度欄位填的是最大值,事後要切割音檔或計算時長的程式不能直接相信那個數字,得用實際檔案大小回推。
錯誤行為本身倒是設計得清楚。單次請求的 input 上限是 4,096 字元,超過要自己分段,只有終端機會自動在段落與句子邊界切長文。mp3、opus、aac、flac 這些回應格式與 instructions 指令欄位都不支援,speed 只接受 1,送了不支援的格式或值會得到 400 錯誤而不是被默默忽略;填了不存在的聲音名稱,錯誤訊息會列出可用聲音。數字與日期的念法也有明確規則:金額會被展開成文字,日期照寫法念,要自然的念法就得把日期寫成完整文字。連 Markdown 符號怎麼處理,兩個頁面都各有說法,一個寫星號井號會被跳過,另一個提醒標題符號可能被念出來,實際行為建議用自己的稿子試一次。
公告裡最顯眼的數字是速度:在配備 M5 Max 的 MacBook Pro 上,Ollama 比「次快的引擎」,也就是 Gradium 自家的執行環境,快 35%。量測條件公開得很完整:生成 45 秒語音、取 10 次中位數、Ollama 在 Apple Silicon 上由 MLX 框架加速、以 bf16 精度跑模型,而對手在 CPU 用 8 位元權重、神經引擎用 fp16、GPU 用 f32。條件透明是好事,但量的人是 Ollama 自己,對比對象是模型原作者的另一個執行環境,這個 35% 讀作「官方宣稱」比讀作結論安全。
辨識品質的部分,公告稱與 Hugging Face Transformers 參考實作的錯誤率(念錯字的比例)持平,量法是把 200 句英語測試集交給模型朗讀,再用 Whisper large-v3 把聲音轉成文字比對。Gradium 模型卡上另有整套自評排行榜,聲稱每個語言的三項指標都由 Phonon 拿下第一,其中英語的偏好分數來自 468 位評分者的 8,290 次投票,對手包含 Kokoro、NeuTTS 等開源模型。同樣的提醒:排行榜是模型作者自己辦的。
相對客觀的訊號是採用情況。到 10 月 31 日,gradium/phonon-31m-en 在 Hugging Face 的一個月下載量已超過 8.3 萬,家族裡其他成員落在約 5,800 到 13,800 之間,差距約六到十四倍;唯一走 Apache 2.0 的英文預設版拿走了約三分之二的家族下載。模型本身也確實朝輕量做:31M 指的是生成聲音用的主網路,不含負責把中間表示解回聲音的 Mimi 編解碼器(這套架構建立於 Kyutai 的 Mimi 與 Pocket TTS 之上),生成時以 80 毫秒為一幀逐步預測。模型卡給的定位是小到能在瀏覽器分頁、手機或筆電 CPU 上跑,這也解釋了為什麼它有瀏覽器、iPhone、Android、Home Assistant 等一長串部署途徑,Ollama 只是其中最新的入口。
Apple Silicon Mac 的使用者是這次明確的受惠者。升級到 0.40.11 以上、拉下 phonon、用一句英文確認聲音輸出、把輸出轉向存成 WAV,這四步就能驗證整條鏈路;要接程式,把 OpenAI SDK 的 base URL 指向本機即可。記得別照模型頁的聊天範例抄,語音模型的正確入口只有兩個。
Intel Mac、Windows 與 Linux 使用者目前都在範圍外,公告只說 Windows 與 Linux 支援「之後提供」,沒有日期。文件裡雖然已經寫了各平台的播放器(macOS 用 afplay、Windows 用 PowerShell),但那是播放指令的說明,不代表語音模型已經能在那些平台跑,看文件的時候別把兩件事混在一起。
需要中文聲音的人,這條路現在就走不通,餵中文只會得到錯誤發音,與其等後續版本,另找支援中文的模型反而更實際。商業用途的人選擇最窄:能商用的只有 31M 英文標籤,要法文或德文的商業配音,這個家族幫不上。幾件事值得回頭再查:Windows 與 Linux 的開放時程、三份文件的版本號何時收斂、預設模型實際附帶的聲音清單,以及中文有沒有排進任何時程。Ollama 的 0.40 版本線還在快速迭代,等下一個功能版本或 Windows 支援落地,這些適用範圍就需要重新核對一次。