TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

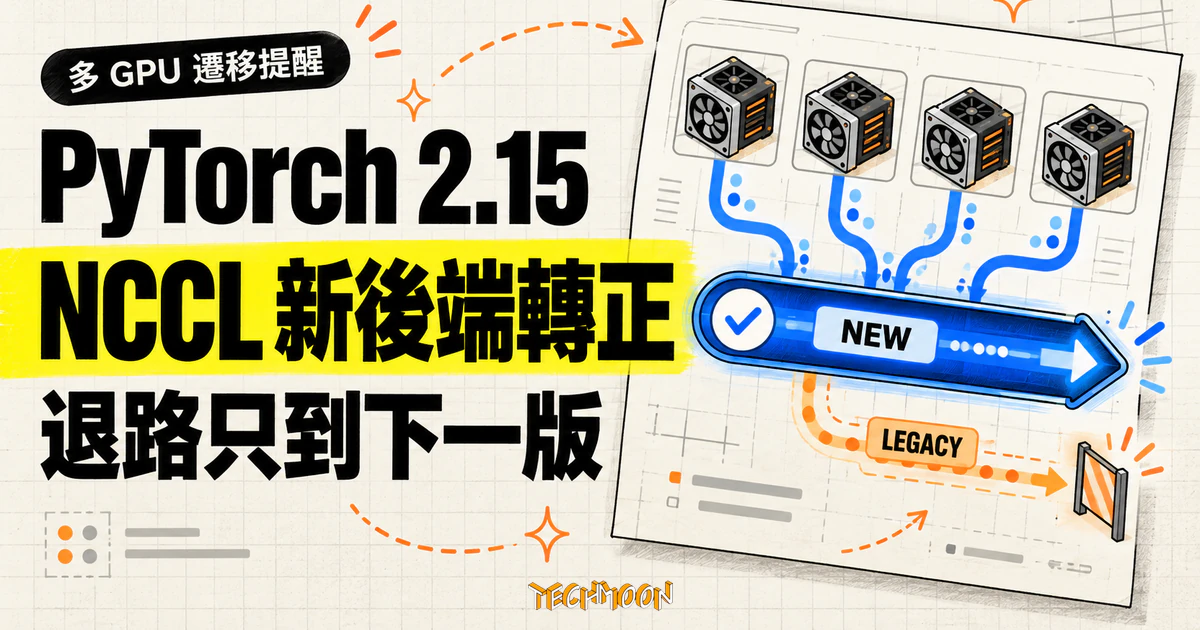
PyTorch 2.15 於 10 月 28 日把改寫版 NCCL 後端設為預設,官方明文退回舊後端的環境變數與 nccl-legacy 只保留到下一版,分散式 checkpoint 也改成 2.14 讀不回 2.15 存的檔案。多 GPU 專案升級前,先確認新後端的行為差異、FSDP2 的預設變更,以及 Mac 上實測可用的 FP8 與 Stream API。
用 AI 摘要這篇文章:
PyTorch 2.15 在 10 月 28 日發布。GitHub 上的 v2.15.0 標籤落在當天 17:09 UTC,換算台北時間是 10 月 29 日凌晨 1 時 09 分,官方部落格隨後跟上(台北時間凌晨 1 時 44 分),整個版本由 3,117 個提交、583 位貢獻者組成。這一版最值得停下來看的東西,官方自己就放在 release notes 的 backwards incompatible 區塊:backend="nccl" 建立的通訊後端換了實作,多 GPU 訓練就算一行程式碼都不改,跑起來的環境也已經不同。我的判斷:有用多張 NVIDIA GPU 的團隊,該把這次升級當成一次有期限的遷移來規劃,而非例行更新。所謂有期限,是官方留的退路只到下一版,分散式檔案又改成只能新讀舊,兩件事都讓「先升上再說、有問題再退」這句話從這版開始變得不可靠。Mac 開發者拿到的是確定的新能力,我在本機裝了 2.15.0 實際驗過;單卡或純 CPU 的使用者,這波幾乎不受影響。
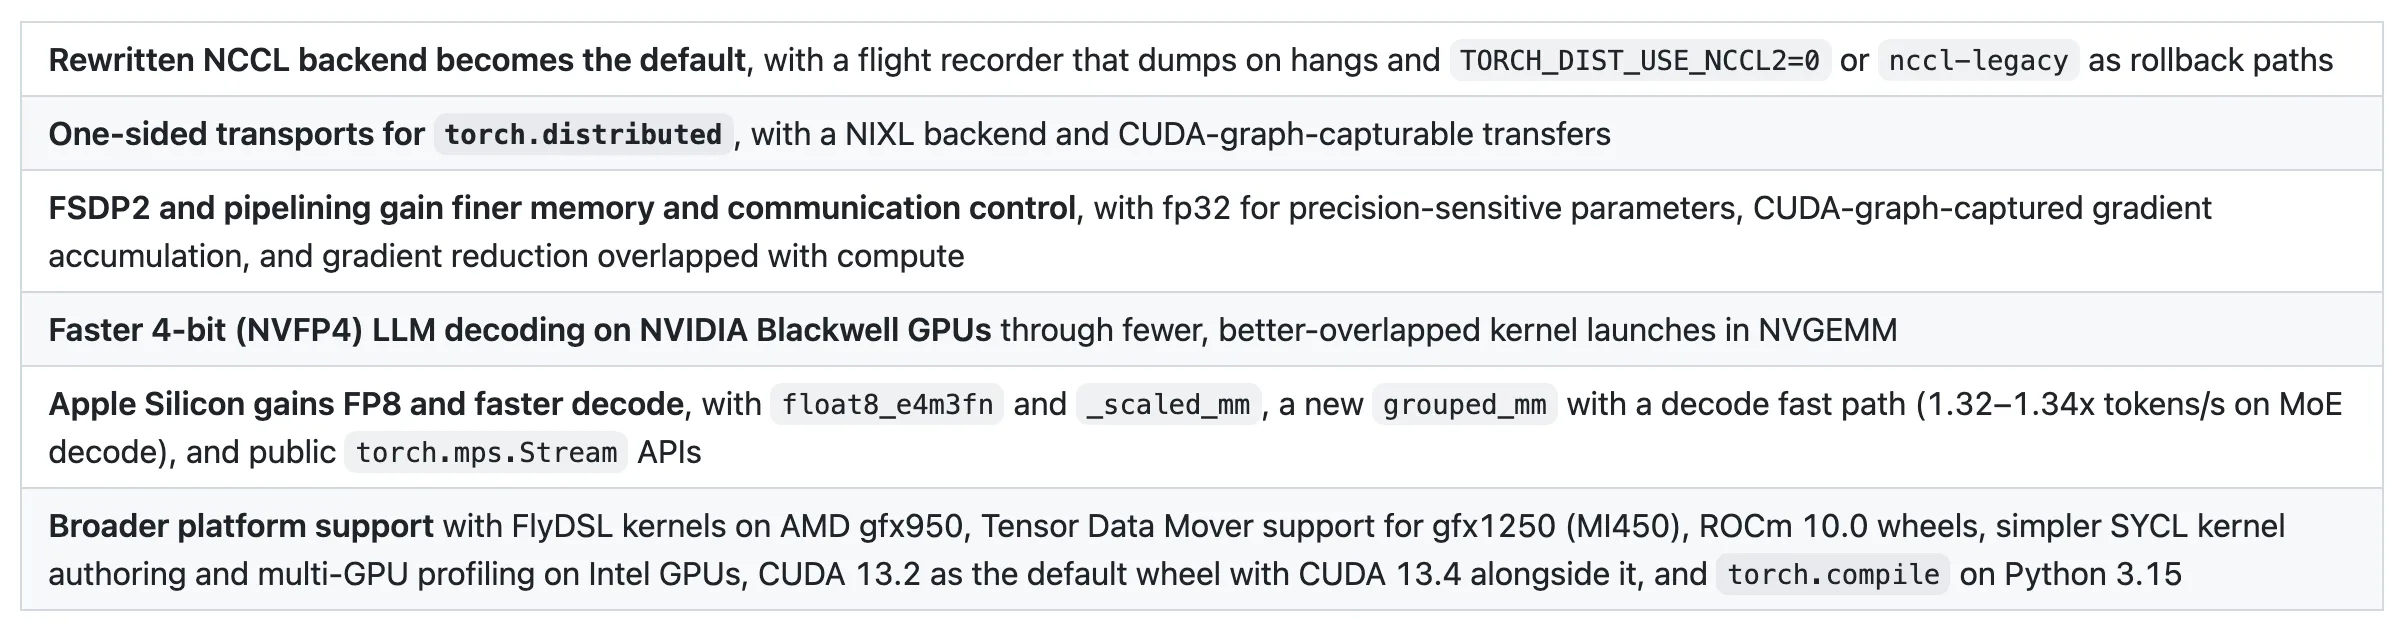
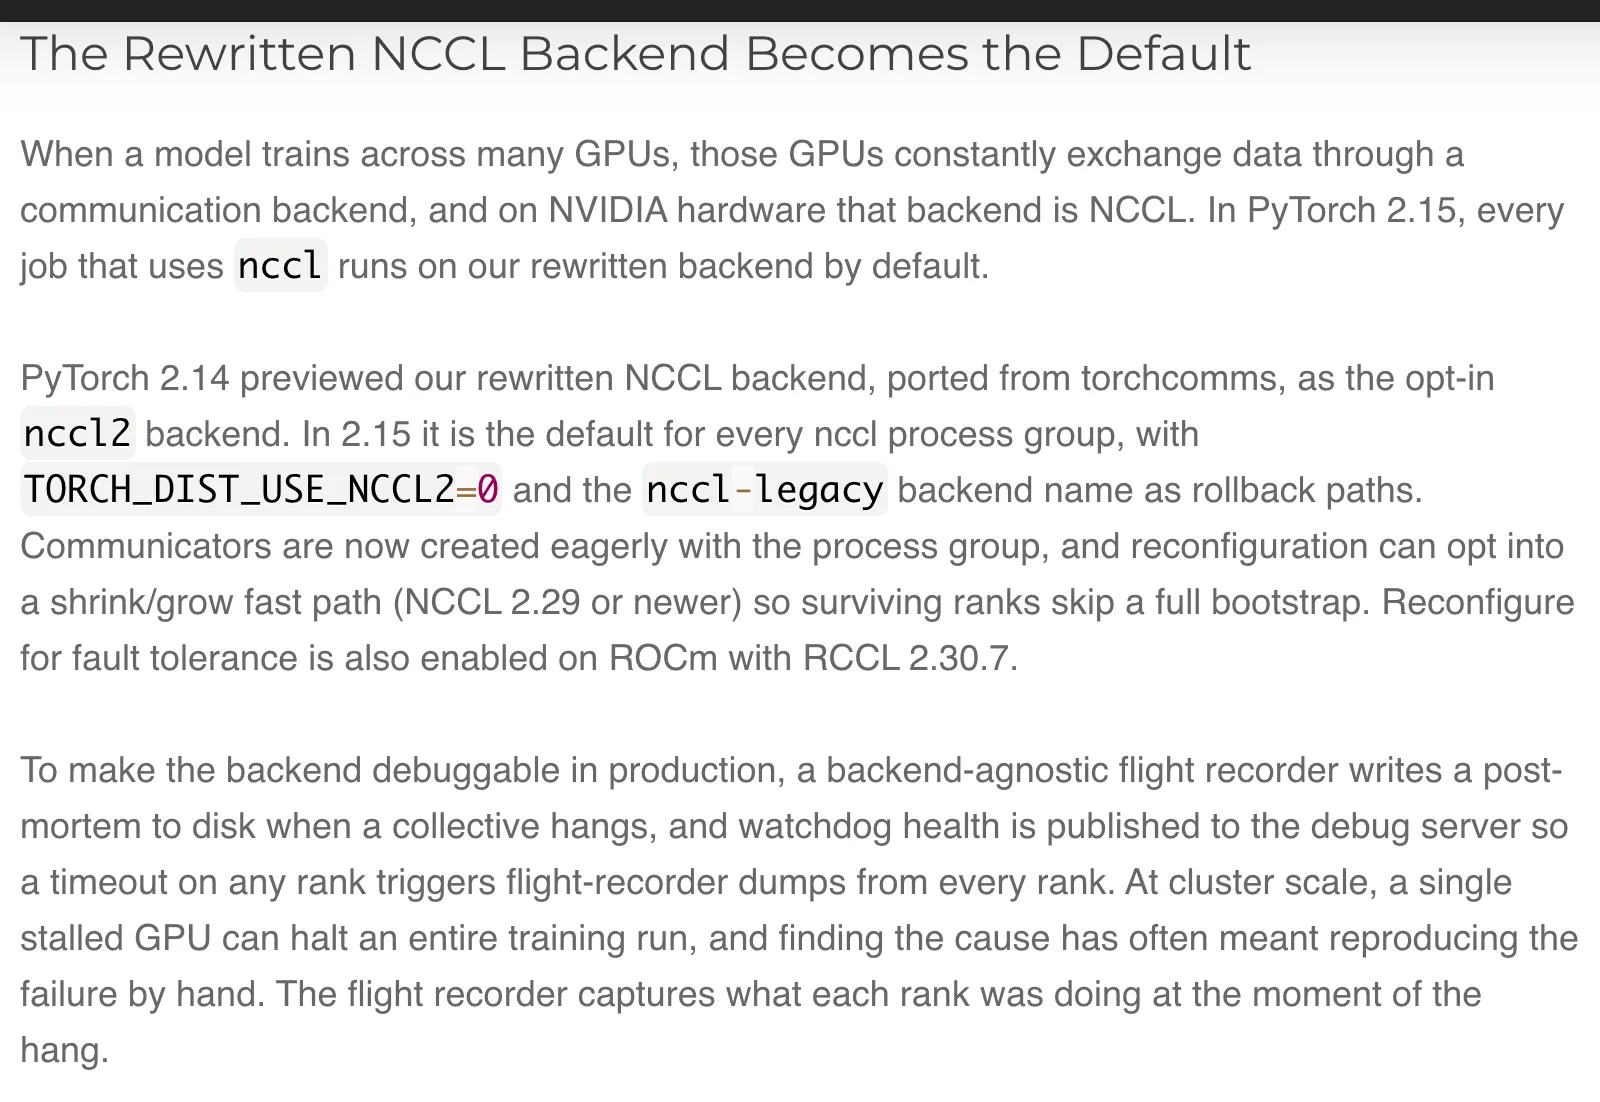
多張 GPU 要一起訓練,就得互相交換中間結果,通訊後端決定的是這些交換怎麼進行。在 NVIDIA 硬體上,這個角色長年由 NCCL 擔任。PyTorch 2.14 先把改寫版的新後端以選用性質上線,名稱叫 nccl2;2.15 把它轉正,凡是 backend="nccl"(也是 init_process_group() 在 CUDA 上的預設值),現在建立的都是新實作。
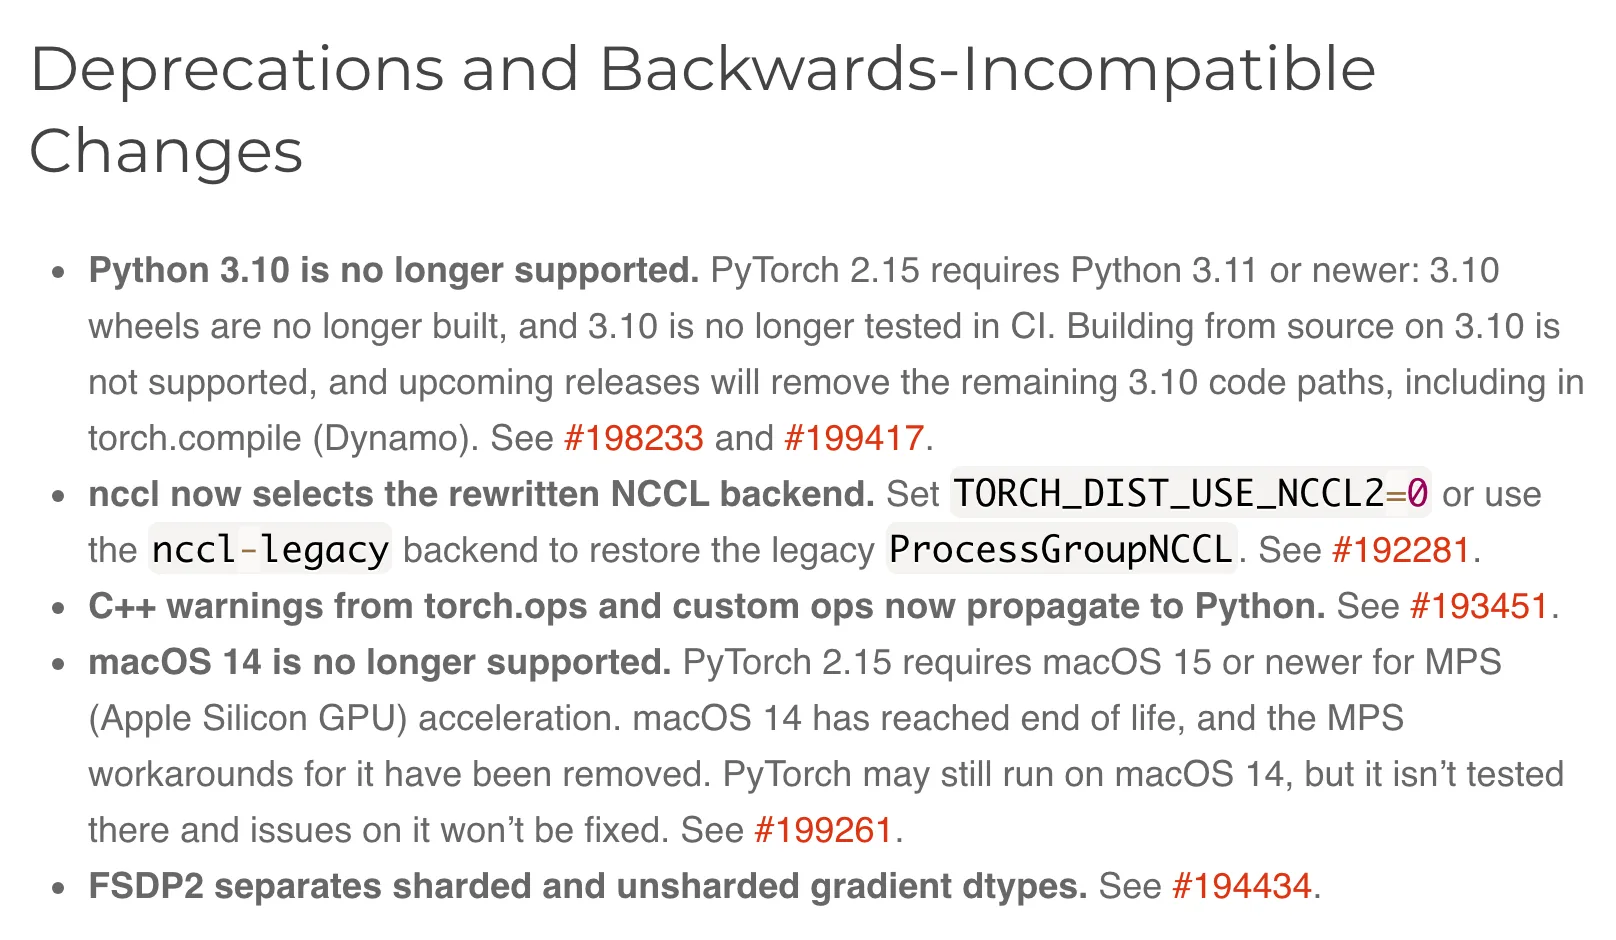
官方同時留了兩條退路:在每個 rank 建立 process group 之前設環境變數 TORCH_DIST_USE_NCCL2=0,或者把後端名稱直接寫成 nccl-legacy。但 release notes 用粗體寫明了期限:這兩條退路只保留在這一版,下一版就會移除,要遷移的程式碼應改用 nccl 或 nccl-lazy。換句話說,退回舊後端爭到的只是排查問題的緩衝期,緩衝期結束前仍要完成搬遷。
nccl-lazy 值得記一下:集體通訊走一條 eager 建立的 communicator,但每對 send/recv 夥伴各自拿到專屬的 communicator 與 stream,對不同節點的點對點傳輸可以並行重疊,這點與舊後端相同。需要獨立點對點通道的程式碼,官方給的正解就是搬去這裡,別把程式碼長期留在 legacy。我在本機的 2.15.0 環境確認過,nccl-legacy 與 nccl-lazy 都已登錄為可用後端名稱。官方在 release notes 給的對照範例長這樣:
# 2.14
dist.init_process_group("nccl")

# 2.15:新實作(需要時傳入 device_id)
dist.init_process_group("nccl", device_id=torch.device("cuda", local_rank))
# 需要獨立點對點 communicator 的場景
dist.init_process_group("nccl-lazy", device_id=torch.device("cuda", local_rank))
# 舊實作,下一版移除
dist.init_process_group("nccl-legacy")
同屬分散式訓練的新東西還有一組單側傳輸 API:torch.distributed 加入 Python 層的 transport 介面,第一個後端是 NIXL。它透過 store 直接與節點建立連線,不需要先有 process group,read_stream/write_stream 把傳輸排進 CUDA stream,因此可以被 torch.cuda.graph 捕捉。做叢集資料預取、參數伺服器類架構的團隊,這是值得追蹤的新介面,官方同樣標記 Unstable。
同一份 release notes 裡還有一條容易被跳過的變更:分散式 checkpoint 的 metadata 開始記錄 tensor strides。後果直接:用 2.15 存的 checkpoint,拿到 2.14 或更早版本讀取,會在 dcp.load 丟出 CheckpointException,訊息是「too many values to unpack (expected 5)」,而且官方明言沒有寫回舊格式的開關。反方向沒問題,2.15 讀 2.14 與 2.15 的檔案都正常。
這對回滾計畫是實質限制。以往「升級出問題就退回舊版」的前提,是新版產物舊版也讀得動;從 2.15 開始,訓練中產生的 checkpoint 只能被同一版或更新版本讀取。要把 2.15 放進正式訓練流程,舊環境與升級前的 checkpoint 副本得先留好,否則退回 2.14 之後,新跑出來的東西就接不回去了。比較穩的做法是把 2.15 當新軌道跑:舊版繼續出最後一個可交付的檢查點,新版成果另存目錄,等新版連續跑出可接受的指標再換軌,兩邊的檔案不要互相覆蓋。
release notes 列出的差異,多數平常感覺不到,出事時才會現形:
device_id(沒給就用 LOCAL_RANK 對裝置數取餘)綁定裝置,torch.cuda.set_device() 不再被拿來推斷。張量落在別張卡上會直接報錯,像是「Expected tensor on cuda:X but found tensor on cuda:Y」。一個 process 要用多張 GPU 的程式碼,這一版仍需要 nccl-legacy。dist.get_backend_impl(...) 回傳的是新類別,isinstance(..., ProcessGroupNCCL) 變成 False,舊後端獨有的方法(如 comm_split_count())不在了。依賴這類檢查的工具碼要跟著改。work.get_future() 拿到的是逐 rank 輸出的 list,不再是包著 stacked tensor 的單元素 list;官方建議直接讀傳入 all_gather 的輸出 list,兩種後端都通用。排障工具倒是補上了。新後端附帶一個與後端無關的 flight recorder:集體通訊卡住時自動把 post-mortem 寫到磁碟,watchdog 健康狀態發布到 debug server,任一 rank 逾時就觸發所有 rank 傾印紀錄。過去在叢集上追一張卡拖垮整個訓練的問題,常要靠人工重現,現在有當下的現場可以看,能直接對照每個 rank 卡在哪個集體操作,把「等別人」跟「自己算錯」分開。這組 API 官方標記為 Unstable,綁版本查文件比較穩當。另外,重配置的 shrink/grow 快速路徑需要 NCCL 2.29 以上,讓存活的 rank 略過完整 bootstrap;ROCm 上相對應的容錯重配置需要 RCCL 2.30.7。
CUDA 側的除錯也有新東西:CUPTI monitor 改名 Cuspy,被 CUDA graph 重放的核心現在能回溯到捕捉它的程式碼位置,export_chrome_trace 會把核心註解寫回 trace,開 record_py_stacks 連 Python 呼叫堆疊都會記下來。已經把推論收進 CUDA graph 的專案,過去看 trace 只知道「某個 graph 在跑」,不知道是哪段程式放進去的,這版把這層黑盒打開了一角。
Apple Silicon 這次的功能,我在本機(macOS、Python 3.14 的乾淨環境)裝了 torch==2.15.0 逐項試過:torch.float8_e4m3fn 的張量可以在 MPS 上建立與轉換;torch.nn.functional.scaled_mm 用 FP8 輸入、tensorwise 與 rowwise 縮放都跑得通,解碼常用的 gemv 形狀(M=1)也通;MoE 用的 torch.nn.functional.grouped_mm 有原生 MPS 實作;torch.mps.Stream、current_stream、set_stream 與 stream context manager 都是公開 API,建 stream、查 current stream 都正常。
兩個實測細節值得記。使用 F.scaled_mm 時矩陣的 K 與 N 維度要能被 16 整除,不然會在形狀檢查就被擋下,訊息會直接寫明 K 與 N 要能被 16 整除;而舊的私有算子 torch._scaled_mm 在 MPS 上沒有實作,FP8 縮放矩陣乘法在 2.15 的正確入口是公開的 F.scaled_mm。官方部落格的「_scaled_mm」字樣,對到的是這條公開路徑。
Stream API 的實用性比字面上大。MPS 過去沒有公開的 stream 操作,資料搬運與計算的排序能做的有限;有了 torch.mps.Stream 與 stream context manager,把主機到裝置的複製、預處理和核心計算排進不同 stream 交錯執行,寫法可以對齊 CUDA 上累積多年的非同步模式。對在 Mac 上做推論服務或資料管線的人,這是把 MPS 從「能跑」推向「能排程」的一步。
加速數字就要綁場景看了。官方量測:M3 Ultra 上 MoE 解碼吞吐提升 1.32 到 1.34 倍;128,256 詞彙的單行 softmax 快 8 倍;upsample 反向傳播最快 21.7 倍;norm 全量歸約快超過 100 倍;512×512 的 QR 分解從約 7 秒落到 1.5 毫秒。這些都是官方在特定硬體與特定形狀下的數字。我在本機(非 M3 Ultra)做了一個解碼形狀的微型對照:fp16 的 F.linear 約 0.060 毫秒,FP8 的 F.scaled_mm 約 0.391 毫秒,FP8 沒有比較快。這不是推翻官方量測結果,而是提醒分母:FP8 支援兌現的是「能用」,「變快」要等你的形狀、硬體與場景對上官方量測條件,MoE 解碼與 gemv 路徑才是這次的主戰場。想在 Mac 上對比 PyTorch 與 MLX 差異的讀者,之前 HobbyLM 的訓練實錄有過兩者並排的數字可以參考。
FSDP2 在 2.15 補上了精度混合的細粒度控制:MoE 的 router gates、norm weights 這類對誤差敏感的參數可以留在 fp32,模型其他部分照樣用 bf16 訓練,而且每個 fully_shard 仍維持一次 all-gather(透過 MixedPrecisionPolicy 的 param_dtype_override_fn)。梯度精度可以逐參數設定,整段梯度累積也能被單一 CUDA graph 捕捉。MoE 的路由器一旦因為數值誤差選了不同專家,後面的計算路徑就整個變了,這種功能讓「哪裡該保留精度」變成可以按結構逐段指定的決策,整個模型不必一起降。對量化與低位元表示有興趣的讀者,可以對照先前介紹過的 EntroPack 任意位元率模型壓縮,兩者處理的是訓練中與訓練後的精度,剛好互補。
但同一節的 release notes 也寫著 BC-breaking:MixedPrecisionPolicy(reduce_dtype=None) 的預設行為改變,梯度累積與歸約改用參數自身的 grad_dtype,不再沿用 param_dtype。既有 FSDP2 訓練的梯度 dtype 行為要重新驗證,訓練曲線有無漂移也得看原本的品質指標,這種變化不會丟錯誤訊息,只會慢慢影響結果。整段梯度累積可以收進單一 CUDA graph 的意義也具體:多個 micro-batch 的累積從逐次 kernel launch 變成一次圖重放,launch 開銷與同步點同時變少,這對小 batch、多步累積的訓練設定最有感。
管線並行(pipeline parallelism)同時拿到一批記憶體與通訊改善:receive buffer 改成收到前一刻才配置,不再為每個 microbatch 預先保留;forward 輸出在 send 完成後就釋放;排程接受 max_outstanding_sends 流量預算;每條 pipeline 平行 rank 之間的傳輸邊有專屬 P2P communicator;FSDP 的 unshard 錯開在各 rank 的啟動 bubble 執行,梯度歸約可以和後續計算重疊。官方把這組改動的總結寫成「cudagraphable、deterministic、優化過的記憶體剖面」,對已經在跑大模型管線並行的團隊,2.15 值得單獨為這段做一次對照測試。
torch.compile 在 3.15 上可用了。環境還在 3.10 的專案,升級前要先過這關。torch.backends.mps.is_available() 會回 False,配置 mps 裝置會丟出「The MPS backend is supported on macOS 15.0+」。CPU 版建的輪子仍能在舊系統跑。NVIDIA Blackwell 的 NVFP4 低精度解碼走 NVGEMM 路徑,把 ModelOpt NVFP4 線性層的反量化係數折進 GEMM、少一次逐層 pointwise launch,並用 programmatic dependent launch 讓 Triton 寫的消費端核心能與 GEMM 尾段重疊;官方還補了一組有界、形狀感知的候選策略,補上 nvMatmulHeuristics 涵蓋不到的 Blackwell NVFP4 解碼形狀。AMD 的核心 DSL FlyDSL(gfx950)與 gfx1250(MI450)上的 Tensor Data Mover 支援與 Intel 的 SYCL 自由函數核心、XPU 多卡效能分析也都在這版入列。這些平台級更新的細節,官方 release notes 都逐項列了條件;需要寫 GPU 核心的讀者,可以先看先前整理過的 NVIDIA CUDA Rust 記憶體安全核心,兩邊的方向是接起來的。
| 你的專案 | 這一版對你的意義 | 建議動作 |
|---|---|---|
| 多 GPU NCCL 訓練 | 預設後端換人、退路只到下一版 | 先盤點再升,保留舊環境與舊 checkpoint |
| FSDP2/管線並行 | 精度與記憶體控制變細,一個預設反轉 | 重驗梯度 dtype 行為與品質指標 |
| Mac(Apple Silicon) | FP8、grouped_mm、Stream API 可用 | 可直接升,FP8 走 F.scaled_mm |
| Python 3.10 或 macOS 14 環境 | 支援已收掉 | 先升環境,再談框架 |
| 單卡/純 CPU | NCCL 變更不觸及 | 照常升級,留意相依套件 |
init_process_group 的呼叫方式(有沒有傳 device_id)、一個 process 是否用多張 GPU(這類程式碼這版還綁 nccl-legacy)、有沒有依賴 ProcessGroupNCCL 的型別檢查。跑一次代表性訓練任務,對照升級前後的記憶體基線與品質指標,再把舊版 checkpoint 副本與舊環境留好。出現卡住時,先開 flight recorder 看現場,退回 nccl-legacy 是排查手段,記得它下一版就消失。reduce_dtype=None 的行為變化對訓練指標的影響;想讓敏感層留在 fp32 的,param_dtype_override_fn 是這版的新位置。F.scaled_mm,記得 K、N 要被 16 整除;對速度有期待前,先確認自己的形狀是不是官方量測的那類場景。2.16 的時程官方尚未公布,NCCL 舊退路是否如期移除、flight recorder 與單側傳輸(NIXL backend)等標著 Unstable 的 API 會不會轉穩定、Python 3.10 的殘餘程式碼路徑何時清完,都要等下一版 release notes。官方問答網研討會排在 11 月 5 日 11:00 PT(台北 11 月 6 日凌晨 3 時),由 Meta 的四位工程師概述這一版並開放社群問答,遷移相關的疑問可以帶到問答環節。這些結論的效力跟著 2.15 走:2.16 發布前後,退路、Unstable 標記與 wheel 家族這三件事值得回來核對一次。