TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Subquadratic 在 10 月 12 日推出 SubQ Snap 決策模型,公開預覽主打 384K 上下文、每百萬輸入 0.05 美元、輸出免費。官方成績單 16 項企業基準贏 13 項,但落後最多的 When2Call 恰好是主打的工具呼叫時機判斷,本文照官方標注的條件把容量、速度與價格攤開來讀。
用 AI 摘要這篇文章:
2026 年 10 月 12 日,Subquadratic 在官方網誌發布 SubQ Snap,一個專門給代理工作流用的決策模型,即日起以公開預覽供應。發布的重點有三個:上下文上限 384K tokens、每百萬輸入 token 0.05 美元(輸出不收費)、官方宣稱 100K tokens 以內的請求一秒內回傳。前 1 萬名註冊者另獲 1 億 tokens 的免費輸入額度。
先把名詞說清楚。決策模型不做開放式的文章生成:應用程式先定義好合法答案(比如「帳務、技術支援、其他」三個去向),模型讀完背景資料後直接回傳每個答案的機率。代理每一步都要做的分流、選工具、檢查結果、判斷要不要停,都屬於這類有明確選項的判斷。TechMoon 先前介紹過的 TypeSafe Jev、Microsoft Decision-1 與 Nace Drex 1.5 都在同一個品類。
Snap 的差異化不在價格,而在讀取端:同品級的競品上下文停留在 32K tokens,Snap 把上限推到 384K,讓整份合約、整個程式庫或整段代理歷史一次讀完再判斷。不過成績單上最大的兩個比分,都要照它自己標注的條件來讀。
Decisions API 是 Snap 對外的唯一介面,端點 POST /v1/systemone,不是 OpenAI 相容格式。它提供三種題型:noul(是否題,回傳「是」的機率)、choice(單選題,可定義 2 到 255 個選項,回傳每個選項的機率與信心值)、score(等級題,2 到 10 個有序等級,回傳加權分數與各等級機率)。每次請求可以一次問多個問題,全部共用同一份背景資料。
這種介面的價值在分工:模型只負責在預先定義的答案之間挑選與給分,程式端拿到的是結構化輸出,不必再解析自由文字。Subquadratic 在發布文裡也點名了同品類的其他做法:Laya 用雙向編碼器加決策頭,Perplexity 的 Decider v1.1 把預訓練語言模型改成非因果注意力,TypeSafe 的 Jev 則是另一套實作。介面長得一樣,架構各不相同。
四種決策角色用一個寫程式的代理走一遍就很具體:使用者丟來一個新需求,先判斷該直接回答、該反問、還是該叫工具(分流);決定要動手後,下一步是搜尋程式碼、讀檔案、還是跑測試(選工具);拿到輸出後,對照證據檢查結果可不可以接受(檢查);每一輪結束前判斷任務完成了沒、要不要繼續(停止)。這些判斷每輪都出現,答案永遠在幾個選項之內,但正確判斷需要的證據可能藏在任何角落。
矛盾出在讀取端。答案再短,判斷依據可能散落在一整個程式庫或長對話裡:使用者 40 輪之前說過的限制、寫在別的檔案裡的設定、合約附件裡的一條但書。現行做法只能二選一:把全部資料塞進去,忍受注意力成本隨長度平方膨脹;或者先用檢索、摘要、分塊削減輸入,賭一賭被丟掉的段落不重要。發布文對後者的風險寫得很直白:截短可能丟掉 40 輪前的限制,檢索可能漏掉關鍵證據,摘要可能拿掉後來才重要的細節。
Snap 不走這兩條老路:架構上把注意力計算從平方級降到線性(官方稱 SSA,次二次稀疏注意力),再配合決策頭直接輸出答案分佈。官網首頁的對照圖宣稱,外推到 2M tokens 時,密集注意力的前沿模型每層要 1,008 PFLOP,SubQ 只要 7.8 PFLOP,差距標示 128 倍(1M tokens 處為 64.5 倍)。這是公司自己的推算,實際導入時,該驗的仍然是三件事:你的資料長度下要等多久、答對多少、花多少錢。
文件寫得很精確:384K 就是 393,216 tokens,超過或接近上限的請求會直接回 400 錯誤,文字與圖片共用同一個額度。要注意兩個數字的區別:原廠在 Decision RULER 評測裡把長度拉到 32K 至 1M tokens,得分 96.3 到 99.8,但那是研究評估;公開產品的輸入上限仍是 384K。看到「百萬」字樣時,先確認它講的是哪一層。
RULER 的改編方式也該知道。Subquadratic 把 13 個 RULER 任務中的 11 個改成四選一,錯誤選項在可行處也藏進填充文字裡,讓模型必須真的找到正確的那個;另外 2 個問答任務被丟棄,因為測試發現模型不看文件也答得出來。這種自己改編基準的做法不是問題,但意味著分數只能跟同套改編的比較對手對照,首頁上 Jev 那欄標的就是 N/A:Jev 的上下文上限 32K,根本進不了 256K 的考場。
圖片的邊界同樣明確。每次請求最多 4 張圖(PNG、JPEG 或 WebP,每張解碼後 4 MiB 以內、合計 8 MiB),每張約佔 64 到 256 個 image tokens,連同文字一起計入 384K。影片不支援直接輸入,文件建議抽最多 4 個影格當圖片送入。所以「多模態」的實作範圍到圖片為止,連續動作或長影片分析需要自己取樣與評估。
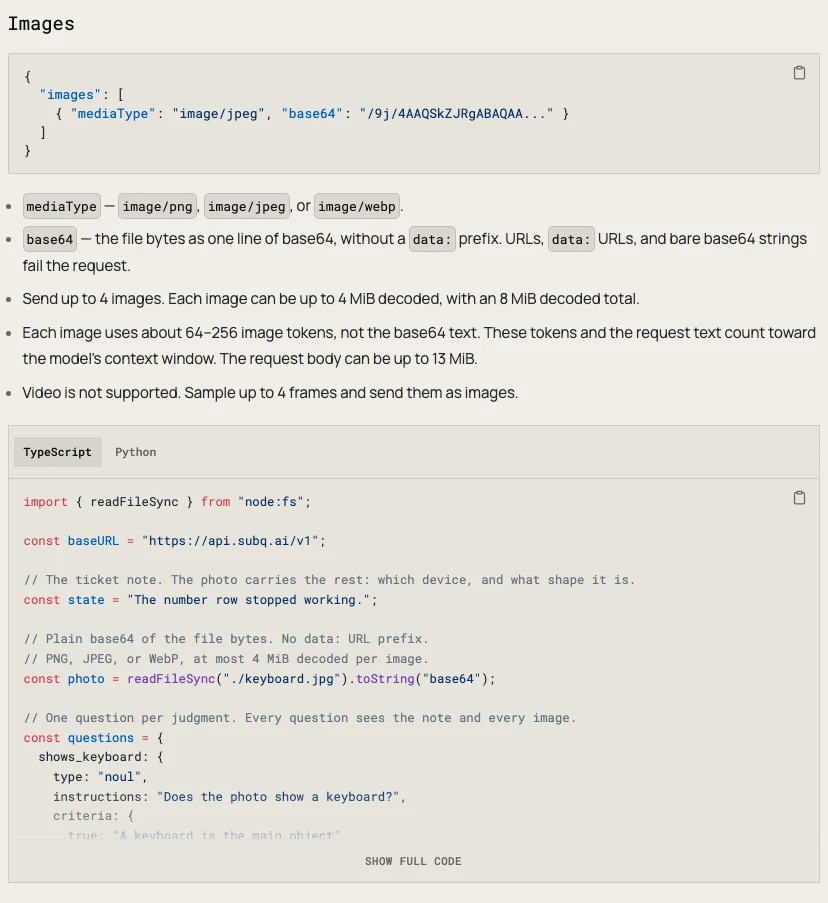
Snap 的評測全由公司自跑自報,沒有第三方複核,讀的時候把這個前提放在旁邊。
先看兩個總分。Decision Index v0.2.1 是決策模型的公開指數:37 個基準、五個加權領域,計分方式把亂猜定為 0、全對定為 100,最長的題目約 34K tokens,量的是短上下文決策。Snap 得 61.7,Jev 57.9;五個主要類別裡 Snap 贏了四個(品味的差距最大,到 12.11 分)。Bespoke Labs 的 Nimble 13 是另一個總分:3,880 個人工標記樣本、13 個資料集,Snap 平均 82.9%,Jev 76.0%。兩個總分同向,但 61.7 不能讀成「所有問題答對 61.7%」,它已經把亂猜扣掉了。
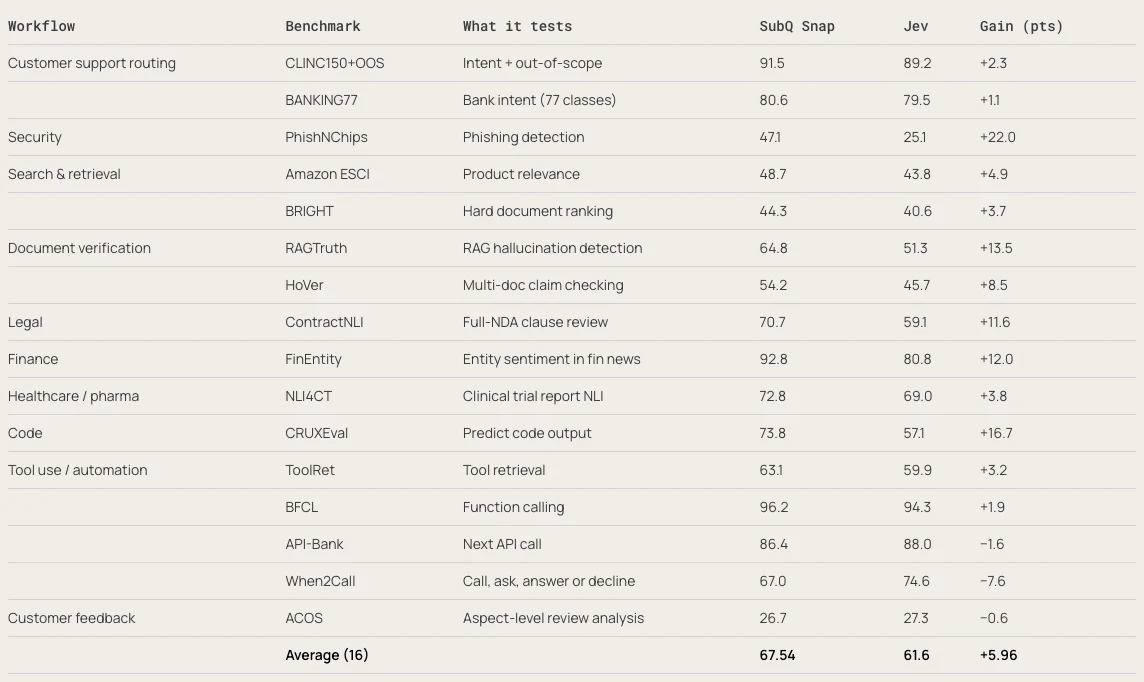
再進到貼近採用決策的 16 項企業基準:Snap 平均 67.6 對 Jev 61.6,13 項領先、3 項落後,其中八項(左邊是 Snap 的分數):
| 場景 | 基準 | Snap | Jev | 差距 |
|---|---|---|---|---|
| 釣魚偵測 | PhishNChips | 47.1 | 25.1 | +22.0 |
| 程式碼執行預測 | CRUXEval | 73.8 | 57.1 | +16.7 |
| RAG 幻覺檢查 | RAGTruth | 64.8 | 51.3 | +13.5 |
| 財經情感 | FinEntity | 92.8 | 80.8 | +12.0 |
| 合約條款審閱 | ContractNLI | 70.7 | 59.1 | +11.6 |
| 客服分流 | CLINC150+OOS | 91.5 | 89.2 | +2.3 |
| 下一步 API 呼叫 | API-Bank | 86.4 | 88.0 | −1.6 |
| 呼叫時機判斷 | When2Call | 67.0 | 74.6 | −7.6 |
落後的三項值得逐字看。When2Call 測的是該呼叫工具、該反問使用者、該直接回答還是該拒絕的時機,Snap 67.0 輸 Jev 7.6 分;API-Bank 的下一步 API 呼叫也小輸。而發布文把 Snap 的設計定位在四種決策角色:分流、選工具、檢查、停止。換句話說,成績單上差距最大的落後項,恰好壓在產品主打的用途上。這不必然否定產品(7.6 分在絕對分 67 對 74.6 的水準上差距有限),但它指出導入前最該先測的位置:如果你的代理最需要的就是「現在該不該叫工具」這種判斷,先用自己的資料跑一輪 When2Call 型的題目再決定。
壓軸的長文件推理 Decision LCR 是公司給出的最大比分:Snap 74.0 對 Jev 48.0,26 分差。但表格欄位自己標注了條件:Snap 一次讀入 72K 到 115K 的多文件組,Jev 用分塊處理。這個 26 分呈現的是「整份讀完」與「分塊後再判斷」兩種資料處理方式的差異,支持長背景的價值主張,但不能當成兩個模型在同輸入條件下的對決。發布文同時提醒,這套分數是從 Artificial Analysis 的 AA-LCR 改編而來(100 題轉成 118 個選擇題、三種選項順序各評一次、亂猜基準 19.2、把文件拿掉後模型還能得 24 到 25),不能拿去跟 AA-LCR 排行榜上的分數直接對照。
定價結構很簡單:輸入每百萬 token 0.05 美元,輸出免費。按這個費率,10 萬輸入 tokens 約 0.005 美元,一份 38.4 萬 tokens 的完整背景約 0.0192 美元。輸出免費對決策模型特別實惠,因為它的答案本來就只有幾個 token。
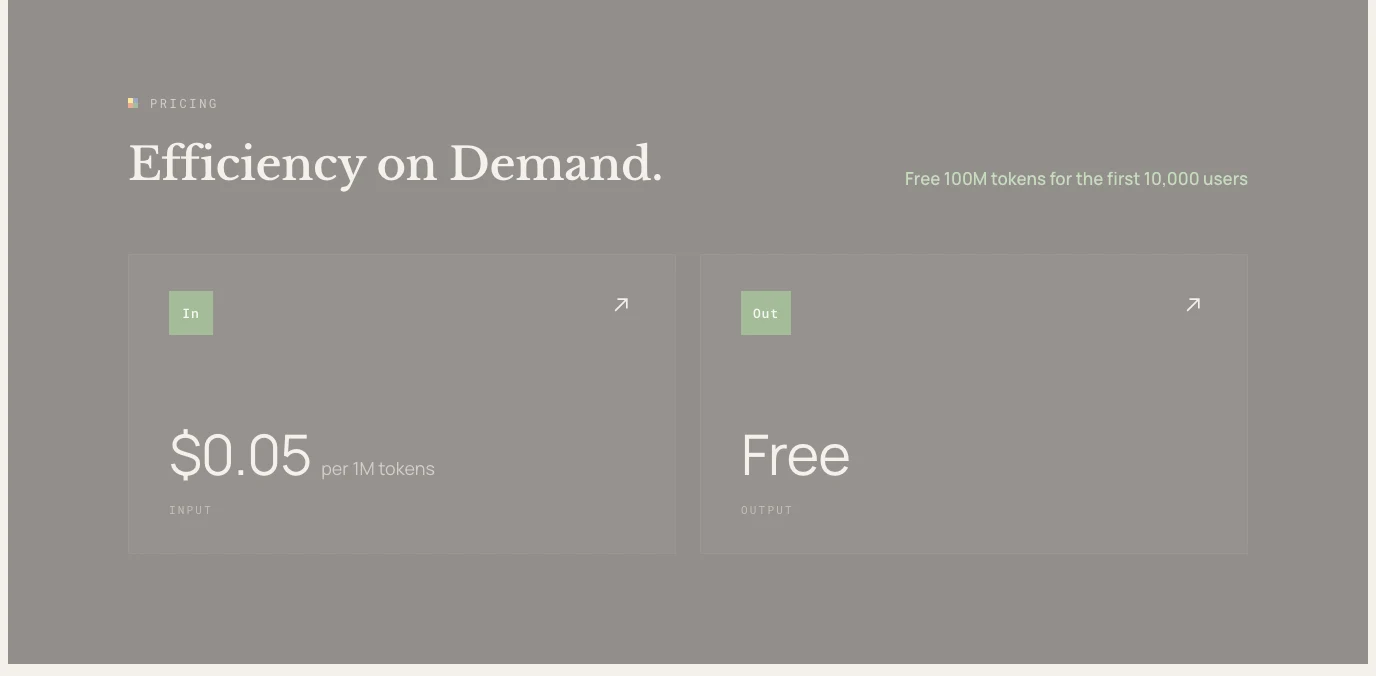
不過把視野拉到整個品類,0.05 美元不是最低價。Jev 1.13 與 Microsoft Decision-1 都是每百萬輸入 0.042 美元、輸出同樣免費。Snap 貴了不到兩成,換到的是 12 倍於對手的上下文上限。決策模型這個品類的單價本來就遠低於生成模型,選型先看任務需要多大的背景、以及題型契約跟現有程式的契合度;幾美元的價差影響有限。
還有兩個成本面的細節。一,優惠要看帳戶:首 1 萬名註冊者的 1 億 tokens 免費額度,名額與帳戶實際拿到多少,以註冊當下為準。二,反覆送同一份長背景時,費用按每次呼叫累積計算;一次 0.0192 美元看起來小,但一個每天把 38 萬 token 背景送 50 次的代理,單日光輸入就是 0.96 美元,帳要照呼叫次數乘上去。
模型名稱有個容易踩的坑。subq-snap-preview 是這次的決策模型,走 Decisions API,公開預覽、不需按帳戶開通(先到先得,額滿進候補);名稱相近的 subq-preview 是另一款長上下文對話模型,走 OpenAI 相容的 Chat Completions 與 Responses 端點,目前是早期存取,要按帳戶開通,未開通的鑰匙會收到 403。兩者的介面與適用場景完全不同:要產生文章找對話模型,要在定義好的選項之間做判斷才是 Snap 的領域。
資料保留是組織層級的政策,預設無限期:提示與完成內容會一直保留到你主動刪除。可以聯繫 SubQ 改成 N 天後刪除,或申請零資料保留(啟用後什麼都不落地)。零保留模式下 Decisions API 不受影響,但帳務與支援記錄仍然存在,內容包含模型、token 數與時間,文件明文保證這份記錄永不包含提示與完成內容。要把企業文件送進去之前,保留政策與可傳送範圍先跟內部規定對齊。
供應狀態方面,公開預覽採先到先得,容量滿了之後新使用者會進候補名單,等更多產能上線。想試用,入口在 console.subq.ai:註冊帳戶、建立 API key,沒有可用額度時請求會回 402。把它接進正式流程前,記得先寫好退路:逾時轉人工、額度不足時沿用原本的分類規則,預覽期的服務不該成為唯一路徑。公開預覽期間的規格與價格都可能調整,本文的數字核對至 2026 年 10 月 13 日。
Subquadratic 的產品節奏很快。2026 年 5 月 5 日發布 SubQ,一個宣稱 12M-token 上下文的次二次 LLM(HN 上 84 分的討論串);6 月 16 日發布 SubQ 1.1 Small 技術報告,模型進入設計夥伴的早期存取;10 月 12 日的 Snap 則把同一套 SSA 研究成果做成決策模型商品。據 The New Stack 五月的報導,這家公司前身叫 Aldea,做語音模型後轉型,累計募資 2,900 萬美元、估值 5 億美元。規模上是新創:採購前對供應穩定性與長期支援,要有自己的判斷。
四件事目前沒有公開資料可確認:實際延遲(一秒內僅為發布文宣稱,尚無獨立實測)、中文與繁體任務的表現(官方文件未揭露分語言評估)、候補名單是否已觸發(頁面看不到即時容量)、以及公開預覽轉正式版的時程與屆時價格。這幾項都可能在幾週內變動,引用前先核對最新公告。
對已經在用 Jev 的團隊,Snap 的意義不是替換,是多一個長上下文的選項:32K 裝得下的短判斷,兩家價格與表現都在同一帶;要一次讀完整份合約或整個程式庫再判斷,目前只有 Snap 把這個上限開到 384K。導入順序建議從一個可以驗收的判斷點開始:準備人工已確認答案的樣本(包含模糊與資訊不足的案例),記錄正確率、等待時間與每件實際花費,再對照原本的做法;任務怎麼拆成這類有明確選項的判斷,可參考 Jev 的 Use Case Map 拆解法。要是你的任務剛好落在 When2Call 那一列,先測再說;要是落在合約審閱或釣魚偵測那幾列,官方自報的差距確實大到足以排一輪試用。