TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

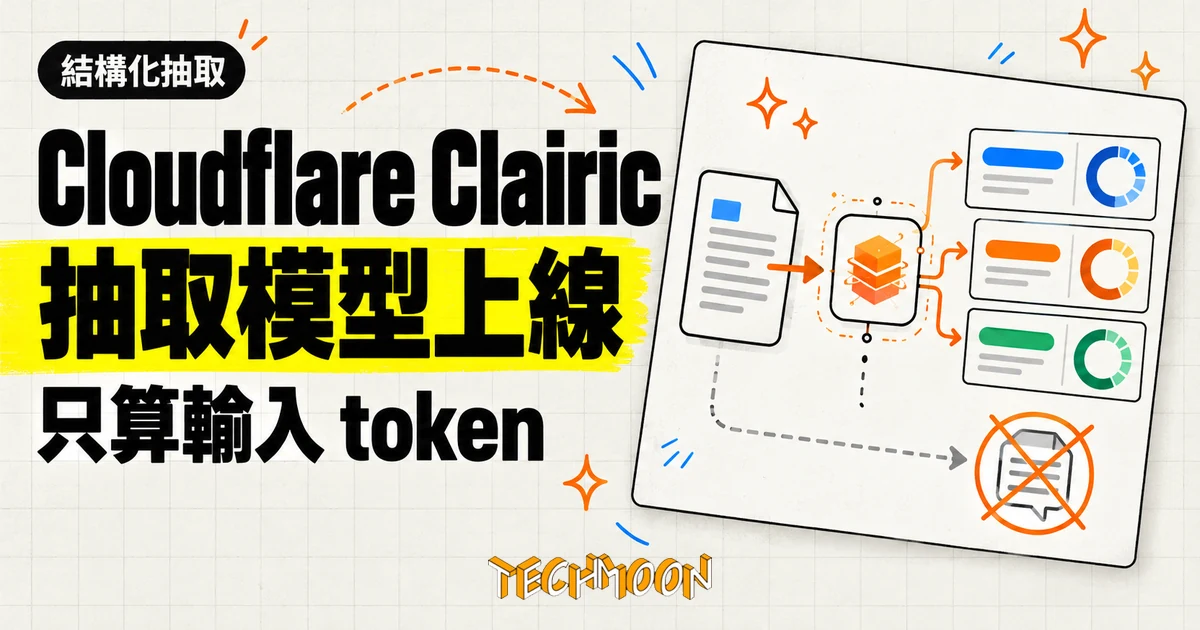
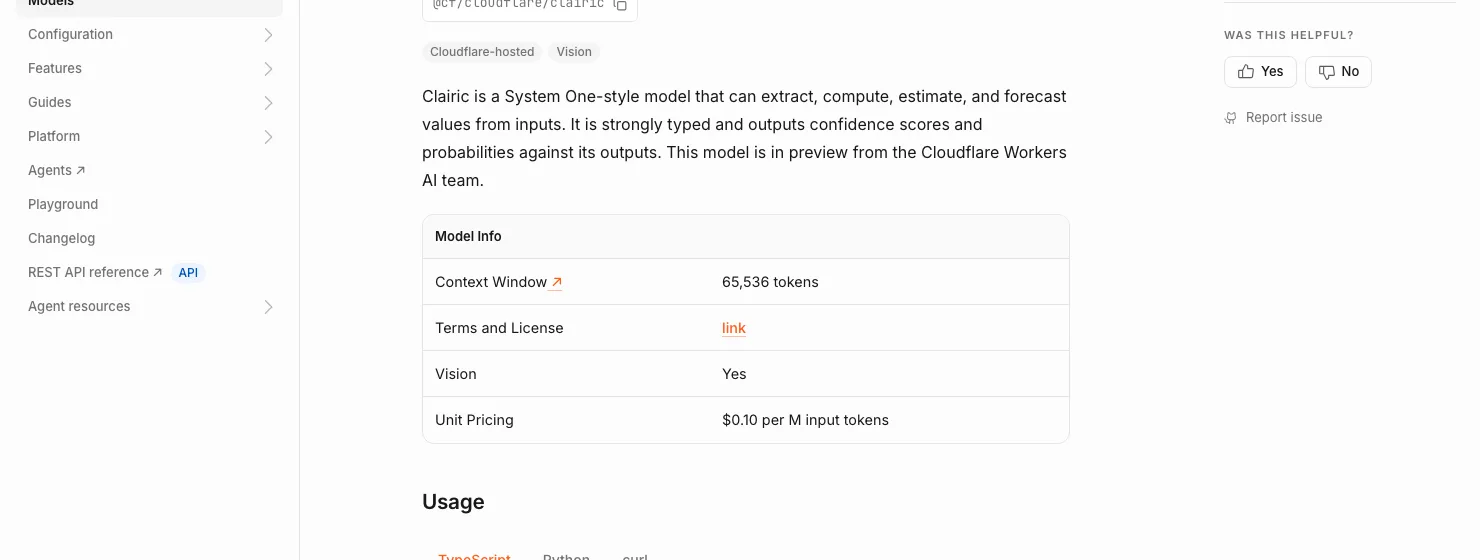
Cloudflare 發表 System One 抽取模型 Clairic 預覽版,一封客服信或一張收據指定欄位後,單次運算回傳每個欄位的值、原文出處與信心分數,不產生輸出 token,每百萬輸入 token 計 0.10 美元。本文核對官方部落格與 Workers AI 文件,整理用法、計費與目前做不到的事。
用 AI 摘要這篇文章:
台北時間 10 月 20 日凌晨 1 時 48 分(UTC 19 日 17 時 48 分),Cloudflare 發表了新模型 Clairic,掛上 Workers AI 平台、模型識別碼 @cf/cloudflare/clairic,狀態是預覽,模型已直接列在 Workers AI 的公開目錄上。官方給它的定位是 System One 抽取模型的首例:你丟給它一封客服信、一張發票或一張收據的照片,先用文字宣告你要哪些欄位、每個欄位是什麼型別,它就一次運算把每個欄位的值算出來,附上信心分數,查無資料的欄位老實回 null。整個過程不產生任何輸出文字,計費只算輸入,每百萬個輸入 token 收 0.10 美元。署名作者有三位:Alex Reneau、Michelle Chen 與 Kevin Flansburg。
這個類別不是憑空出現。一個月前 TypeSafe 提出 System One 模型的說法並發表了決策模型 Jev,把「快而精準的單次判斷」與「會推理的大型語言模型」分成兩個世界,Jev 也示範了專為單一用途打造、按利基定價的模型能在語言模型失手的地方過關;Cloudflare 隨後在 10 月 1 日開源了自己的決策模型 Clef 與強化學習微調平台,這次的 Clairic 則補上另一塊:抽取。官方給它的分工很清楚,抽取模型把原始輸入變成有型別的值,決策模型把值變成決定,語言模型再把決定寫成文字。Cloudflare 觀察到的背景是,今天有大量同形狀的結構化呼叫湧向語言模型:發票總額多少、貨哪天送到、逾期幾天、這次維修要花多少錢,這類問題要的從來不是一段議論,而是一個可以直接進程式的值。客服申訴、應收帳款、收據報銷、電商訂單,這些每天進來的文件流就是它瞄準的對象。對每天處理這類文件的開發者來說,值得先弄懂的是三件事:它跟叫語言模型生 JSON 差在哪裡、帳單怎麼算、以及官方自己承認它現在還做不到什麼。
先看它怎麼工作。一次呼叫包含兩個部分:state 是要讀的文字,fields 是欄位宣告,每個欄位給名字、型別與用白話寫的說明。型別目前有 text、date、number、list、estimate 這幾種,number 可以指定小數位數與單位,estimate 要給上下界與步長,部落格另外點名 times、datetimes、durations 等型別也在支援列,duration 直接回時長。date 回傳 ISO 格式,輸入裡沒寫年份的日期可以用 reference_date 錨定基準日。整個請求的上下文上限是 65,536 個 token,欄位數量沒有上限,塞不進單趟 8,192 個 token 的運算就自動拆成多趟平行處理再合併,每趟都看得到完整輸入。
文件對「值」的來源分得很細,這份分類值得照抄:抽取回傳輸入裡明確出現的值,例如發票上印的總額;計算從輸入裡的事實推導出輸入裡沒寫的值,例如用到期日減今天算出逾期幾天;估計面對輸入決定不了的未知,例如這張發票到底幾月幾號會被付掉;預測則針對一段期間逐步給值,例如未來四週每週的應收餘額。查無值時的行為依型別而異:單值欄位回 null,清單回空清單,估計與預測則照樣給出分布,輸入裡線索再少也不例外。拿到值之後的用法就是普通程式:拿到期日跟今天比,把逾期的發票標出來。約束只保證形狀、不保證正確,文件自己的例子是:把估計的付款日限制在十一月,它一定回十一月內的日期,但發票還是可能拖到十二月才付。欄位設計也有實際建議:名字取描述性的,說明欄用白話講清楚要什麼(「總應付金額,含稅、含運、折扣後」),型別與單位另開欄位宣告,不要塞進說明裡。
跟語言模型最大的差別在輸出。Clairic 不逐字生成答案,所以官方說它不會像語言模型那樣生成一半把數字看錯、或吐出不合規格的 JSON;每個欄位拿到的是一個宣告過型別的值,text 類的答案直接標出它在原文的起迄字元位置,等於每個答案都附帶可以點回去核對的出處。找不到答案時回 null,同時給 p_null(這個值不在輸入裡的機率)與 guess(它本來會挑的猜測),讓程式能分辨「文件裡真的沒有」和「模型沒找到」,guess 欄位則留下它原本想挑的答案,方便回頭除錯。文件對這類模型的定位講得很白:把 AI 的預測接上應用程式的邏輯,靠的是可預期的結構,而不是自由的文字。
Cloudflare 把模型輸出分成三種形狀,也順手把整個生態的位子排好了:要一個數字或一個值,交給 Clairic,數字附 80% 區間;要從固定選項裡挑一個,交給 Clef,每個選項附機率;要開放式的文字,才輪到語言模型。文件用同一張發票示範三種問法:抽取問總額與到期日;決策問這張該核准、退回還是轉人工覆核;生成模型負責寫發票、訂單與收貨單之間的差異摘要。三種形狀對應的三個典型問題,公告裡各給了一句:金額多少、何時發生、將會是多少;屬於哪類、合不合法、該採取哪個行動;為什麼發生、該怎麼處理、能不能修好。前兩種因為單次運算、不生成 token,官方標示的回應時間通常在 1 秒內,而會推理的語言模型走同樣一步要花好幾秒。官方對語言模型做估計的批評也很具體:拿到的是單一數字,下游分不出有把握的 180 美元和沒把握的 180 美元;以前想用決策模型逼近估計,只能把連續值切成「一百美元以下」「一百到五百」這類桶子,桶子粗、每加一桶就多一份輸入 token。Clairic 直接在你宣告的範圍與步長上給分布,中位數、80% 區間、要的話全部 99 個百分位都拿得到,而且估計值天生落在你宣告的上下界內,事後不用再夾限或進位。兩種 System One 模型都對輸出給了硬保證:Clairic 的每個答案要嘛是宣告型別的值、要嘛是 null,且一定落在你設的界內;Clef 的答案永遠是選項之一。官方形容這補上的是一直都在的缺口,過去要嘛人工先把資料整理好餵給語言模型,要嘛讓語言模型直接嚼沒整理過的原始文件,兩頭都不便宜。
官方文件裡的發票範例把這些性質一次攤開。輸入是一張 Northwind Supply 的發票:四棧板每棧 250 美元、運費 80 美元、開立日 2026 年 9 月 2 日、net 30 付款條件。欄位宣告六個:發票號碼(text)、到期日(date,說明寫「開立日加付款天數」)、總額(number,兩位小數、單位 USD)、聯絡人清單(list)、採購單號(text)、付款天數估計(estimate,0 到 120 天、步長 1)。Clairic 回傳總額 1,080 美元(它自己把 4 乘 250 加上運費算出來)、到期日 2026 年 10 月 2 日(輸入裡沒有這個日期)、兩個聯絡人各自的原文位置,而採購單號因為發票裡根本沒有,回 null 且 p_null 等於 1;付款天數估計則是中位數 30 天加 80% 區間(第 10 到第 90 百分位是 21 到 38 天),並附上落在宣告上下界之外的機率。這種「附區間的估計」正是它與語言模型最實用的分野:下游程式能依區間寬度決定要不要送人工覆核,而不是拿到一個無從判斷把握程度的數字。文件也提醒區間的意義:80% 區間標記的是分布中間的八成,實際值仍然可能落在區間外,把這當保證就是誤讀。
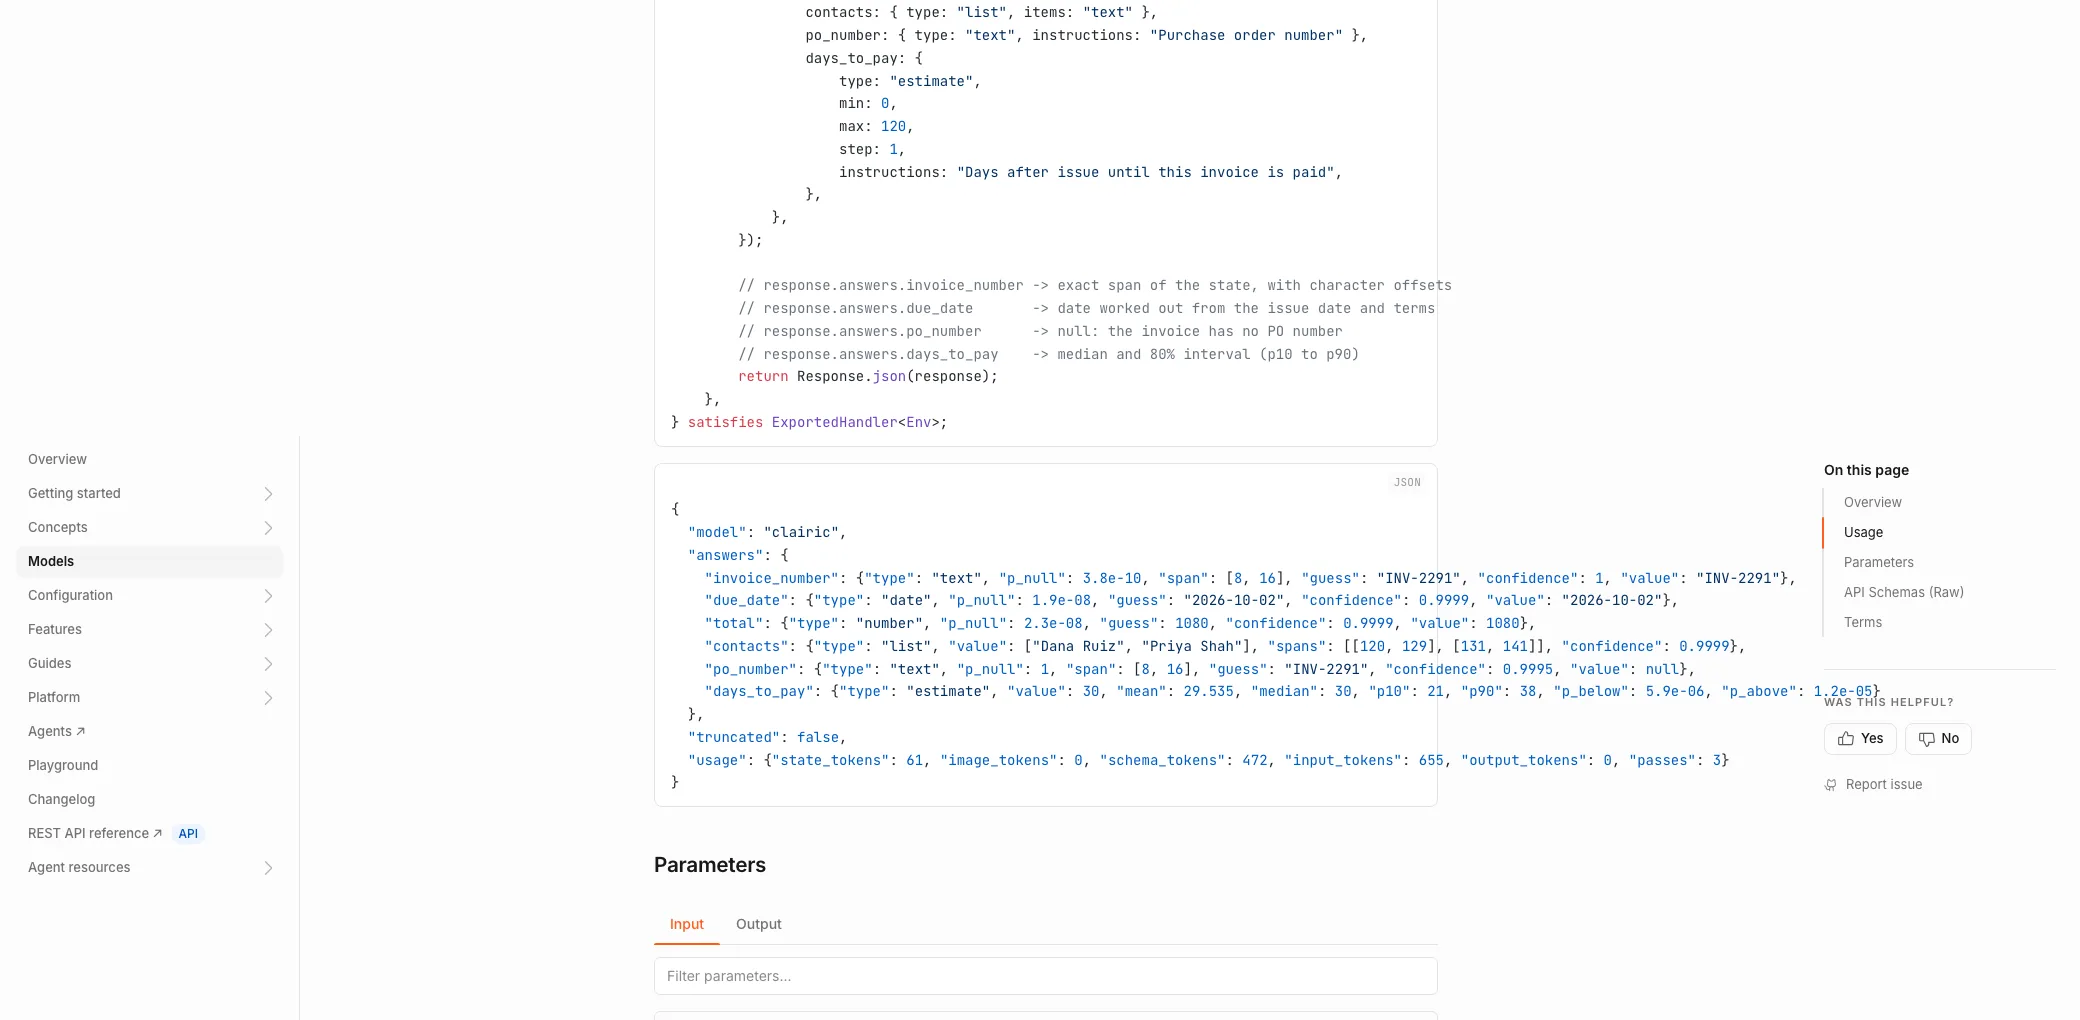
部落格裡另一個例子更貼近日常。一封顧客來信寫著:訂單 A-88412 在 2026 年 9 月 28 日送達,螢幕裂了、機身一角凹陷,付了 649 美元加 52.10 美元稅金,10 月 9 日寫信要求維修或退款。官方示範的欄位裡,總支付金額由 Clairic 當場把價格加稅金算出來,「送達到寫信隔了幾天」則從信裡的兩個日期推出,兩處損傷以原文片段位置回報,可以直接在來信上標示給人看。圖片輸入也在支援列:最多四張 PNG、JPEG 或 WebP,每張 4 MiB,官方用一張角度歪斜、文字不清的真實收據照片示範,照樣抽出欄位值並正確回報收據裡沒有折扣欄位。
計費是這次發表裡對成本結構最有殺傷力的一層。語言模型做抽取時,推理與輸出 token 按每一個欄位、每一份文件收費;Clairic 只處理輸入、單次前向運算,沒有輸出 token 可收,官方在部落格直說問三十個欄位的成本跟問三個差不多,因為所有欄位在同一趟平行運算裡一起回答。
文件裡的 usage 範例給了具體的帳單形狀:讀入的 state 是 61 個 token,欄位宣告本身佔 472 個 schema token,整個請求的輸入 token 共 655 個(兩者之外還有範本類開銷),輸出 token 為 0,拆成 3 趟運算。換句話說,欄位宣告也計費、也吃輸入額度,而且這份示範裡,欄位宣告比要讀的文件正文還貴,說明欄寫得精簡一點就是在省 token,但成本不隨答案長度或答案數量膨脹,只跟輸入文件的長度與你宣告的欄位複雜度有關。以 0.10 美元的單價換算,這個示範請求的成本不到萬分之一美元,一百萬個輸入 token 的額度大約夠跑一千五百份這種長度的請求,量大時帳單是可以事先估算的,這對每天處理幾萬份文件的管線來說,是從「每次呼叫都在燒錢」變成「按輸入量買流量」的差別。
帳單之外,工程帳也一起變薄。今天的抽取管線為了怕語言模型出錯,多半墊了好幾層補救:解析輸出、驗證規格、失敗重試、抽樣人工檢查,每一層都是程式碼與延遲。官方的說法是,Clairic 的答案本身就是從輸入裡標出來的值,出處位移與信心分數讓「驗證這一步答案對不對」變成讀兩個欄位的事,省掉再包一層工程。
接法上沒有新的框架要學:Workers 環境用 AI.run 綁定呼叫,任何地方都能打 REST 端點 /ai/run/@cf/cloudflare/clairic。幾個硬限制也寫在文件裡:圖片不接受遠端 URL,只能內嵌在請求裡,四張合計解碼後 8 MiB、整個請求上限 16 MiB;state 在沒有附圖時必須非空。回應結構裡還備了 truncated 旗標與 state_text 欄,輸入被截斷時程式察覺得到。它接進既有工作流的姿態是並存而非取代,抽取這一步交給 Clairic、要生成文字的步驟交回語言模型;想先看看 Cloudflare 家族還有哪些模型可以在瀏覽器裡試,可以翻Cloudflare AI Playground。把關鍵規格收攏成一屏:模型識別碼 @cf/cloudflare/clairic,狀態預覽;REST 端點 /ai/run/@cf/cloudflare/clairic,Workers 環境另有 AI.run 綁定可用;上下文上限 65,536 個 token,單趟運算 8,192 個 token、超出自動拆趟;輸入計價每百萬 token 0.10 美元,輸出不計費;圖片最多四張、只能內嵌上傳不接受遠端 URL;欄位至少一個、不設上限;權重尚未開放,目前僅託管端點一條路。
Cloudflare 這次附了兩組自家數字,都用「官方宣稱」的層級看待比較安全。一組是預測能力的公開測試:拿美國運輸安全局(TSA)每日機場安檢人數這個公開時間序列,每天早上把截至前一天為止的實際數字餵進去、預測隔天人數,連跑 21 天,結果平均誤差 3.3%,21 天裡有 17 天的實際值落在它給的 80% 區間內(命中率約八成一,對一個標定成 80% 的區間來說,這件事本身就是校準的證據),某一天實際值 2,419,474 對它預測的中位數 2,419,283。它也從純數字裡抓到週期節奏,週二週六偏靜、週四五日偏旺;沒接住的四天裡有三天集中在哥倫布日連假,官方自己註記原因:序列裡看不到的假日事件,它無從預測;方法細節(每天早上以截至前一天為止的實際值重算)都寫在公告裡,想重現門檻不高。估計的例子則拿歷史房價與可比成交資料進去:房價欄位給出 37 萬到 47 萬美元的窄區間,在市場天數給出 24 到 148 天的寬區間,輸入裡證據多寡直接反映在區間寬度上;因為欄位數不設限又平行作答,可以一次呼叫幫整批候選物件各估一個值,再用程式排序。
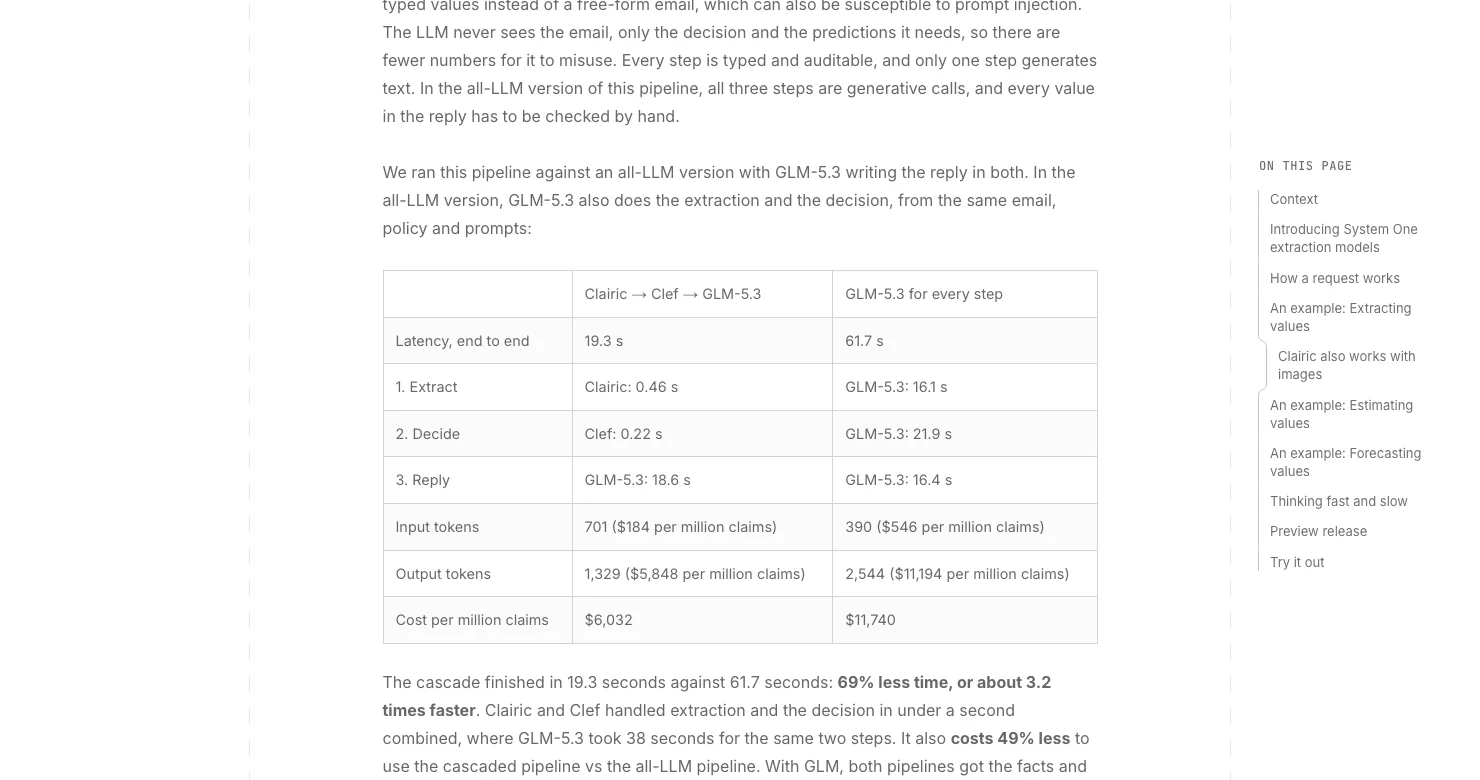
另一組是把 Clairic、Clef 與 GLM-5.3 串成三段式客服管線(抽取、決定、寫回信),跟全由 GLM-5.3 處理的版本對比。抽取一步 Clairic 花 0.46 秒、GLM-5.3 要 16.1 秒;決定一步 Clef 0.22 秒、GLM-5.3 要 21.9 秒;兩步合計不滿 1 秒對 38 秒。整條管線 19.3 秒對 61.7 秒,輸出 token 1,329 個對 2,544 個,每百萬件申請的成本 6,032 美元對 11,740 美元,省 49%。有個反直覺的細節值得單獨看:三段式讀進來的輸入 token 反而更多(701 個對 390 個),輸入側成本卻更省(每百萬件 184 對 546 美元),靠的是 Clairic 的輸入單價低;省得更多的在輸出側,每百萬件 5,848 對 11,194 美元。官方也交代了兩個版本都把事實與決定做對的前提,差別在穩定性:同樣的輸入跑三次,Clairic 給的維修估計金額三次相同,GLM-5.3 三次分別是 250、250 與 220 美元,區間也每次不同;全語言模型版換上 Gemma 4 與 Qwen 時直接失敗,連 repair_cost 這個欄位都推導不出來。這是單一場景的示範,數字可以當量級參考,愈往外推,愈要記得這是廠商替自家模型挑過的場景。
同一個示範還藏了一個安全設計值得記下:三段式裡,Clef 是看著 Clairic 抽好的幾行有型別值與退款政策做決定,不是看原始來信;寫回信的語言模型則連來信都沒見過,只拿到決定結論與需要的少數事實。示範用的政策寫得像真的維修條款:到貨 30 天內可退款,維修成本低於售價六成且不影響使用時優先維修。官方點出這個安排的另一層意義,自由文字的來信是提示注入的好載體,讓下游只碰型別值,等於把攻擊面收窄到可以先驗證的欄位;整條管線只有寫回信那一步生成文字,每一層的輸入都比上一層乾淨,而全語言模型版的三步都是生成式呼叫,回信裡每個數字都得靠人工再核一次。
公告裡最有價值的一段,反而是官方坦白現在做不到的事。多步算術還不行:一兩步的加總、差值、日期計算看起來可靠,依賴多步的長鏈計算與跨大量表格列的聚合都撐不住,官方給的機制面原因是單次運算的模型沒有草稿本可以中途記中間結果,建議的姿態是讓 Clairic 給值、算式交回程式。估計要有證據:它擅長從可比案例、歷史軌跡或輸入裡的描述文字推估,對輸入裡毫無線索的值,給出的區間幫助有限。區間標定在多數保留資料集上是校準的,但碰到不熟悉的資料可能偏窄。時間序列預測則卡在中間:傳統做法是每個指標建一條專用管線,解析、配適、調參、部署,準確但每換一個新指標就要重來一次;把三十六個月的數字貼給語言模型很省事,換來的是沒有區間的點預測、隨措辭漂移的答案。Clairic 讀歷史的方式就是你手上已經有的樣子,CSV 匯出、貼上的報表數字、混著備註的列都行,通常不用先清理,每往後一步給一個值加 80% 區間;但官方明講它不取代針對特定資料訓練的專用模型,建議用在非關鍵、一般性的型態比對,而非長期預測,定位甚至偏保守,只說比一般語言模型快一點、便宜一點。公告裡有一句值得抄下來:架構保證每個答案格式正確,不保證答案正確,要不要自動化、要不要送人工,該由 p_null 與區間寬度決定。
另外兩個時程上的未定案也要記著。模型權重官方說「即將」開放,發表當下能用的只有託管端點,想自架的人還在等;而目前部署的是早期檢查點,官方明講每個檢查點都會繼續改進算術、估計與預測,也就是說今天的表現數字有保存期限,依這個定位推論,正式環境裡今天校好的信心門檻,換檢查點後可能要重校一輪。模型文件的授權注意事項也寫得直白:用不用由你自行裁量,Cloudflare 對模型不做任何聲明、保證或擔保。名稱由來倒是說得很清楚:取 Clair de Lune 的 Clair 與預知(clairvoyance)的意象,官方另拆成 Cloudflare 的 AI Regression,一把抓準了它的本質是回歸與抽取。
判斷的軸線其實已經在前幾段浮現了。該現在試的:欄位固定、文件量大、答案要能對回原文的抽取工作,發票、收據、客服信、訂單信都在這個框裡,尤其是要拿信心分數當人工覆核閘門、或要控制每份文件成本的管線,0.10 美元的單價與「欄位多不加價」的性質直接改變成本模型。需要估計與短期預測、且能接受區間輸出的場景(從可比物件推房價、從歷史推下期數字)也值得試,前提是輸入裡真的有證據。
該等的:把抽取當開放問答用的需求(它只回答你先宣告過的欄位)、需要多步計算或跨列聚合的任務(目前明確不行)、以及等開放權重出來才要自架的團隊。還有一個務實的接法:因為輸出是有型別的值,管線裡這一步將來換回語言模型、或等權重開放後搬進自家機器,介面都不必大改,先接先用的風險主要落在檢查點更換時的行為漂移。既有的 Jev 生態已經示範過這類小而專的模型怎麼挑工作,Clairic 把同樣的邏輯搬到抽取這一側。如果要一句話收尾:先拿一條真實管線裡「請把這幾個欄位抽出來」的那一步換成 Clairic 試算,算術留在程式端、信心分數當路由,帳單與延遲的變化會比任何規格表都誠實。上述規格與數字以 2026 年 10 月 20 日的官方文件為準;開放權重釋出、定價調整或檢查點更新時,記得回官方文件重核一次。