TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

NVIDIA 與兩所大學的研究者在 arXiv 發表新評量法:重播成功解題軌跡,找出讓測試由敗轉勝的決定性步驟,在那一點用三種方式評基礎模型的後訓練潛力。十組模型的排序與後訓練 SWE-bench Verified 成績相近;直接跑完整流程的六個基礎模型有五個零分,唯一有分的那個排序還指向錯誤方向。
用 AI 摘要這篇文章:
砸下大筆後訓練成本之前,怎麼判斷哪個基礎模型值得訓?NVIDIA 與明尼蘇達大學雙城分校、加州大學柏克萊分校的 22 位研究者,10 月 7 日把論文《Before They Can Solve: Predicting Post-Training Coding-Agent Performance from Base Models》放上 arXiv(編號 2610.10478),給出的答案很具體:與其要求基礎模型從冷啟動跑完整條代理流程,不如重播一條成功解題軌跡,找出讓測試由敗轉勝的那一步,就在那一點上評量。論文送出時間是 arXiv 系統的 10 月 7 日傍晚(台北 8 日凌晨 1 時 37 分),10 月 9 日晚間由 AI 研究社群 DAIR.AI 在 X 上向開發者推薦,形容它是「a clever way to rank base checkpoints」(一種為基礎檢查點排序的聰明做法)。
這篇論文處理的決策非常實際。挑一個基礎檢查點(base checkpoint)投入代理式後訓練,算力、工程與評測成本都發生在選完之後;要看到代理能力,得先付錢。現有的兩類量法在論文裡各被戳破一次:直接上完整流程,基礎模型跑不動,因為未經調整的模型連可靠的工具呼叫格式都生不出來;退回單發短題,又把多步互動壓縮成固定提示加單一修補,避開了真正在意的核心能力,也就是在儲存庫持續演進的過程中,跨很多個使用工具的步驟維持一致狀態。DAIR.AI 那則推薦文也點到了同一件事:論文清楚記錄了基礎模型在代理式程式任務上有多難評。研究團隊的解法是換測量的位置。
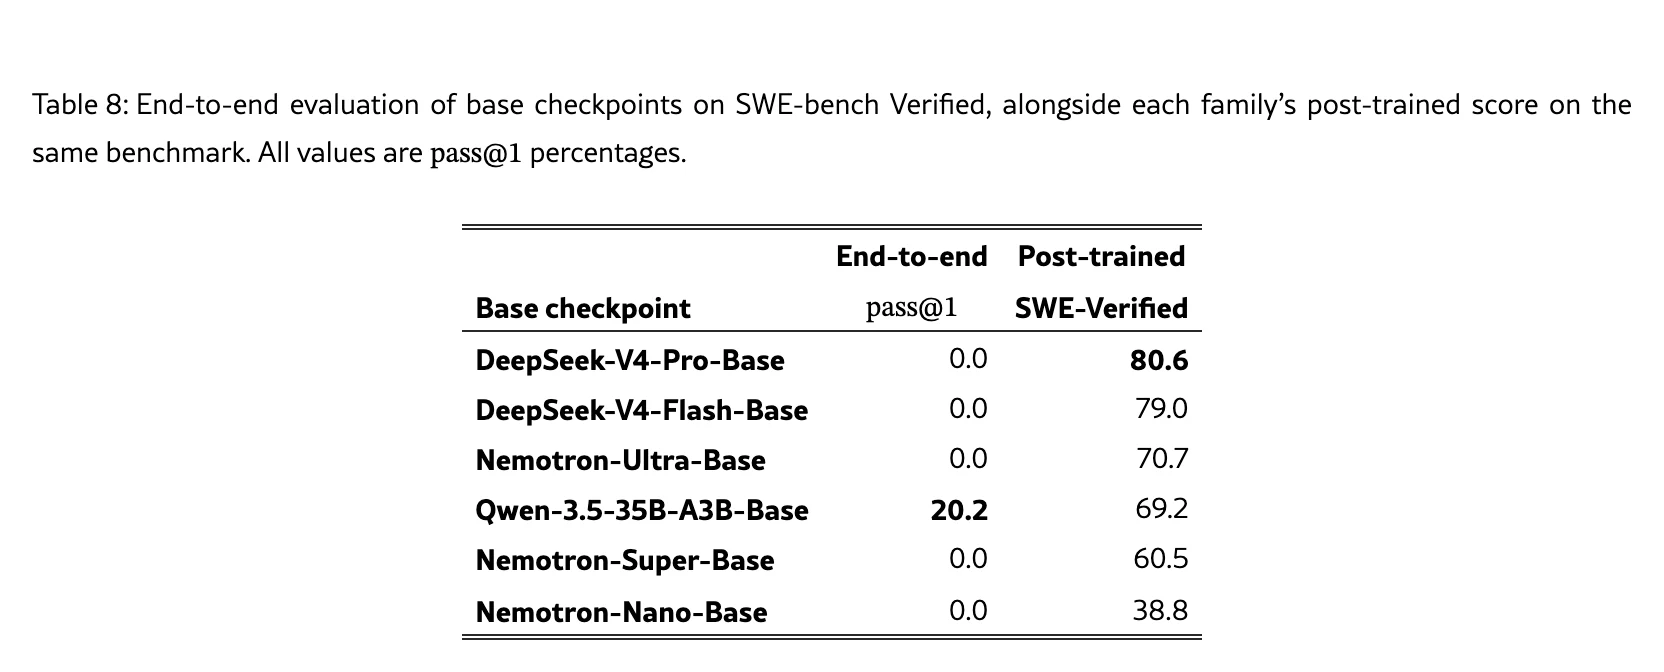
附錄裡最能說明問題的實驗,是把六個基礎模型直接放進 SWE-bench Verified 的完整代理流程,從任務描述開始驅動工具鏈,不給任何軌跡上下文。結果五個模型的 pass@1 是 0.0:DeepSeek-V4-Pro-Base、DeepSeek-V4-Flash-Base、Nemotron-Ultra-Base、Nemotron-Super-Base、Nemotron-Nano-Base 全數掛零,而這五個的後訓練版本在同一測驗上分別有 80.6、79.0、70.7、60.5、38.8 分。唯一解出題目的是 Qwen-3.5-35B-A3B-Base,20.2%,在六個基礎模型裡排最前面;但它的後訓練版本 69.2 分,在六家中排第四,落後兩個 DeepSeek V4 與 Nemotron Ultra。
作者對這個結果的措辭很直白:端到端評測在這裡並非只是缺乏訊號,在它能分辨的地方還會誤導。五個模型綁在零分地板上,等於無法排序;唯一非零的分數,把一個中等排名的家族推到最前面。團隊對 Qwen 例外的解讀也收著講:更可能反映它對代理格式互動的熟悉度,而非程式能力本身。換句話說,就算勉強跑出幾分,那個分數也接不上後訓練後的真實排序,這正是「要馬太嚴、要馬太鬆」之外的第三種困境:量得出數字,方向卻是反的。
退一步用不需代理互動的傳統程式基準來挑呢?論文附錄把六種有界程式基準對後訓練 SWE-bench Verified 成績的排名相關係數(Spearman)攤開:MBPP 是 0.091,幾乎平的;HumanEval 是 -0.394,方向反了;最強的 RepoBench XFirst 有 0.830,仍輸給三種新測法裡最弱的那個。把目標換成命令列任務的 Terminal-Bench 2.1,HumanEval 的相關再掉到 -0.571。
論文提出一個觀察角度:分數範圍壓縮。十個模型的 MBPP 分數擠在 67.2 到 86.0 之間,RepoBench XFirst 擠在 73.2 到 82.8,可後訓練目標橫跨 38.8 到 80.6。一個分數全擠在高位的測驗,排不開下游差距超過四十分的模型群。團隊也提醒這些係數是十個樣本上的描述性關聯,沒有區間估計,單列差異不該過度解讀;有界基準並非一無是處,CRUXEval-O 這種要預測程式輸出的測驗確實帶著訊號,只是整個家族裡沒有一個能事先挑出來當選模工具。
核心設計叫決定性步驟(decisive step)。團隊先讓前沿後訓練模型在 SWE-bench Verified、SWE-Pro、DeepSWE 上跑出成功軌跡(軌跡來源是 GPT-5.6-Sol、Opus-5、Kimi-K3,用 mini-swe-agent 驅動),接著逐步重播:每遇到一個改程式碼的步驟,就把到那步為止的累積修改套回儲存庫、重跑該任務的測試。第一個讓測試由失敗翻成通過的步驟,就是決定性步驟,定義寫成一行數學式:最早被驗證器接受的累積修改。
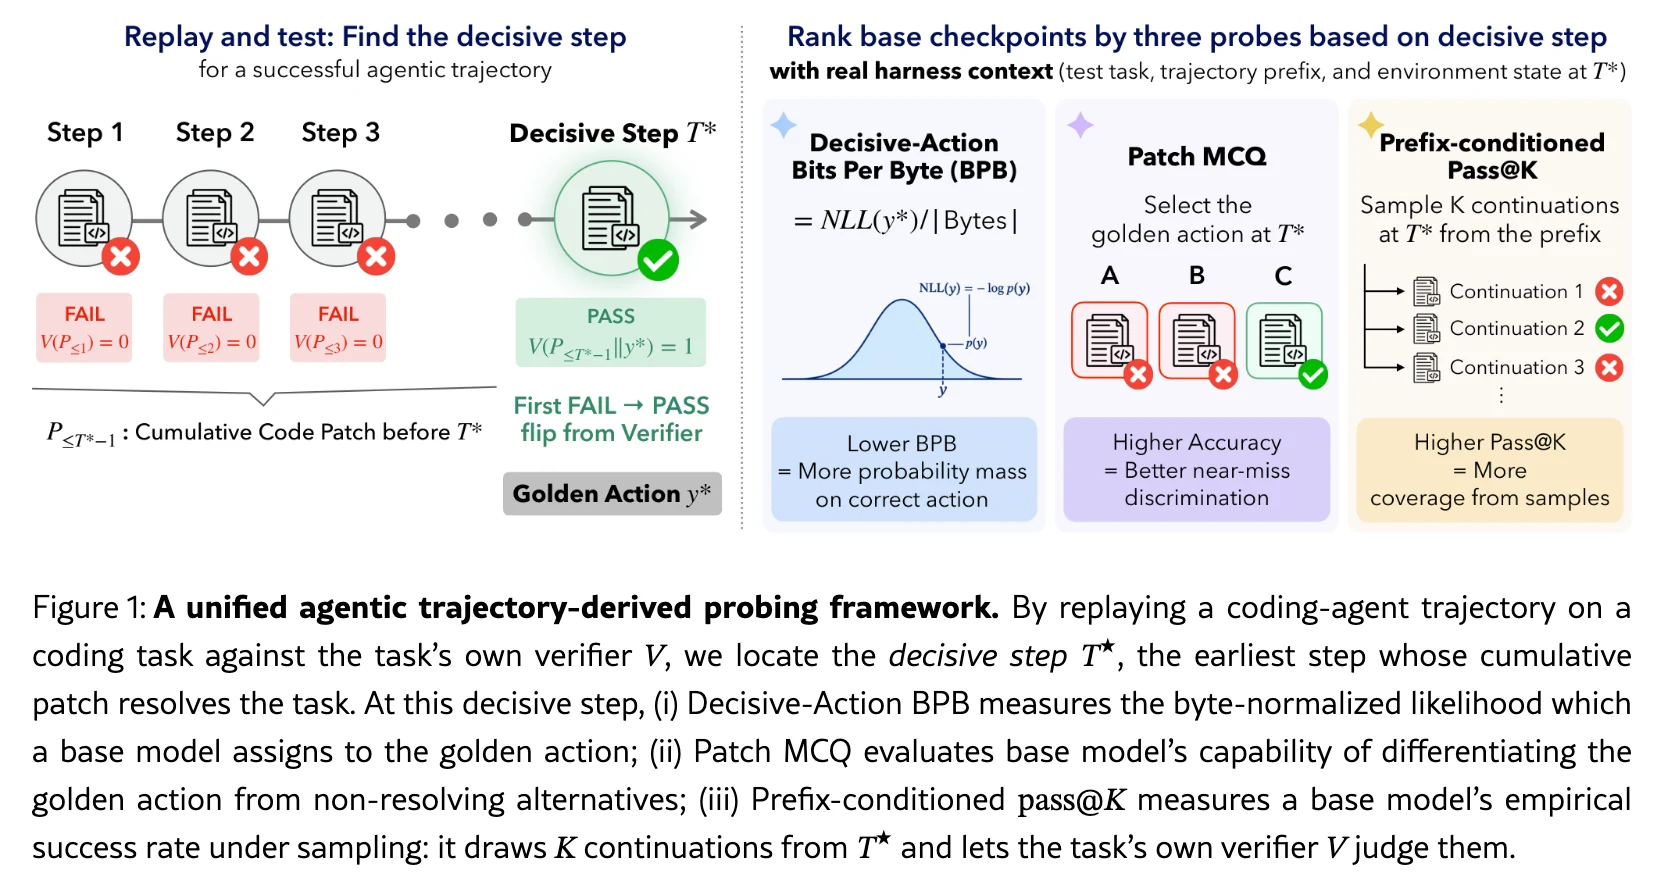
這一步上的模型動作,論文稱為 golden action,它有兩個性質。在它之前,沒有任何動作能讓測試翻盤,所以對前面步驟打分數,量到的多半是模仿軌跡產生器;在它之後的修改,可能與解題無關。與 SWE-bench 原本人工寫的參考修補相比,這個動作由真實代理產生,並被任務自己的驗證器認證。
測量點選在這裡不是憑感覺。消融實驗顯示,把 BPB 限制在決定性步驟,與下游能力的排名相關從 0.915 升到 0.964,並反轉兩組被「全步驟平均」排錯的模型對:DeepSeek V4 Flash 應在 Nemotron Ultra 之前、Kimi K2 應在 Qwen 3.5 35B 之前,兩組都與後訓練成績的方向一致。把評測對象從最終成品搬到中間產物,這種測量設計在今年 AI 研究裡並不孤單,Google DeepMind 的 Dream-RSI 把已付成本的探索歷史做成回放模擬器,走的是同一個方向。
在同一個測量點上,論文問了三個不同的問題,對應三種測法。
押注量。Decisive-Action BPB(每 byte 位元數)量基礎模型分配給 golden action 的機率有多少,分數越低越好。計算是把軌跡前綴與黃金動作接在一起做位元化的負對數似然,再除以動作的 byte 長度;用 byte 做正規化,讓採用不同分詞器的模型可以互相比。chat 模板外加的格式文字會被遮掉,避免量到模板熟悉度。研究團隊還發現遮掉工具呼叫格式的效果在 SWE-bench Verified 軌跡上特別大,論文把原因假設為:這類任務的決定性動作常出現得早,基礎模型在那之前還沒看過足夠多的工具格式範例,逐 token 的似然會突然跳升。
分辨力。Patch MCQ 給模型四選一:正確選項是 golden action,干擾項是同一位置上被驗證器拒絕的替代修改。干擾項由七個模型生成(包含 Opus-4.8、Sonnet-5、GPT-5.6-Terra、GPT-5.6-Luna、GLM-5.2、Gemini-3.7-Flash、Gemini-3.6-Flash),每一個都由驗證器實際執行過濾。評分方式是把四個選項放進同一個上下文,比答案字母(A 到 D)的下一個 token 似然,並用循環換位來壓位置偏誤。消融實驗顯示這個設計很關鍵:若改成每個選項獨立算 BPB 再挑最低,與後訓練成績的排名相關只剩 0.665 與 0.578;換成同上下文聯合評分就回升到 0.806 與 0.842,允許推理後再作答再補到 0.867 與 0.903。團隊還審計了同類前作 APTBench 的 1,682 道選擇題,找到指定正確選項其實錯誤或不唯一的題目,這正是他們堅持選項要由驗證器認證的原因。
生成力。prefix-conditioned pass@K 把決定性步驟之前的軌跡當上下文,讓基礎模型取樣 K 個續寫,任何一個能通過該任務測試的續寫都算成功;附錄另交代了把基礎模型接上代理介面的橋接做法、前進預算與 k 個續寫的驗證細節。三種測法共用同一份代理上下文與成功標準,回答的問題不同,論文強調三者互補。
受測的十組都是公開基礎模型:Nemotron-3 的 Nano、Super、Ultra 三個尺寸,Qwen-3.5-35B-A3B-Base,DeepSeek V4 的 Flash 與 Pro,Kimi-K2-Base,GLM-4.5-Air-Base,騰訊 Hy3-Preview-Base,以及 Gemma-4-26B。對應的後訓練版本在 SWE-bench Verified 上從 Nemotron-Nano 的 38.8 分排到 DeepSeek-V4-Pro 的 80.6 分,差距超過四十分,中間有 Kimi-K2-Thinking 的 71.3、Hy3 的 78.0 等。三種測法在這十組上排出的順序,都與這份成績單相近。這裡的三個測驗家族先定位一下:SWE-bench Verified 是人工驗證過的儲存庫議題集,SWE-bench Multilingual 把同樣形式擴到九種程式語言、41 個儲存庫,DeepSWE 用原創多語言任務配上專門打造的驗證器。
成績單裡有個反直覺的細節:用 DeepSWE 軌跡做的測法,比用 SWE-bench Verified 自己的軌跡還要準。DeepSWE 版的排名相關是 0.964、0.867、0.951,同基準版只有 0.915、0.903、0.906,只有 Patch MCQ 從同基準匹配佔到便宜。來源與目標同測驗並沒有買到更高的一致性;要解釋這組數字,「模型剛好記得同一份測驗的細節」說不通,量到的東西必須是跨測驗一致的解題傾向。
換目標再看一次。對 SWE-bench Multilingual,三個數字升到 0.976、0.927、0.945,第一個還是全部九種組合裡最高的;換到 Terminal-Bench 2.1,兩種靜態測法掉到 0.833 與 0.796,取樣型的 pass@K 守在 0.930。論文把落差歸因於 Kimi K2 與 Gemma 4 26B 這兩個模型在兩種測驗上的排序本來就不同:Kimi K2 的後訓練版在 SWE-bench Verified 排第四,在 Terminal-Bench 掉到第八;測法跟著 SWE 那一邊的視角走。要吃到命令列任務的排序,論文的建議是把好幾種任務家族的軌跡來源加總。
取樣預算也有甜蜜點。DeepSWE 版在 K=8 時 0.915,K=16 升到 0.952 之後就持平;同基準版在 K=8 與 K=16 都有 0.988,K=32 反而掉到 0.906,因為通過率逼近飽和(最高 83.7%),兩個模型的分數咬在一起。開大取樣預算不會單調變好,K=16 已接近可得上限。成本結構論文也有交代:軌跡收集與驗證器執行是每份軌跡語料跑一次的前置成本,之後每個檢查點只需跑探測本身;整條管線的瓶頸在驗證器執行,模型前向傳播反而是便宜的那端,所以找決定性步驟用二分法、取樣路徑把前綴快取起來。
幾個邊界要先知道。十個下游目標分數來自各實驗室各自的訓練配方與評測環境,比較並未控制;團隊為此把 Nemotron-3-Nano、Nemotron-3-Super、Qwen-3.5-35B-A3B 三個基礎模型用同一份 SFT 配方重訓(內部語料、1,000 步、16.8B 訓練 token),三個重訓版在 SWE-bench Verified 上拿到 28.5、53.1、61.2 分,排序與公開版發布一致;以 SWE-Pro 軌跡計算時,三種測法也排出同樣的順序,換其他軌跡來源時部分測法的一致性會減弱。論文把這段讀成趨勢延續,不是精準估計。方法的輸入依賴前沿後訓練模型的成功軌跡與該測驗的驗證器,論文宣稱只要有這兩樣,未來任何代理式程式測驗都能轉成基礎模型評量;這句話目前只有該論文的十組證據支持。v1 全文沒有附程式碼或 artifact 連結,想採用的團隊得照論文自建管線,開源社群能否像整數乘法研究那樣接力重現,是值得追蹤的後續看點。NVIDIA 今年把內部工程實踐陸續公開,從 CUDA Rust 的兩條記憶體安全軌到這次的研究評量方法,都是先內部使用再對外說明的節奏。
理論根據也要分清楚。方法掛的「覆蓋原則」,講的是後訓練主要在放大基礎模型已經取樣得出的行為,這個結論引自既有研究,論文的貢獻在把探測點落到驗證器認證的那一步,做出可操作的三種測法。
對要在開放權重模型上做後訓練的團隊,這篇論文給的像一份選秀會前的體測報告:排序參考,而非選擇保證。相關不等於因果,取樣預算開到 16 就夠,換任務家族時優先看取樣型測法的數字;若團隊自己的任務長得跟儲存庫議題不像,從 Terminal-Bench 的落差看,得先確認軌跡來源跟自己的任務夠接近,再談採用。這份研究目前只停在 v1:沒有程式碼、沒有 artifact、十組模型、描述性關聯。若未來出現修訂版或第三方重現,數字與結論都需要重新核對。在這之前,它是把「值不值得訓」這個問題變得可量測的認真嘗試。