TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Luxirty Search 是把內容農場擋在結果外的開源 Google 搜尋前端,csdn.net、抖音、百度智慧雲整域排除;官方網址如今轉進賭博站,但引擎配置仍在作者帳戶運作,把原始碼跑起來就能完整復活,實測過濾與 For Program 提權都健在。
用 AI 摘要這篇文章:
最急的問題先說結論:Luxirty Search 的官網死了,而且死得難看。2026 年 10 月初打開 search.luxirty.com,迎接你的已經換成一個印尼文的線上老虎機網站;按下搜尋跑出的則是伺服器的 404 頁。但這個曾以「幫你把內容農場從搜尋結果裡剔除」打出名號的開源專案,功能本身其實還活著,而且把它救活只要三個指令。這篇把我實際驗屍、實際把它的原始碼跑起來之後看到的事情攤開,你看完可以自己決定要不要收留它。
我用了兩種方式確認這件事,避免把暫時性的伺服器問題誤判成死亡。第一次用命令列工具帶著一般瀏覽器的身分造訪,第二次用真的 Chromium 瀏覽器載入,兩次結果一致:根路徑連得通,但頁面已經落在 qq.ryesoccer.org 這個網址上,標題寫著印尼文的賭博宣傳語。直接訪問搜尋頁 search.luxirty.com/search 則是 nginx 伺服器的 404 預設頁,連作者部落格的介紹頁也一樣是 404。
幾個旁證把「暫時故障」的可能性排除了。這個網域的 DNS 仍然指向 Cloudflare 的伺服器,代表域名本身沒有被丟棄或被搶註,是後面的服務被換掉了。網頁歷史檔案庫對這個站留有快照紀錄,最後一筆停在 2025 年 12 月中,當時官網還一切正常,這表示淪陷發生在其後的某個時間點;至於被誰、用什麼方式接管,從外部已無從考據,可以確定的只有 2026 年 10 月 4 日這天的現況。對讀者來說有一件立刻該做的事:如果你在其他網站看過舊的分享連結,別再點,那條路現在通往賭博站。
要判斷這工具死透了沒,得先弄清楚它到底由哪些部分組成。Luxirty Search 常被介紹成「基於 Google 開源引擎」的搜尋引擎,這個說法拆開來看只對了一半。它真正使用的引擎是 Google 可程式化搜尋引擎(Google Programmable Search Engine,簡稱 CSE),那是 Google 自家的閉源託管服務,一般網站主拿來做自己站的站內搜尋;開源的部分只有這層前端介面,以 AGPL-3.0 授權放在 GitHub 上,本體是一個不大的 Vue 3 加 Vite 專案。
過濾是怎麼發生的?作者在 README 的說明是:透過 CSE 的 Annotations 功能設定屏蔽名單,讓 Google 在伺服器端執行搜尋時就把那些網域排除,效果等同於你每次搜尋都自動附上一串減號語法。這和 uBlacklist 這類瀏覽器擴充的路線不同:擴充是等垃圾結果載入到你的畫面上再把它藏起來,Luxirty 是結果根本不出爐。代價在於那些屏蔽設定不在原始碼裡,而是住在作者的 Google 帳戶後台。專案倉庫裡附的屏蔽清單文件只有十七條規則,csdn.net、抖音、百度智慧雲這些是整個網域屏蔽,華為雲與騰訊雲開發者社群則是封了特定分區,但作者自己承認完整的屏蔽名單其實散在 issue 討論串裡,原本計畫用自動化流程生成 Annotations,一直沒有做。
這裡藏著整個故事最關鍵的一行程式碼:這個專案把作者的引擎編號(CSE 的 cx 值)直接寫死在版本庫的環境變數檔裡。意思是你把它跑起來的那一刻,用的就是作者帳戶裡那套完整的屏蔽與權重配置,什麼都不用設定。這解釋了為什麼官網死了它卻還有得救,也埋下了唯一的單點風險:哪天作者的 Google 帳戶把這顆引擎停用,所有自架的人會一起失效。
復活的步驟樸素到有點好笑。把專案從 GitHub 複製下來,進資料夾裝相依套件,再跑起開發伺服器,整串就是三個指令:
git clone https://github.com/KoriIku/luxirty-search.git
cd luxirty-search && npm install
npm run dev
前置需求只有一項:機器上有 Node.js。相依套件裝完後,終端機會印出本機網址(vite 預設是 5173 埠),瀏覽器打開就是那個熟悉的極簡搜尋頁。我在自己的機器上計時,服務起來只花了 269 毫秒,這種量級的反應速度對 Vue 加 Vite 的純前端專案來說是常態,沒有後端要暖機。
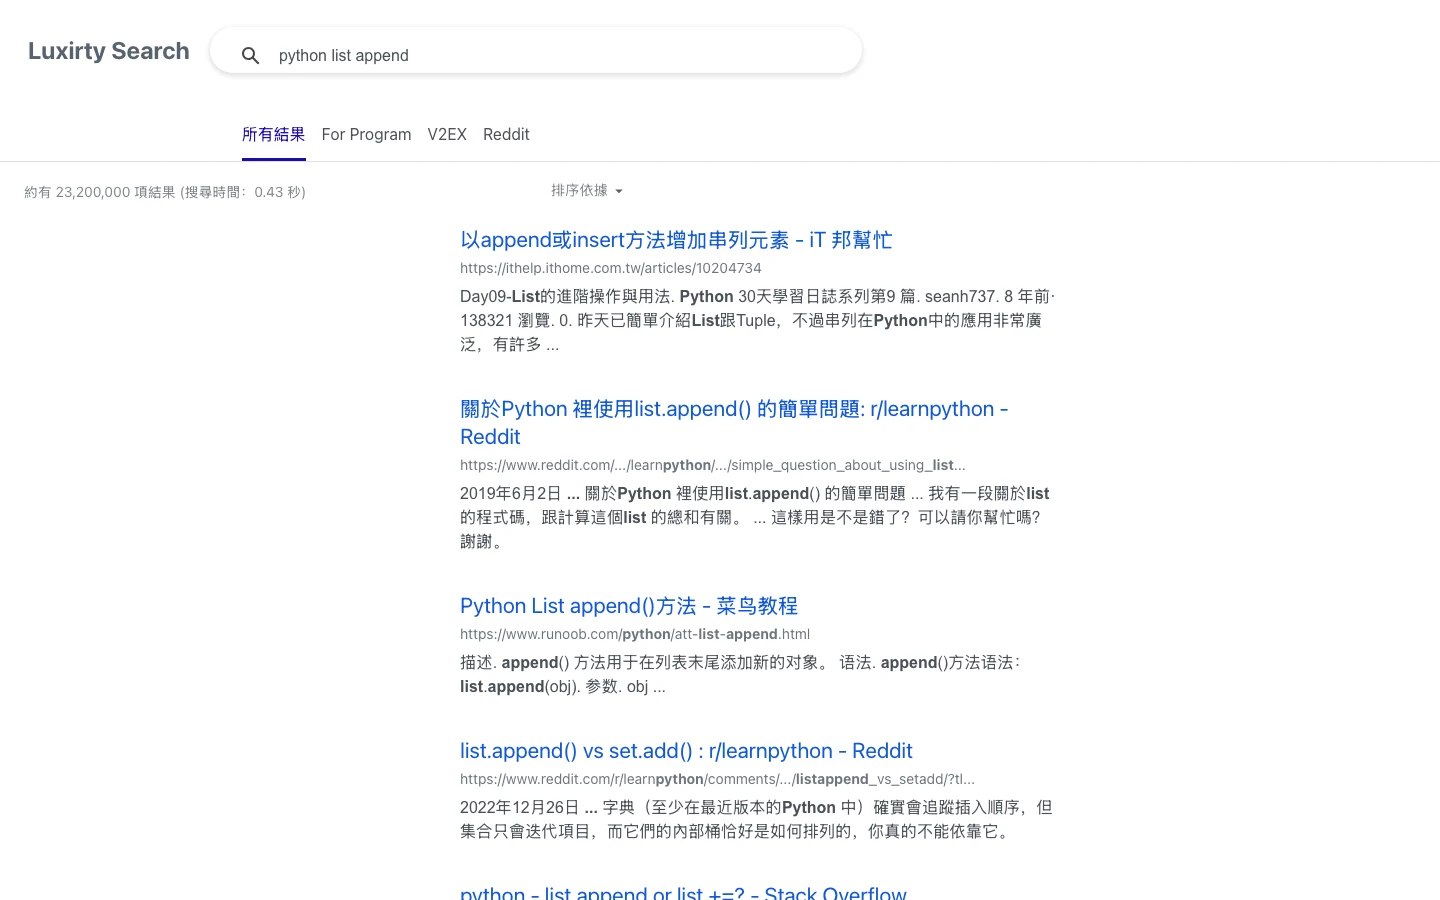
搜尋功能是不是真的活著?我丟了一組很容易長出內容農場的關鍵字:python list append。這種程式入門查詢在一般的中文 Google 結果裡,CSDN 和各家抄搬站通常會佔掉大半版面。實測結果,頁面顯示「約有 23,200,000 項結果(搜尋時間:0.43 秒)」,第一頁十筆全部落在 iT 邦幫忙、Reddit、Stack Overflow、runoob、W3Schools、Medium、Python 官方文件這些來源上,屏蔽名單上的任何網域一次都沒出現。過濾功能確定還在運作,而且是在作者的 Google 帳戶那端運作。
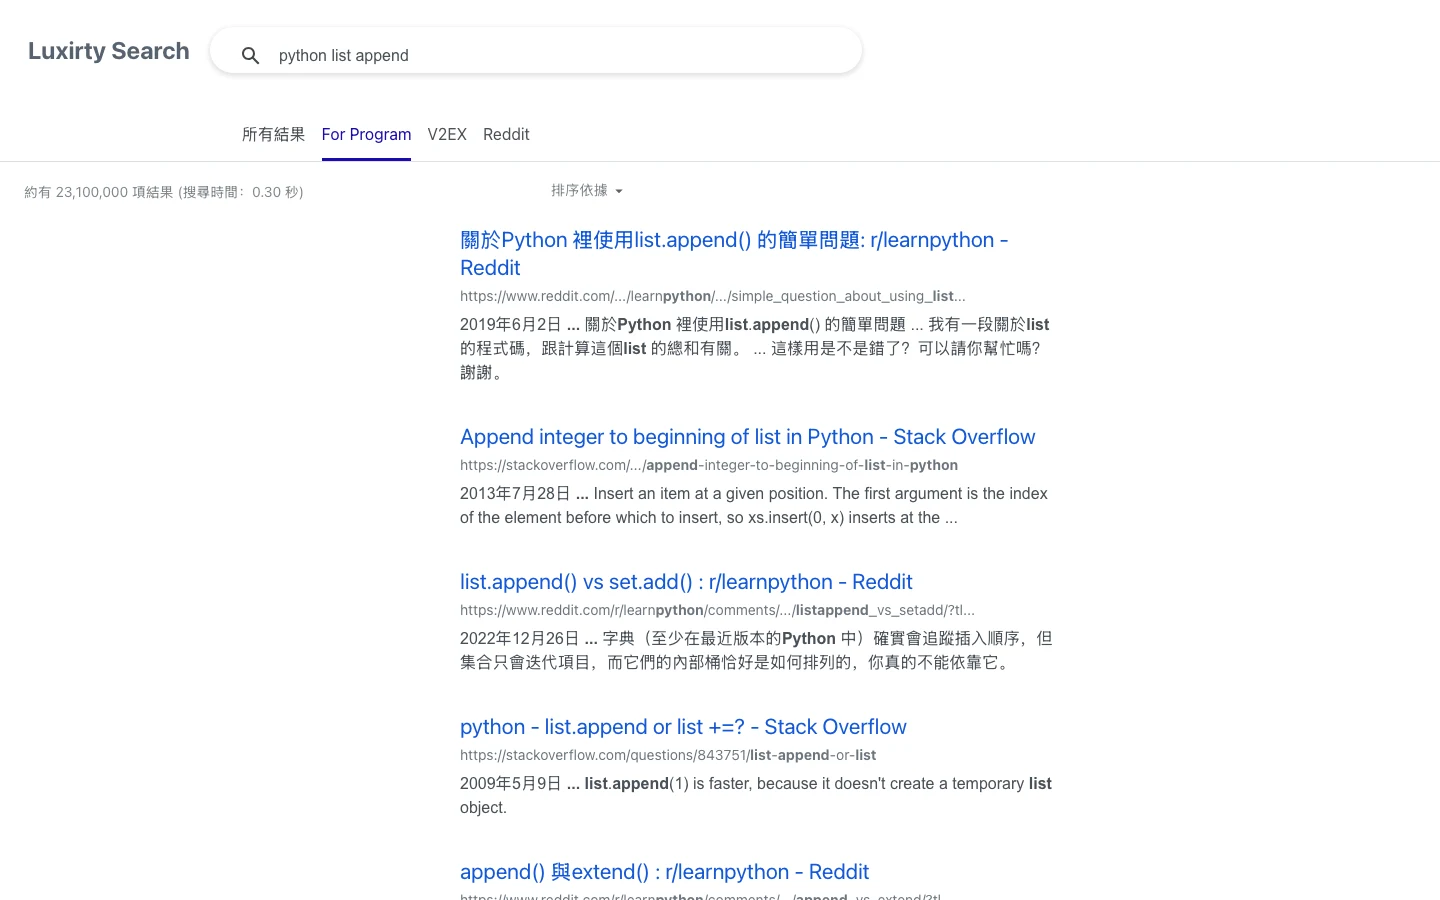
結果頁上方那排作者引以為傲的標籤也完好:所有結果、For Program、V2EX、Reddit 四個切換鈕都在。我點了 For Program 驗證提權是不是真的:切過去之後結果從十筆變成十七筆,GitHub 上的一個技術文件頁擠了進來,Stack Overflow 佔到六筆,我實測的那一輪,原本在前十的 Medium 文章也被擠了出去。權重調整這個賣點不是裝飾品。對會頻繁下減號語法、手打 site: 限定範圍的開發者來說,一鍵切換確實省事。
另外兩個標籤走的是站內限定的邏輯:V2EX 標籤把查詢範圍收縮到那個技術討論站,Reddit 標籤收縮到 Reddit。實際點開看,這組功能對「想看真人討論而不是官方文件」的查詢很好用,例如查某個服務的實際評價時切到 Reddit 標籤,出來的就不會是公關稿與 SEO 文章。這也是它與一般搜尋器最不一樣的使用姿態:把「去哪個社群問」這個動作從開新分頁貼 site: 語法,縮成點一下標籤。
用一輪之後還會注意到兩個小細節。結果頁的自動補全在頁內搜尋框是正常的,打字時會浮出建議字詞;翻頁用的是結果區底端的下一頁按鈕,每頁十筆的節奏與 Google 相同,想一次看幾百筆的捷徑(直接在網址加每頁筆數參數)在這套元件上沒有開放出來,專案 issue 裡有人提過這個需求,至今沒有實作。
不想在本機跑開發伺服器的人有兩條替代路。Docker 的一行部署仍然是通的,映像檔在 ghcr.io 上最新版還拉得到(2026 年 10 月 4 日驗證),容器裡用的是 nginx 服務靜態檔案,跑起來就是正式版配置,比開發模式更適合長期掛著。README 裡另附 Vercel 與 Netlify 的一鍵部署按鈕,不過有個先潑冷水的細節:Vercel 按鈕內嵌的專案網址把 luxirty 拼成了 luxiry,少一個字母,頁尾的 GitHub 連結也是同樣的拼錯。這顆按鈕能不能一鍵成功我不敢替你保證,想走這條路就先手動把網址改對。
還有一條進階路:完全不依賴作者的引擎,自建一顆屬於自己的 Google 可程式化搜尋引擎。把環境變數 VITE_GOOGLE_CSE_CX 換成自己申請的引擎編號就能抽換,但 README 講得很明白,代價是所有過濾配置要自己重來:先到 Google 的引擎管理頁建立 CSE、把想屏蔽的網域加進去,再手動設定 For Program 這類最佳化標籤並把優先網域掛到標籤上,工程性質接近重新布置一遍。前面提過倉庫裡的十七條規則只是文件殘本,真要把完整名單搬過來,得到專案的 issue 討論串裡撈。對多數人而言,直接沿用寫死的作者引擎是務實選擇,反正它現在活著、過濾力也實測過;自建路線留給想掌控全部配置、或擔心作者哪天收引擎的人。
無廣告這件事,在自架環境裡我驗證是成立的:結果頁從頭到尾沒有任何廣告區塊。無追蹤的成色要說得更精確。我把整個搜尋過程的對外連線全部錄下來清點,除了本機伺服器,請求只去了四個 Google 自家的網域(載入引擎元件、執行查詢、縮圖與自動補全),沒有任何統計腳本、沒有廣告聯播、沒有第三方字型或分析服務。另外它的程式碼裡有一段誠實的小功夫:搜尋結果渲染完成後,自動把結果連結上的兩個點擊追蹤屬性拿掉,你複製出來的網址就是乾淨的原始連結。
不過把「無追蹤」理解成隱私搜尋引擎就過頭了。你輸入的每個查詢都交給了 Google 的 CSE 服務去執行,這是它架構上的必然。它做到的是把 Google 搜尋頁面周邊的雜訊清乾淨:沒有廣告、沒有第三方腳本、結果連結不帶追蹤參數。想要真正不把查詢交給任何大廠的人,該看的是另外的路線,這篇文章結尾會給你方向。
它有三個寫在 README 裡、開發者自己承認幾乎不可能解的限制:設成瀏覽器預設引擎後,網址列的搜尋建議會失效(頁內的補全正常);無法用時間條件篩選結果;沒有同義詞擴展,你的用詞和文章的用詞對不上時,結果會明顯比 Google 官方站少。這三條都源自 Google CSE 這個引擎本身的產品邊界,不是作者偷懶。實際用起來最扎手的應該是第二條,查「這兩年的」什麼東西時會很想念時間篩選。
維護狀態是另一個要睜眼看的事實。專案在 GitHub 上累積了 1,680 顆星,但主要分支的最後一次合併停在 2024 年 12 月,到今天凍結了接近兩年。README 裡列的未來計畫(攔截特定標題的農場文、自動載入下一頁)都停在計畫;2025 年之後的 issue 基本上沒有人處理,有人反映字體太細、有人問怎麼讓每頁結果多一點,都還掛著。順帶一提,也有中國大陸網友反映過用不了,這不意外,引擎在 Google 那邊,Google 到不了就全到不了;台灣的連線環境我實測全程暢通。
所以救活之後拿到的東西,正確的期望值是:一台功能完整、過濾力有實證、畫面乾淨的搜尋前端,但上游不再保養,能力的上限由 Google CSE 畫線,而且心臟還在別人帳戶裡跳。適合收留它的人也很明確:平常查技術文件被內容農場弄到煩、願意花十分鐘跑個本機服務或 Docker 容器、並且能接受查詢還是交給 Google 的人。如果你的需求只是讀一般網頁時少看到農場結果,裝個 uBlacklist 類的瀏覽器擴充反而省事,安裝一次全站生效;想要徹底不依賴 Google 的查詢路線,可以看我們先前寫過的 Scira 與 Gemini Search;想了解 CSDN 相關的瀏覽器腳本生態,這篇有整理。另外,免費網路服務說斷就斷的形態我們不是第一次見,HumanizeAI 那篇記錄了另一種死法,對照著看會更有感覺。
最後一個務實的提醒:真要自架,別沿用官方網址列的那條 opensearch 描述檔,它寫死的還是已經淪陷的舊網域,問題的修法在專案的 issue 裡有討論。把它跑起來、掛在自己控制的網址下,這顆 1,680 星的過濾器就又是你的了。至於那個被賭博站佔據的官方網址,就當它替整個專案上了最後一課:開源工具的壽命不由官網的存亡決定,程式碼在哪裡活著,工具就在哪裡活著。