TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
Fast-Powerful-Whisper-AI-Services-API 用 Apache-2.0 開源授權把 Whisper 包成可自架的轉錄服務,轉錄推理全在本機,但部署實測卡在 Windows 專屬依賴,服務出廠也沒有金鑰驗證。
用 AI 摘要這篇文章:
把 Fast-Powerful-Whisper-AI-Services-API 的依賴清單交給 pip,它在碰到任何一個 Whisper 模型之前,就先倒在一個 Windows 專屬的套件上。我在 macOS 上實際跑了一次安裝解析,pip 停在第 63 行,輸出只有一句話:ERROR: Could not find a version that satisfies the requirement pywin32==308 (from versions: none)。這個在 GitHub 上有 474 顆星、以 Apache-2.0 授權開源的語音轉錄 API 專案,宣稱讓你不必購買 Whisper API、用自己機器上的模型做推理,這部分我翻遍程式碼後確認是真的;但它省下的帳單,換成了環境工程、安全設定與長期維運三種責任,而且每一種都比 README 呈現的樣子重。
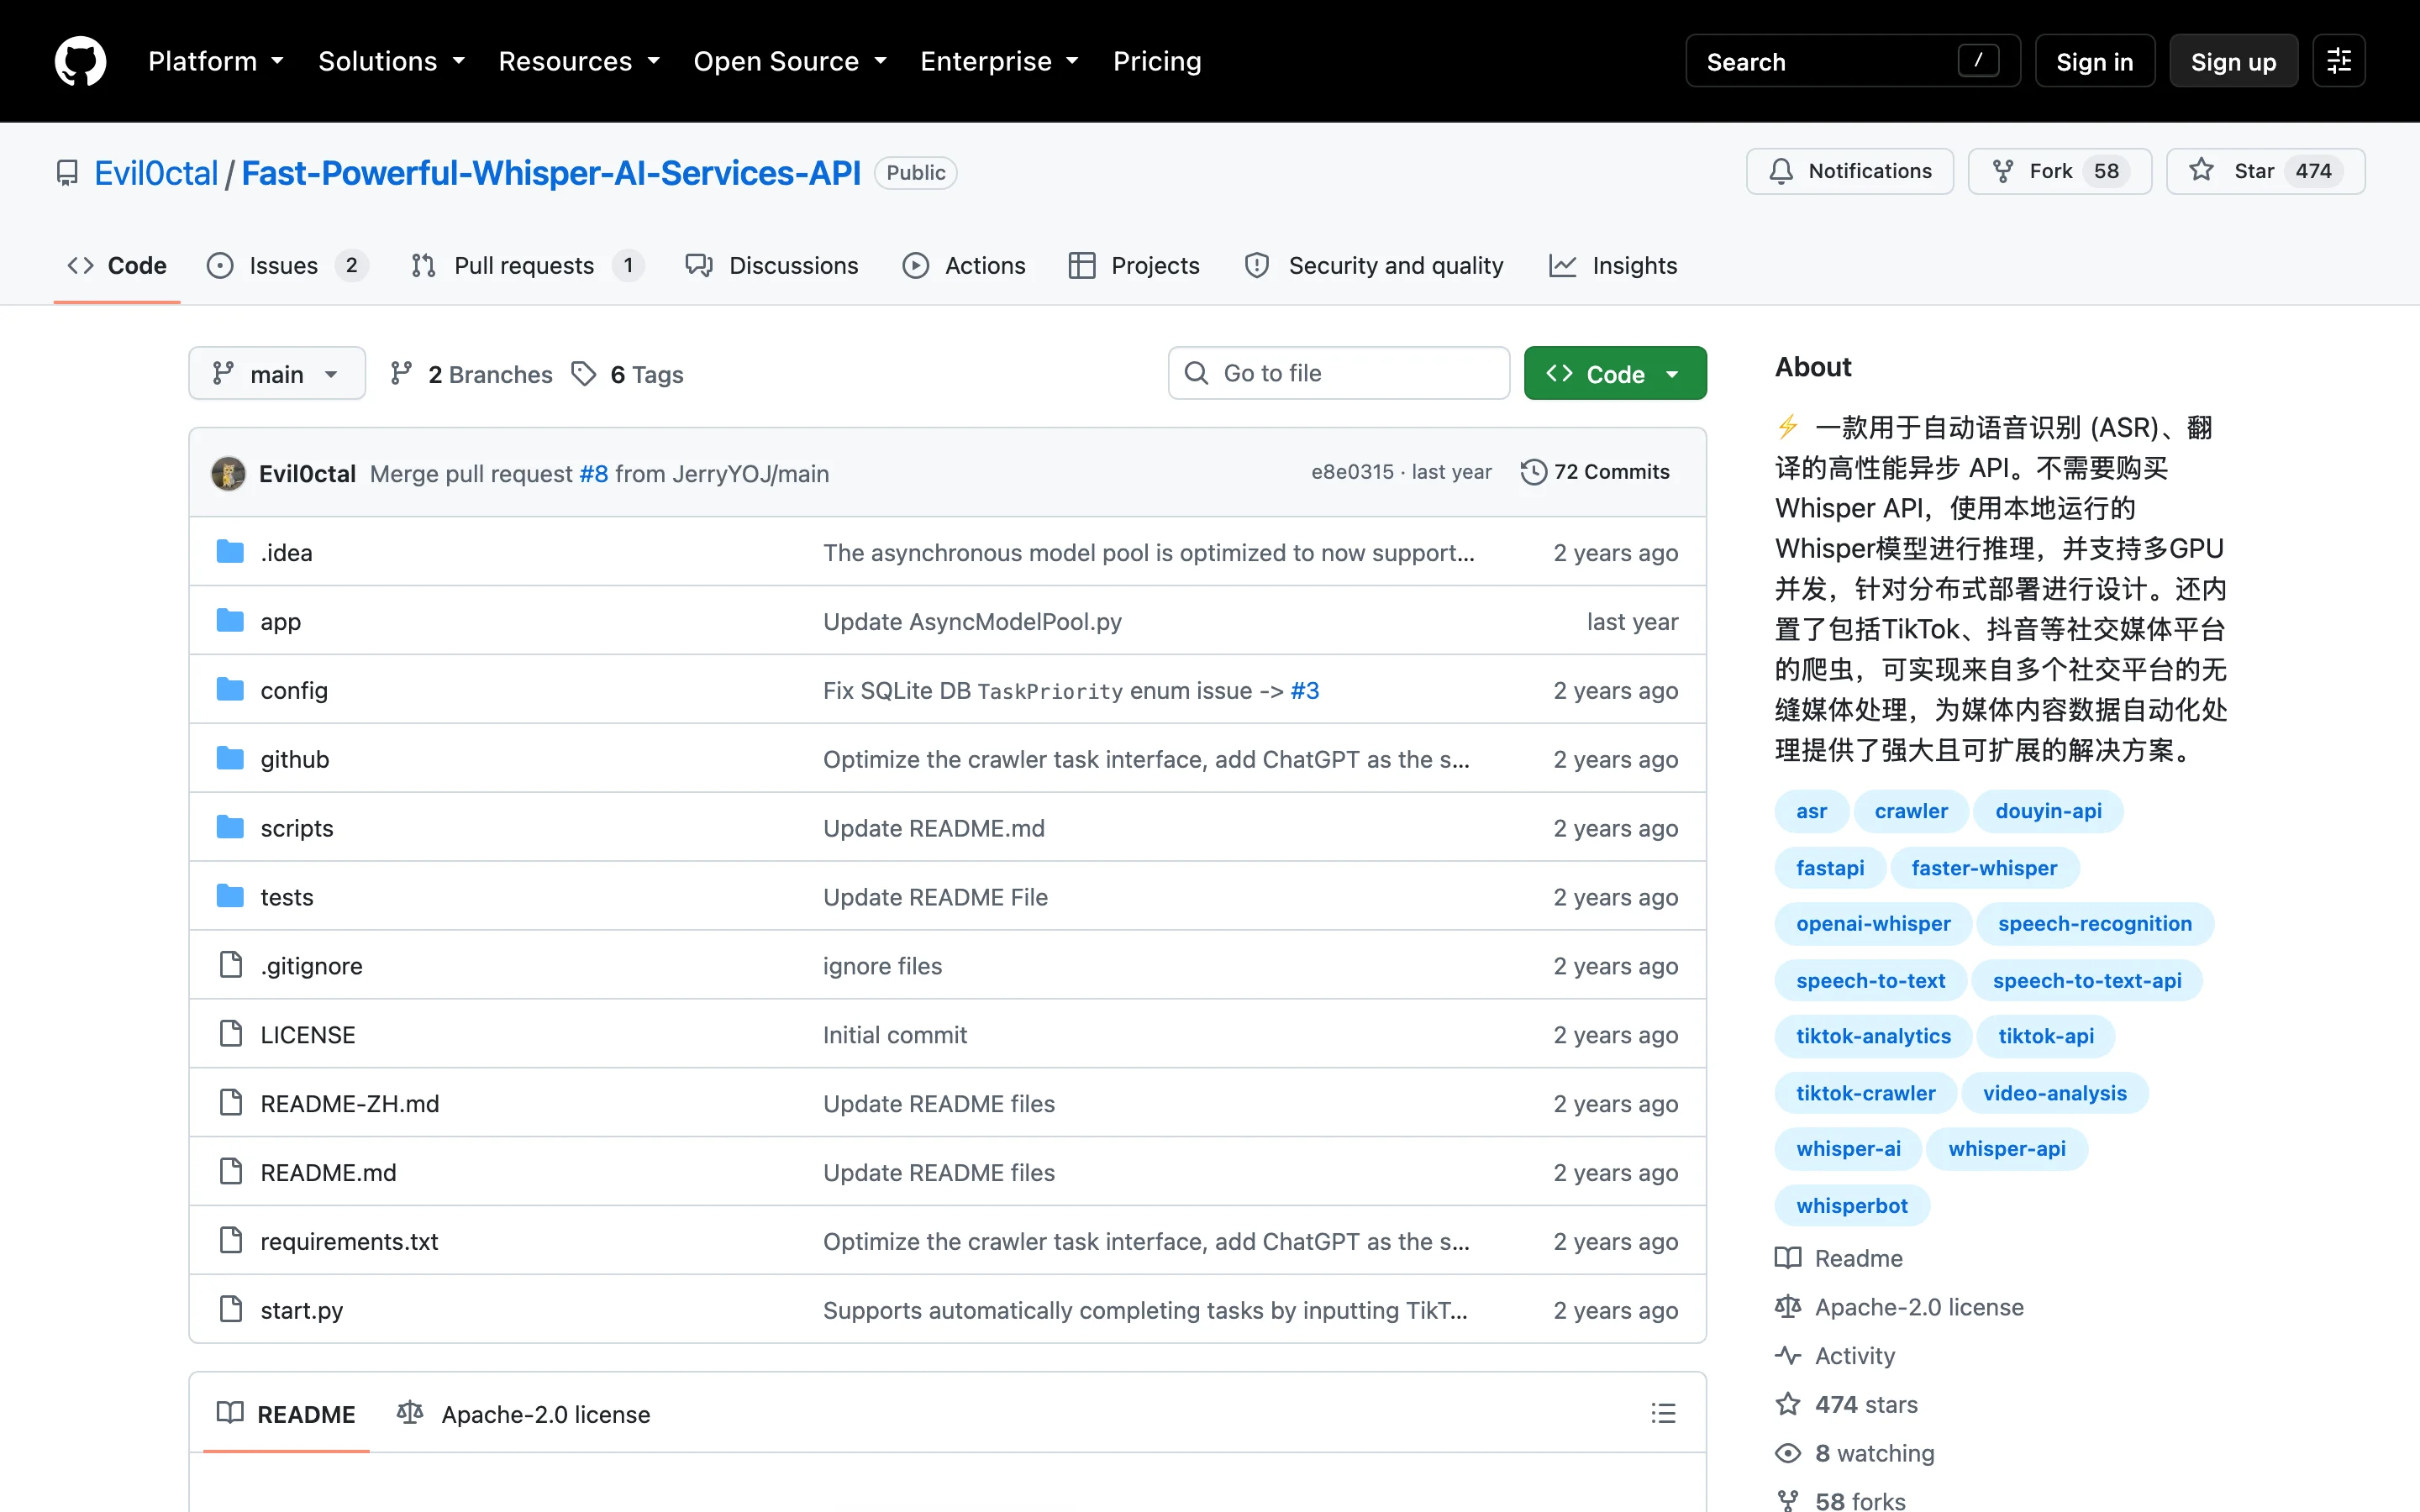
先講結論給趕時間的人:轉錄推理全程在本機這件事,程式碼層完全成立,授權也乾淨;但部署路徑被一份 2024 年 11 月的依賴鎖定檔實質綁在 Windows 加 Python 3.8 到 3.12 的組合上,服務出廠設定直接綁 0.0.0.0 的 80 連接埠而且全程沒有任何金鑰驗證,主要分支也超過 15 個月沒有新的程式碼提交。它適合有 NVIDIA 顯示卡、願意自己改設定檔的開發者;想要一鍵自架的人會在第一天就想離開。
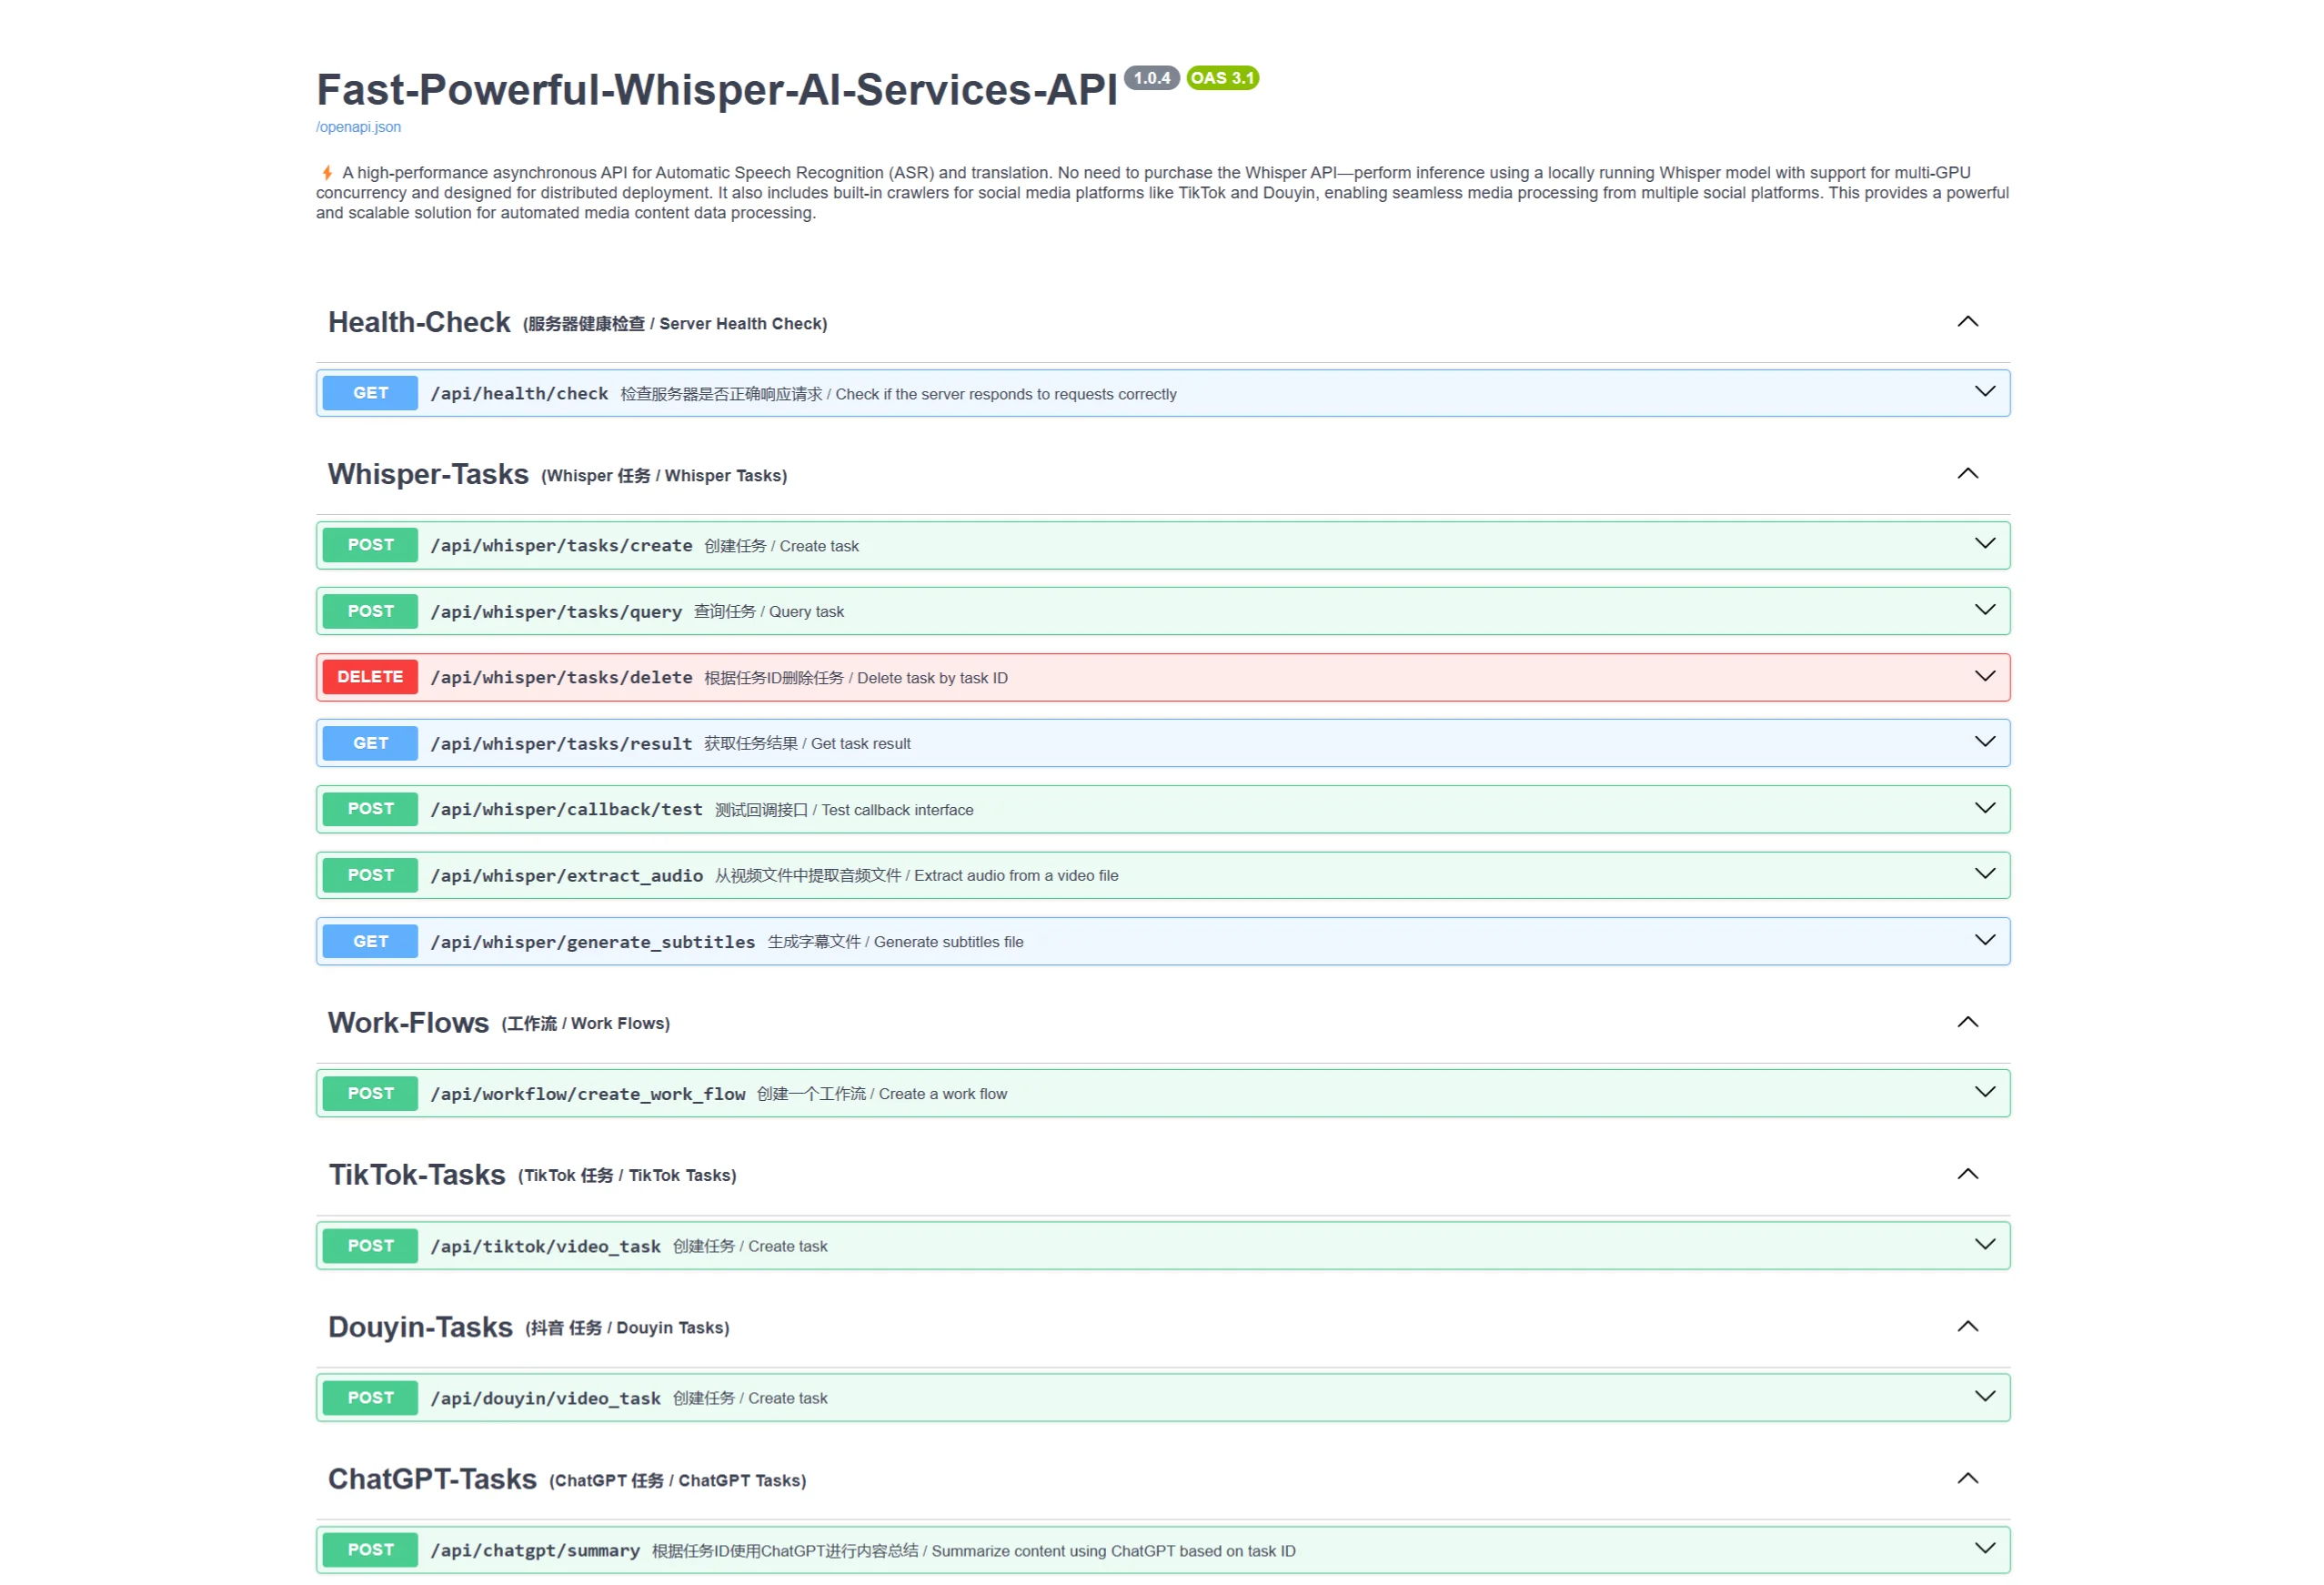
Fast-Powerful-Whisper-AI-Services-API 是中國開發者 Evil0ctal 的作品,用 Python 的 FastAPI 框架把 OpenAI Whisper 包成一個可以自己架的轉錄服務。使用流程是這樣:你上傳媒體檔案或給它一個檔案網址,服務把任務丟進佇列,背景的模型池用 Whisper 做語音辨識,完成後可以透過 API 拿結果,或直接產出 srt 與 vtt 兩種字幕檔。它同時支援轉錄與翻譯兩種任務類型,可以設定優先順序,也能指定完成後把結果 POST 到你自己的通知網址。
實際呼叫的介面很單純:對建立任務的端點送請求,來源二選一,上傳檔案或給一段檔案網址,再帶上任務類型與優先序。想盯完成的話填一個通知網址,服務處理完會主動把結果 POST 過去,不必反覆輪詢。這種設計對要把轉錄接進自動化流程的人真正有用,例如每晚批次處理當天的會議錄音,或是掛在影片上傳流程後面自動出字幕。
我特別去驗證「本地推理」這個宣稱。設定檔裡的引擎清單只有兩個選項:原生的 openai_whisper 與走 CTranslate2 加速的 faster_whisper,預設使用 faster_whisper 搭配 large-v3 模型。整個任務處理鏈從音檔提取、模型推理到結果寫入資料庫,全部落在本機程序裡;我把路由層的程式碼掃過一遍,不存在任何把音檔送給外部語音辨識服務的呼叫。換句話說,只要你不主動開啟後面會提到的 ChatGPT 摘要功能,你的音檔內容不會因為轉錄這件事離開你的機器。上傳檔案有 2GB 上限,暫存檔在處理完成後預設自動刪除,這兩個預設值對隱私是加分的。
和官方路線的差異在成本結構。OpenAI 的 Whisper API 按音檔分鐘數計費,你付出的是帳單;自己架這套,你付出的是一張能跑 large-v3 的顯示卡(作者自己的測試環境是一張 RTX 4060 筆電版顯示卡)、第一次跑要下載的模型檔,以及後面所有環境維護工。作者提供的效能數字是:large-v3 模型、39 秒的影片、連續丟 5 個任務,全部在 32 秒內處理完成。這是作者在 README 提供的量測數字,參考數量級即可;實際速度取決於你手上的顯示卡,我沒有實測。
架構上有幾個設計值得單獨講。整個服務走生產者消費者模型:API 層收任務,背景的非同步模型池消費任務,池子大小、每張顯示卡能掛幾個模型實例都可以在設定檔調。要注意一個誠實的限制:作者在文件裡明說,單張顯示卡的環境拿不到平行處理,模型池的平行處理是給多 GPU 部署用的;只有一張卡的人,別期待同時丟十個任務會變快。推理參數的開放程度倒是少見地完整,從語言、溫度、無語音門檻到字級時間戳記共 11 項都能在建任務時指定,等於把 Whisper 原生的解碼參數原汁原味暴露出來。資料庫支援 SQLite 與 MySQL 兩種,單機跑用 SQLite 零設定,要多節點共享任務佇列就換 MySQL,這條分散式的路有鋪,但目前只走到資料庫層,文件裡的 Kafka 整合與工作流系統都還是願景。
介面語言要適應一下:它的 API 文件與文案是簡體中文加英文雙語,沒有繁體中文。 Swagger 文件頁本身好用,端點描述、參數說明都算清楚,但看慣繁體的人讀起來會有隔閡,issue 討論區也全是大陸簡體語境,遇到問題上 GitHub 找答案時要有心理準備。
README 的快速部署寫了 8 個步驟:複製專案、準備 Python、裝 FFmpeg、裝 CUDA、裝支援 CUDA 的 PyTorch、安裝依賴、改設定、啟動。照著做到第 6 步,問題來了。我在 macOS 上把那份依賴清單交給 pip 解析,解析器碰到的第一個障礙就是前面提到的 pywin32:這個套件在 PyPI 上只提供 Windows 的安裝包,macOS 與 Linux 上根本不存在可安裝的版本,而鎖定檔裡這一行沒有任何作業系統標記。這不是我的環境怪異,是清單本身的問題。
就算你想繞過 pywin32 手動刪掉那一行,還有第二道牆。清單把處理影音串流的 av 套件釘在 12.3.0 版,這個版本在 PyPI 上的現成安裝包只出到 Python 3.12。我用 Python 3.14 再跑一次解析,pip 告訴我得從原始碼編譯,而編譯的前提是系統裝好 pkg-config 與 FFmpeg 的開發檔頭。也就是說,就算作業系統對了,裝了新版 Python 的人照樣會卡住。兩道牆疊起來,實際能走的路收斂到一個很窄的組合:Windows 搭配 Python 3.8 到 3.12。這個結論停在依賴解析層;Windows 加 Python 3.12 的組合能否一路裝到服務跑起來,要實際裝過才知道。
macOS 或 Linux 使用者真的想裝,技術上不是無解:把 pywin32 那行刪掉、用 pyenv 或 conda 開一個 Python 3.12 環境、補齊編譯工具鏈,有機會推進到下一步。但每動一行鎖定檔,你就在製造一份自己的私有 fork;上游已經凍結,不會有人把你的修補收進上游,之後每次重裝、每次換機器都要重做一遍。這種成本一開始看不出來,第三次重裝的時候會非常具體。
為什麼一份 Python 專案的依賴清單會長成這樣?把 78 個套件全部釘死版本、連 pywin32 這種 Windows 系統套件都原樣列入、不做任何平台標記,最合理的解釋是:這是作者在某台 Windows 機器上直接匯出的完整環境快照。2024 年 11 月當下,這份清單在那台機器上是完美的;問題是它從此不再前進。對照 PyPI 現行版本,faster-whisper 已經從 1.0.3 走到 1.2.1,CTranslate2 從 4.5.0 走到 4.8.2,這一年多的修復與改進,這份鎖定檔一概吃不到。
時間膠囊效應還有個更硬的證據:專案的主要分支最後一次程式碼提交停在 2025 年 6 月 17 日,到今天超過 15 個月。凍結的不只是程式,還有鬆綁那份清單的機會。倉庫裡的文件素材甚至比公開倉庫本身還舊:README 的專案截圖檔名標著 2024 年 2 月,而這個倉庫是 2024 年 10 月才建立的,設定檔的檔頭則顯示它前身叫 Whisper-Speech-to-Text-API,檔名看起來是改掛前留下的遺跡;截圖裡的 Swagger 文件頁顯示版本 1.0.4,與現在設定檔裡的 1.0.5 差一版,截圖本身也是 2024 年 11 月隨 ChatGPT 功能一起入庫的。文件與程式碼之間的時間差,追起來像在看專案的地層。
設定檔裡的出廠值是 ip 設 0.0.0.0、連接埠 80。翻成白話:服務跑起來的那一刻,它監聽機器上所有網路介面,任何掃到你連接埠的人都能直接使用。我把 6 個 API 路由分組全部檢查過,沒有任何一處要求 API 金鑰或帳號,整個服務不存在鑑別層。你能在 API 上做的,陌生人也能做:把你的顯示卡算力吃滿、讀走轉錄結果、用 2GB 的上傳上限塞爆你的磁碟。這類出廠值問題在自架工具圈很常見,之前實測 MagicMirror 開源換臉工具遇到過本機服務綁 0.0.0.0 卻零驗證的組合,夸克雲端硬碟排程轉存工具則是出廠預設密碼加對外監聽,模式幾乎一樣。
風險還有一層容易被忽略:這個服務的資料庫裡存的不只是任務狀態,還有每一筆轉錄出來的文字。預設走 SQLite,一個檔案放在專案目錄裡;換句話說,誰能用 API,誰就能讀走你機器處理過的所有內容。如果上面跑的是訪談、內部會議或客戶委託的素材,這個資料庫檔案本身就該當成敏感資料看待,備份與權限都要比照辦理。
如果你決定要架,動手前先做兩件事:把 ip 改成 127.0.0.1 讓服務只聽本機,需要對外就掛一層反向代理,並在代理層加上金鑰驗證。這兩步都不難,難的是意識到有必要做,因為 README 的部署步驟裡完全沒提這件事。
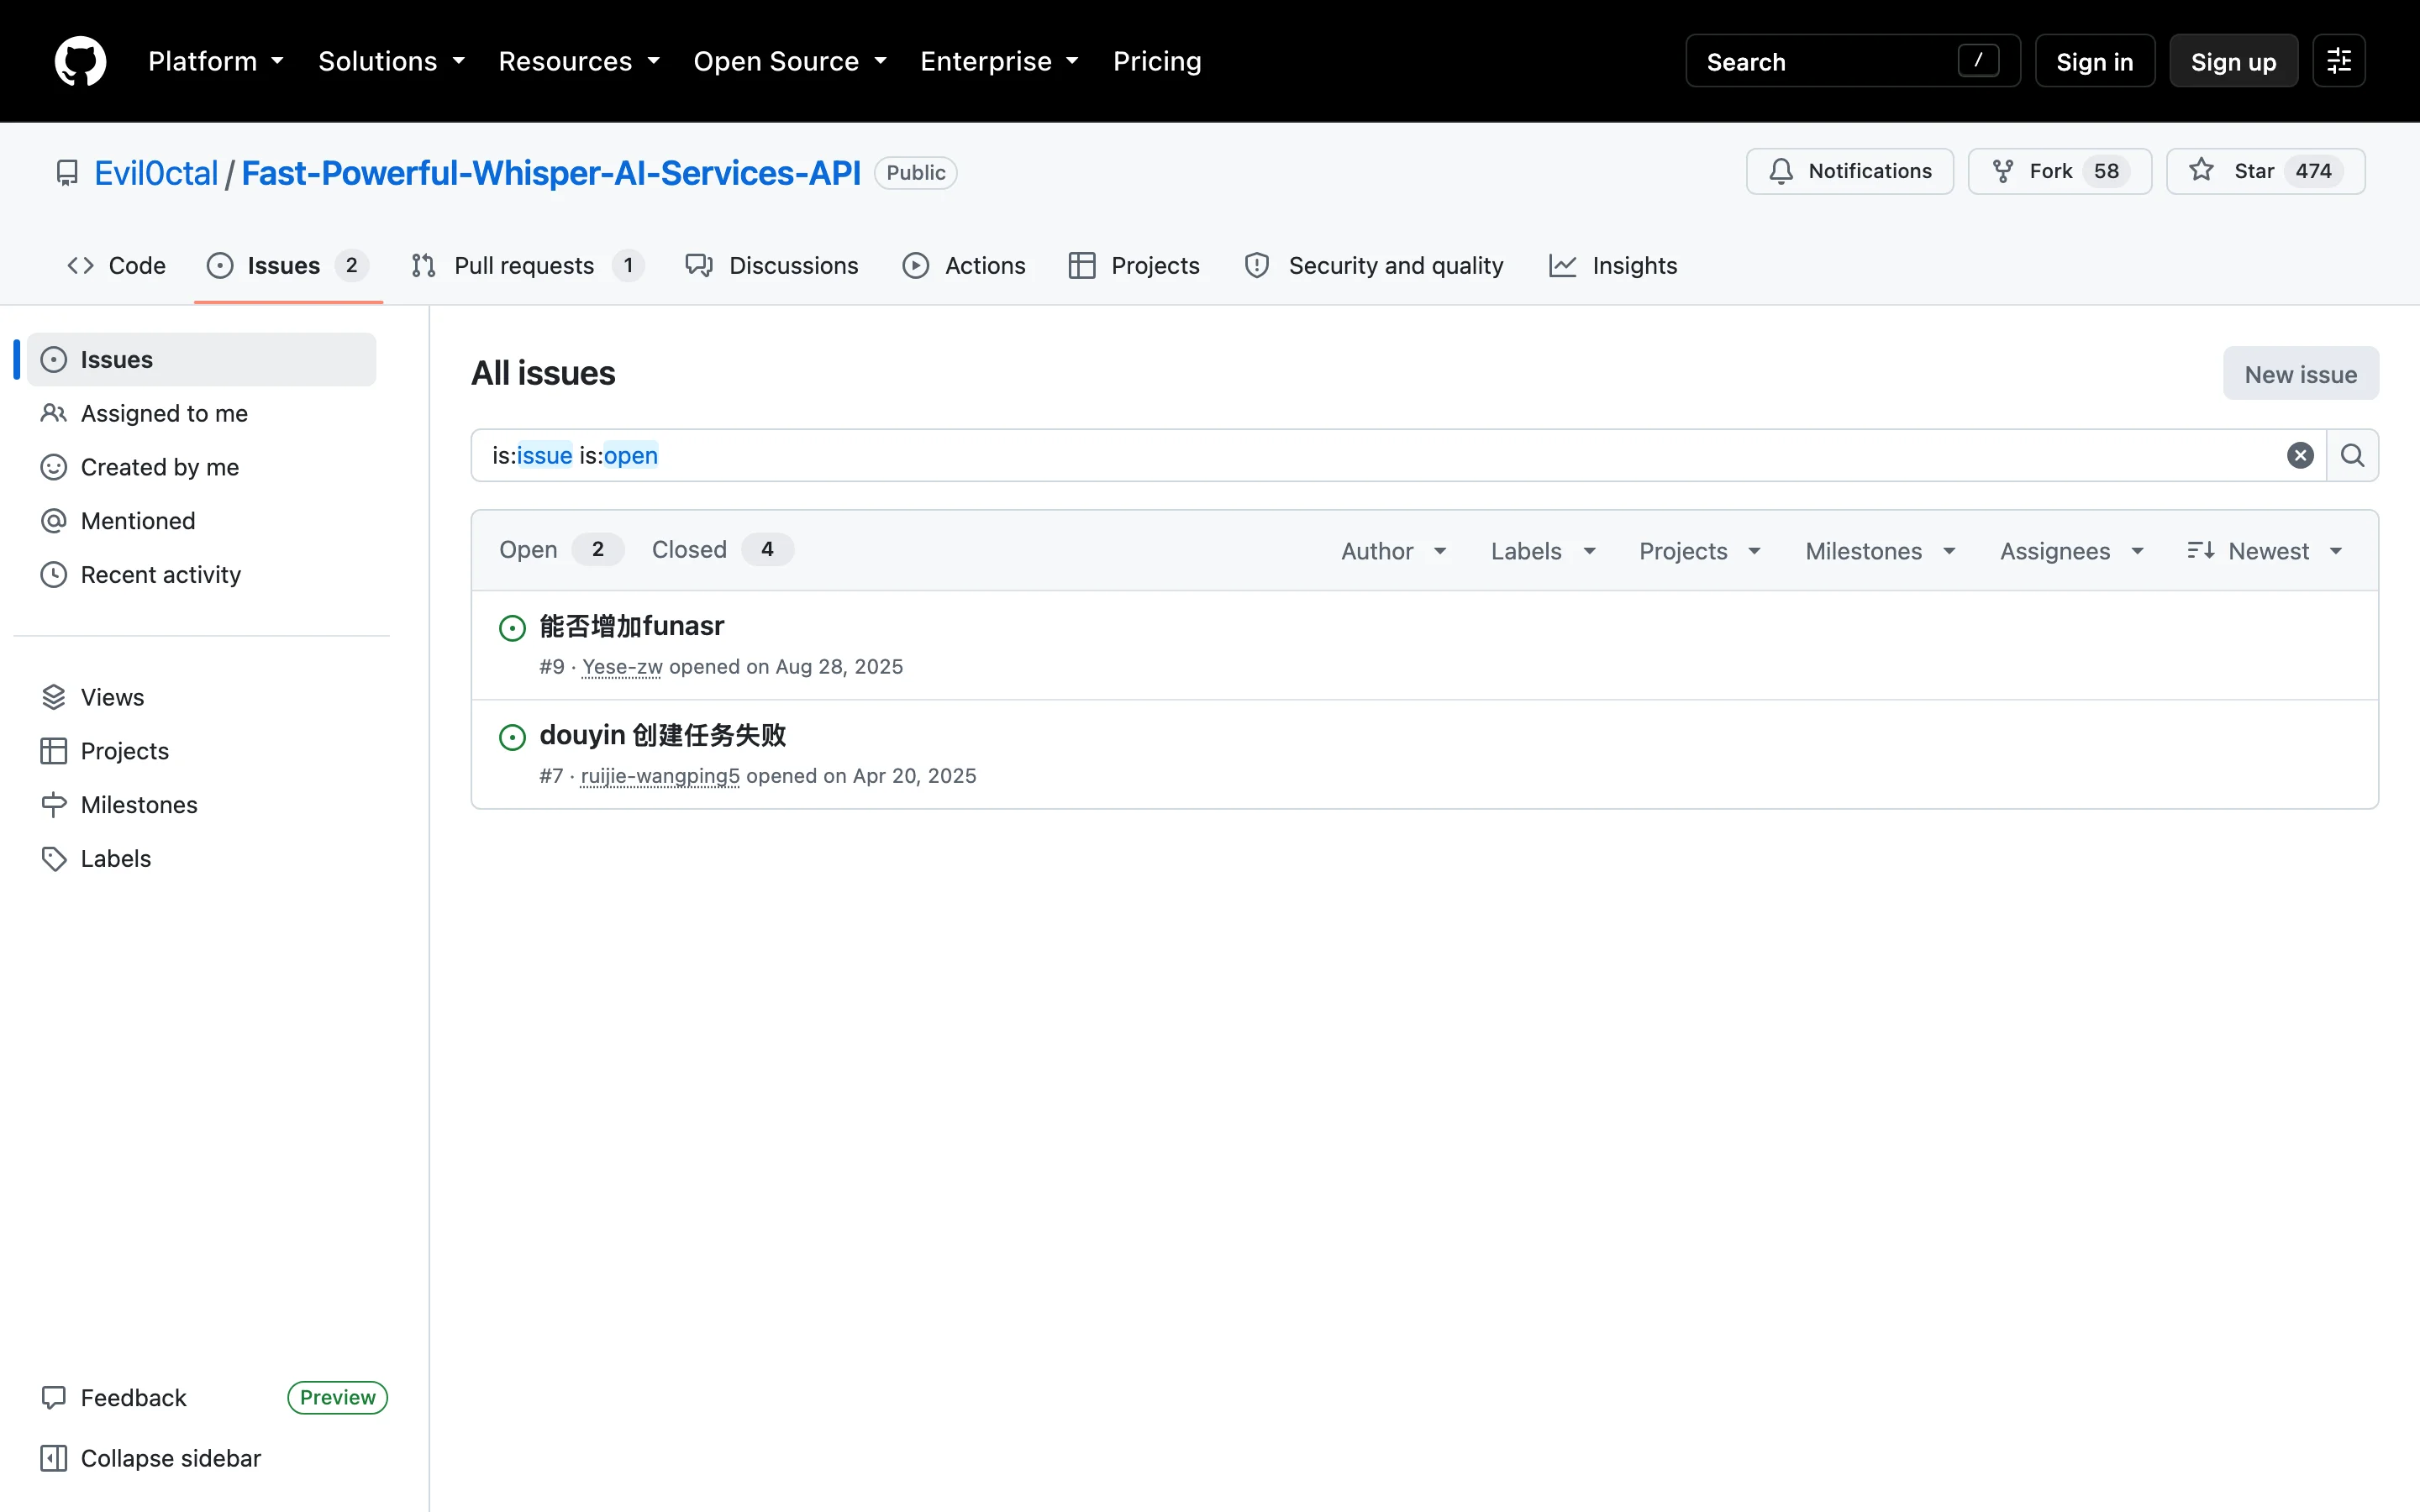
這個專案的賣點之一是內建抖音與 TikTok 爬蟲,貼個影片連結就能建轉錄任務。看原始碼會發現它不是新寫的:爬蟲模組整組搬自同一位作者的另一個專案 Douyin_TikTok_Download_API,檔頭的 Apache-2.0 版權宣告原樣保留,這點做得規矩。但要實際用它抓抖音,你得自己在環境變數裡填一組 DOUYIN_WEB_COOKIE,等於用你自己的抖音帳號身分去存取平台資料,平台條款與帳號風險都由使用者自己承擔。至於它現在還能不能用,我持保留態度:倉庫裡僅有的兩個開啟中 issue,其中之一就是 2025 年 4 月有人通報抖音任務建立失敗,到今天沒有任何維護者或社群的討論。順帶一提,設定檔裡還留著付費第三方服務 TikHub 的金鑰欄位,但我讀的這份程式碼裡沒有任何地方使用它,純粹是搬家時留下的舊家具。
ChatGPT 摘要則是另一種狀況:功能是新的、能用,但它是整個專案「全本地」宣稱的但書。這個功能讓你用任務編號把轉錄結果丟給 ChatGPT 做摘要,金鑰走 OPENAI_API_KEY 環境變數,屬於自帶金鑰的設計,不填就用不了,邊界算是清楚。要注意的是預設模型停在 gpt-3.5-turbo,2026 年的今天這個預設值明顯過時,用之前建議自己換掉。另外別忘了資料流向:摘要功能一開,被送出機器的就是你的轉錄文字,這一段不在本地推理的保護範圍裡。如果你處理的是隱私敏感的音檔,這個開關務必想清楚再開。
把散落在各段的問題集中列出,方便對照自己的環境:
專案以 Apache-2.0 授權釋出,內嵌的爬蟲來源專案同樣是 Apache-2.0,商用與修改的空間都存在;README 裡留了作者的商業合作信箱。倉庫建立於 2024 年 10 月,目前 474 顆星、58 次 fork。健康度要分兩面看:星星數對這種規模的自架工具不算差,但主要分支自 2025 年 6 月 17 日後就沒有程式碼提交,最後一個版本標籤 V1.0.5 停在 2024 年 12 月,處於實質凍結狀態。裝它,就要帶著接手維運的心理準備。
這套工具值得裝的情境很明確:你手上有 NVIDIA 顯示卡、有一批自己的影音素材要批次轉錄或產字幕,而且你有能力改依賴清單、顧好反向代理。典型的工作量是那種一次幾十支起跳的批次:節目累積幾年的 podcast 存檔、整學期的課程錄影、每週產出的會議紀錄音檔,丟給任務佇列讓它慢慢跑,完成的字幕直接拿去後製或封存。對這種人,它把兩個成熟的開源引擎包成有佇列與字幕產出的完整服務,骨架設計(非同步模型池、任務完成通知、雙資料庫支援)看得出工程功底,Apache-2.0 的授權也沒有後顧之憂。
定位看清楚會更好判斷。和直接抓 faster-whisper 或 whisper.cpp 的命令列工具比起來,你多拿到的是服務層:任務佇列、優先序、完成通知、字幕檔產出,以及可以讓其他程式遠端呼叫的 API。官方付費 API 換到的是零維運,命令列換到的是零服務層,這個專案站在中間,服務層現成、維運全包。如果那層服務對你的流程沒有價值,比如一年只轉幾支影片,維運成本就完全不值,命令列工具或官方 API 都比它省事。
反過來,三種人建議直接繞開:想要 docker pull 就完工的人,容器化還躺在待辦清單裡;沒有獨立顯示卡的人,large-v3 在 CPU 上跑會讓你懷疑人生,改小模型或改 int8 都得再折騰一輪;以及主要目的其實是下載抖音影片的人,爬蟲只是這個專案的附屬品,而且狀態不明。如果你的需求是把 Whisper 用在自己電腦上做配音或剪輯的後製流程,先前實測過的 Voice-Pro 本機 AI 配音管線是更貼近那種用途的選擇。
裝完怎麼確認成功:打開服務首頁能看到完整的 Swagger 文件、建一個小任務能拿到任務編號、查結果能拿到文字,這三件事成立就是跑通了。卡住的時候,先檢查你的 Python 版本與作業系統組合,再檢查 FFmpeg 有沒有裝好;這兩關過了還有問題,考慮到倉庫的凍結狀態,答案大概要自己找了。