TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Perplexity 研究團隊公開 Computer 的後訓練方法:把使用者修正與工具錯誤整理成可驗證的提示,結合拒絕採樣微調與策略內自我蒸餾訓練模型。線上 A/B 測試中,兩個後訓練版本的工具呼叫失敗率從 2.24% 降到 1.77%,相對降幅 21.2%,但對原始模型的線上差異未達統計顯著,使用者不滿意度也沒有變化。
用 AI 摘要這篇文章:
Perplexity 的研究團隊在 2026 年 9 月 21 日於官方部落格刊出一篇研究,標題是 Learning from Real-World Experience,隔天在 X 官方帳號宣布。官方貼文寫得直接:「We post-trained a Computer model to learn from its own errors using hint-guided self-distillation」,翻成白話,就是用一種由提示引導的自我蒸餾,讓模型從自己的錯誤中學習。貼文同時附上一張 A/B 測試結果圖,並公布工具呼叫失敗率相對下降 21.2%。
Perplexity Computer 是這家公司的自主代理產品,會代替使用者搜尋資料、操作工具來完成任務,模型每一次呼叫工具的可靠度,直接影響任務能不能走完。這也讓這篇研究的位置更清楚:它談的不是新功能,而是讓模型少在同一類地方跌倒的訓練方法。
這項研究值得記住的地方有兩個。他們把「什麼錯誤可以拿來訓練」變成一條可驗證的規則,避免把所有失敗一律算在模型頭上;同時他們自己把 21.2% 的證據邊界畫得很清楚,這是兩個後訓練版本之間的比較,改善集中在工具呼叫的可靠度,使用者不滿意度沒有同步變化。
研究處理的素材來自真實的 Computer 使用紀錄:多輪對話、真實任務、真實的工具呼叫。Perplexity 點出這類資料的價值。使用者什麼時候跳出來修正,代表模型沒做到他要的;工具什麼時候報錯,代表模型的動作在真實環境裡碰壁。這兩種訊號是合成環境容易漏掉的,而且錯誤發生的位置經常已經寫在紀錄裡。合成任務的優點是結果容易驗證,缺點是離不開設計者想得到的場景;真實流量補上的正是這一塊。
從成功對話學習的傳統做法是「拒絕採樣微調」(rejection sampling fine-tuning,RFT):判斷每段對話的最終結果,留下成功的讓模型模仿。文中指出這種做法的兩個盲點。成功的對話裡可能藏著先犯錯再繞路救回來的步驟,整段模仿會把壞習慣一起學進去;失敗的對話整段丟掉,又浪費了「模型在哪裡出錯」的證據。
Perplexity 的解法是把兩個決定拆開:哪些對話有值得模仿的行為,哪些回合有值得修正的錯誤。文中把每一個模型回合分成三種對待:
修正的部分就是官方所稱的「策略內自我蒸餾」(on-policy self-distillation,OPSD):同一個模型跑兩遍,一遍當老師、一遍當學生。老師看得到那句提示,學生看不到;訓練的目標,是讓學生在沒有提示的情況下,逼近老師有提示時的下一步預測。兩遍都採用教師強制(teacher forcing)的做法,餵給模型的永遠是記錄下來的原始對話,不是模型自己新生成的內容,差的只是老師多看一句提示。老師的預測只當目標、不帶梯度更新,一次優化器步驟同時吃下模仿與修正兩種損失。損失的權重設計也有務實的細節:兩種損失共用同一個分母,權重參數歸零時整套損失就退化成標準的監督微調,方便與既有基線對照;共用分母的另一個用意,是避免數量少的修正 token 在個別批次裡拿到不成比例的大權重。
研究文舉了三個具體例子。一個來自使用者修正:使用者問「如何在 Paychex 上找到我的 w3」,模型把 w3 當成 W-2 的筆誤,去搜尋報稅單的說明,使用者追問「我指的是 W-3 transmittal form」才定位出錯誤。另一個來自工具錯誤:模型呼叫搜尋工具時帶上 recency_filter 參數值 year,但工具只接受 day、week、month,工具直接拒絕執行。還有一個是程式碼執行:搜尋工具的文件寫明結果會以清單回傳,模型卻把清單當字典取值,收到 TypeError 的型別錯誤。三個錯誤的共同點,是模型當時手上已有的資訊,包含前後文與工具文件,就足以避免這個錯誤。
這篇研究最有意思的部分,是把歸因做成一套紀律。
工具呼叫失敗的原因很多:模型給錯參數是一種,服務中斷、權限被拒、使用者指令模糊是另外幾種。如果把所有錯誤都當成模型缺陷丟去訓練,模型可能學到錯的修正方向。研究文的做法是層層過濾。已知的基礎設施故障與授權遭拒先排除;錯誤提示必須指向模型當時可取得的資訊,例如工具規格、系統指示或更早的對話內容;還要通過一項事後偏見檢查,避免把使用者事後才揭露的新偏好,當成模型早就應該知道的事。
找到錯誤發生的位置,同樣有一套程序。使用者抱怨時,最後一個回答未必是禍源。文中量化了這件事:在他們的標註資料裡,抱怨出現前最後一個模型回合是根本原因的,只有大約一半。定位根因由三個 LLM 裁判投票,至少兩個同意才算數。有時錯誤的要求明寫在前文,有時要靠多段對話合起來才推得出來。以 Paychex 那個例子來說,註解產生的提示會要求模型改搜 W-3 的申報表,或者在語意不明時先問清楚,修正的對象是更早的判讀與搜尋決策,不是最後那句回答。提示送進訓練前還要過兩道檢查:佐證是否在錯誤發生前就存在、提示的修正主張是否能從當時的資訊推出來,兩道都過關才收入訓練集。
對話的篩選與判定也寫得明白。抽樣前先排除含個人識別資訊的對話,也排除選擇退出模型訓練的使用者;進入候選的對話,要先通過 LLM 裁判對任務難度的五分制評分,只留難度四到五分的樣本,再分成使用者回饋與工具錯誤兩組。成功與否由兩個 LLM 裁判分別判定,兩個都給出正面結論才算成功;有交付成果的對話還能重建檢查,等著使用者回應的未完成對話直接排除。訓練完成的模型接著成為 Computer 裡的模型選項,新的使用流量再經同樣的篩選進入下一輪訓練。
評估設計先回答兩個問題:提示出現時,模型能不能當場修正錯誤;訓練之後,模型能不能在沒有提示的情況下避開同類錯誤。前一問測的是訓練訊號有沒有效,後一問測的是模型有沒有真的學到東西,兩者的證據要分開看。
線上評估跑了兩次各自獨立的 A/B 測試,研究文寫明每個條件約十萬名使用者,這是官方自述的規模。第一次拿早期的後訓練版本跟原始 GLM 5.2 比:工具呼叫失敗率 2.82% 對 2.94%,差異沒有達到統計顯著。第二次拿兩個後訓練版本互比:從 2.24% 降到 1.77%,統計顯著,官方據此報告 21.2% 的相對降幅。
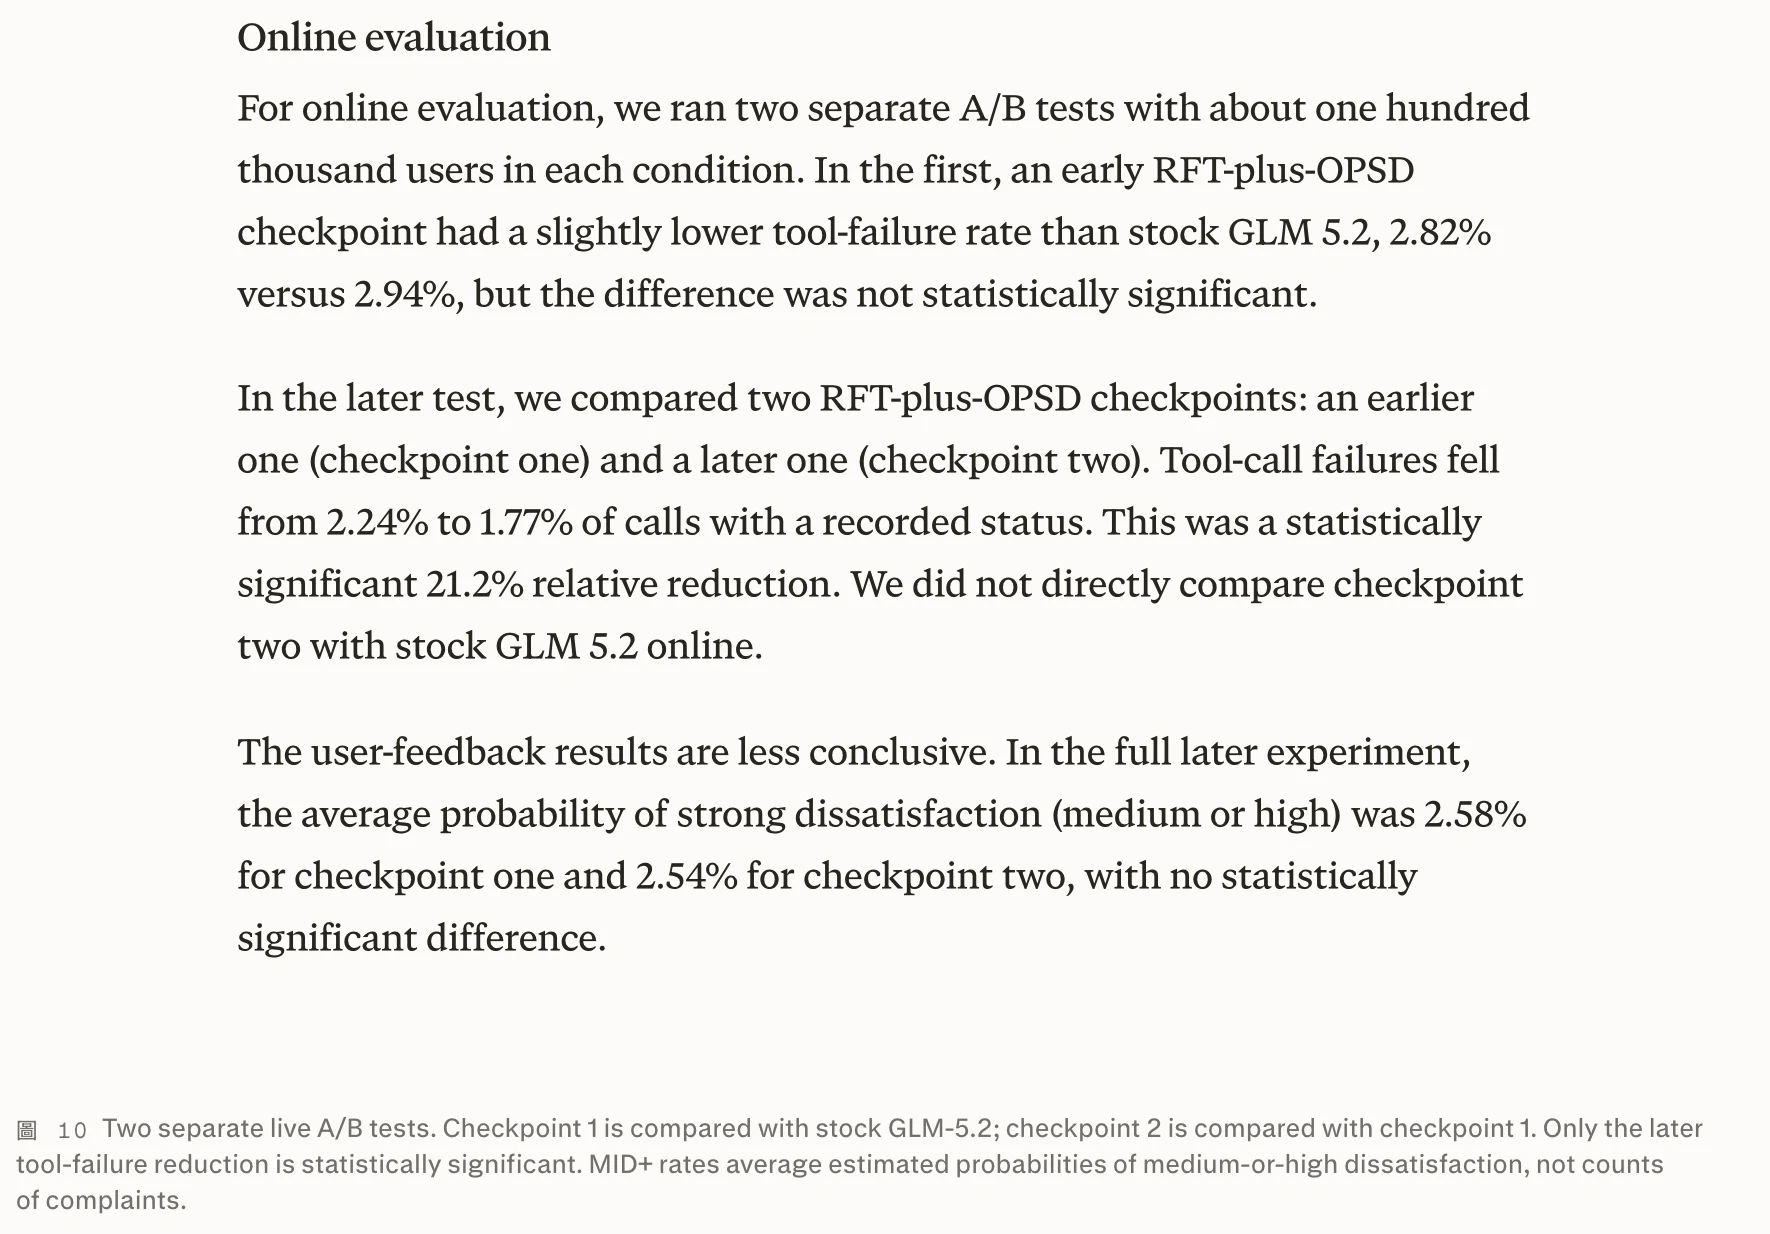
把這個數字放回研究文的脈絡,有幾件事不能省。21.2% 是相對降幅,兩個版本的絕對差距是 0.47 個百分點,分母是「有記錄狀態的工具呼叫」,不是任務整體成功率。研究文明說,第二個版本與原始 GLM 5.2 之間,線上沒有直接對比的結果。也就是說,把 21.2% 讀成「比原版少失敗五分之一」缺乏線上證據支持,何況第一次對原版的比較本身就不顯著。
使用者這端的結果更保守。第二次實驗裡,中高度不滿意的估計機率從 2.58% 到 2.54%,差異不顯著。研究文特別註明這是模型估計出來的機率,實際收到的抱怨次數並未公布。結論一節寫得坦白:目前站得住的後訓練證據是工具可靠度,線上測試沒有證明使用者不滿意度下降;裁判也可能出錯,修正單一回合也不保證整個任務成功。
離線評估提供另一組參考數字。在 BrowseComp、Finch、WideSearch、DRACO、DSQA、SpreadsheetBench、HLE 與一組 Computer 任務的評估軌跡裡,原始 GLM 5.2 的工具錯誤率是 2.79%,只用 RFT 的版本是 1.35%,RFT 加 OPSD 的版本是 0.87%。但研究文主動提醒,這幾個版本訓練資料不同,不能當成 OPSD 的對照消融實驗;任務級的基準成績好壞互見,工具錯誤減少本身不等於任務成功率全面提升。
還有一組數字常有人讀錯方向:提示本身的驗證是在訓練前的原始模型上做的。在 985 個標記回合的樣本上,每個回合有提示與沒有提示各重新生成四次,由看不到提示與條件的盲測裁判評分,失敗避免率從 75.1% 升到 93.7%,採取修正動作的比例從 60.6% 升到 82.3%。另外兩組各 40 個回合的使用者回饋樣本,重生成時溫度設為零,修正或上軌道的比例分別從 40.0% 升到 75.0%、從 32.5% 升到 80.0%。這組數字證明的是「提示能讓未訓練的模型避開錯誤」,也就是訓練訊號本身有效,跟訓練後的成效是兩回事。
抽樣說明寫明,訓練素材取自 GLM 5.2 服務的 Computer 對話。GLM 5.2 是智譜(Z.ai)的模型,在 OpenRouter 上的上架紀錄是 2026 年 6 月中。換句話說,Perplexity 拿第三方的底層模型,用自家產品收到的真實流量做後訓練,再把它放回自家產品當選項。署名的貢獻者共十位。
同一條產品線今年動作不少:七月末推出 Personal Computer,9 月 14 日讓本機 Agent 登上 Windows,9 月 17 日又為 Computer 加上努力程度滑桿,把模型挑選交給系統。底層模型的研發方智譜,最近也發布過模型基礎設施的自動改進研究,可見相關報導。
對使用者來說,這次公布沒有帶來任何新功能或新按鈕,改變發生在模型本身。真正值得追蹤的驗收點有兩個:後續能不能看到任務成功率或使用者滿意度的顯著改善,以及這套從錯誤歸因的訓練紀律,會不會出現在其他公司的模型後訓練報告裡。
沒有揭露的部分也該列出來:每次 A/B 實際納入計算的工具呼叫總數、修正損失的權重值、訓練資料總量、兩個後訓練版本的訓練時間範圍,研究文都沒有給。數字與結論出自 Perplexity 自家研究團隊,刊載時沒有附外部審計或同儕審查的標記。業界研究常態如此,但讀者拿到 21.2% 這個數字時,知道它的邊界在哪裡,比數字本身更有用。