TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

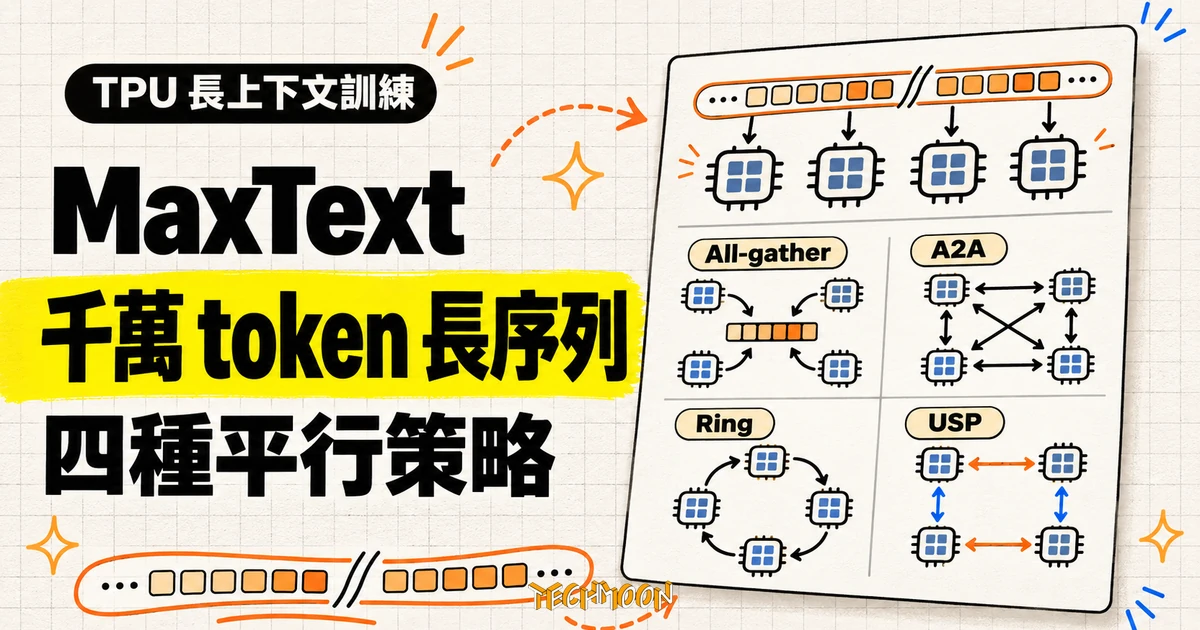
Google 開源訓練框架 MaxText 在 v0.2.4 加入長上下文訓練,官方在 64 顆 Cloud TPU 上示範 1,400 萬 token 訓練序列;All-gather、A2A、Ring、USP 四種上下文平行怎麼選,官方利用率數字各綁哪些條件,想試的人從哪裡開始。
用 AI 摘要這篇文章:
2026 年 11 月 9 日,Google 在開發者部落格發布公告,宣布開源訓練框架 MaxText 加入長上下文訓練支援,並在 Cloud TPU 上示範了長達 1,400 萬 token 的訓練序列。token 是模型讀寫文字時計算量的基本單位,1,400 萬 token 對應的原始文字量遠超過一般書籍,而這個數字講的是「訓練」,與任何聊天產品的輸入上限是兩回事:公告全篇談的都是訓練框架,沒有觸及你我在對話框裡能貼多長的文章。這件事有它的時代背景:公告開頭自己算了帳,三年之間主流模型的上下文視窗從 12.8 萬到 20 萬 token 這個量級,長到 100 萬到 200 萬 token,而且朝 1,000 萬 token 邁進的模型正在路上。模型「讀得到」這麼長,訓練端就要「餵得下去」,後者正是這次更新要解的題。
先把結論說清楚。一千四百萬的長度是亮點,更實際的變化是這一行:多百萬 token 序列的訓練,從各團隊自製的工程難題,變成開源框架裡的一個設定值,安裝套件、指定策略名稱、設定平行度,其他訓練參數不動。配套的選擇原則也寫明白了,起點是一個很實際的問題:你的鍵值資料放不放得進晶片記憶體。文中效能數字均為 Google 官方公告的報告值,並非第三方重測;版本與專案動態為 2026 年 11 月 13 日的官方頁面內容。
MaxText 是 Google Cloud 的開源 JAX 訓練框架,原始碼放在 GitHub 的 AI-Hypercomputer/maxtext 儲存庫,採 Apache-2.0 授權,累積約 2,460 個 stars 且近期仍有提交。長上下文訓練功能在 v0.2.4 提供,依照公告,可從 PyPI、Docker 映像檔與 GitHub main 分支取得;官方另在 tpu-recipes 儲存庫放了兩份現成配方,分別對應 TPU 7(Ironwood)與 TPU 5p,用的示範模型都是 Llama 3.1 8B。
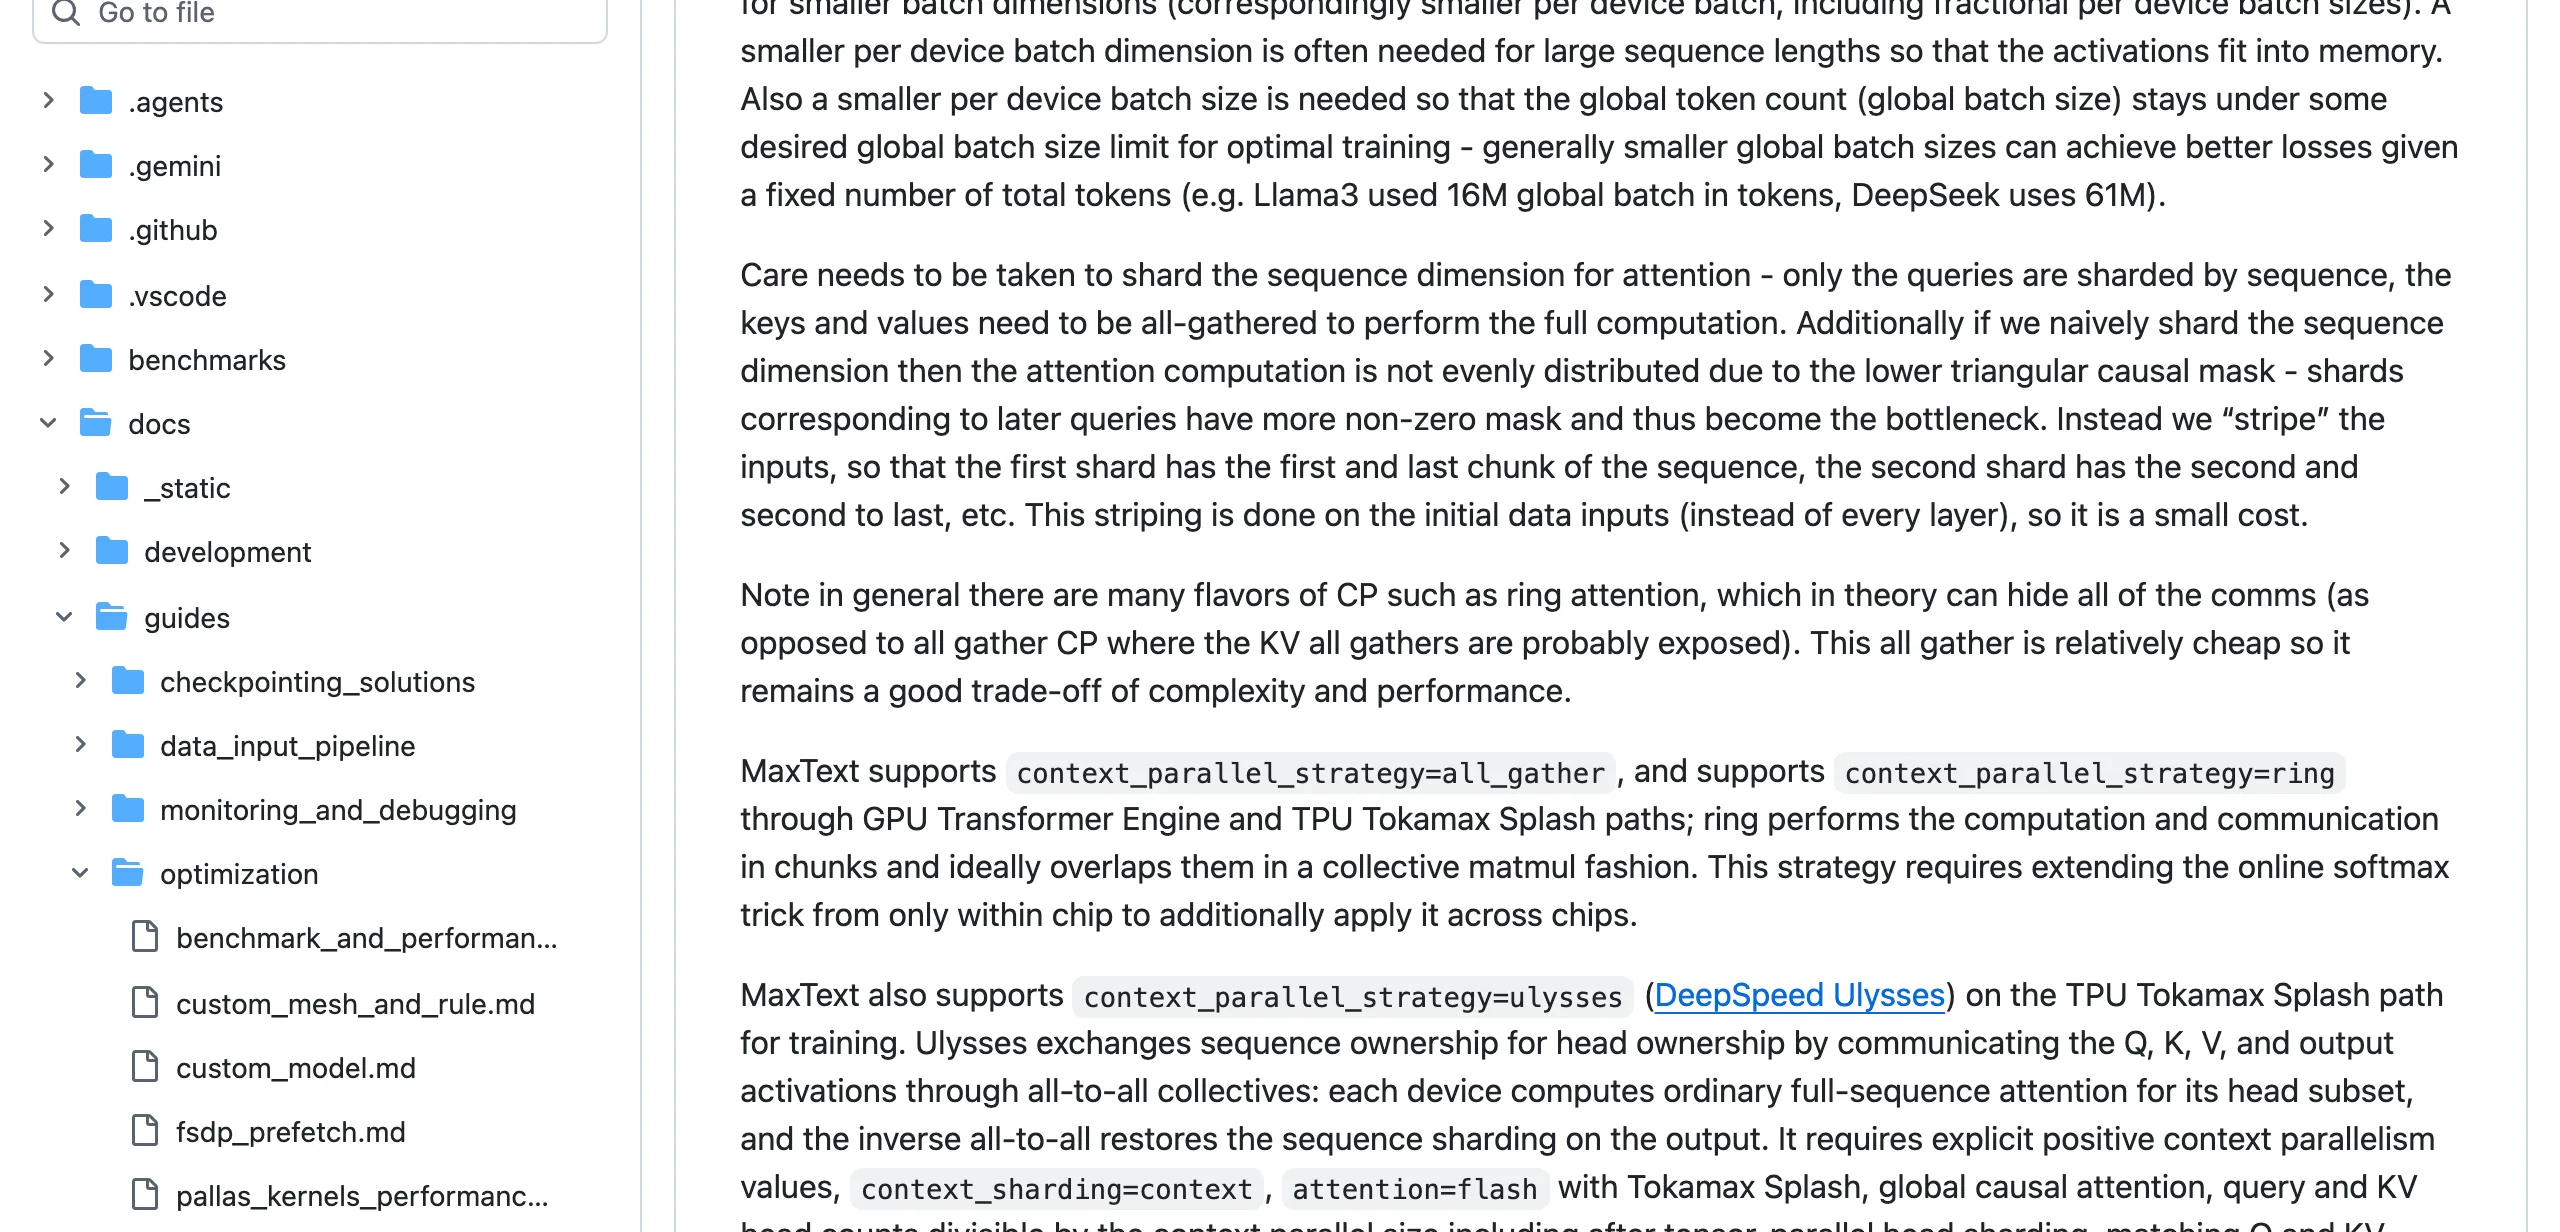
版本紀錄把這一版的工作列得很具體:新增 Ulysses 與 USP 兩種上下文平行策略、Tokamax 負載平衡的 Ring Attention,以及序列打包(sequence packing,把多段樣本併成長序列餵給模型),對應的 pull request 編號從 #4230 一路到 #4887。對照官方 sharding 文件,這次更新之前框架支援的上下文平行選項是 all_gather 與 ring 兩種,更新後湊成四種:All-gather、A2A(另一個名字是 DeepSpeed Ulysses)、P2P(Ring Attention),以及把 A2A 與 P2P 疊起來的混合策略 USP。四種策略共用同一個注意力核心:Tokamax 這個 Google 開源 TPU 核心庫裡的 Splash Attention,它會跳過完全被遮罩掉的區塊,處理打包序列時也不需要補空白。公告也提到這些策略涵蓋了當前主流模型的注意力變體,從多頭注意力、分組查詢注意力(GQA)到 DeepSeek 式的多頭潛在注意力(MLA)都在支援範圍。
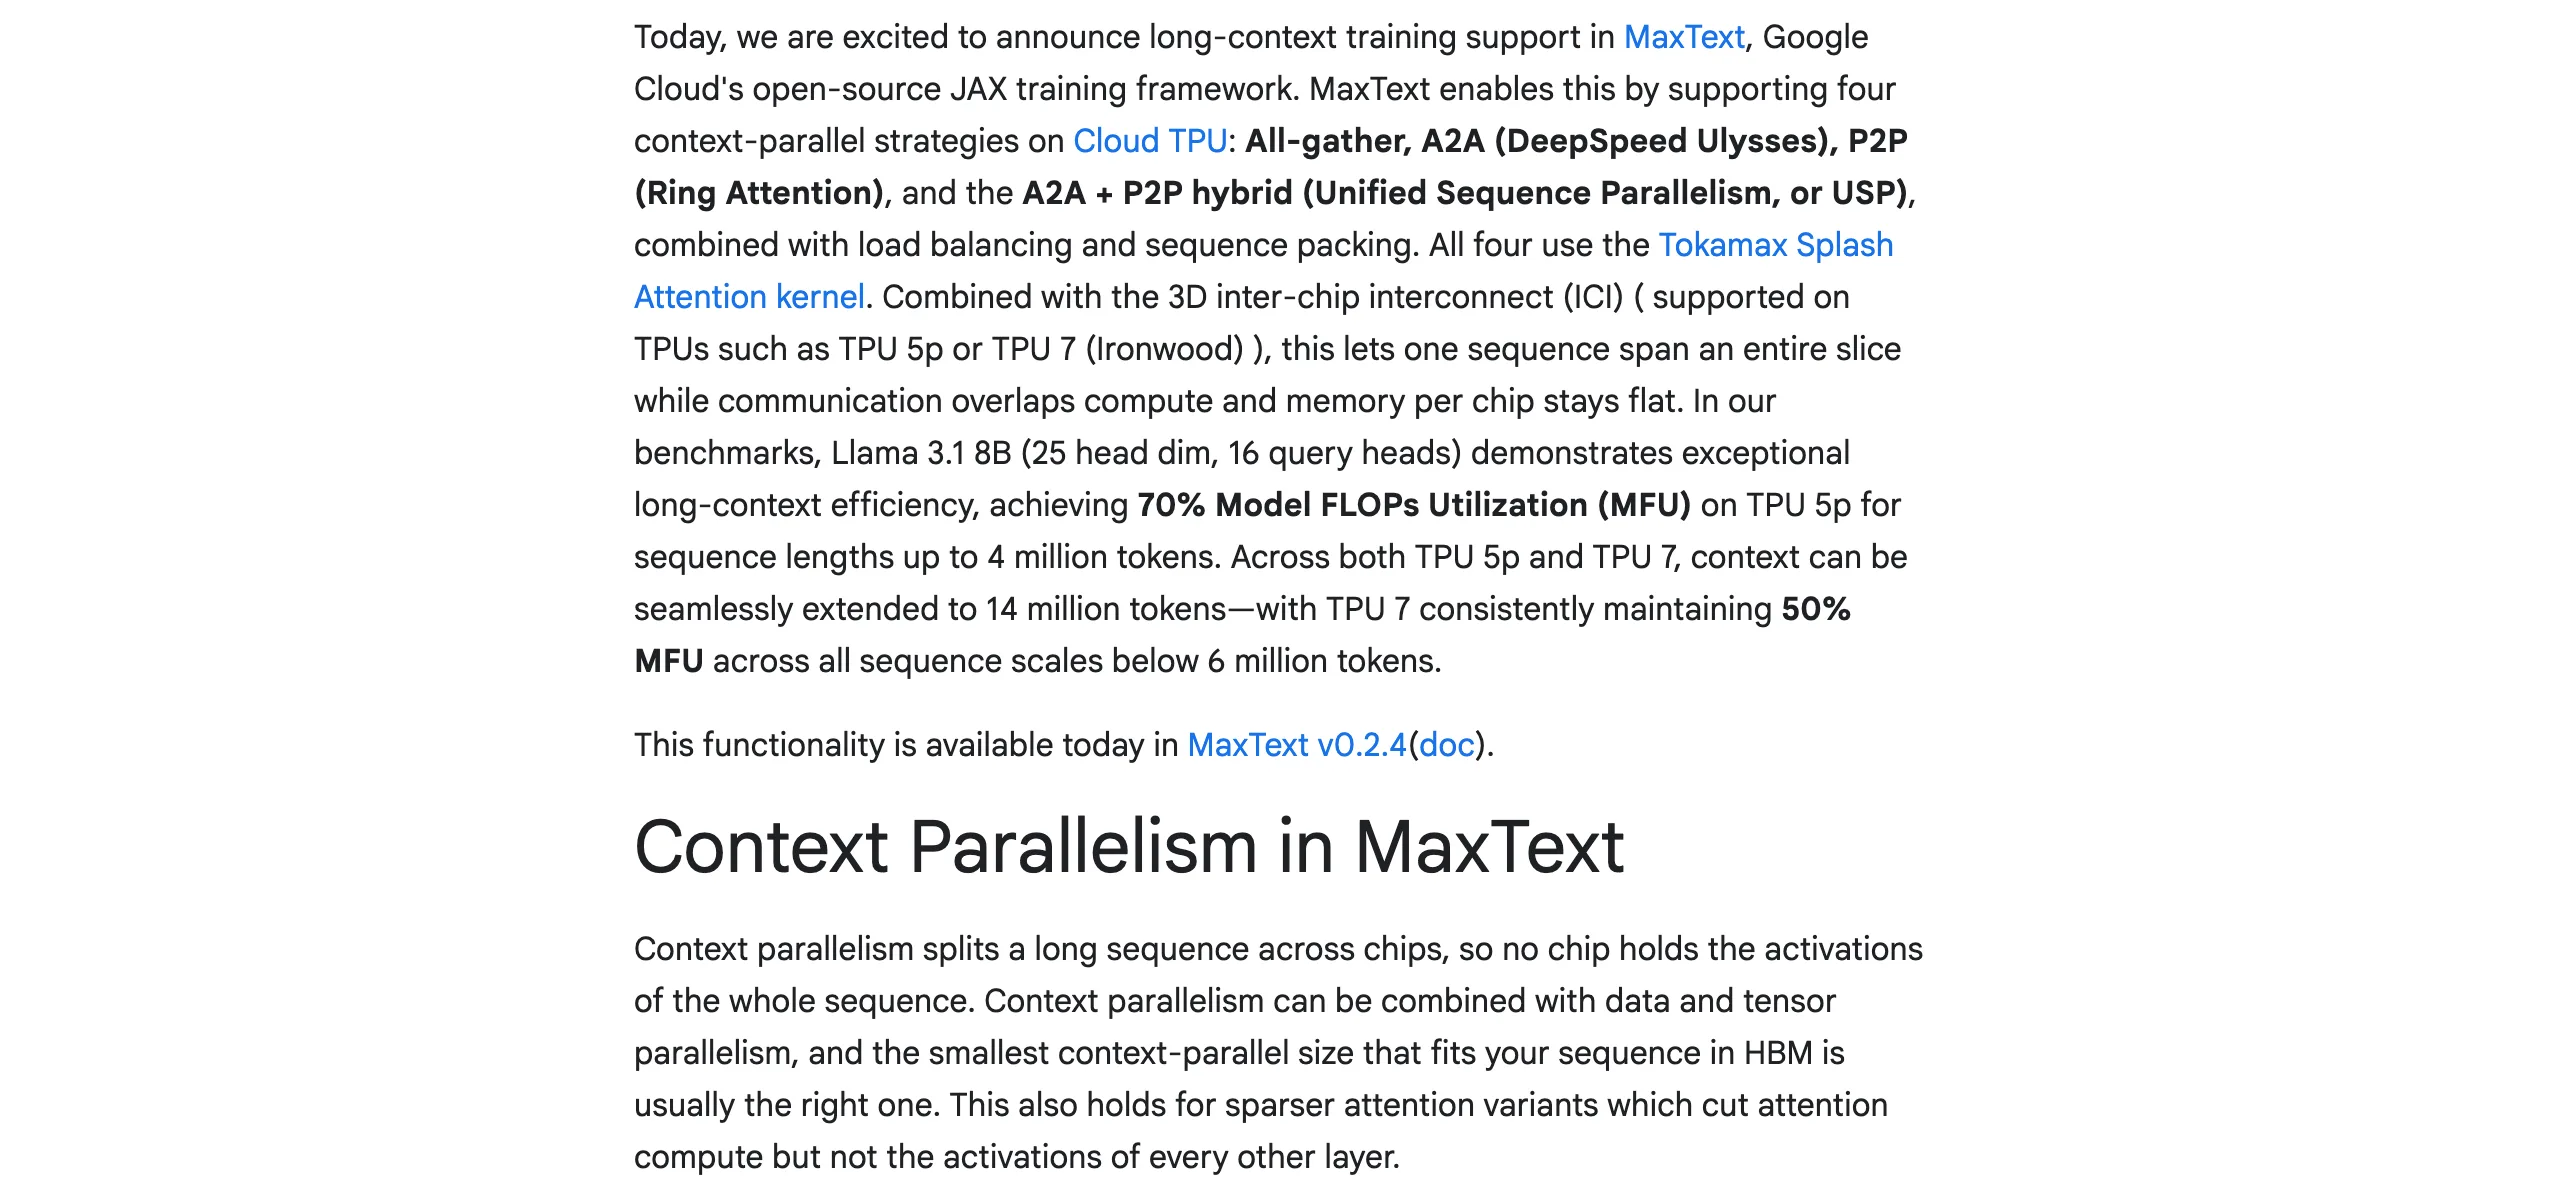
誰受影響?已經在 TPU 上訓練、而且序列長度開始撞記憶體上限的團隊,是這次更新直接的受眾;在 GPU 上訓練的人不在這條路徑上,sharding 文件寫明 ring 策略在 GPU 走的是 Transformer Engine,屬於既有支援,本次更新的主體在 TPU 這側。公告也交代了這套做法能成立的硬體前提:TPU 的三維晶片間互連(ICI)讓一條序列可以攤滿整個切片(slice,一組透過互連相連的晶片),通訊與計算重疊著跑,每顆晶片的記憶體用量維持平坦,支援的世代包括 TPU 5p 與 TPU 7(Ironwood)。
要看懂四種切法的差別,得先知道長序列訓練卡在哪。訓練時模型要為序列裡每個位置保存中間結果,其中最佔空間的是注意力機制需要的鍵與值(key 和 value,模型替每個位置留下的檢索線索與內容摘要)。序列越長,這些鍵與值的總量就越大;如果每顆晶片都完整複製一份,就像辦公室裡每個人都影印一整套百科全書,紙堆比誰的桌子先垮還好預測。官方公告直白地點名:天真地把鍵值湊齊到每顆晶片,會耗盡高頻寬記憶體(HBM),直接觸發記憶體不足的失敗。
計算量同時在膨脹。注意力讓每個位置回頭參考它前面的所有位置,序列長度加倍,這類比較關係的工作量接近四倍成長,注意力因此成為長序列訓練步驟裡最主要的計算。兩者相加,就是「模型參數放得進晶片、中間資料卻放不進」的常見窘境。
上下文平行(context parallelism)是針對這個問題的切法:把同一條序列的不同區段分給不同晶片,鍵與值用串流的方式在晶片之間傳遞,取代一次湊齊整份。它和資料平行(不同樣本分給各晶片)、張量平行(把模型運算拆開)分攤的是不同維度,實務上可以疊用。四種策略的差別,在於「鍵值怎麼流、誰手上拿多少」,也就改變了記憶體用量與傳輸成本的取捨。
公告裡的效能數字不少,單看百分比容易誤讀,連條件一起看才有意義。
| 官方數字 | 綁定的條件 |
|---|---|
| 70% MFU | Llama 3.1 8B、TPU 5p、序列最長 400 萬 token |
| 序列可達 1,400 萬 token | TPU 5p 與 TPU 7 兩世代、訓練框架的能力示範 |
| 50% MFU | TPU 7、600 萬 token 以下的各個序列尺度 |
| 48.7% 對 37.1% MFU | 1,400 萬 token、P2P 策略、64 顆晶片、TPU 7 對 TPU 5p |
MFU 是模型浮點運算利用率,描述模型有用計算佔硬體理論運算力的比例,它能告訴你資源有沒有被浪費,與模型回答的準確率沒有對應關係。最後那組對比數字值得一提:同樣用 64 顆晶片跑 P2P 的 1,400 萬 token 訓練,TPU 7 達到 48.7%,TPU 5p 是 37.1%,官方把差距歸給 Ironwood 世代每顆晶片兩倍的 HBM 容量。官方也在 64 顆 TPU 5p 的固定切片上,比較 P2P 與 All-gather 從 64K 到 1,400 萬 token 的表現,結論是在理想設定下 P2P 幾乎在各個長度都跑得比 All-gather 好,而且 ring attention 在 TPU 7 上優於 Ulysses 與 USP。這是官方在特定配置下的觀察,不是一張適用所有模型與晶片組合的排行榜。
讀這段還要留意兩件事。公告對示範模型的規格描述前後不一致,兩處分別寫了 25 與 256 的 head dim(注意力頭維度),引用規格時以 Llama 3.1 8B 的模型卡為準。更重要的是,「訓練得動」只證明計算與記憶體安排得下來,模型有沒有因此更會利用長文件裡的遠處資訊,公告沒有附任何品質評測,這一步要自己用長文件任務驗收。
官方給的選擇邏輯從一個問題開始:把湊齊的鍵值放進 HBM,放得放不下?
| 你的狀況 | 官方建議 | 理由與限制 |
|---|---|---|
| 湊齊的鍵值放得進 HBM | All-gather,開負載平衡 | 最簡單的基準;記憶體隨整條序列增長,最先撞牆 |
| 晶片數不超過鍵值頭數 | A2A(Ulysses) | 把「切位置」換成「切注意力頭」;上限是模型的頭數,公告以 Llama 3 8B 為例是 8 個 KV 頭,且不支援 MQA |
| 鍵值放不下、模型是 MLA 或頭數無法整除 | P2P(Ring) | 鍵值區塊沿環狀一棒接一棒傳,通訊與計算重疊;區塊太小會拉低核心效率,需要明確的負載平衡 |
| 頭數允許 A2A 因子 2 以上 | USP(混合) | 兩個維度相乘得到總平行度,環更短、每塊更大;兩個維度都必須大於一 |
回頭用影印室的比喻收攏這張表:All-gather 是人人都影印一整套,最快也最傷紙;A2A 是每個人認領不同主題的櫃子,櫃子數量天生有限;Ring 是把整套拆成一冊一冊輪流傳閱,人人桌上只剩自己那一冊加上正在讀的一冊;USP 則是先把幾個人併成小組共讀幾個主題,再讓小組之間傳閱。官方的原則寫得節制:取「剛好放得進 HBM 的最小上下文平行度」,切得比需要的更細只會增加交換,未必再有任何收益。
表中兩個「為什麼」值得多說兩句,因為它們直接影響你能切到多大。A2A 的上限來自注意力本身的形狀:注意力在各個頭之間互不相干,在位置之間卻互相依賴,所以頭可以切、位置不能切,能分的晶片數就被封在頭數裡,張量平行又與它共用同一個維度,兩者相乘後不能超過頭數總量。它的意外好處是不用再做負載平衡,sharding 文件寫明每顆晶片對自己的頭算的是完整序列,工作量天生均勻,這時文件的指示是把因果遮罩的負載重排關閉。Ring 那邊剛好相反:每顆晶片只對造訪中的區塊計算,通訊可以墊在計算底下進行,但序列前後位置的工作量天生不均(越靠後的位置要回顧的範圍越大),加上區塊切得太細會拉低單顆晶片上的核心效率,所以文件要求明確開啟負載平衡。USP 的混合邏輯也就順理成章:A2A 先把各組的內容併攏,讓環上每一棒攜帶的區塊變大、環變短,每棒有更多計算可以把傳輸藏在後面。
實作層的細節,sharding 文件比公告更具體。設定旗標叫 context_parallel_strategy,公告的上手清單列了 ring、ulysses、usp,sharding 文件另載明 all_gather 也是同一個旗標的合法值;ulysses 僅限晶片間互連(ICI)內使用、要求頭數在含張量平行切分後仍可被上下文平行度整除,而且不支援 MQA、dropout 與多種注意力變體;usp 要環長度與 Ulysses 因子兩個維度都大於一,想開負載平衡時環長度還得是偶數。這些限制在公告裡只見輪廓,實際配置時文件才是準頭。
如果四種切法都試了記憶體還是不夠,公告給的下一招不是把平行度繼續往上加。官方順序是「先搬家、再重算」:MaxText 能把保存的啟用值、優化器狀態與參數逐一搬進主機記憶體(加速器所在伺服器的記憶體),長序列帶來的計算時間通常足以把搬移藏在後面,官方形容長上下文情境下這些搬移「幾乎免費」。搬的順序也有講究:先搬注意力輸出,再來優化器狀態、各層輸入、參數,重新計算(remat,放棄保存、需要時重算中間結果)是最後手段。官方量測顯示 MFU 在這段搬移階段維持平坦,而 All-gather 會先掉下去、最後直接放不下;搬到哪個程度才夠,官方另有一份 remat 調校指南可以對照。
安裝面很單純:pip 裝 maxtext,0.2.4 起就含這套功能,PyPI 上這個版本的套件早在 8 月 21 日就上傳了,最新版已到 0.2.6,版本語意當作「至少 0.2.4」即可。照公告的說法,揀一個策略名稱填進 context_parallel_strategy、設好上下文平行度,其他訓練設定維持原樣,就是最小改動的起點;不想從零配置的人,tpu-recipes 的兩份 Llama 3.1 8B 長上下文配方可以直接參考。
第一次比較策略時,紀律比技巧重要:固定同一個模型、同一條序列與相同批次,一次只改一個切分條件,記錄哪個設定先撞記憶體上限。兩種成果要分開看:原本跑不動的序列現在能跑,與同樣跑得動的設定之間誰更快,是兩種不同性質的收益,混在一起比會誤導自己。短輸入佔大多數的既有訓練管線,也不必為了統一配置而全面改用複雜策略,公告自己的量測就顯示短序列時 All-gather 仍是最快或接近最快的選項。另外一個採用前要先想清楚的邊界:MaxText 是 JAX 生態的框架,不是 PyTorch,已經把訓練管線建在 PyTorch 上的團隊,評估的不只是功能,還有搬家成本。
視角拉遠一點,這次更新落在 Google 近期把大型 TPU 訓練基礎設施持續往外送的這條線上:單一控制器編排的 Pathways 已正式開放,TPU 也排定 2027 年登上 Oracle Cloud,硬體端則有推論取向的 TPU 8tx 與 8i Max。訓練配方、編排系統與硬體三條線一起往外走,對租用 TPU 的團隊來說,長上下文訓練的門檻確實在下降。
公告結尾自己畫了界線。Gemma 這類混合滑動視窗與全域層的模型、GDN 與 KDA 這類線性注意力機制,都在「計畫支援」的清單上,屬於還沒落地的事,不能當成 v0.2.4 已經能用;Tokamax 核心與 P2P 反向 pass 的調校也還在走。效能數字是官方單方報告,GPU 生態的對應方案公告隻字未提,這裡不替它補上比較敘事。要追蹤後續,看 MaxText 的 release notes 與 sharding 文件最直接,配方更新則看 tpu-recipes。
收斂成一句判斷:已經在 TPU 上訓練且序列長度開始撞牆的團隊,這次更新給了明確的下一步,從放得進 HBM 的最小平行度開始試;還沒碰 TPU 的讀者,記住這是訓練側的工程進展就好,你手邊的聊天視窗不會因為這篇公告變大。