TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

MTranServer 是開源的自架離線翻譯伺服器,用 Firefox 同源的 Mozilla 模型在 CPU 上跑出每句十幾毫秒的翻譯速度,這篇實測它的延遲、記憶體帳與部署時會踩的繁簡、長度限制。
用 AI 摘要這篇文章:
一行指令 npx mtranserver@latest,半分鐘後本機 8989 連接埠就站著一台翻譯伺服器。把第一句英文丟給它,16.7 秒之後變成繁體中文,這 16.7 秒裡有 33MB 的模型下載;從第二句開始,每一句只要 14 到 19 毫秒。這是 MTranServer,一個 Apache-2.0 授權的開源專案,GitHub 上 4,700 多顆星,賣點寫得毫不客氣:CPU 就能跑、不用顯示卡、翻譯無限量免費。
我自己裝了一輪、量了延遲與記憶體,也踩到幾個文件沒寫的坑。結論先講:如果你常駐需要翻譯、不想按字數付 API 費、手邊有一台記憶體 2GB 以上的常開機器,它值得裝。但「離線」「低記憶體」這兩個標籤各自附帶成立條件,台灣用戶還有一個不指名就會踩的繁簡陷阱,下面逐項攤開。
網路上流傳的介紹常叫它「免費版 Google 翻譯」。翻開原始碼,它跟 Google 沒有關係:伺服器載入的是 Bergamot 專案的 WebAssembly 翻譯引擎,模型檔直接從 Mozilla 的 Firefox RemoteSettings 管線下載,兩個 mozilla 網域就寫在原始碼的常數裡。換句話說,它用的是 Firefox 瀏覽器內建翻譯功能的同一批模型,貨源是 Mozilla 官方供應鏈,不是作者自己訓練的東西。
我拉了這份模型清單來數:109 個語言模型對、57 種語言,其中繁體中文與英文互譯的兩個方向都在,單個模型解壓縮後約 44MB。值得注意的時間戳:英翻繁中這組模型是 2026 年 1 月 27 日才加入模型庫的,而整份清單最後一次更新停在 2026 年 9 月。這對使用者是好消息,伺服器程式半年沒改版,Mozilla 那頭的貨源還在進貨,新語言會自己長出來。
品質要放在正確的位置看。作者在 README 開頭就自述「專注速度、翻譯品質輸給大模型」,坊間說的「與 Google 翻譯相當」則是流傳文章裡的評語,專案文件裡其實沒有這一句。我的實測樣本是這樣:日常句子讀起來自然,「開放原始碼軟體讓使用者能自由檢視和修改程式碼」「量子電腦使用量子位元」這類輸出的用詞就是台灣習慣的說法;但時態會丟,”used to require” 這種過去式的語意,出來只剩「需要」。讀網頁、讀文件夠用,拿來出稿不行,要出稿等級的譯文請走大模型 API,這也是作者自己給的建議。
為什麼不用獨立顯示卡也能跑這麼快?線索藏在模型檔名裡:這批模型全部經過整數矩陣運算的量化壓縮(檔名裡的 intgemm 字樣),用一點精度換整數運算的吞吐量,翻譯引擎再配上極窄的搜尋寬度來壓低單句成本。這正是 Bergamot 為瀏覽器內翻譯設計的路線:模型小、走整數運算、普通機器跑得動。遇到長段落它會先斷句再逐段處理,這個行為我在實測裡碰到過;混著兩種語言的句子,原始碼裡的設計是先做語言偵測、切開各自翻譯再接起來。
README 宣稱單一請求平均 50 毫秒。我在 Apple Silicon 的 Mac 上用五個不同的新句子實測,暖延遲落在 13.8 到 19.2 毫秒,比宣稱快了一倍以上;重複丟同一句更只剩 0.6 毫秒,已經不到正常翻譯的等級。作業系統是 macOS,其他平台的速度我沒有量,但這個量級的差距足以說明它的速度宣稱不是行銷話術。
自架與公共實例的差距,一句話就能看出來。README 上有社群貢獻者開的公開實例,從台灣丟一句過去,2.7 秒才拿到答案,瓶頸在跨網路的往返;同一句在本機只要 17 毫秒。這就是自架的意義:模型住在你家,網路成本只剩區網內的那幾毫秒,而且沒有別人跟你搶排隊。
要付的代價是冷啟。第一次翻某個語言對時,伺服器會先下載該組模型(英翻繁中是 33MB 的壓縮檔)再初始化引擎,第一句等 16.7 秒屬於正常;換一個新語言對,這個代價就要再付一次。正式上線前先把常用的語言對各翻一句暖機,是文件也建議的做法。
「低資源」是它的招牌,但這四個字有精確的適用範圍。實測行前程式:只載入英翻繁中一個引擎時,記憶體佔用約 735MB;再載入繁中翻英,漲到 1.35GB。每多一個同時載入的語言對,多吃約 600MB,帳是線性的。
它控制記憶體的手段是「用完就放」。每個引擎閒置超過 300 秒(可設定)會自動卸載,我在四個引擎同時載入、記憶體漲到 1.37GB 之後放著不動,引擎逐一到期釋放,佔用退到 727MB。模型檔本身不佔記憶體,四個語言對在磁碟上只有 193MB。
所以「1GB 記憶體就能自架一個翻譯服務」這個說法成立的條件是:你一次只用一個語言對。如果打算讓全家或整個辦公室拿它翻各種語言組合,記憶體請按「600MB 乘以同時上線的語言對數量」再加作業系統開銷估算,或把閒置逾時調短,讓引擎輪流上場。
「離線翻譯」是它的核心賣點,翻譯當下資料不出門也是真的:譯文由本機的 WebAssembly 引擎算出,沒有任何雲端 API 介入。但從安裝到真正離線,中間有三個需要連網的時刻,文件寫得分散,這裡一次整理。
第一次是啟動。伺服器跑起來時會向 Mozilla 拉取模型清單,這一步失敗就起不動。GitHub issue 上有現場:#154 的提問者用 Docker 部署,啟動時抓檔逾時,容器陷入無限重啟;#156 接著給解法,照官方 compose 再掛上兩個資料卷,把抓下來的東西持久化,重啟就不必重新下載。這不是冷門情境,斷線、防火牆或下載來源不穩都會踩到。
第二次是每個新語言對的模型下載。真要完全離線的部署順序是:連網狀態下用 --download en_zh-Hant 這類指令把需要的語言對備齊,再以離線模式啟動,之後就完全不連網。直接在離線模式裡翻一個沒備料的語言對,是拿不到結果的。
第三次跟硬體有關。標準版的引擎用 WebAssembly SIMD 指令集,需要較新的 CPU;原始碼裡遇到不支援的處理器會明確退出,並提示改抓 legacy 版本,發行版也確實為各平台準備了 legacy 變體。這點我沒有舊機器可以驗證,2015 年以前的老機器或某些精簡的虛擬機環境,裝之前先確認指令集支援。
另外提醒一件預設行為:不設定 API token 時,翻譯端點完全開放,我在本機測試從頭到尾沒帶過任何鑰匙。放在區網內自用沒問題,一旦掛上公網,等於任何人都能用你的機器、你的電費翻譯,記得設 MT_API_TOKEN。
這是最容易踩、後果又最直接的一坑。同一句英文,目標語言填 zh,出來的是簡體字形;填 zh-Hant 或 zh-TW,出來才是繁體。原始碼裡的語言代碼對照表寫得很明白:zh 與 zh-CN 都映射到簡體,zh-TW、zh-HK、zh-Hant 才映射繁體。UI 裡的語言選單也是同樣邏輯,Traditional Chinese 是獨立選項,預設停在 Simplified Chinese。
這件事會順著相容介面一路延伸。用 DeepLX 相容端點時,目標語言送 ZH,實測拿到的答案是標成 ZH-HANS 的簡體輸出。所以在沉浸式翻譯這類外掛裡接自訂 API 時,目標語言欄位請明確填繁體代碼,不要依賴外掛的自動判斷。
伺服器自帶一個簡單的 Web 介面和一份 Swagger API 文件,瀏覽器直接開本機 8989 就能用,介面裡翻譯、歷史紀錄、深淺主題都有,語言選單同樣把 Traditional Chinese 列為獨立選項。不寫程式的人光靠這個介面就能把它當桌邊翻譯機用。
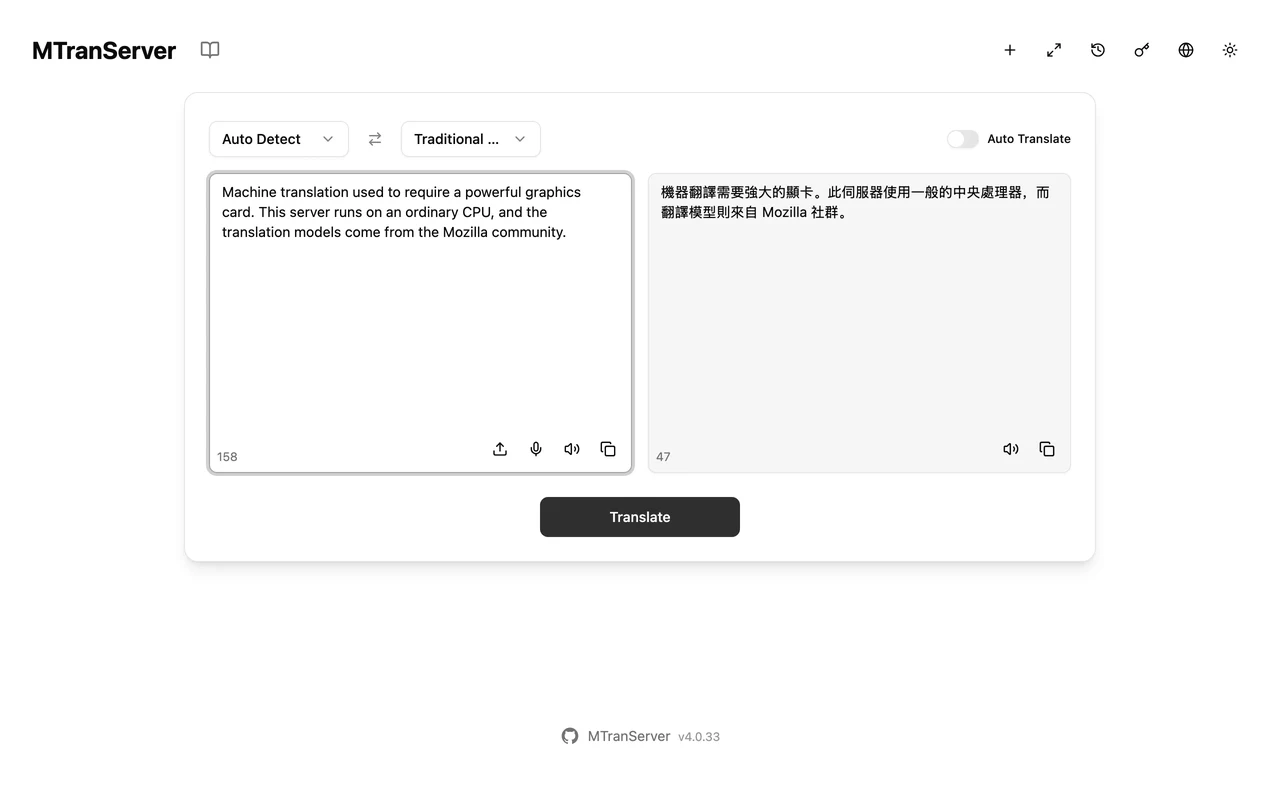
附帶一個好消息:繁中模型 2026 年 1 月才進貨,代表這條供應鏈對繁中的支援是新的、還在擴充的階段。以 Firefox 翻譯功能的使用基數當後盾,繁中模型的後續維護不需要只靠這個伺服器專案的作者。
它吸引人的地方之一,是相容介面給得很齊,共七種:沉浸式翻譯用的 /imme、簡約翻譯用的 /kiss、DeepL 官方 API v2 格式、DeepLX 格式、選字翻譯類外掛的 /hcfy、Google Translate API v2 格式,以及 Google 網頁版的 translate_a/single 格式。
我實測其中三種:Google v2 格式(帶 source、target、q 欄位)拿到標準的 Google 式 JSON 答覆;DeepLX 格式送 text 加 source_lang,拿到它仿 DeepL 免費版的 JSON;沉浸式翻譯的批次格式 text_list 一次送兩段,兩段都正確譯成繁體。要注意欄位名稱要照各端點的文件填,格式不對時它不會猜你的意思,直接給 500 錯誤,照著 Swagger 文件改欄位就好。有個小細節見微知著:沉浸式翻譯端點的源語言被寫死成自動偵測,更新日誌說得直白,因為那個外掛經常送錯語言代碼,乾脆伺服器端代勞。
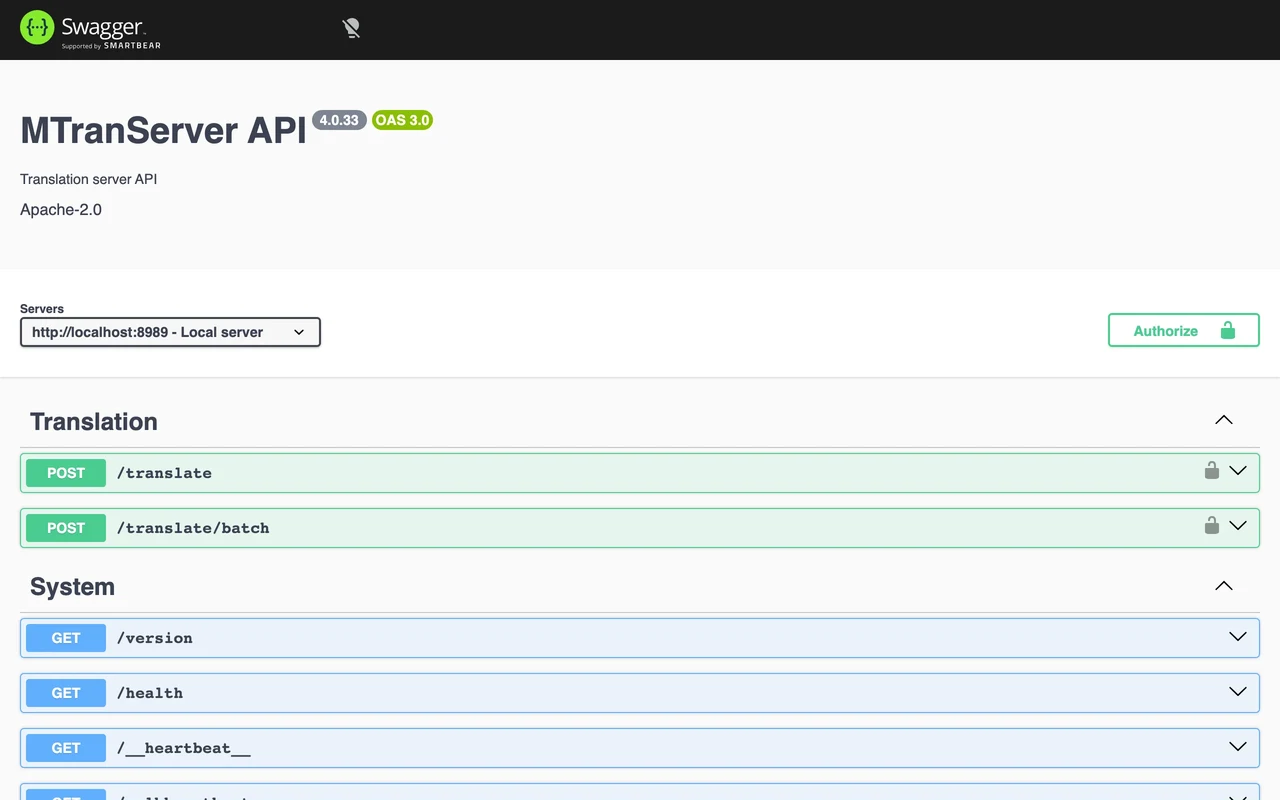
對多數人來說,這節就是全部的設定工作:伺服器跑起來,外掛裡把 API 位址指向本機 8989,結束。VS Code 生態另有同作者的註解翻譯外掛 MTranCode 可直接搭配;瀏覽器擴充官方頁面標示開發中,尚未釋出。
第一個是單次請求的長度上限。它上層的網頁框架對請求內文有 100KB 的預設上限,超過就得到 500 錯誤。我實際丟了一個 205KB 的請求,錯誤訊息原樣重現;GitHub issue #153 從 9 月初反映至今沒有得到答覆,也沒有設定項可以調高。實務上的意思是:整本書、整份長文件想一次送進去翻是不行的,要自己切段、批次送,這對想做文件翻譯管線的人是必修課。若你的需求是 PDF 整本翻譯,先看 BabelDOC 開源 PDF 翻譯 那種專門工具會更順。
第二個是沒有直接模型的語言組合會繞路。我請它把一段繁中翻成日文,它自動下載了繁中翻英、英翻日兩組模型,走兩跳完成任務。能用,但譯文明顯生硬,等於一句話被轉手兩次。109 個模型對聽起來很多,缺口仍然存在,日韓與中文之間就沒有直達車,這種組合建議先試一句再決定要不要信任它。
專案現況要誠實說:main 分支停在 2026 年 1 月,最新版 v4.0.33 是 2026 年 3 月發布,之後程式碼沒有再動。但周邊數字顯示使用基數是真實的:Docker Hub 官方映像檔累計超過 16 萬次拉取,npm 上 17 個版本的發布史,桌面安裝包在 Windows 上單一版本就有 2,800 多次下載,issue 區到 9 月還有人開新單,也有人在清整舊單。它不是棄坑專案,是進入穩定期的工具。
安裝形態有三條路,各自對應不同人。npm 套件(要 Node 18 以上)一行指令就起,最適合試水溫;Docker 映像檔適合常駐部署,環境變數把連接埠、離線模式、token、快取大小都開出來設;桌面安裝包(Windows、macOS、Linux 都有)裝完是一個常駐通知列的應用程式,附開機自動啟動選項,給不想碰終端機的人。另外 Linux 伺服器用戶可以直接抓各平台的獨立執行檔,repo 裡連 systemd 服務檔都備好了。
有個小斷點值得知道:早期介紹文章會指引一個官方網站(mtranserver.2020818.xyz),那個站現在是 404,2025 年春天時還營運著。作者把獨立站收了,現在的入口就是 GitHub、npm 與 Docker Hub,文件齊全度靠 repo 的 README 與多語文件撐著,也算夠用。
授權與資料的邊界整理如下:伺服器本體 Apache-2.0,商用自架沒有授權疑慮;模型跟著 Mozilla 的 Firefox 供應鏈走,模型庫專案本身是 MPL-2.0。翻譯過程在本機完成,你的待譯內容不會因為翻譯這個動作離開機器,這點對隱私敏感的使用者是真優勢,也是它相對雲端翻譯 API 最本質的差異。
適合誰:有常開機器(NAS、小主機都行)、翻譯量大到不想按次付費、資料不想出門的人;想把它接進自己的程式或外掛,七種相容介面省下大半工。不適合誰:要出稿品質的正式文件,以及想單次送整本長文、機器記憶體又只有 1GB 的人。想先看看效果,公共實例可以試兩句;想認真用,一行 npx mtranserver@latest 起服務,瀏覽器開本機 8989 的 UI,語言選 Traditional Chinese,翻一句看看,這一套流程半小時內能讓你知道它跟你的工作流合不合。若你對自架語音服務也有興趣,微軟 Azure 語音自建服務 是同一條思路的另一個作品;遊戲類的即時翻譯需求則可以看 DeepRant 遊戲快捷翻譯 的做法。