TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

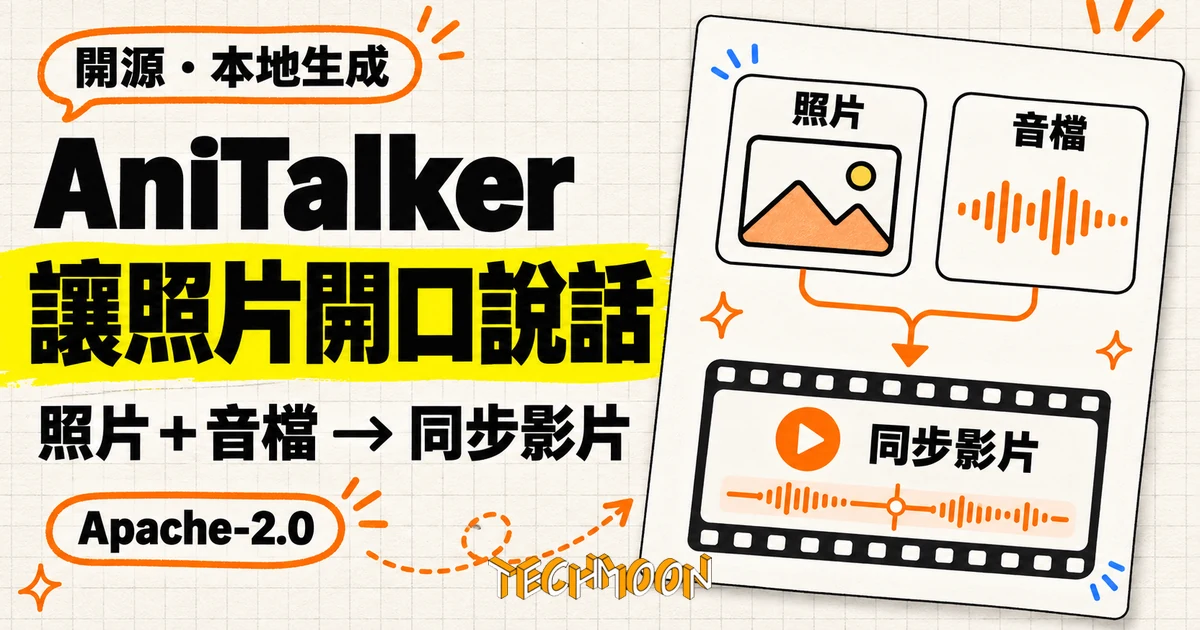
AniTalker 是上海交大 X-LANCE 實驗室開源的說話頭像生成框架,一張照片配一段音檔就能生成嘴形同步、表情自然的動畫影片;Apache-2.0 可商用但訓練代碼不釋出,依賴釘在 2021 年舊棧,RTX 50 系列裝不起來,Apple Silicon 有社群文件可照做,中文配音則是它自己承認的弱項。
用 AI 摘要這篇文章:
學術研究室把 AI 程式碼公開時,常畫一條看不見的線:能把論文結果跑出來的推論代碼給你,把模型養出來的訓練代碼留給自己。上海交通大學 X-LANCE 實驗室的 AniTalker 把這條線畫得特別清楚,連不公開的理由都寫在問答裡。想在 2026 年自架說話頭像(talking head)生成工具的人,這條線連同它的依賴版本與授權細節,比 GitHub 上 1,595 個星數更值得先讀。
AniTalker 做的事一句話講完:給它一張靜態肖像照加一段音檔,它輸出一段嘴形跟著聲音走、表情與頭部動作自然流動的動畫影片。論文 2024 年 5 月掛上 arXiv(編號 2405.03121),官方在倉庫描述自標獲 ACM Multimedia 2024 收錄,程式碼以 Apache-2.0 授權公開。下面把它的能力範圍、機器路線、中文限制與授權現實逐一攤開。
先把品類分清楚。TechMoon 先前介紹過的 LivePortrait 屬於影片驅動:拿一段別人的臉部動作影片,把表情與頭部姿態搬到你的照片上,過程中沒有聲音什麼事。AniTalker 屬於音訊驅動:輸入只有一張照片和一段聲音,嘴形、表情節奏、頭部晃動都由聲音內容推導出來。想做配音短片、知識影片口播人物,走音訊驅動這條路;想讓照片模仿某段表演,走影片驅動那條路。
方法上,作者宣稱的關鍵在「身份解耦的臉部動作編碼」。白話說,模型把「這張臉長什麼樣」和「這張臉怎麼動」拆成兩組資訊分開學:動作部分靠同一個人的影片裡前後影格互相重建來學,身份部分用度量學習另訓一個編碼器,兩者之間還刻意壓低互相洩漏的資訊量。論文摘要的說法是,這樣學到的動作表達能捕捉細微表情與頭部動作,而不只應付嘴唇開合。生成多樣性則交給擴散模型加一個變異數適配器:同樣的控制訊號會長出姿勢與表情相近、但帶著隨機變化的不同結果。這些都是論文與官方展示頁的宣稱,本文沒有重現生成過程,成品長什麼樣以官方 demo 頁的展示影片為準。
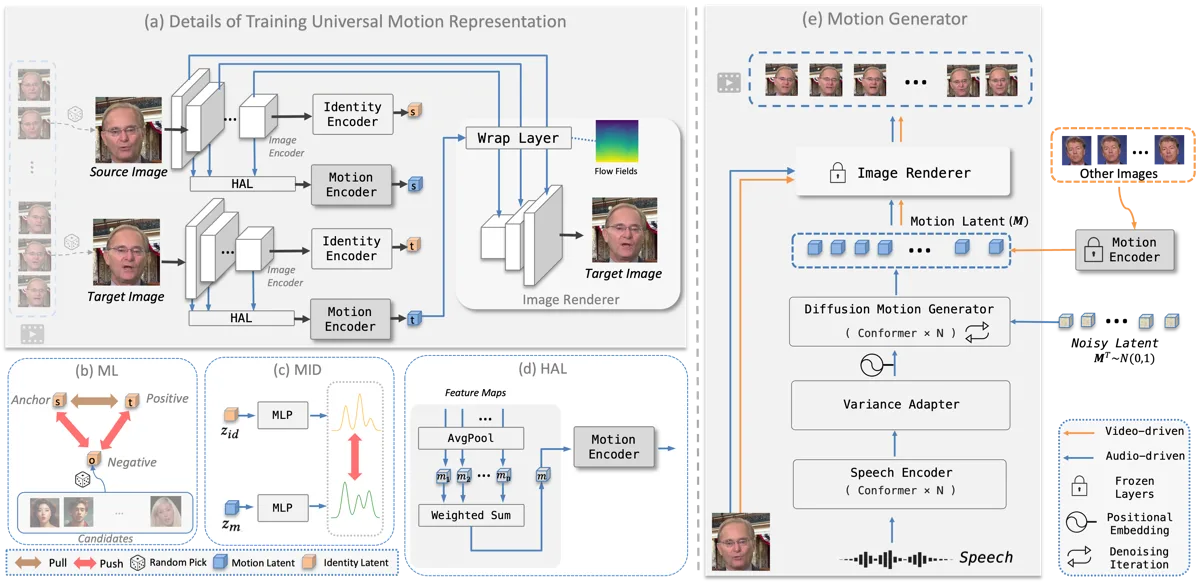
與坊間雲端產品相比,它的定位是研究框架而非服務。你拿到的是完整的推論程式碼與預訓練權重,在本機生成,不限次數、不收月費,代價是安裝與維運全靠自己。
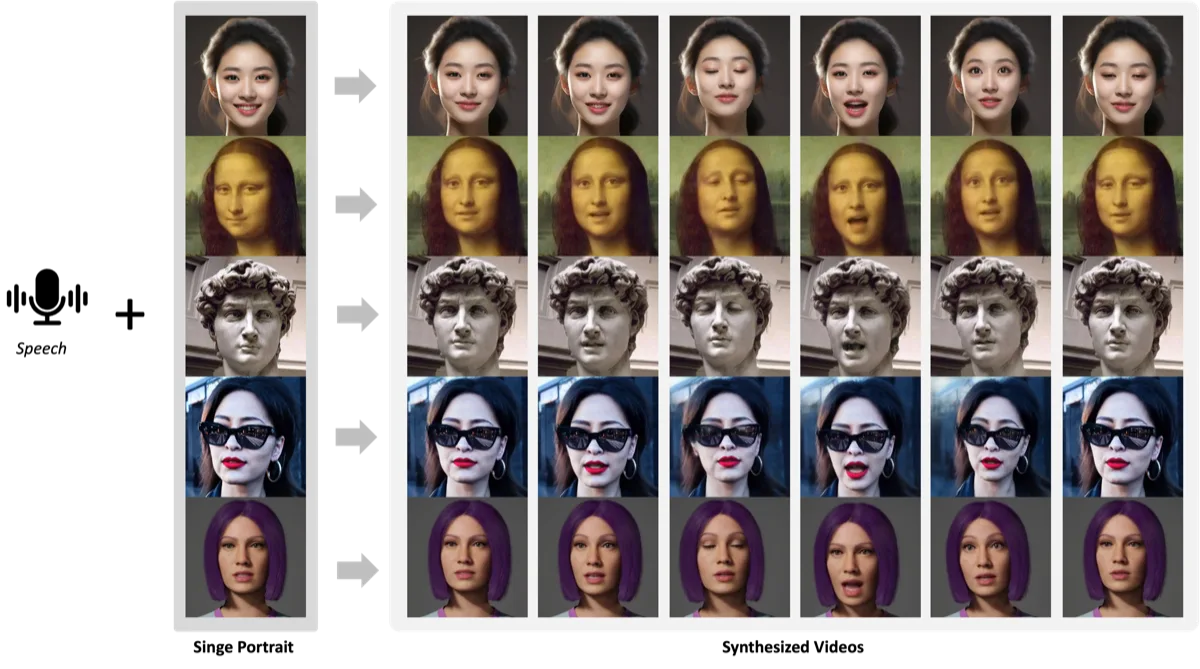
擴散模型那半套還帶來一個實用副作用:同一張照片、同一段音檔,跑兩次會得到姿勢與表情相近、細節不同的兩個版本。官方展示頁把這個特性攤開來展示,同一組控制訊號排成一列,每個欄位都是一次新的隨機取樣。對要做內容的人,這等於同一段口白可以低成本生出多個 take,挑最順眼的那個用。
展示頁的案例選擇也透露了它的能力範圍:驅動對象除了真人肖像,還放了雕像與卡通人物。身份解耦的設計讓它不挑「臉是不是真人」,只要前置偵測抓得到臉部,油畫、雕像、動漫角色都能開口,這也是它與標榜寫實的商業數位人產品明顯不同的地方。
AniTalker 的授權檔是完整的 Apache-2.0,法律上允許商業使用、修改、再散布。但 README 的問答區有一條寫得直白:考量擬真模型伴隨的風險與倫理疑慮,團隊決定不釋出訓練腳本與其他 checkpoint,並為造成的不便致歉。換句話說,開源的是「拿權重來生成」這一層,想要用自己的資料微調或重新訓練,這條路在專案現狀下不存在。
免責聲明同樣值得讀完。官方明言這套代碼不是正式產品、未涵蓋所有使用情境測試,不能直接當作終端服務上線;公開的目的是學術展示與交流,禁止用來散播有害資訊;生成結果的責任由使用者自負,背後公司(思必馳 AISpeech)不為輸出內容負責。Apache-2.0 給你法律上的商用許可,這五條聲明則告訴你產品化要自己扛哪些風險。
生成他人肖像還有授權以外的法律層。拿誰的照片、配誰的聲音,都應取得當事人同意,深偽相關法規在各國都在收緊,這不是工具授權條款能替你擋的部分。
打開 requirements.txt,釘死的版本號是一整排 2020 到 2022 年的名字:torch==1.8.0、numpy==1.19.5、transformers==4.19.2、pytorch-lightning==1.6.5、scipy==1.5.4,環境要求 Python 3.9.0 加 cudatoolkit 11.1。這在論文發表的 2024 年已經是舊棧,到 2026 年又舊了兩輪。新機器上裝不起來,多半卡在這裡,而不是卡在你的操作。
NVIDIA 新卡的處境特別明確。Issue #42 記錄了升級到 Python 3.11 加 CUDA 12.6 裝不起來的嘗試;2025 年 5 月的 Issue #50 更具代表性,一位經常使用它的使用者表示這工具跑短語影片又快又順、他不介意 256 像素的輸出,但換到需要 PyTorch 2.7 的 RTX 50 系列之後,安裝再也調不起來,公開詢問是否有更新計畫。截至 2026 年 11 月,這個問題沒有任何維護者回覆。
相對地,Apple Silicon 有官方倉庫內的社群文件可照做。貢獻者 airwzz999 寫的 macOS 安裝指南記錄了兩台實測機器:M1 Pro(16GB 記憶體)與 M3 Max(128GB),安裝時不釘 PyTorch 版本、改用當前版,另把語音處理庫 espnet 釘在指定提交。依這份文件判斷,Mac 路線避開了 Linux CUDA 路線的版本地層,是 2026 年相對可行的自架選擇;不過這是依文件內容做的推論,不是本文的安裝實測,個別機型仍可能遇到文件沒寫到的坑。
訓練資料以英語為主,是 README 最佳實踐區塊自己承認的限制:官方明言模型主要吃英語語音內容,其他語言的音檔可能出現嘴唇小幅度誤動或畫面變形。對台灣讀者這是第一個該知道的邊界,想配中文口白,成品品質要先打折扣預期;官方建議的用法是英語音檔驅動;中文內容的務實做法,是生成後自己在後製換上中文聲音軌。社群側也有相應回報,Issue 清單裡看得到頭部晃動過大、成品抖動等紀錄,可對照官方最佳實踐列出的輸入條件建議。
另一個先講好的期待是解析度。輸出基準只有 256×256,官方問答區給的高解析路徑是接上 SadTalker 的超解析模組把成品拉到 512×512 級距,這個模組在倉庫裡已經整合好,屬於選配。256 對社群短影音的頭像框夠用,要做更大畫面的成品,就要多一道後處理。
還有幾個小限制順手記下:模型只處理臉部與周邊區域,不會生成半身或全身;視線方向不在建模範圍,官方建議用控制訊號讓目光盡量朝前,否則眼神會顯得放空。輸入照片也有眉角,官方最佳實踐提醒:頭擺畫面中央、臉別占太大,姿勢控制時生成角度貼近原照角度最穩,硬要從正面照生成大側臉,2D 變形的風險會直接反映在成品上。訓練資料也以理想條件為主,劇烈環境變化與非正常語速都不在它擅長的範圍裡。
安裝流程以 README 記載為準:用 conda 建 Python 3.9.0 環境,Linux 上裝 pytorch==1.8.0 加 cudatoolkit=11.1,再跑 pip install -r requirements.txt。Mac 使用者改照前述 macOS 指南,Windows 也有社群教學可參考。
權重下載自 Hugging Face 的 taocode/anitalker_ckpts 儲存庫(儲存庫共 11 個檔案,其中權重檔 9 個),放入 ckpts 資料夾;針對中國大陸網路環境,官方另給了百度雲端硬碟連結。模型是兩階段設計:stage1.ckpt 在單張照片的影片資料集上訓練,學的是「把動作搬到別的臉上」這件事,訓練完成後提供動作編碼器與影像渲染器;第二階段的五個 checkpoint 在帶聲音的影片資料集上從頭訓練,差別在音檔特徵來源(HuBERT 或 MFCC)與控制訊號的多寡。官方 README 整理的對照如下(倉庫最後更新 2024 年 8 月):
| Checkpoint | 音檔特徵 | 額外控制訊號 | 定位 |
|---|---|---|---|
stage2_audio_only_hubert.ckpt | HuBERT | 無 | 官方建議的起點,正面臉不需要調參 |
stage2_pose_only_hubert.ckpt | HuBERT | 頭部姿勢 | 想控制轉頭方向時用 |
stage2_full_control_hubert.ckpt | HuBERT | 頭部姿勢、位置、縮放 | 控制粒度最細 |
stage2_pose_only_mfcc.ckpt | MFCC | 頭部姿勢 | 輕量路線,效果讓位 |
stage2_full_control_mfcc.ckpt | MFCC | 頭部姿勢、位置、縮放 | 同上,不建議 |
兩族特徵的取捨,官方問答區講得比多數論文誠實。HuBERT 效果穩、跨語言表現好,但依賴重、占硬碟;MFCC 輕快、容易收斂,代價是表達力弱、跨語言推論較差,而且碰到 TTS 合成語音或靜音段,容易出現抖動、過度平滑或表情過頭。官方在 README 的推薦與不推薦標記都圍繞這組取捨,選模型時照著自己的音源類型挑就好。
進階玩法官方也留了路:想讓照片模仿另一個人的角度與頭部動作,可以搭配團隊開源的臉部前置處理工具,把驅動來源的姿勢抽出來餵進控制訊號;README 還有一區社群投稿藝廊(User-submitted Gallery),收錄使用者的實際成品,目前條目不多。
不想碰命令列的話,倉庫裡有貢獻者 yuhanxu01 寫的網頁介面 webgui.py,也有對應的 Colab 筆記本。要留意的是,另一條零安裝路線已經斷了:Hugging Face 上社群維護的 Delik/Anitalker Space,截至 2026 年 11 月的狀態是建置失敗(BUILD_ERROR),2024 年 9 月後就沒有再更新。想先看效果,直接到官方 demo 頁看展示影片,比找線上 demo 可靠。
回頭看社群生態的時間線,會發現這個專案的「活著的時間」非常集中:Windows 教學、macOS 教學、網頁介面、Colab 筆記本、HF Space、YouTube 影片教學,全部落在 2024 年 8 月上旬的兩週內到位,貢獻者各有其人,隨後專案在 8 月 15 日推送最後一批更新後靜止。那兩週像是一個暑假專案的收工衝刺,成品都留下了,但也停在留下的那天。
它適合的人相當具體:有 Mac 或舊世代 NVIDIA 卡、想零費用在本機批量生成英語配音的說話頭像短片、且能接受 256 像素成品的開發者與研究者。論文等級的動作表達、Apache-2.0 的授權彈性、生成速度快的社群評價,是這群人值得裝的理由。
反過來說,需求不同就有更省事的路。想的是「一套裝好就能用的開源數位人系統」,AIGCPanel 這類整合面板把模型、語音、對話介面都配好了;想顧 2D 虛擬形象搭配聊天機器人,Live2D 數位人工具 更貼合;要商業級畫質與中文口播、也願意付費,HeyGen 這類雲端影片與語音 API 不用處理任何依賴。AniTalker 的價值在自架、免費與研究透明,這三個條件缺一個,都該先看別條路再回頭。
回到開頭那條線。AniTalker 把「開源到哪裡」誠實寫在文件裡,也把維護終點留在提交紀錄上;2026 年還想用它的人,讀懂這兩件事,再對照自己的機器與語言需求,一個下午值不值得花,答案其實已經很清楚。