TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

美國專利商標局 2026 年 10 月 29 日公開 Microsoft 專利申請 US 2026/0341309 A1,描述直播時用生成式 AI 即時替換說話者的用詞並重繪嘴型。本文拆解申請公開與核准的差別、20 項請求項的主張範圍,以及 Teams Interpreter 產品線的距離。
用 AI 摘要這篇文章:
2026 年 10 月 29 日,美國專利商標局公開了一份 Microsoft 提出的專利申請,編號 US 2026/0341309 A1。這幾天社群把它轉述成「Microsoft 專利讓 AI 即時改寫你說的話,連嘴型都跟著改」。文件確實描述了這樣的系統,但先把狀態講清楚:這是一份專利申請的公開文件,不是核准的專利,更不是產品。報導這件事的科技媒體 Futurism 在 11 月 1 日的文章裡寫明,Microsoft 沒有回應置評請求。
「只是申請」卻值得認真讀,因為這份 27 頁的文件把一套直播改寫系統的主張範圍寫得相當具體:從濾掉贅詞,到即時事實查核,到把說話者的嘴型重繪成翻譯後的字。把它從頭讀完,真正值得留下的判斷有兩個。一個是它主張的修改範圍遠比「濾贅詞」大;另一個是 20 項請求項裡,沒有任何一條要求向觀眾標示畫面已經過修改。
對一般觀眾,這份文件的意義是看懂「畫面與聲音可以被無縫替換」正在變成可申請專利的工程題目;對內容製作者與平台,意義是標示與同意機制完全不在這份技術主張的範圍裡。以下用 USPTO 公開文件與 Microsoft 官方說明頁的原文,拆它實際主張了什麼、沒主張什麼,以及它和 Microsoft 自己產品線的距離。
文件首頁的文件類型欄印的是 Patent Application Publication,專利申請公開。公開的意思是內容可供任何人查閱,與審查結果無關:請求項最後會留下多少、駁回多少,要看後續審查。書目欄的其他資訊:申請日 2025 年 4 月 29 日,公開日 2026 年 10 月 29 日,正好相隔 18 個月,這是美國專利申請案的標準公開時點;申請號 19/193,093;發明人列 David Callaghan 與 Dinesh Kumar;申請人是登記在 Redmond 的 Microsoft Technology Licensing, LLC。
案件目前的進度也有紀錄可查。第三方專利追蹤站 Patentlyze 的案件頁顯示,審查官已在 2026 年 7 月 29 日對請求項提出異議,該站同時註明這是頁面發布當下的狀態;正式審查紀錄以 USPTO Patent Center 的查詢結果為準。換句話說,這份申請連第一輪審查都還沒走完,最後會拿到什麼範圍的專利(如果拿得到),是幾年後才會揭曉的事。
媒體端的用語則比文件狀態跑得快。Futurism 報導的標題用的是「Microsoft Patents」,以取得專利的動詞描述一份申請公開文件,語感上往前跳了一大步;社群貼文再把它推成「AI 已經可以改你說的話」,兩層放大之後,文件本身反而沒有人打開來讀。連文件自己的標題都值得對照:正式名稱是「直播活動之影片或擴增實境呈現的近即時人工智慧強化」,用的是強化,不是改寫。兩個詞描述同一套流程,但語氣差很多,這正是讀文件比讀轉傳可靠的地方。
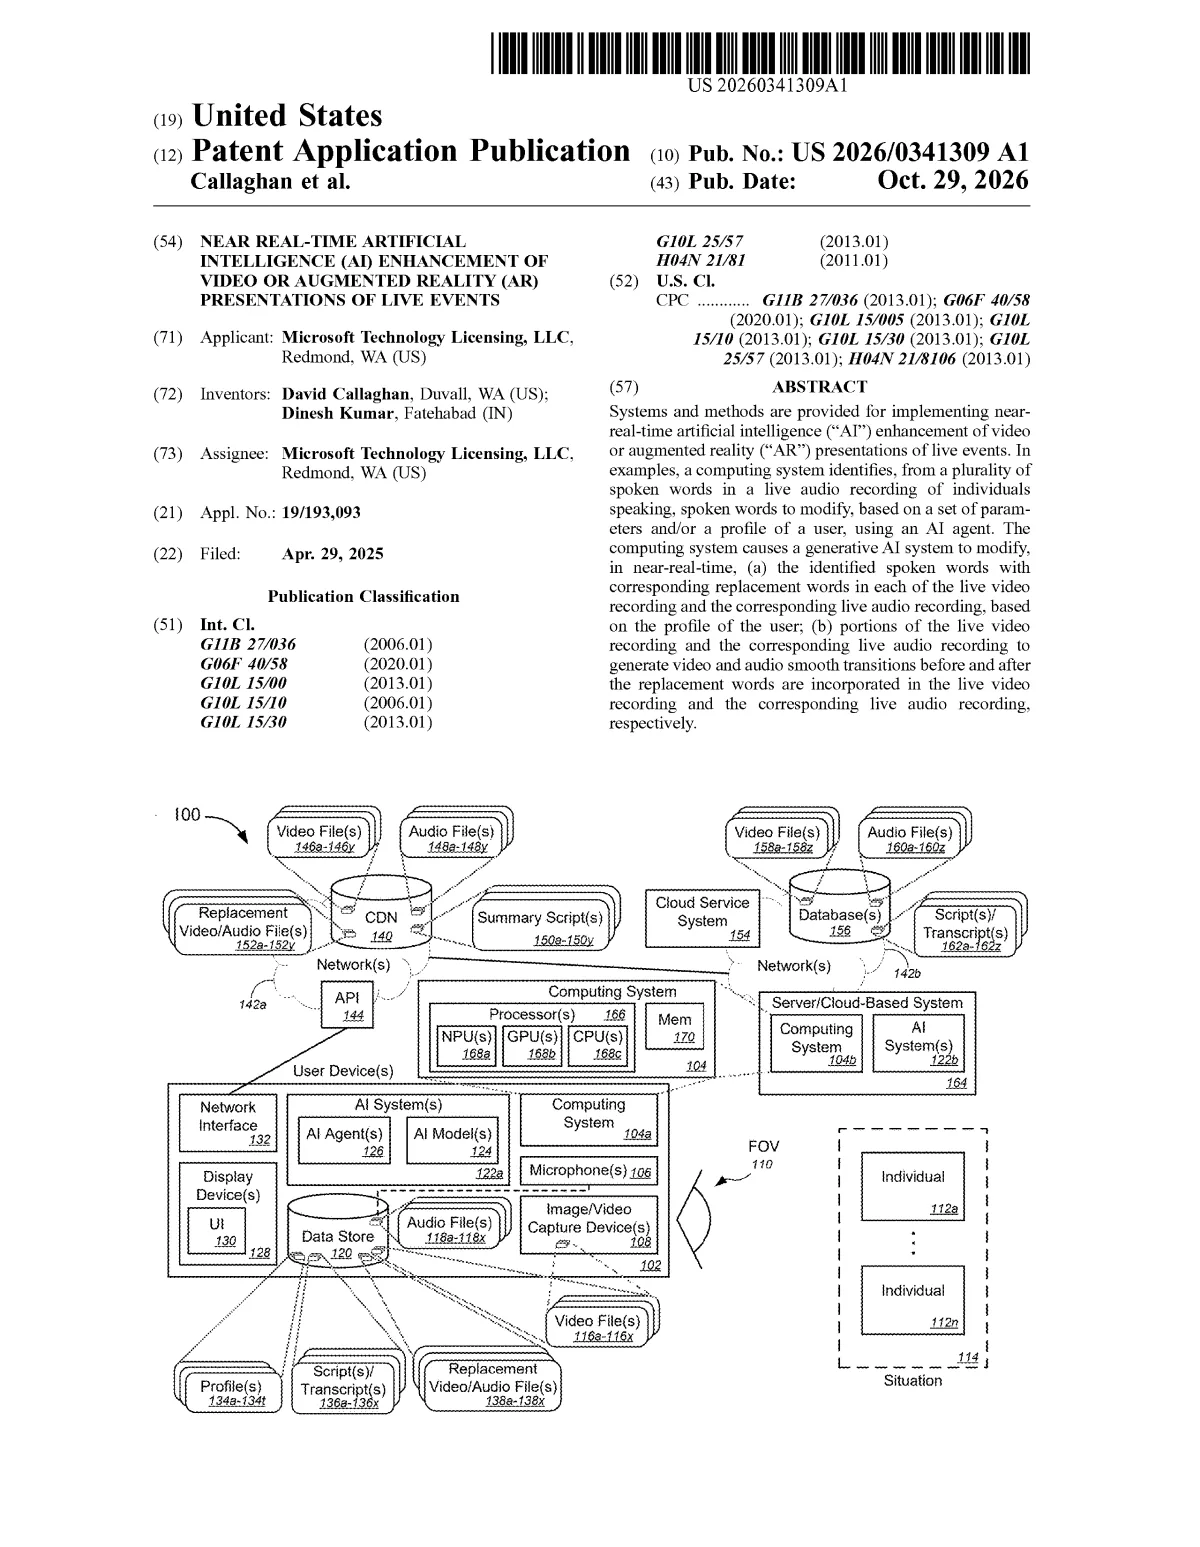
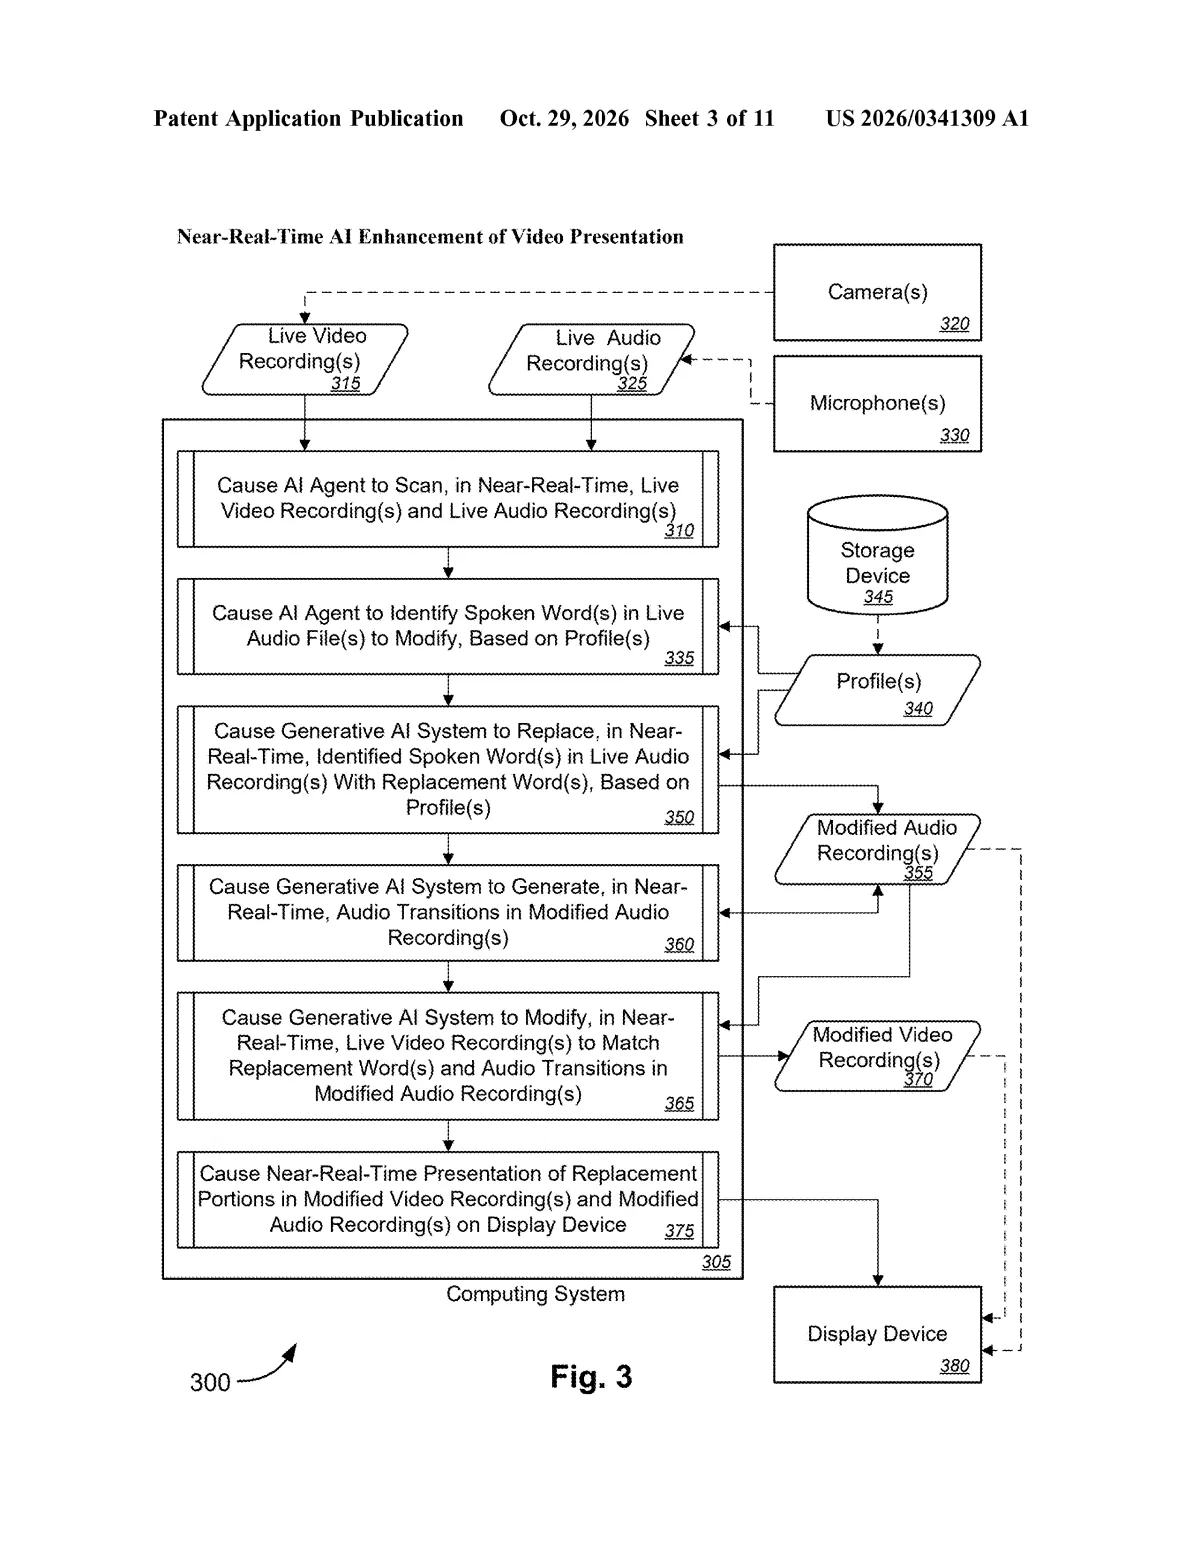
文件的圖 3 把直播版本拆成六個操作。AI 代理先在近即時狀態下掃描直播的影像與聲音;接著依一組參數和使用者資料,從掃到的口語裡挑出要修改的字;再由生成式 AI 把這些字換成替代字,同時在替代字前後生成聲音轉場,避免聽起來斷裂;然後修改影像,讓畫面配合新的聲音;把替換過的段落送上顯示裝置。值得注意的是送出來的東西:觀眾在畫面上看到的,是替換後的影音段落。
「近即時」在說明書有自己的定義:幾秒之內,文件舉的例子是 1 到 10 秒;或是現代直播本來就保留的人工調整延遲,文件稱之為 live feed buffer,這段緩衝在既有廣播裡用來處理髒話之類的突發狀況。兩種讀法差很多,一種是 AI 在幾秒內完成替換,另一種是直接借用廣播標準的安全延遲。實際採用哪一種、延遲多少,說明書未著墨。
而且直播只是文件的一半。另一條路徑是錄影後的後製版:先修改逐字稿,再依改好的稿子修改聲音與畫面。講稿也能接進直播路徑,請求項 9 允許以實際說出的字與講稿的差異來挑字。換句話說,講稿上寫了、嘴上卻說成別的字的段落,正是它認為可以修的地方。非口語的聲音也在主張範圍裡,請求項 12 列了背景噪音與音訊回授的過濾;說明書另把超過門檻長度的口說停頓,例子是 5、10 或 15 秒,列為可移除的項目。
說明書第 0037 段還寫到一個更遠的用途:即時修正講者說出的不準確或有誤導性的資訊,做法是由 AI 系統上網搜尋並驗證講者正在說的內容,替代字也可以顯示在隱藏式字幕欄位。「AI 認定你說錯了,當場換掉」不是外界腦補,是文件自己寫下來的用途之一。
請求項 10 列出可以被替換或移除的字詞類型:贅詞、個人慣用語、口語用詞,含糊、唸錯、用錯、說錯的字,一路延伸到冒犯、不敏感、不恰當的字。說明書給的例子更具體,um、you know、basically 這類贅詞,dude、buddy 這類個人慣用語,gonna、ballpark 這類口語用法,都在可替換清單裡。
換上去的字從哪來?請求項 11 允許從網路搜尋或資料庫搜尋,抓取與談話主題相關的一般資訊。替代字不必是說話者本人的用語。這一點在濾贅詞的情境裡不明顯,放到翻譯或事實查核的情境就變得敏感:換上去的內容可以是系統自己找來的。
更關鍵的結構是「依誰的資料決定」。請求項 1 把挑字與替換都綁在使用者資料上,請求項 5 列出的欄位包括年齡、使用語言、出生地、居住地、族裔、文化背景、宗教、教育程度、大學主修、語音樣本、影像樣本,而且任一項或任意組合都成立。照這個結構推,同一段直播理論上可以對不同觀眾呈現不同版本,每個人的資料不同,被挑出來修改的字就不同。這是從請求項結構推出的推論,文件裡找不到直接演示。
不過文件也寫了自用的版本。說明書第 0027 段提到,有口吃或咬舌的說話者可以用這套系統修正自己的語音與畫面,說話者本人的資料也能建檔,用來生成屬於自己的替換影格。誰來決定改哪些字,在文件裡同時存在聽者、預期觀眾與說話者三種位置,並沒有限定一種。
嘴型重繪是翻譯情境裡的正式主張。請求項 16 寫的流程是:說話者使用的語言不在使用者資料列出的語言內時,AI 先辨識這些外語字詞,換成使用者語言的翻譯,生成聲音轉場,然後產生替換影格,影格必須包含對說話者嘴唇的重繪,讓畫面看起來像他本人說著翻譯後的語言。適用場景列得很廣,各國代表的聚會、國際會議、出國旅遊、社群影片、Podcast、電影電視、歌劇、演唱會、課程與簡報,都在請求項 17 的清單上。
裝置與運算位置也有交代。請求項 3 與 20 列了搭配音訊輸出的 AR 眼鏡、手機、平板與錄影裝置,AI 代理跑在 NPU、GPU 或 CPU 上;說明書另外寫到,部分方法可以由伺服器或雲端系統執行。運算落在裝置端還是雲端,文件沒有限定,這也代表資料會送到哪裡,要等真有產品才會揭曉。AR 眼鏡出現在清單裡另有意味:眼鏡上的畫面本來就是一副眼鏡一份,替換如果發生在這一端,依個人資料呈現不同版本,在架構上就是最自然的做法。
同一段 0027 還有一個多數轉述漏掉的細節:替換影格可以包含 AI 生成或輔助的鏡頭角度變化,例如把觀眾的注意力從講者導向現場觀眾、簡報投影片或替換素材。這套主張不只改字、改嘴,連鏡頭語言都能用生成內容替換。
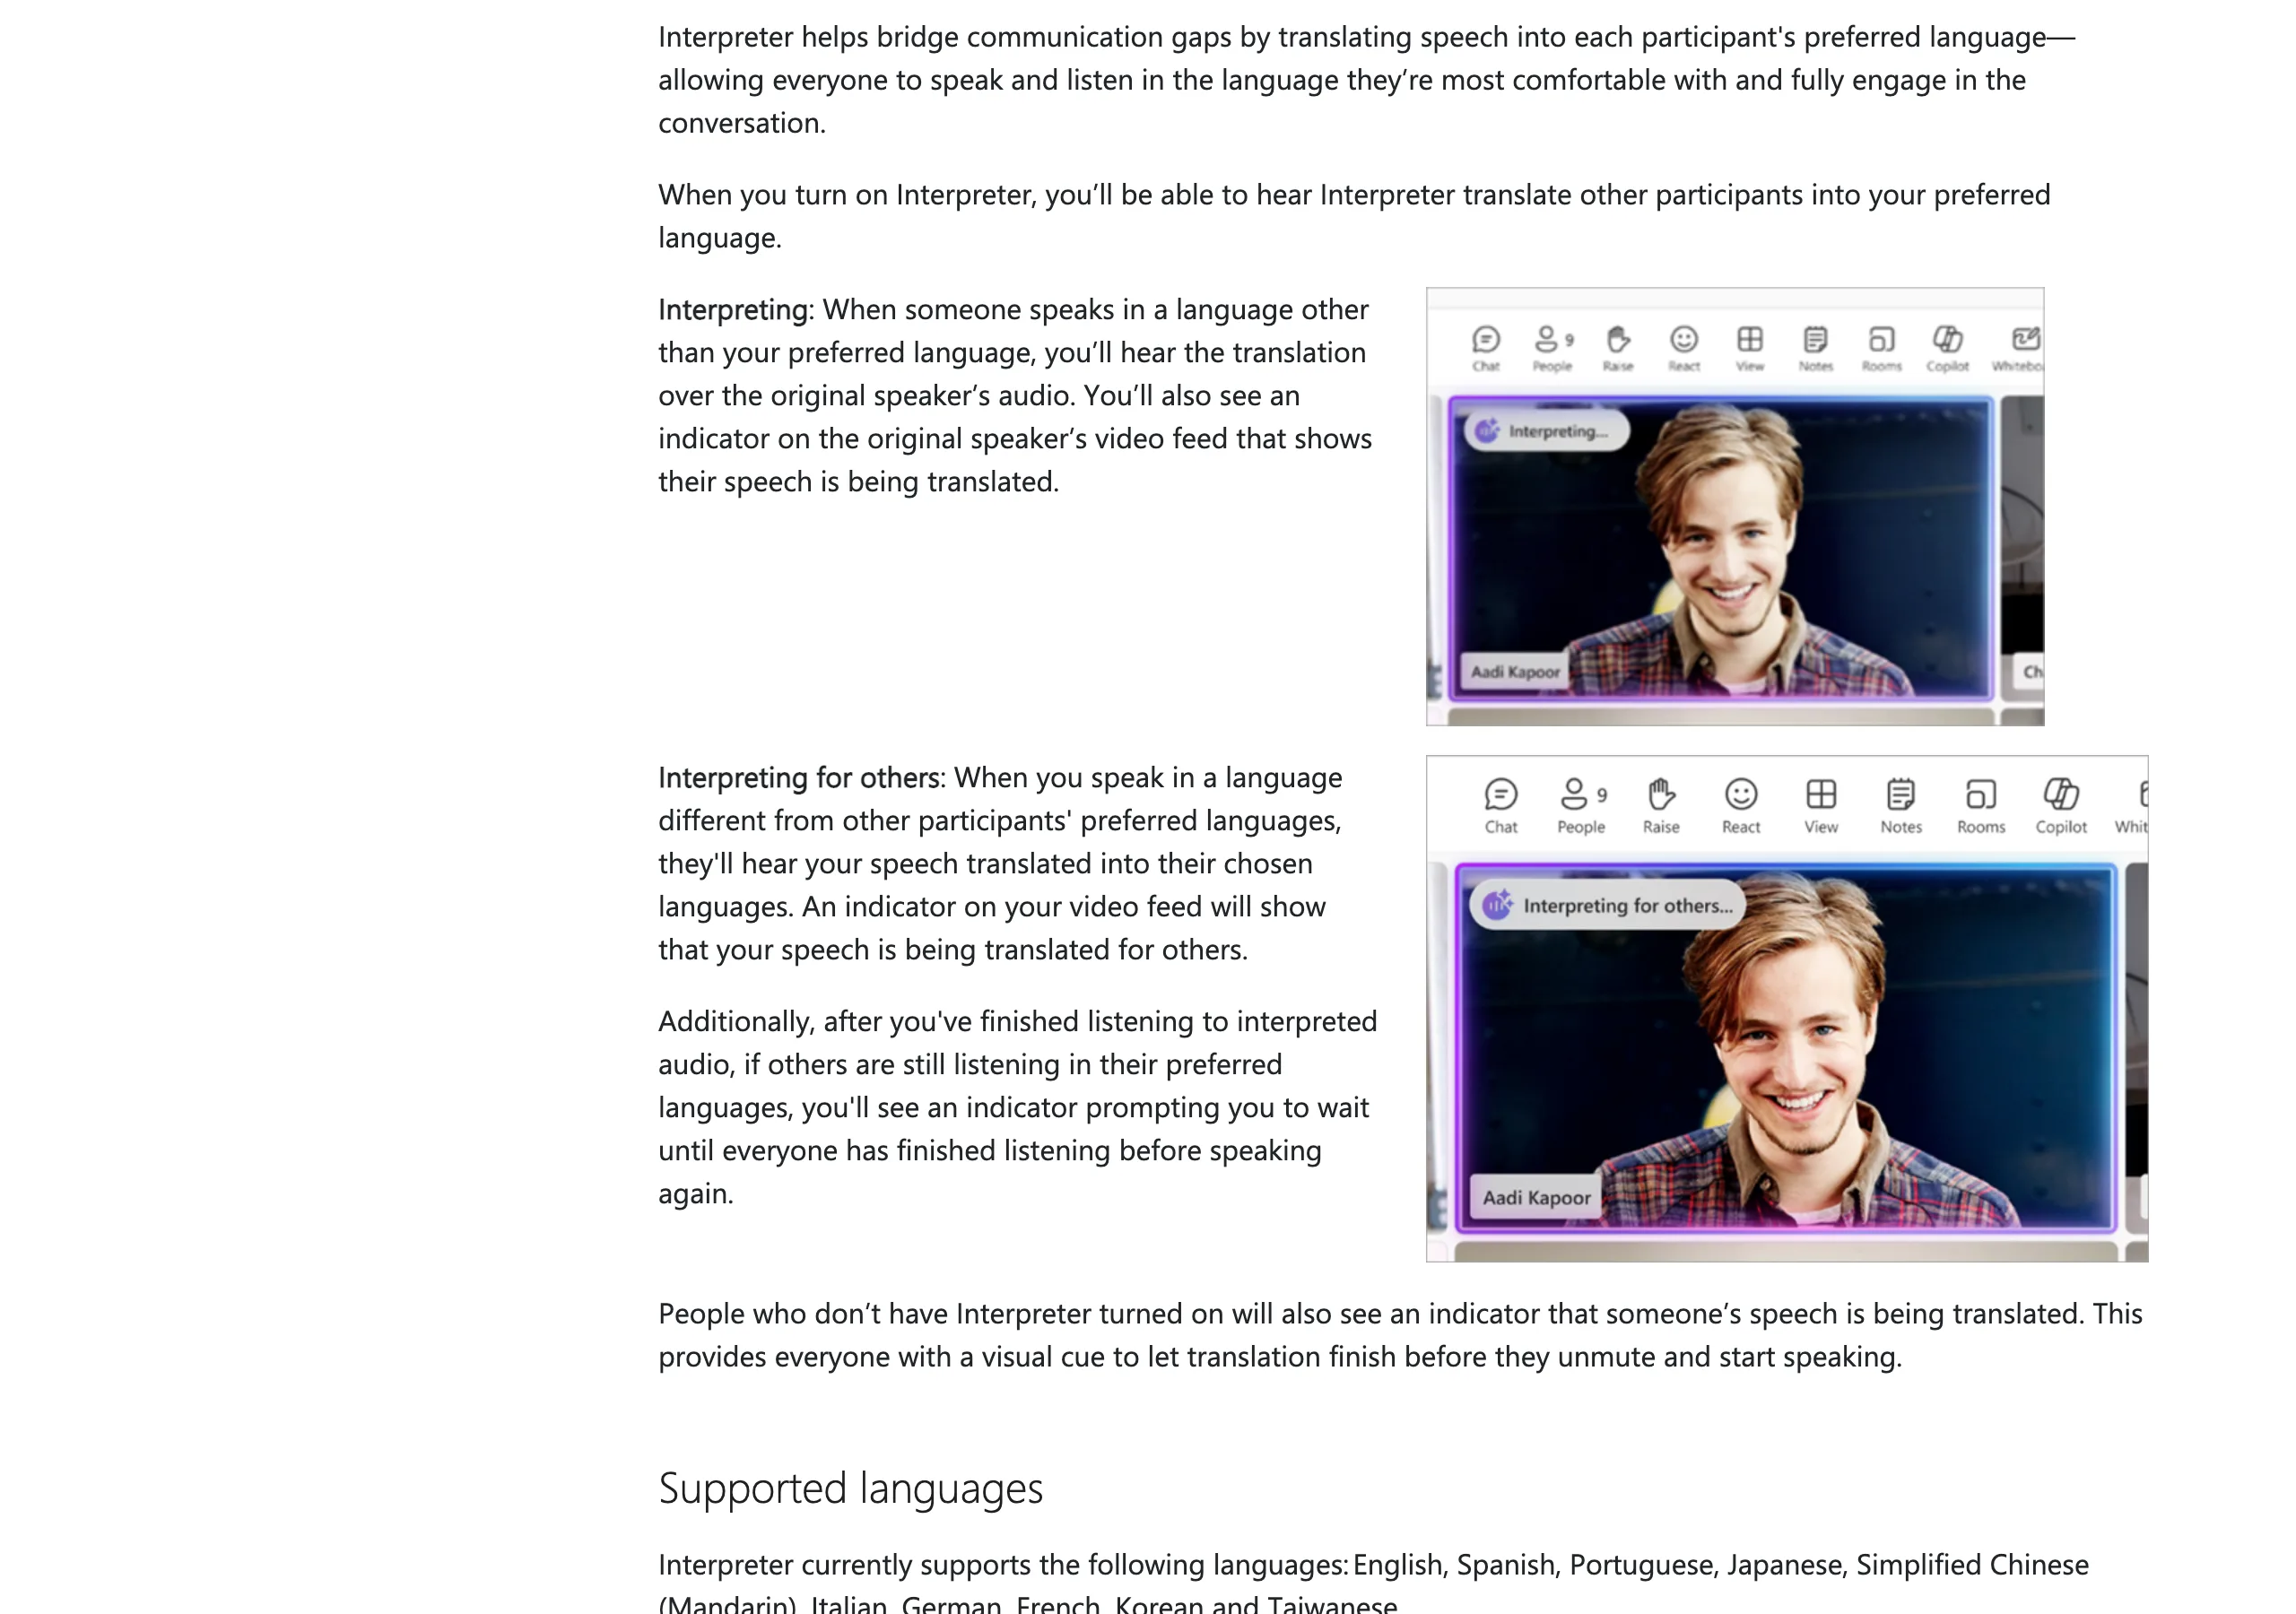
Microsoft 在這個方向上不是從零開始,Teams 的 Interpreter 已經是上架的功能。官方支援頁說明它提供會議與通話中的即時語音翻譯,聽的人在原說話者的聲音之上聽到翻譯,Copilot 授權每人每月含 20 小時翻譯時數,超出部分依可用容量而定。支援語言清單裡除了英、日、韓、法、德、義、葡、西與簡體中文,還列了 Taiwanese。
把官方兩頁說明從頭讀完,產品與專利主張的距離就看得很清楚。Interpreter 動的只有聲音:被翻譯者的視訊畫面會出現指示器,告訴所有人這段語音正在被翻譯;會議錄影只收原始音訊,翻譯逐字稿只在會議當下可看;官方也明講它不適合快速交談、插話與重疊對話。管理頁寫的流程是語音辨識、機器翻譯、語音合成,音訊由 bot 送上雲端處理,語音樣本與生物特徵資料不會儲存。兩頁都沒有提到修改影片或重繪嘴型。
支援範圍的邊界也畫得很具體:Interpreter 可以開在最多 1,000 人的會議,但臨時發起的會議、大型全員廣播、網路研討會與免費版 Teams 目前都不支援;通話場景只支援一對一的 Teams 網路通話。一個已上線功能把「在哪裡可用、錄了什麼、不擅長什麼」寫到這個程度,對照之下,專利申請只說了「可以這樣做」,兩者的成熟度差距一目了然。
專利申請描述的,是把同一個方向推到影像本體:不只翻譯聲音,還要讓畫面裡的嘴對得上。聲音翻譯這條線上,各家進展都很快,阿里巴巴的 Qwen3.8-LiveTranslate 已把同步口譯延遲壓到 2.3 秒;想自己拼一條影片翻譯配音流程的開源方案也早就存在,例如 Linly-Dubbing。這份申請想保護的,是這些能力往直播畫面本體延伸時的整條流程。
把 20 項請求項逐一讀完,向觀眾標示修改的義務不在其中。與保存有關的只有請求項 14:原始錄下的影音可以存為 ground truth,供日後參考。專門保留一份原始版本的設計,本身就預設了播出內容與原始內容可能有出入;至於原始版本存在誰手上、保存多久、誰可以調閱,文件同樣沒有交代。
這不是在指控 Microsoft 打算悄悄改畫面。專利請求項的功能是界定技術範圍,標示政策屬於產品與法規層,本來就很少寫進請求項。真正的訊號在對比:Microsoft 自己的 Interpreter 在只有聲音被翻譯的狀態下,都堅持在視訊畫面掛上指示器;當技術主張升級到改畫面本體,向觀眾揭露修改事實的機制,反而沒有出現在文件的任何角落。
觀眾端短期內能依靠的還是既有驗證工具,例如檢查 AI 生成簽章的 Image Provenance。文件的發明背景寫得很直白:講者會說贅詞、卡到不恰當的詞,既有系統只能盡可能高傳真地錄下來,事後移除需要專門工具與專業人員。這套系統要解決的就是這件事,而代價是觀眾失去判斷畫面是否為原始內容的依據。
追蹤這件事有兩個現成的入口。審查端用 USPTO Patent Center 查申請號 19/193,093,審查結果出爐才會知道 20 項請求項留下多少;產品端看 Teams Interpreter 的說明頁,哪天它從翻譯聲音跨到更動畫面,再回頭對照這份申請也不遲。
在那之前,把它當成一份公開的技術構想最合適:內容可以討論,時程不能推算。直播產業真正該開始想的問題是,當「所見即所說」變成「所見依你的資料而定」,觀眾的信任要建立在哪裡。