TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

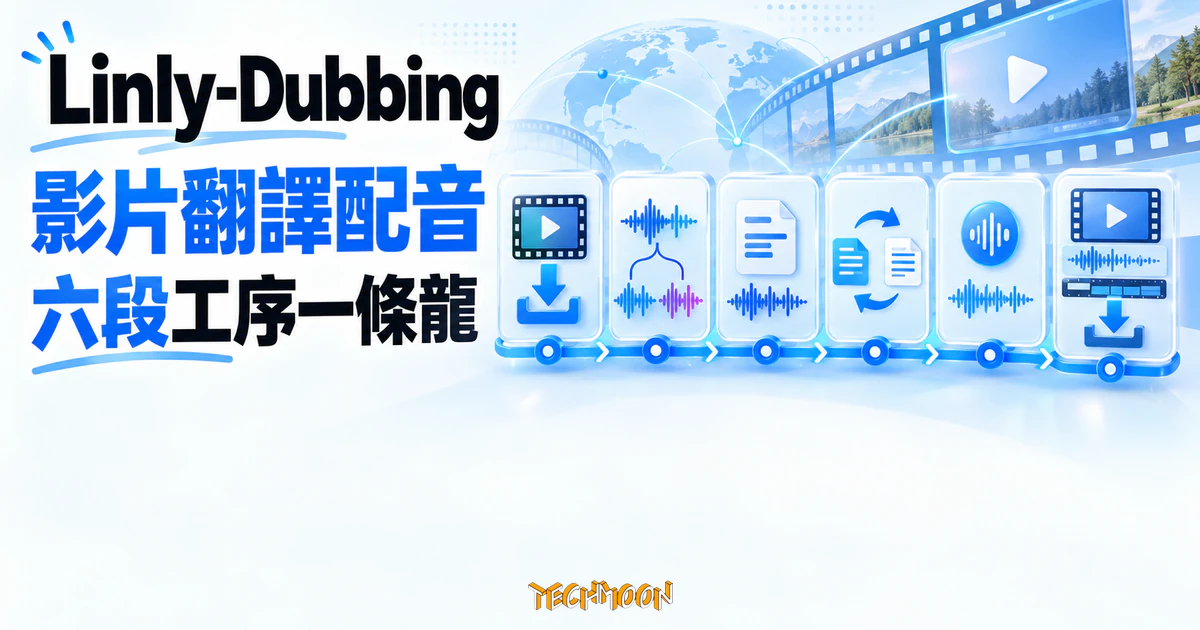
Linly-Dubbing 是把影片下載、人聲分離、轉錄、翻譯、配音、合成六段工序接起來的開源流水線,Apache-2.0 授權可商用;但招牌的數位人對口型在兩套介面都還是施工中佔位,主分支停在 2025 年 3 月,預設模型是 2024 年代,自架前值得拿仍在更新的上游 YouDub-webui 一起比較。
用 AI 摘要這篇文章:
想讓外語影片開口說中文,或反過來把中文影片推向國外觀眾,搜尋開源做法的人很容易遇到 Linly-Dubbing:GitHub 上 3,350 顆星、385 個 fork,倉庫簡介一句話的意思是「智能的多語言影片 AI 配音與翻譯工具」(原文為簡體)。同一場搜尋裡其實還該出現另一個名字,就是它自述的靈感來源 YouDub-webui:5,602 顆星,2026 年 9 月還在合併功能性更新。對照之下,Linly-Dubbing 的主分支最後一次提交停在 2025 年 3 月 5 日,距今十九個月。星數較少的那一個,剛好是被凍結的那一個。
先把定位講清楚。Linly-Dubbing 是一套把「抓影片、分離人聲、語音轉錄、字幕翻譯、配音、合成輸出」六段工序串起來的開源流水線,授權採 Apache License 2.0,操作介面有兩套:瀏覽器開的 Gradio 網頁版,以及 PySide6 寫的桌面視窗版。它的價值與它的邊界同樣明顯:README 列在主要特點裡的數位人對口型(原文件用語是「數字人對口型技術」,指讓畫面人物的嘴型跟著配音動),在兩套介面裡都還是掛著施工中提示的佔位分頁;README 宣稱定期更新、持續引入最新模型,程式碼庫卻已靜止超過一年半;預設接的翻譯模型與語音模型,全部停在 2024 年的版本。下面把可替換的零件、真正的邊界、以及它和上游 YouDub 的取捨一次攤開。文中引述的介面文字都轉寫成繁體。
翻開原始碼,這條流水線的骨架比想像中好讀。tools 資料夾裡的檔案直接以工序編號命名,從 step000 到 step050:step000 用 yt-dlp 抓影片,網頁版預設範例連結是一支 Bilibili 影片,也吃 YouTube 的播放清單與頻道網址;step010 用 Meta 開源的 Demucs 把人聲和伴奏分開,預設模型 htdemucs_ft;step020 做語音轉錄,可以在 WhisperX 與阿里達摩院的 FunASR 之間二選一,WhisperX 路徑預設抓 faster-whisper-large-v3,FunASR 那條路對中文辨識比較友善;step030 翻譯字幕,選單上有 OpenAI、本地 LLM、Google 翻譯、Bing 翻譯、百度文心五種,2025 年 3 月又在程式碼層補了 Ollama 這條本地路,不過兩套介面的翻譯下拉選單都沒有這個選項,要用得自己改呼叫;step040 生成語音,介面上真正的選項是 XTTS、CosyVoice、EdgeTTS 三種;step050 用 moviepy 加 ffmpeg 把配音、字幕、背景音樂合成回影片,字幕燒錄固定用倉庫內附的 SimHei 黑體字型,還附了一段示範背景音樂。
介面把這條流水線攤成兩種用法。「一鍵自動化」分頁塞了二十七個參數,從下載解析度、Demucs 模型、轉錄引擎、目標語言到背景音樂音量全部在同一頁,按一次跑全程;每個階段也各有獨立分頁,可以只跑其中一段。程式會追蹤 GPU 的可用記憶體,模型採懶載入,第一次用到才初始化,跑完人聲分離也會把模型釋放掉再換下一個,看得出作者在顯示卡記憶體吃緊的機器上打磨過。網頁版啟動在本機 6006 埠。桌面版多了一個設定頁,能把參數存進 config.json,下次開啟直接沿用,對反覆跑同一種片型的使用者省事。
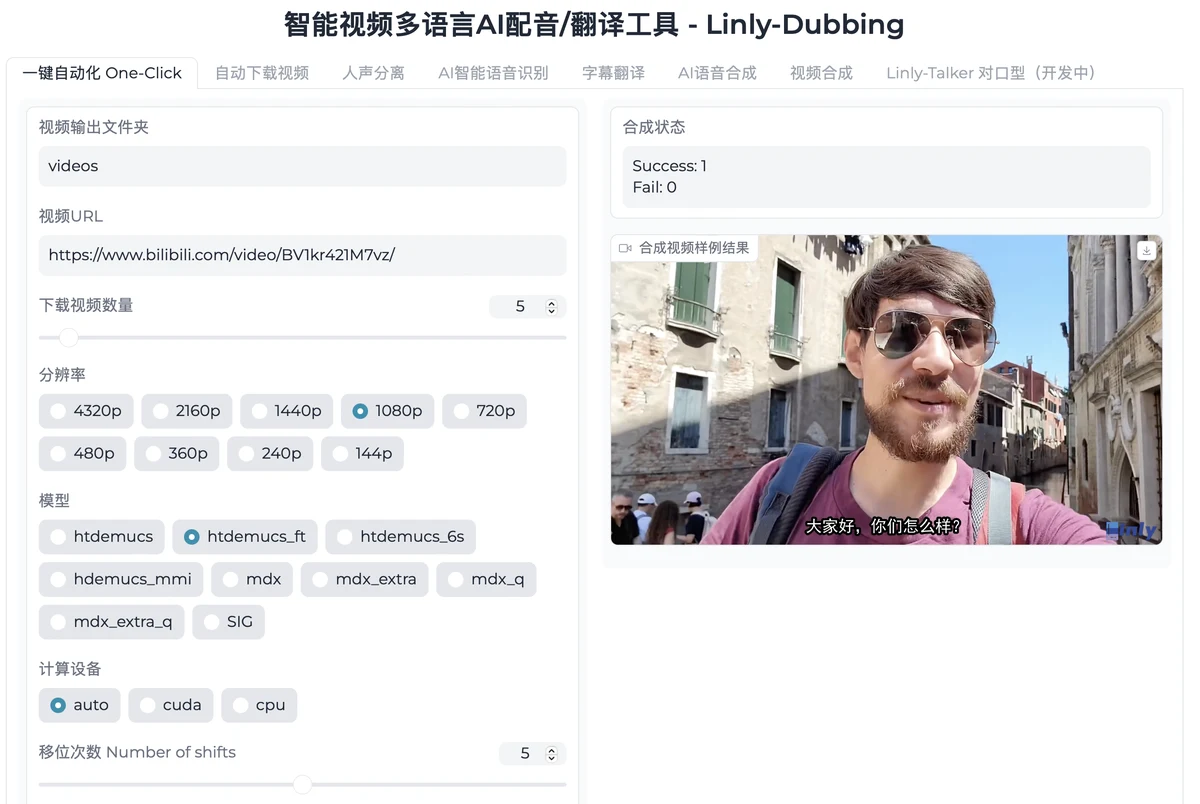
這份零件清單本身就是它最大的價值。每一段用的都是各自領域有名的開源組件,Linly-Dubbing 做的事情是把它們接起來,加上段與段之間的橋接邏輯。有幾處接法值得細看。聲音克隆的做法是:轉錄階段標記出每位講者,並從分離後的人聲軌為每人拼存一支參考音檔,配音時把該音檔當音色樣本送進 XTTS 或 CosyVoice 做零樣本合成,多人影片因此能各自保有原聲的質地。配音生成後會用時間拉伸把每句語音對齊原片的時間軸,拉伸倍率限制在 0.6 到 1.1 倍之間,超過範圍就頂多拉到邊界值,不會更極端。最後合成時,新的配音人聲會先對齊原始人聲的音量水平,再與人聲分離階段抽出來的伴奏軌混回,所以換了配音,原片的背景音樂還在。產生影片摘要時只把逐字稿的開頭一千字加結尾一千字送進模型,超過兩千字的長片中段不會進摘要。想入門影片翻譯配音的工程架構,把這六個檔案讀完,等於拿到一張標好接線的電路圖。
模型怎麼來也有明確答案。Linux 的安裝腳本會從 ModelScope 拉三個模型:XTTS-v2、Qwen1.5-4B-Chat、faster-whisper-large-v3,加起來是 GB 級的下載量。CosyVoice 的 300M 模型在腳本裡被註解掉,要走這條路得自己抓;說話人分離用的 pyannote 模型放在 Hugging Face 的申請牆後面,要手動申請通過才下載得到。還有個容易忽略的細節:網頁版啟動參數寫死了 share=True,Gradio 會自動開一條公開分享連結,只想在自己電腦上用的人得自己改掉這行;抓影片資訊的函式也預設直接讀本機 Chrome 的 cookies,不想讓工具碰瀏覽器登入狀態的人同樣要動程式碼。
最受矚目的功能落差在對口型。README 的主要特點清單寫著對口型技術能讓配音與影片畫面高度契合,介紹段落也說整合了作者另一個專案 Linly-Talker 的這套技術。可是同一份 README 的開發清單裡,「實現並優化數字人對口型技術」這一項的核取方塊是空的。
程式碼給的答案更直接。Gradio 版 webui.py 裡的對口型分頁,事件處理函式就是一行 fn=lambda: None,點下去什麼都不會發生,畫面輸出是一段 Markdown 文字:「施工中,請靜候佳音」,旁邊附一條連結指向 Linly-Talker 的倉庫。桌面版的 tabs 資料夾裡有個 linly_talker_tab.py,內容同樣是一個下拉選單(Wav2Lip、Wav2Lipv2、SadTalker 三個選項)加一個寫著「功能開發中」的標籤,沒有任何實作程式碼。換句話說,兩套介面裡的對口型都是佔位,而且從 2025 年 3 月之後就沒有機會再長出來,因為整個專案停更了。
真的需要讓畫面裡的人對著配音動嘴型,現成的路有兩條:一是作者自己的 Linly-Talker 專案(3,461 顆星,2026 年 2 月還有提交,那裡才是對口型技術的本體);二是站上先前介紹過的開源數位人系統 AIGCPanel,把語音與數位人影像分開處理再組合。抱著對口型期待來裝 Linly-Dubbing 的人,可以先省下這筆安裝工時。
維護時間線可以用幾個節點講完。倉庫建立於 2024 年 8 月 8 日,全部歷史只有 59 個提交,2025 年 2 月底到 3 月初是最後一段密集期,接連修了啟動失敗、影片生成失敗、Ollama 翻譯等問題,也把輸出影片上的浮水印設定移除(文件資料夾裡還留著當年的浮水印圖檔);3 月 5 日合併最後一個 pull request 之後,主分支再無任何提交。轉折點前三天有個耐人尋味的細節:有人在 issue #49 反映程式碼需要更新,作者 3 月 2 日回覆「OK,I will update code next week!!!」(隔週就更新),三天後推了最後一批修正,然後就沒有然後了。
issue 追蹤區則一路熱鬧到現在。2026 年 6 月有人建議整合 FunASR 的新模型並主動表示願意幫忙整合,沒有得到任何官方答案;同年 7 月還有使用者在兩年前的安裝錯誤討論串裡更新自己的狀況。作者帳號最後一次出現在 issue 回覆是 2025 年 5 月 25 日。他並沒有消失:同一帳號到 2026 年 10 月都還每天推送另一個專案 mimotion 的程式碼,只是 Linly-Dubbing 不在行程表上了。專案也從未發過任何一版正式 release,沒有標籤可以回溯版本,想要官方整合包的人從 2024 年問到現在(issue #72、#5)都沒有下文。
README 列的測試環境是 Python 3.10、PyTorch 2.3.1、CUDA 11.8 或 12.1,這是 2024 年中期的組合。文件假設的使用情境也看得出目標讀者在哪裡:安裝指引建議把 pip 源切到清華大學鏡像、ffmpeg 用 conda 裝 7.0.2 版、模型從 ModelScope 拉,整條路都是為中國網路環境鋪的,台灣使用者照抄可用,但換成官方源通常更順。相依套件裡有幾個安裝上的已知地雷:pynini 必須用 conda 裝(WeTextProcessing 的前置需求);whisper、whisperX、demucs、Coqui TTS 四個套件放在 submodules 目錄,要用另一份 requirements_module.txt 安裝。這些關卡在 issue 追蹤區都有對應的長討論串:Windows 上 onnxruntime 的 DLL 載入失敗(#58、#70)、明明裝了 submodule 卻報模組缺失(#71)、CosyVoice 的 cli 模組找不到(#21、#61)、Coqui TTS 的 API 模組匯入錯誤(#37,這串到 2026 年 7 月還有人更新)。
依賴鏈的上游也在老化。語音克隆走的 Coqui TTS 倉庫約 4.6 萬顆星,但公司已在 2024 年收掉,倉庫最後一次推送停在 2024 年 8 月 16 日;2026 年還有人撞上的 TTS.api 匯入錯誤,正是這類年代錯位的典型症狀。更硬的牆在顯卡:2025 年 5 月起 RTX 50 系顯卡的使用者回報 CUDA 相容性無解(#64),作者僅回覆一句「具體是什麼問題呢」之後就沒有下文;問有沒有非 CUDA 版本的 issue #22 從 2024 年 9 月開到現在;Mac 部署的問題(#73)只在 2026 年 1 月等來另一位使用者的「同問」,官方沒有給出任何答案。
沒有 NVIDIA 顯卡能玩嗎?官方文件只列 CUDA 環境,非 CUDA 的問題懸了一年多沒有答案。語音轉錄與本地翻譯模型都吃運算資源,純 CPU 跑得動但體感差很多,沒有卡的人比較務實的起點是自架轉錄服務(例如先前介紹過的 Whisper 轉錄 API 方案或 YouTube 逐字稿工具),而不是這套。
macOS 能裝嗎?沒有官方說法。上游 YouDub-webui 倒是在 2026 年 8 月的更新裡釋出了 MPS 路徑的記憶體處理說明,兩條路的成熟度在這裡拉開。
有整合包嗎?沒有官方版,社群請求被晾著。官方倒是提供了一份 Colab 筆記本,能在 Google 的雲端顯卡上跑整套流程,不想拆本地環境的人可以先試這條(Colab 的免費額度與環境會變動,能不能開起來要當場試)。要在本地裝,照著 README 的指令一步步來,並把前面提到的 issue 編號當成排錯索引。
這套工具本體不連任何帳號,但資料流向取決於每一段接的零件,隱私邊界要自己把關。全程本地的組合存在:轉錄用 WhisperX 或 FunASR、翻譯用本地 Qwen 或 Ollama、配音用 XTTS 或 CosyVoice,影片與文字不出機器。便利路徑則都在雲端:EdgeTTS 走微軟的免費語音服務(程式直接呼叫 edge-tts 指令)、翻譯可以接 OpenAI、百度文心、Google、Bing。翻譯品質的官方建議也很直白:README 承認本地模型效果有限,建議改用 OpenAI 的付費 API。
預設值的細節值得知道。env 檔的 MODEL_NAME 預設是 qwen/Qwen1.5-4B-Chat,而且翻譯模組的程式碼寫死了防呆:名稱裡不含 Qwen 就強制換回 Qwen1.5-4B,想讓本地路徑跑別家的模型,只能走 Ollama 那條後來加的路。env 檔裡另有個 BILI_BASE64 欄位,翻遍整份原始碼找不到使用它的地方,是留下來的死設定。配音文字進模型前還會被改寫:每個「AI」字串一律換成「人工智能」,數字與符號走一套中文正規化(把小數點唸成「點」這類處理),翻譯後處理則有幾組硬規則,例如把「變壓器」換回 Transformer(原始碼以簡體字寫成,此處轉寫)。這些改寫對唸稿順口有幫助,但代表配音唸出的內容與字幕原文可能不一致,正式用途要先檢查。
台灣使用者有一個現成的落點:EdgeTTS 路徑內建 314 支語音,其中 zh-TW 有三支(HsiaoChen、HsiaoYu、YunJheNeural),沒有高等級顯卡也能靠這條路出配音,代價是聲音沒有原講者的質地、文字要送微軟的服務。想要複製原聲的音色,XTTS 與 CosyVoice 都做零樣本克隆,拿幾秒原聲就能生成相似語音;但 CosyVoice 是以 git 子模組釘在 2024 年 8 月 1 日的版本上,後續 CosyVoice2、CosyVoice3 的改進都不在這條路徑裡,想升級要自己動子模組。
把兩個專案放回同一個決策框架:做的是同一件事(開源自架的影片翻譯配音),比較的時間基準是現在。YouDub-webui 是 Linly-Dubbing 自述的靈感來源,README 的講法是在 YouDub 的基礎上拓展與優化(此為作者自己的宣稱);實際的差異化也看得到:Linly-Dubbing 多了第二套桌面介面、中文轉錄的 FunASR 選項、以及 XTTS 與 CosyVoice 兩種本地克隆引擎。星數 5,602 對 3,350,維護狀態一活一凍:YouDub 在 2026 年 8 月底處理了 MPS 路徑的記憶體釋放、補了 VoxCPM 語音的說明,9 月加入 Atlas Cloud 翻譯預設,9 月 21 日還在整併文件與鏡像修正;Linly-Dubbing 這邊則是 2025 年 3 月後一片寂靜。
凍結的這一邊並非沒有優點。Linly-Dubbing 同時提供瀏覽器與桌面兩種介面;中文轉錄多了 FunASR 選項;本地配音有 XTTS 與 CosyVoice 兩種克隆引擎可以互相比較;六段工序的檔案切分乾淨,讀原始碼學架構的體驗好。YouDub 的強項在維護:Mac 路徑有人照顧、翻譯後端生態持續在長、遇到問題有人修,而且它的預設場景本來就是 YouTube 影片在地化。兩邊授權都是 Apache-2.0,商用限制同低。
決策可以這樣分流:目的在研究影片配音流水線怎麼拼、有能力自己修相依問題的人,拿 Linly-Dubbing 當教材很值得,程式碼小而清楚;目的是今天就產出翻譯配音片、不想當維護者的人,投入同樣工時在 YouDub-webui 上風險低得多;連自架都不想碰的人,配音神器 Pro 這類線上服務或做影視解說的 NarratoAI 是更短的捷徑。翻譯與配音的成品好壞沒有公認基準,誰翻得準、誰配音好聽,用自己的素材實際跑一次才算數。
Linly-Dubbing 的程式碼採 Apache License 2.0,允許商用、修改、再散布,義務是保留版權與法律聲明、專利授權隨條款走。但程式碼寬鬆不等於整條管線可以商用:預設的配音引擎 XTTS-v2,模型授權是 Coqui Public Model License,條文寫明模型與它的輸出物都僅限非商業使用,拿來做商用影片等於踩到模型授權牆,商業用途應改走 CosyVoice 或 EdgeTTS 路徑,並逐個模型確認條款(Qwen1.5 系列也有自己的通義授權條款)。README 結尾的提醒也值得記下:使用時請遵守版權、資料保護與隱私相關法律,未經原作者或版權所有人授權,不要拿這工具處理別人的影片。配音翻譯再上片的整條鏈,輸出物算不算衍生作品、能不能營利,答案不在工具身上,在素材的授權狀態。
程式碼仍可用、文件齊、授權寬鬆,但主分支停擺十九個月,沒有正式版本、沒有官方整合包,安裝問題還在累積。它的六段流水線是一張還拿得到手的電路圖,零件也各自拿得到;要把這張圖變成每天在跑的生產線,畫圖的人已經離場,接下來的維修單會全部落在你自己身上。想清楚再進場,進場後把它當起點而不是終點,是這套工具今天最誠實的使用方式。