TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

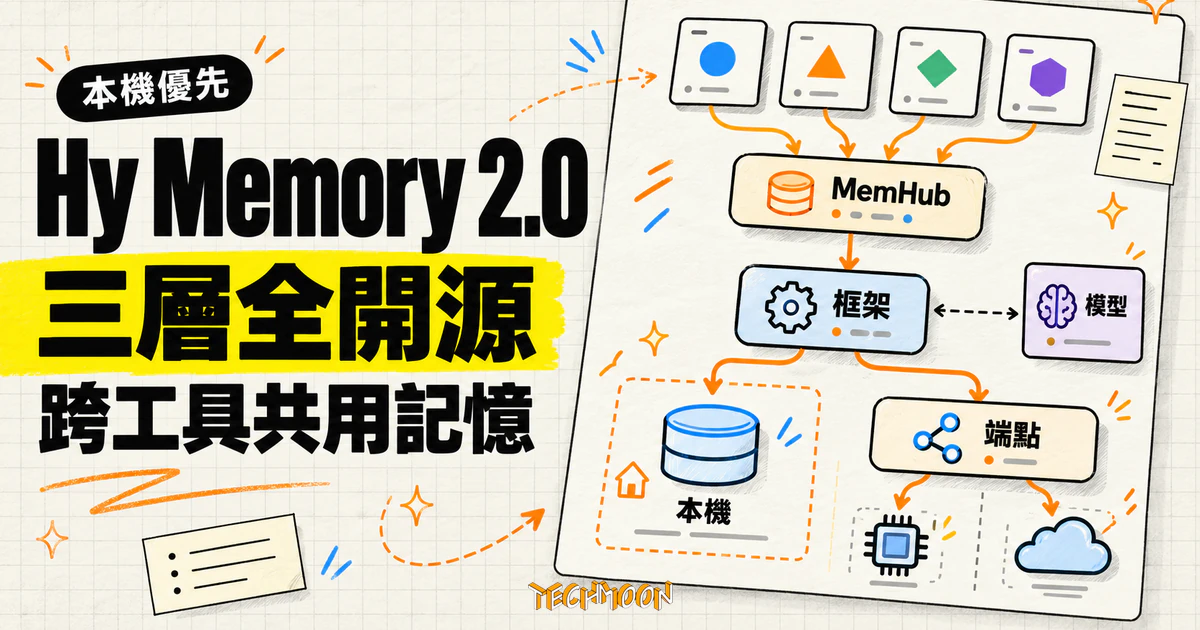
騰訊混元 10 月 16 日把 Hy Memory 2.0 三層全開源:30B 記憶寫入模型、hy-memory 框架與 MemHub 應用。本篇實際安裝框架實測:lite 模式零 LLM 全本機跑通寫入搜尋與使用者隔離,搜尋預設門檻會擋掉低分召回,列舉介面讀不到原始層;本機優先的真正邊界在端點設定,每筆寫入查詢的原文都會送進你設定的嵌入服務。
用 AI 摘要這篇文章:
騰訊混元在 10 月 16 日把記憶系統 Hy Memory 2.0 三層全部開源:記憶專用模型、記憶管理框架,以及讓 Claude Code、Cursor、Codex 這些工具共用一份記憶的 MemHub。消息本身一句話講完,值不值得現在跳進去卻需要拆開看。我把最中間的框架層裝起來實際跑了一遍,先給三個結論:lite 模式在完全沒有設定語言模型、嵌入端點全部指向本機的條件下,寫入與搜尋都跑得通,使用者隔離與來源過濾這些容易被忽略的機制是真的有做;「本機優先」的邊界比字面更細,每次寫入與查詢的原文會完整送進你設定的嵌入端點,端點選雲端,內容就出門;最後,PyPI 上的 2.0.4 和 GitHub 上的文件已經有落差,lite 模式有兩個讀取介面讀不到你剛寫進去的東西,那不是資料掉了。
先看這次到底放了什麼出來。模型層是 Hy-Memory-30B-A3B,總參數 300 億、每次推理激活約 30 億的 MoE 架構,訓練目標很單純:專門負責記憶系統裡「什麼該存、存成什麼樣、新資料進來怎麼改舊記憶」的寫入端。權重放在 Hugging Face,技術報告標題就寫明是為長期記憶寫入做的歸因強化學習,授權 Apache-2.0。
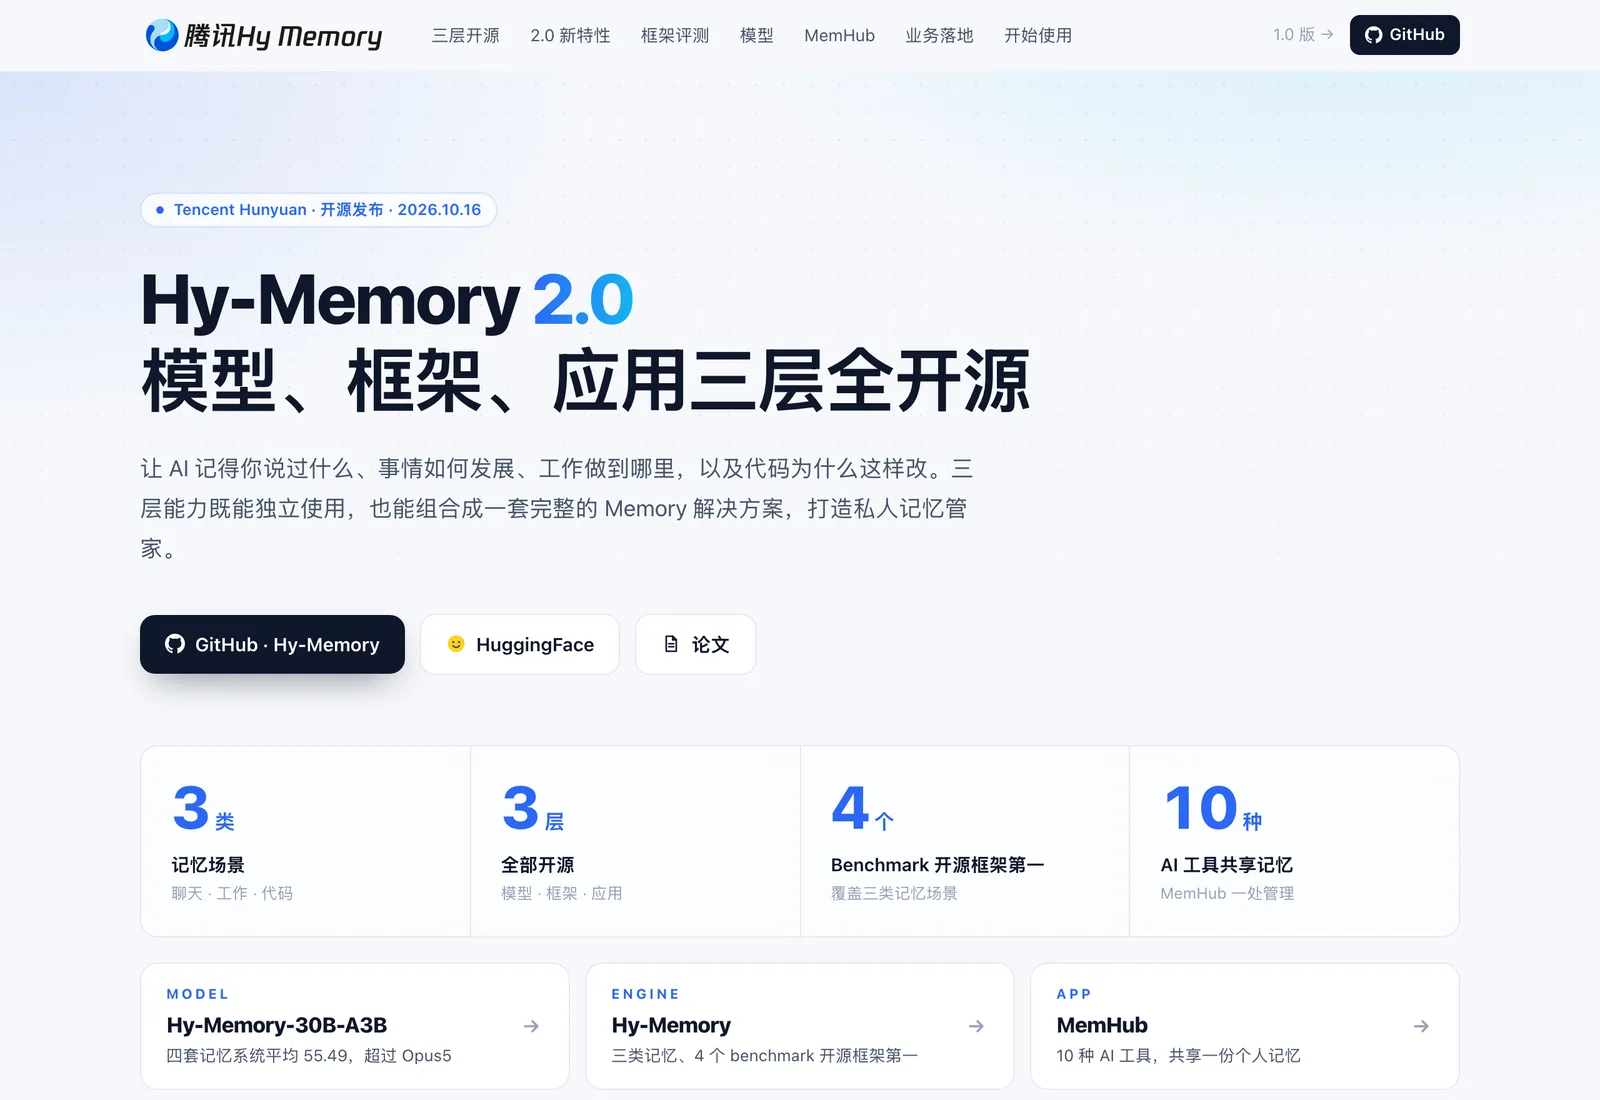
框架層是 Python 套件 hy-memory,一條 pip install 就能裝,自帶 ChromaDB 向量庫與 Kuzu 圖資料庫。它把記憶分成三種場景:聊天記憶走分層結構,從原始對話逐層抽象成原子事實、摘要到更高層的認知結構;工作與程式記憶走「事實加可重用經驗」兩層,一件事做完留下它做了什麼,以及下次能用的方法;程式場景再多一條版本演進鏈,把每次修改的差異連同當時的說明一起留下,被改回去的版本事後還查得到。
應用層 MemHub 則是桌面 App 加命令列,官方列出的整合對象有十個:Claude Code、Cursor、Codex、OpenCode、OpenClaw、Qwen Code、WorkBuddy、Pi、Hermes 與 DeepSeek Harness。它的角色是把各工具的歷史對話匯入同一份本機記憶,再讓正在工作的工具取用。
三層的設計細節裡有兩個值得記住的機制。工作與程式場景的記憶分成「事實」與「經驗」兩層,事實層保證做過的事情被記下來,經驗層則要通過價值判斷才會留下,兩層互相連結,被取代的事實沿著任務進度鏈還能追回去;程式場景的版本演進鏈刻意不把程式碼貼進事實裡,而是記檔案、函式、分支座標,真正的修改差異由版本鏈零 LLM 成本保存,粒度是「一個分支上一個檔案裡一個函式的一段經歷」。儲存後端也留了選擇:向量庫預設 ChromaDB,可換 Qdrant 或 FAISS,ultra 模式的圖資料庫用 Kuzu 或 Neo4j,工作與程式場景的結構化資料落在本機 SQLite。
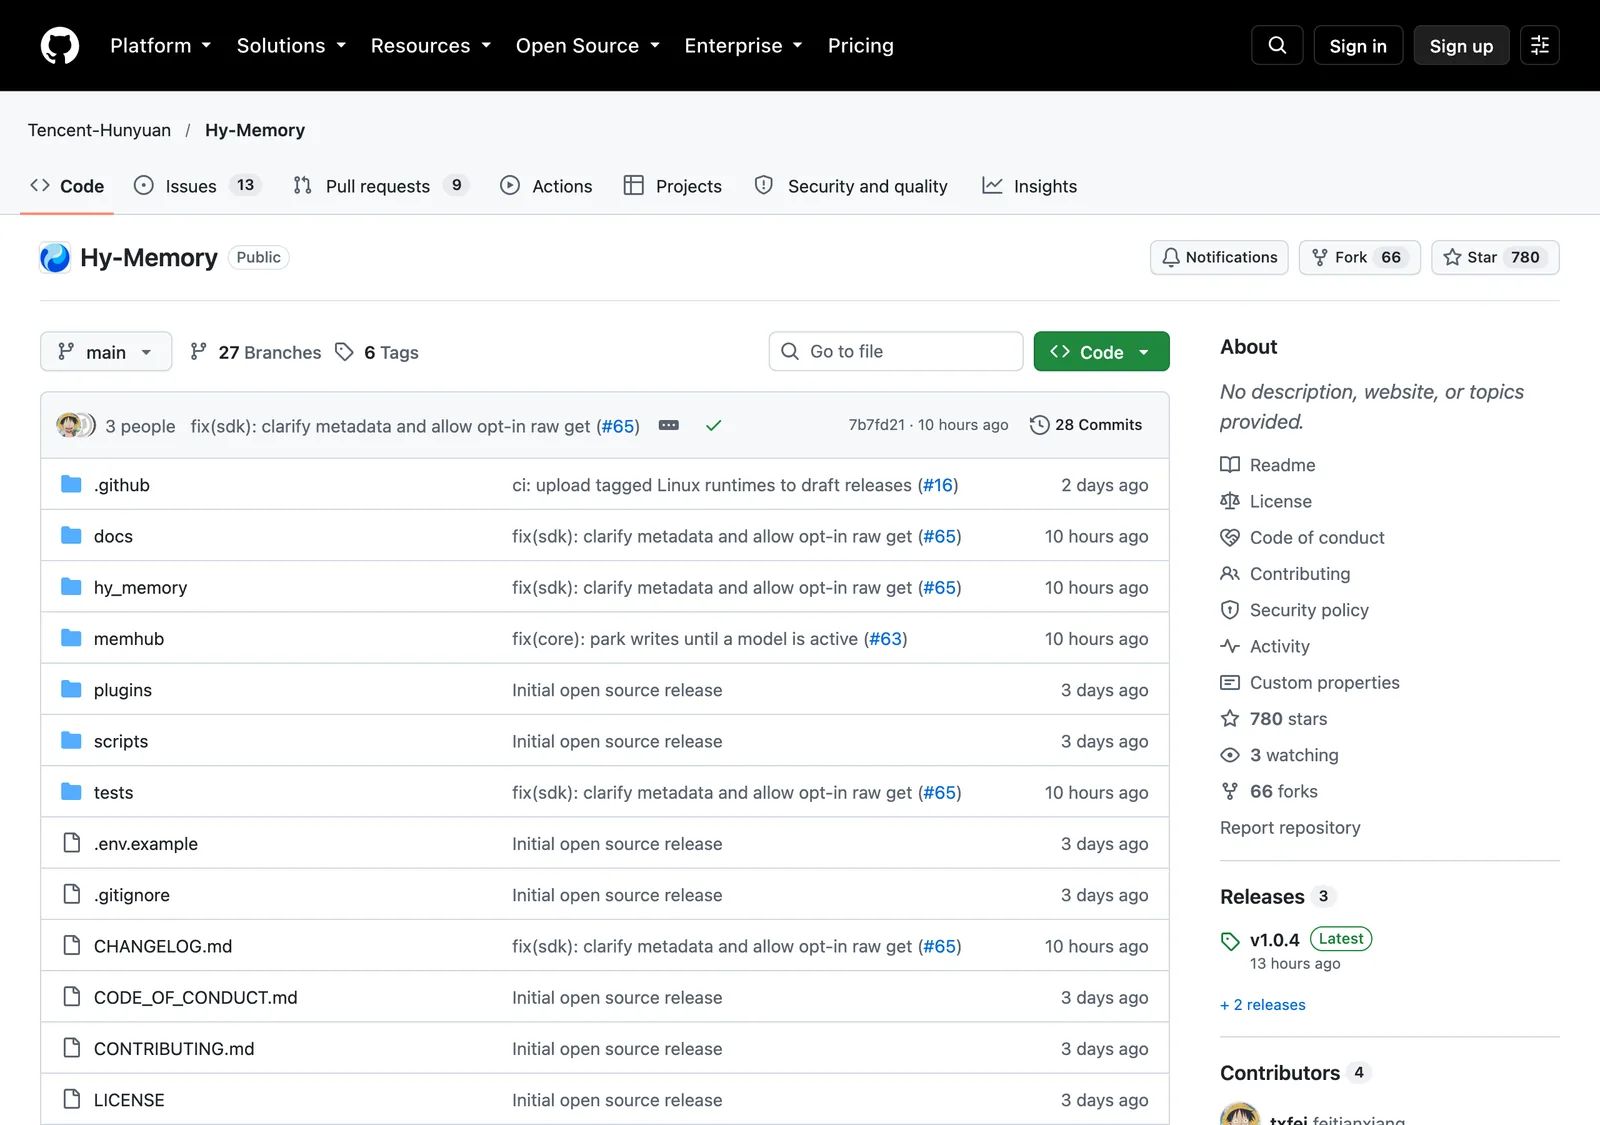
對照官網的版本時間線,2026 年 5 月的 1.0 只有論文和產品,程式碼沒有開放;2.0 補上工作與程式兩種新場景,而且三層全放。研究脈絡也一併公開:聊天記憶的雙系統架構論文獲 EMNLP 2026 接收,程式記憶的 CMB 基準投稿 ICLR 2027,加上這次的模型技術報告,三份文件把設計理由攤得很開。開源動作本身節奏很快:GitHub 倉庫 10 月 15 日建立,模型同日上架,官網 10 月 16 日宣布開源,第一天就發了兩個 release,10 月 18 日又推到 v1.0.4,npm 上的 memhub-cli 同日更新到 1.0.5。截至寫稿,倉庫星標已經超過 770。
框架的使用門檻比想像低。我在乾淨的虛擬環境裝了 hy-memory==2.0.4,它需要的外部服務只有一個嵌入端點,也就是把文字轉成向量的服務,任何 OpenAI 相容協議都吃。我把這個端點指到自己寫的本機測試服務,語言模型的設定整個留空,這正好對應框架的 lite 模式:不做任何抽取,原文直接以原始層存下來,官方文件也明講這個模式不呼叫 LLM。
實測結果先看數字。寫入每筆 110 到 120 毫秒,第一筆含初始化約 0.76 秒;搜尋一次 3 到 20 毫秒;更新一筆 10 毫秒。全部資料落在指定目錄裡的幾個本機檔案:ChromaDB 的資料庫與向量檔、歷史紀錄檔和快取檔,五筆記憶連同日誌佔約 644KB。框架日誌明確標示 lite 模式強制只搜原始層、忽略場景參數、不經 LLM,我本機端點收到的請求也只有嵌入呼叫,沒有別的東西出門。
第一個踩點馬上出現:寫入成功,搜尋卻一筆都沒有。對照套件原始碼才確認,搜尋的 min_score 參數預設就是 0.4,會擋掉相似度 0.4 以下的結果,而我自製的嵌入服務只是把文字拆成字元組合做比對,分數落在 0.2 上下,全部被門檻攔下。把 min_score 明確設成 0 之後,召回一切正常。這不算框架的缺陷,卻是自架端點時的第一個檢查點:先確認不是被門檻擋掉,再懷疑資料沒有寫進去。
跨工具共用記憶最怕兩件事:A 專案的背景漏進 B 專案,以及所有工具的紀錄糊成一團分不開。這兩點我分別做了驗證。
用兩個使用者各寫入不同的記憶再交叉查詢:bob 查得到自己寫的內容,完全查不到 alice 的;反向查詢同樣乾淨,alice 的結果裡沒有任何一筆屬於 bob。來源標籤的部分,我故意傳了大小寫混用、尾端帶空白的「Codex 」,實際存下來是正規化過的 codex,和文件宣稱的行為一致。搜尋時用 include_sources 限定只看 codex 寫入的記憶,cursor 來源的內容就不會出現;換成 exclude_sources 也即時生效。
更新與刪除同樣即時。把一筆記憶的內容改掉之後,用新內容的關鍵字搜得到、識別碼不變;刪除之後同樣的查詢就不再回傳那一筆。整套寫入、隔離、過濾、修改、刪除的循環,在一台不上傳任何東西的機器上完整走完。
實測裡最意外的地方,是 lite 模式的兩個列舉介面都讀不到原始層記憶。list_memories 一律回 0,get 帶識別碼預設回 None。翻安裝套件的原始碼看到原因:對外的列舉路徑刻意隱藏原始層,要底層參數 allow_raw_layer 打開才會給,而這個開關沒有暴露到公開介面。也就是說,lite 模式寫進去的記憶只能靠搜尋撈回來,官方介面上沒有「列出全部」的管道。
README 的說法又是另一套:文件寫著 get 可以帶 include_raw=True 讀回原文,但我裝的 2.0.4 直接丟出 TypeError,這個參數根本不存在。對照倉庫,修復在 10 月 18 日已經併入 main 分支,對應的 issue 也標了 fix,只是還沒發到 PyPI。教訓很實際:這個專案開源三天內已連發多個版本,看文件要對準自己安裝的版本,拿 main 分支的用法套 2.0.4 會踩空。
資料流向是這類工具最該先問的問題,實測給了很具體的答案。我的本機嵌入服務每次收到的是完整原文,寫入一句話,整句送進嵌入端點;查詢也一樣,問什麼就送什麼。lite 之上還有需要語言模型的 pro 與 ultra 模式,那表示內容還會再送一份給模型端點。官方文件的範例配置就是 OpenAI 或 DeepSeek 的雲端服務。
換句話說,框架把「資料存在哪」和「內容送給誰處理」拆成兩件事:儲存在本機是預設,但處理端點你設成雲端,原文就會離開電腦,對方怎麼記錄也不在你的控制範圍。要全程留在自有環境,就必須自備本機的嵌入與模型服務,維運成本自己承擔。
MemHub 把同一條邊界寫進了產品合約:來源原文以 Evidence 形式存在本機資料目錄,預設路徑 ~/.one-memory;啟用第三方模型服務之前,提供方、發送範圍與用途必須先顯示給使用者;API Key 進系統的安全儲存,不寫進安裝包或日誌;產品不採集螢幕畫面、輔助功能樹、OCR、鍵鼠、剪貼簿與錄音。命令列提供完整的生命週期指令,從 serve、status、doctor 到 install、upgrade、uninstall 都有;解除安裝預設保留記憶資料,只有 delete-data 會在 runtime 停止、二次確認精確路徑之後才真正刪除。不過桌面端還在 preview 階段:npm 上的 memhub-cli 只有約 384KB,純粹是安裝引導,執行 memhub install 才會下載完整 runtime,Linux 版 258 到 264MB、macOS 安裝檔 320MB,Windows 明確不支援。另外有使用者回報記憶輸出語言被硬編碼成簡體中文,這個 issue 到寫稿時還開著,對繁中工作流是個實際的摩擦點。
開源同步公布了兩套成績。模型卡的實驗把同一個寫入模型放進 Mem0、Hy-Memory、MemOS、EverMemOS 四套記憶系統,每套用 LoCoMo、LongMemEval、PersonaMem、旅遊規劃、組合購物與程式記憶六個指標等權平均,全部基準取固定的 20% 子樣本,而且只換寫入模型、固定檢索與評審設定:Hy-Memory-30B-A3B 總平均 55.49,高於 Claude Opus 5 的 54.62 與 DeepSeek V4.1 Flash 的 53.64,比自己的基座模型高了 7.8 分,其中 EverMemOS 在訓練中沒有見過,用來檢驗遷移。官網另外宣稱框架在聊天、工作、程式三個場景的四個基準都是開源框架第一,例如聊天場景 LoCoMo 72.6%、工作場景 MemoryArena 55.31% 領先次優 10.2 分、工作場景記憶佔用只有 6.06%。
這些數字我沒有重跑,量測條件是官方固定的,樣本只取兩成,閱讀方式應該是「同一把尺下的相對位置」,不是絕對能力保證。騰訊也列了內部業務的採用案例,自選股助手的多跳召回從 50% 提到 90%,iWiki 只用記憶回答的正確率高於讀完整原文,這部分同樣屬於官方宣稱。
已有自己的 agent 或在寫代理程式的開發者,框架層是成本最低的入口:pip 裝完、指一個嵌入端點就能動,lite 模式先用零成本驗證記憶形態,要開抽取再接模型。想重現我這套最小驗證也不難:開一個乾淨環境裝 2.0.4,嵌入端點隨便指一個本機服務,寫兩筆不同使用者的記憶再交叉查詢,隔離、過濾、更新、刪除一次看完,全程不必申請任何 API Key。常在多個工具之間換手接續工作的人,MemHub 的方向值得追蹤,但現在要接受 preview 階段的缺口:沒有 Windows 版、簡中硬編碼未解、runtime 體積不小。至於 30B 模型本身,部署需要相當的 GPU 資源,一般使用者碰不到,它更像是給記憶系統研究者的一塊材料。
還沒有答案的問題也先講清楚:MemHub 桌面端從授權匯入到跨工具召回的完整流程,我沒有實際安裝 runtime 驗證;官方評測數字未重跑;模型在繁中環境的抽取品質未知。版本還在快速迭代,安裝前建議先看 release 與資訊清單確認平台製品,拿不準就等下一版。
若你也在找讓 Claude Code 與 Codex 共用工作記憶的路線,之前介紹過的 holaOS 走的是自架工作區的路數,另一個 ai-memory 則把專案記憶抽成獨立服務;同時看住多個代理工作的 Port22 處理的是另一端的監控需求,幾條路和 MemHub 的本機記憶中樞可以對照著看。