TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

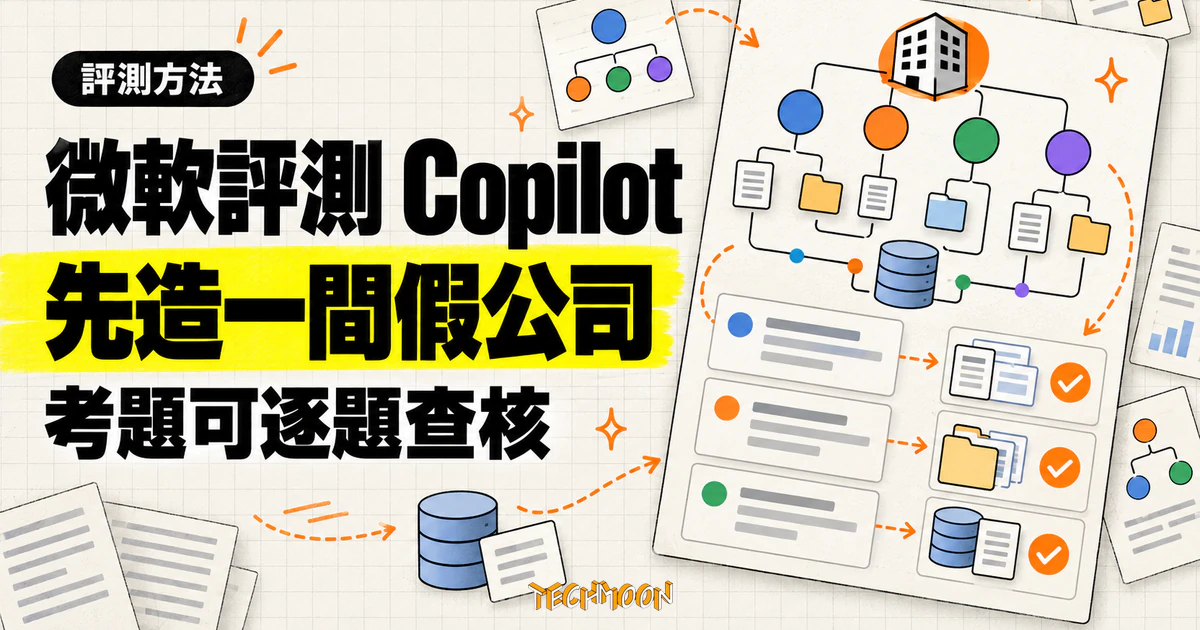
微軟研究團隊在 10 月 30 日公開合成企業資料評測方法,用 O*NET 職業資料與 SEC 申報文件生成有員工、專案與時間演變的虛構公司,在藥廠、資本市場與軟體三種產業情境內部評測 Copilot。公告中的 39% 品質提高與 30 萬美元節省,量測對象都是資料生成流程本身,不能解讀為客戶導入成效。
用 AI 摘要這篇文章:
想在公司內部驗證 AI 助理好不好用的人,很快會撞到同一堵牆:拿真實客戶資料來測試,隱私與法規這關過不去;自己手寫幾份假文件,又測不出真實工作的混亂,因為企業問題的答案往往散在不同人、不同時間點的會議與郵件往來裡。微軟內部把這件事整理成一套有名字的做法:研究團隊在 10 月 30 日於官方部落格公開「產業評測資料生成平台」(Industry Evaluation Data Generation Platform)的方法說明,核心是把測試素材從幾份手工文件,換成一整間虛構的公司,裡面有員工、專案、會議紀錄與會隨時間演變的郵件串,再對著這個環境自動產生答案可查核的測試題,用於內部評測 Microsoft Copilot。
公告開頭就點出這套方法要回答的兩個問題:Copilot 真的在做到使用者需要的事嗎?以及,能不能在完全不碰使用者資料的前提下證明這一點?前一問關於能力,後一問關於信任,兩者合起來才是企業級評測的完整題目。
先把界線畫清楚:公告裡的兩個關鍵數字,合成資料品質提高 39%、專案共省 30 萬美元,量測對象都是這條資料生產線本身。39% 量的是「假公司做得像不像真公司」,省下來的 30 萬美元是微軟自己估算的製作成本差異。兩個數字都沒有觸及 Copilot 的答對率,更不是任何客戶導入後的成效。
這篇公告的性質要先看懂。平台服務的對象是微軟內部負責評測 Copilot 的團隊,內容是回顧性的方法說明:團隊已經用它建立三個產業的評測環境,發布到微軟內部共用目錄,並被定位為 Copilot 的首個標準化評測基準。微軟自己形容這是評測文化的轉變,從各團隊各自為政的手工流程,走向標準化而且可重現的基礎設施。換句話說,10 月 30 日公開的是「怎麼做」,不是「現在可以買」。
對一般讀者的影響要分兩邊看。如果你只是使用 Copilot 或訂閱 Microsoft 365,日常使用沒有任何直接變化,這則消息對你沒有行動項;如果你負責企業 AI 助理的評估或採購,這篇公告值得細讀,因為它展示了一套把驗證標準化的完整思路。至於外部能不能取得這批資料,公告沒有宣布資料集開源,也沒有對外定價或產品化時程,這些都還是微軟的內部資產。
同一時間微軟在產品端動作不斷,例如把 Frontier 預覽擴大到 Outlook 與 Teams,財報端也看得到 AI 服務對 Azure 成長的貢獻。這篇方法公告屬於另一條線:產品往前推的同時,內部也在把「怎麼驗證產品」這件事標準化。
微軟用的單位是「租用戶」(tenant),白話講就是一個組織在服務裡的獨立工作環境,有自己的使用者、設定與資料。過去的做法是少量手工維護的測試文件;新做法是生成整個租用戶,裡面的角色會參與專案、專案會產生文件、往來紀錄會隨時間累積。微軟把這些環境定位成可擴充的基準,各團隊可以在同一套骨架上依需求變化。
為什麼單一文件不夠?因為企業助理面對的問題很少只存在於一份文件。回答「這個專案現在由誰負責」,可能得先分辨原本的分工與最近一次交接;資訊散在多處、又有看似相同但已經過期的內容,這才是日常工作的真實樣貌,也是通用測試案例測不到的地方。微軟在公告裡直說,這套方法能找出通用基準會漏掉的問題。
虛構公司的骨架來自三類公開資料。美國勞工部的 O*NET 職業資料庫(公開免費,涵蓋約一千個職業的任務與技能描述)用來讓每個職務做的事情貼近現實,例如臨床試驗審查或投資組合更新該由哪些角色經手;線上職缺提供職稱、回報層級與部門組成的樣貌;美國上市公司向 SEC 申報的文件則提供公司規模、部門結構與財務背景的參考。微軟強調這些來源都經過內部法務與政策單位審查,而且管線任何階段都不使用真實客戶資料,這是設計原則,不是先抓真資料再匿名化。
三個產業環境各自長出不同的工作內容:藥廠情境有法規送審、臨床試驗討論與跨部門安全審查會議;資本市場情境有交易案管道、合規溝通與客戶投資組合檢視;軟體公司情境則有衝刺規劃、程式碼審查討論與產品上市協調。差異寫在工作流程裡,如果只是把同一份會議紀錄換個公司名稱,就測不出不同產業會遇到的問題。
時間軸是另一個關鍵設計。環境裡的會議有歷史、專案有時程、郵件串會發展數週,組織變動也自然發生。微軟的理由很直接:一大類 Copilot 查詢本質上時間敏感,「團隊上週四做了什麼決定」「上次季度檢討之後改了什麼」這類問題,只有背後資料真的有時間結構時,測出來的答案才有意義。對使用端來說,這也是危險的一類錯誤:一句流暢卻引用過期結論的回答,比直接說找不到資料更容易誤導決策,而這種錯只有帶時間軸的測試環境測得出來。
題目本身也是生成的。管線從大量通用工作任務出發,依產業挑出相關項目,換上該領域的語言,再依環境裡實際存在的資料產生題目,改寫成一般人提問的口氣,最後逐題驗證準確與不重複。把題目改寫成自然口氣有其必要:如果只有工整的問法能被正確理解,測試結果會高估真實使用時的表現;反過來說,如果題目措辭本身就洩露了答案,模型根本不需要讀資料也答得出來。而題目要求的資訊如果根本沒有生成,模型答錯也無法公平反映能力,所以每題都要回頭對著環境查核。
生成的資料還要過品質檢查,面向包括組織結構的合理性、題目與工作情境的相關性、模擬使用者的行為真實度,以及內容安全,排除有害或冒犯性內容、可識別的個人資料與冒充真人的內容。微軟表示,正因為資料完全合成又通過安全檢查,各團隊才能直接共用這些評測環境做實驗與回歸測試,不必每次重跑隱私審查。整條管線也保留了資料出處與流向的追蹤紀錄,需要引用真實統計分布的地方,只使用保護隱私的聚合形式。
兩個數字回到官方公告看。39% 出現在「結果與影響」段:內部綜合品質分數(量測合成資料反映真實企業環境複雜與模式的程度)比起專案初期的生成做法提高 39%,部分產業環境的品質分數超過 0.9(滿分 1.0)。這些都是資料品質分數,0.9 不能換算成「現場工作九成成功」,更不能寫成「Copilot 準確率提高 39%」。
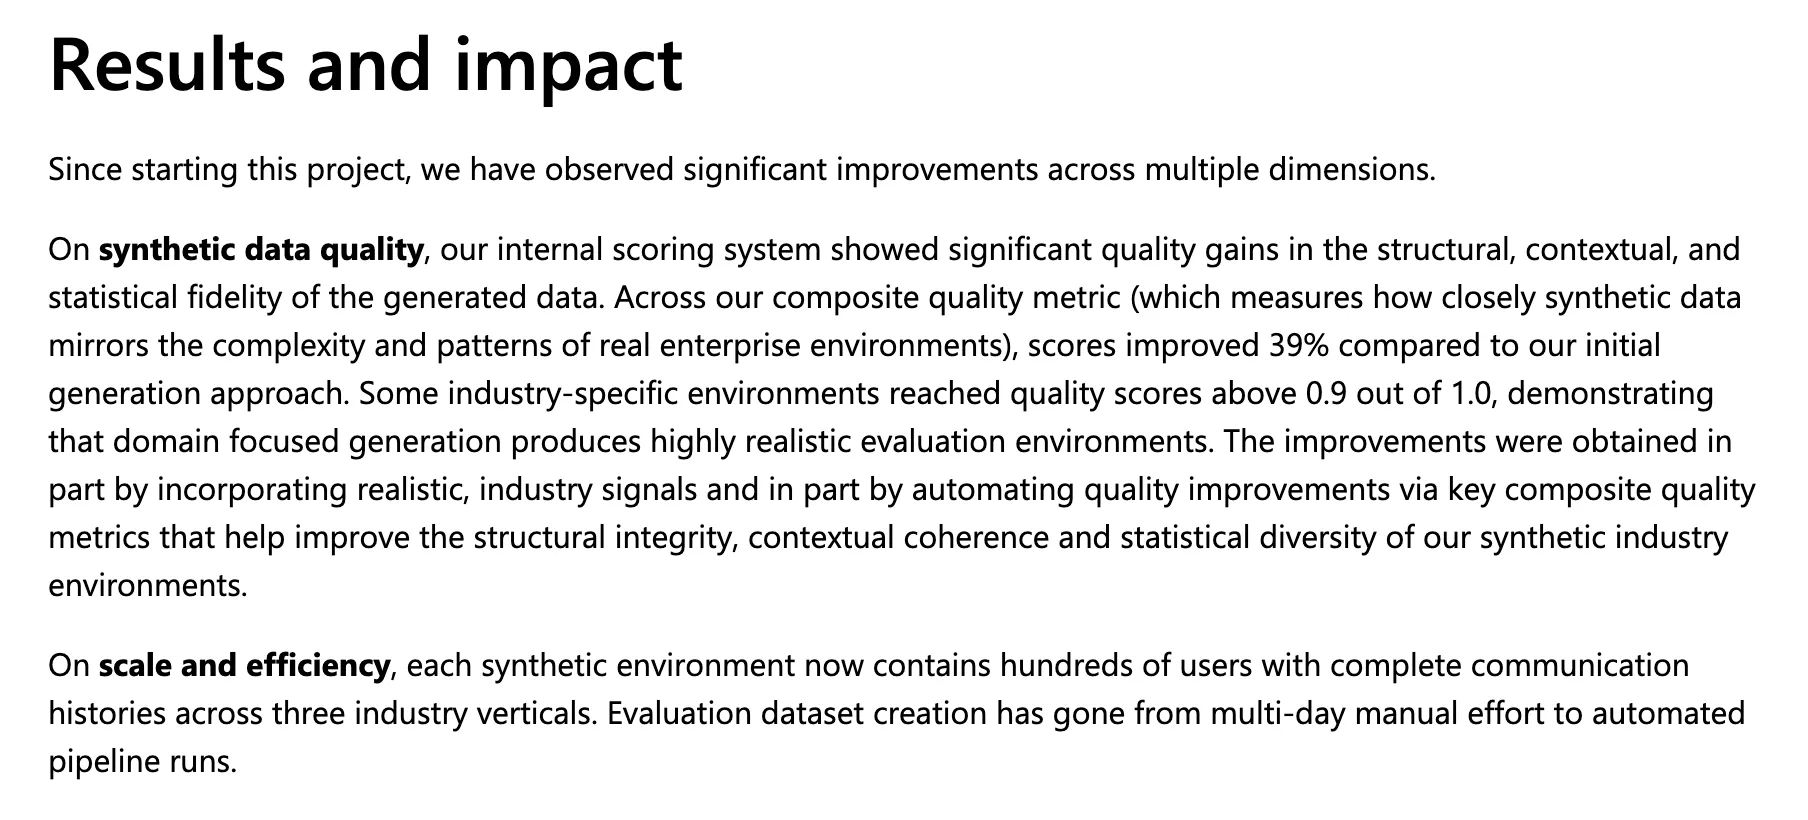
成本數字則是微軟自行估算的節省:每個評測資料集約省 10 萬美元,整個專案約 30 萬美元,比較對象是原本需要多天的人工製作流程。它不是平台售價(公告未提及對外銷售或定價),也不是哪家客戶導入 Copilot 後回收的金額。
規模面的數字倒是具體:每個環境有數百名虛構使用者與完整通訊歷史,三個產業並行,資料集製作從多天的人工流程變成自動化執行,而且同一份設定重新生成會得到相同結果。
自動化不是為了省錢而已,公告列出的理由更根本。人工製作每次都會產生細微不同的結果,跨版本比較就不可靠;產業數量與設定變體的規模超過任何團隊能手工負擔;人工製作要花上數天,拖慢修正循環;沒有標準化工具時,不同團隊做出來的評測資料集格式互不相容、品質參差。對微軟內部而言,這才是這套方法最有價值的部分:跨版本比較變得可靠,分數變動才有解釋空間。
負責評估 AI 助理的團隊,可以直接從這套方法檢查三件事:題目要有可追溯的答案,先確認答案真的存在於測試資料裡再問模型;同一件事保留不同日期的版本,看助理會不會把舊資料當成現況;固定可比較的基準,服務或模型改版前後用同一批題目重跑,分數變化才有意義。
拿一個台灣辦公室常見的場景套用:採購案換手。可追溯的題目會先在測試資料裡放好供應商評估紀錄、交接郵件與最新的負責人聯絡資訊,再問「這家供應商現在誰負責、上次評估結論是什麼」。答錯的方式還能分類:找到對的專案卻引用換手前的舊負責人,與完全找不到評估紀錄,是不同的問題,修法也不同。前者該修的是時間判斷,後者該修的是檢索。錯誤可以被分類,驗證才會產出可以行動的資訊。
導入規模與驗證是兩回事。福斯為 33 萬名員工配備 Copilot 的新聞展示的是部署的廣度,而這篇公告展示的是測試的深度,前者不保證後者存在。企業在看任何「大規模導入 AI」的案例時,值得同時問一句:驗證基準是什麼,可不可以重跑。
也不用急著模擬一整間公司。微軟的做法背後有自動生成管線與法務審查的資源門檻,小團隊先挑一件最常見的工作,寫幾題答案可查核的題目,加入同一件事不同日期的版本,就能先看出助理會不會選對資料。驗證的起點不必是完美的模擬,而是答案可以被檢查的題目。
公告留下幾個未解的問題:資料集會不會開源、平台會不會產品化、對外有沒有定價,文中都沒有給答案。微軟自己列出的後續挑戰也都還在清單上:多輪代理互動怎麼評、橫跨數月到數年的組織演變怎麼模擬、會採取行動而不只是產生文字的 AI 系統怎麼測。
數字有時效。39% 與 30 萬美元是 10 月 30 日公告當下的內部口徑,之後微軟若再公布評測進展,或這批資料對外開放,相關說法就需要回查更新。在那天之前,這篇公告最穩定的價值是方法本身:考場自己蓋,考題自己生,答案可查核。
這批合成資料集可以下載嗎? 公告沒有宣布開源,目前是微軟內部資產,外部無法取得。
39% 可以寫進導入簡報當成效嗎? 不建議。它量的是合成資料品質的進步,拿來描述 Copilot 的表現是張冠李戴。
沒有生成平台的小團隊,現在能做什麼? 挑一件最常見的工作,寫幾題答案可追溯的題目,加進同一件事不同日期的版本,先看助理選對資料了沒。