TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

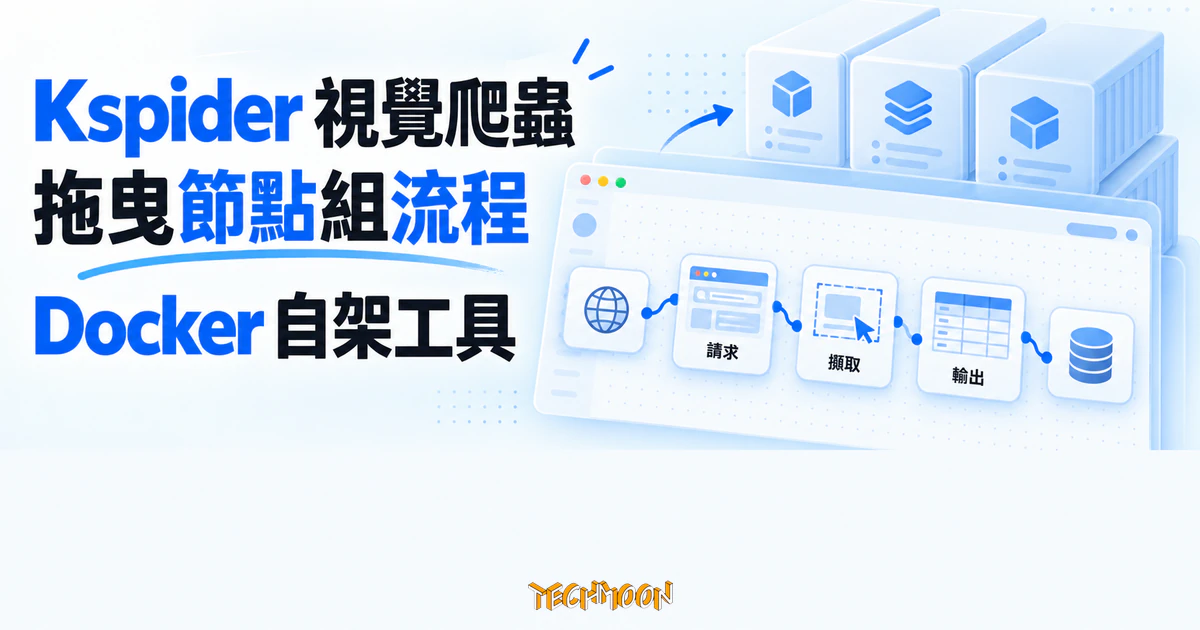
Kspider 是 1,268 星的 MIT 開源視覺化爬蟲平台,把節點拖成流程圖就能抓網頁資料。實測在 Apple Silicon 用三個 Docker 容器完整自架:後端 5 秒起動、任務真的爬到資料;但專案開發停在 2024 年 8 月、官方站已連不上,密碼明文儲存、流程失敗只留一行「執行出錯」。放內網當個人採集工作台可以,別當有維護的生產系統。
用 AI 摘要這篇文章:
想在網頁上搬資料,多數人的第一條路是寫 Python 爬蟲腳本;不想寫程式的人,則會去找八爪魚那類商業採集器。開源陣營裡另一種做法,是把整個爬蟲做成平台:瀏覽器打開、把節點拖上畫布、連成流程圖,機器就照著圖去抓資料。Kspider 是這個思路的中國開源專案,GitHub 上 1,268 顆星(2026 年 10 月),MIT 授權,主打 xpath 與 css 選擇器、Cookie 自動管理、代理支援,還能透過 Selenium 處理需要 JavaScript 渲染的頁面。我在 Apple Silicon 的 Mac 上把它完整自架起來跑了一輪:三個容器叫起整個平台、登入操作介面、建了一條最短的爬取流程出任務,機器真的抓到了資料。它也是一個開發停在 2024 年 8 月的專案,官方網站現在已經連不上。這兩件事同時成立,正是用它之前最該理解的一件事。
把時間軸攤開會先讓人猶豫。倉庫 2024 年 7 月 7 日建立,前後兩位開發者,30 天內擠出 6 個版本,8 月 19 日發完 v0.0.6 之後 main 分支就凍結到今天,超過兩年沒有新的提交;對應的前端倉庫 kspider-ui 也停在同年 8 月 20 日。官方網站 kspider.kangert.top 現在連不上,瀏覽器打開只會看到連線失敗;文件站掛在 GitHub Pages 上還活著,倉庫裡的 issues 也有人問「停更了?」,這則 2025 年 9 月開立的提問至今沒有作者答覆,另一則問入群答案的提問同樣掛著。星數的走勢與程式碼脫鉤:專案不動了,星還是緩慢在長,這是 GitHub 上「留下來的骨架」常見的樣貌。
但映像檔還在。Docker Hub 上的 kkangert/kspider 最後更新就停在 v0.0.6 那天, amd64 與 arm64 兩種架構都有,累積下載不到兩千次。我在 2026 年 10 月用它自架:MySQL 8.0.38 資料庫、Kspider 後端、kspider-ui 前端三個容器跑起來,Spring Boot 後端 5.24 秒完成啟動,瀏覽器打開前端頁面,登入頁、流程設計器、任務管理全部正常載入。一個兩年沒動的 Java 專案在最新版 arm64 環境直接跑通,沒有編譯、沒有改設定檔,這點比多數同處境的開源專案體面。
部署檔放在倉庫的 deploy 目錄,一份 compose 檔加一個環境變數檔就描述完整個棧:資料庫預設密碼寫著 123456,前端佔 80 連接埠,後端佔 8086。照著把三個容器叫起來後,你會撞到第一個門檻:這個平台沒有註冊介面。文件教的辦法是直接連進資料庫,手動執行一行 SQL,往 kspider_user 表裡插入使用者名稱與密碼。文件給的範例帳號密碼是 kangert 與 111111,插完之後拿這組帳號登入,就能進到管理介面。
這個步驟官方寫得理所當然,但它透露了整個專案對「帳號系統」的態度:使用者管理列在 README 的 TODO 清單上,和分散式部署、OCR 節點一樣,都是規劃過、沒做起來的功能。對自架者來說,這表示你要嘛接受單人使用,要嘛自己往資料庫塞多個帳號,沒有角色、沒有權限分級。
進到流程設計器,左側是 12 種節點:開始、請求、變數、函數、循環、輸出、等待、延時、SQL、子流程、備註、Selenium。玩法是把節點拖到畫布上連成圖,起點必定是開始節點,接一個請求節點填網址,再用輸出節點指定結果去處。我組了一條最短的路:開始、請求 example.com、輸出成 CSV,欄位抓 HTTP 狀態碼與頁面標題。
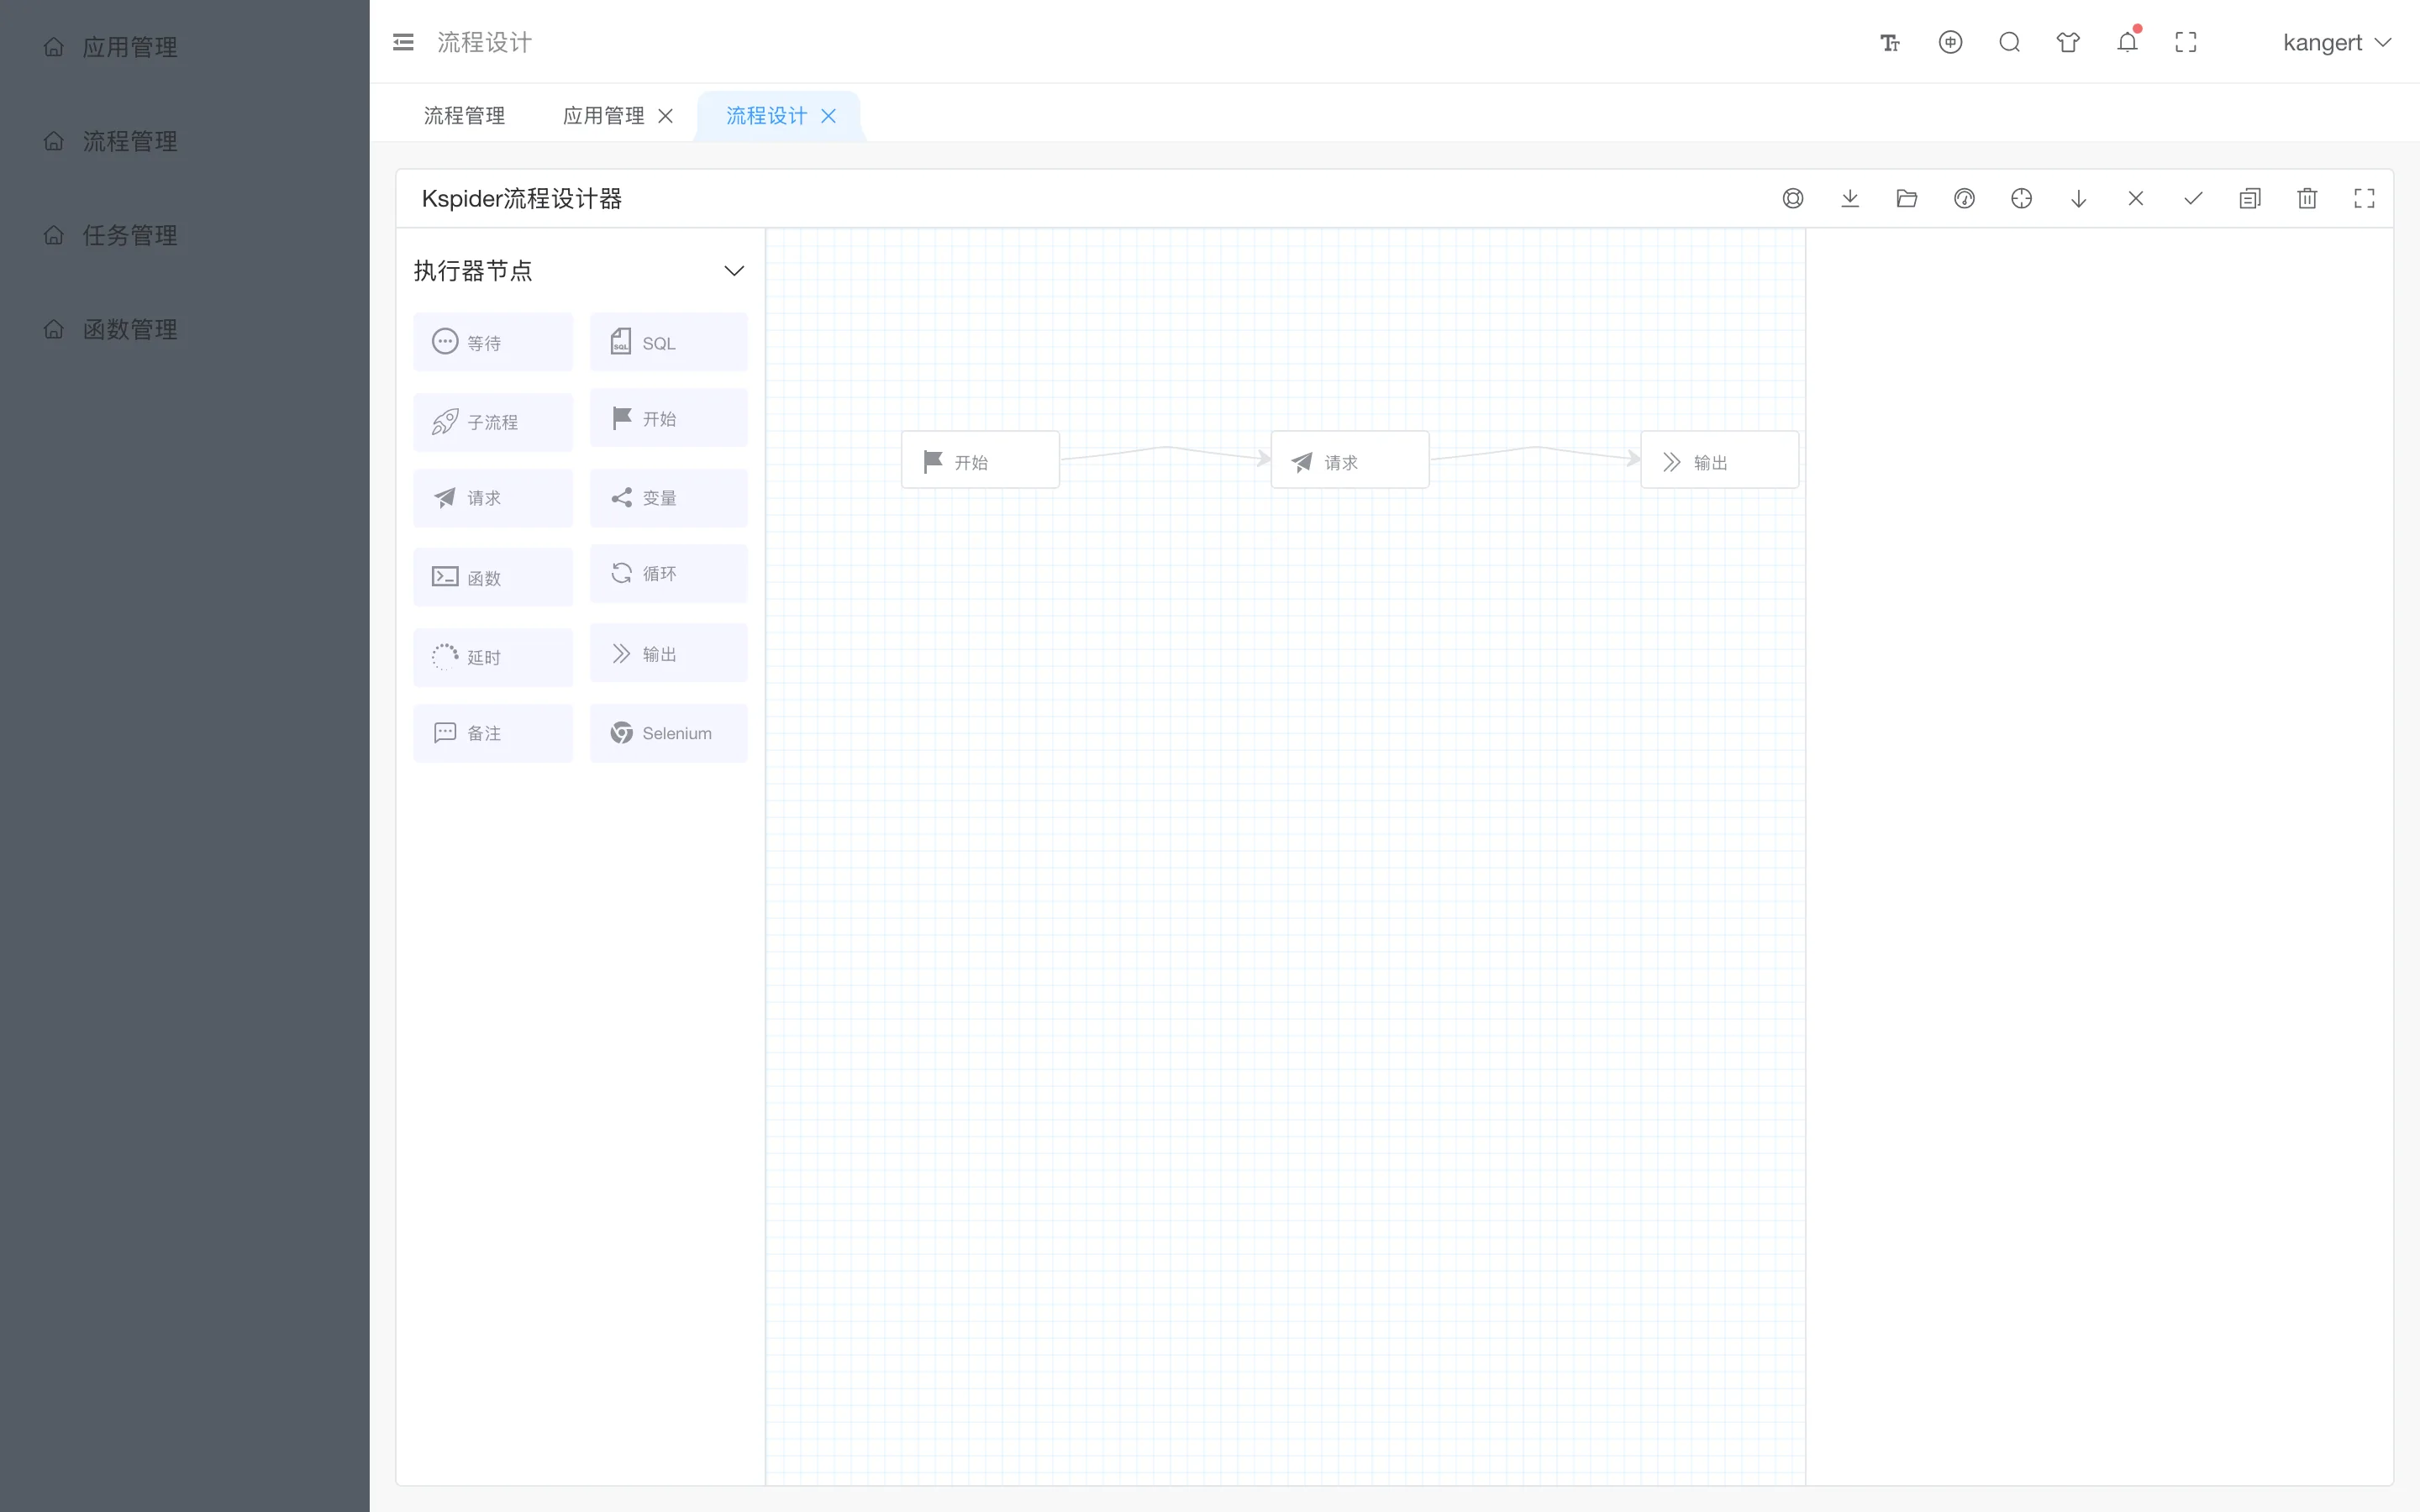
畫布之外的管理頁共四個:應用管理、流程管理、任務管理、函數管理。函數管理是給進階使用者的一格,讓你自己寫 JavaScript 函式在流程裡呼叫,文件的豆瓣案例就用了一個自訂函式把 Selenium 抓到的元素清單整理成字串。設計器工具列上除了提交流程,還掛著測試流程、開啟除錯、單步除錯,以及把整條流程下載成 JSON、再從檔案匯入的進出口;流程在資料庫裡本來就是一份 JSON 文件,下載匯入等於把別人畫好的圖搬進自己的站,這對團隊內分享爬蟲流程算實用的設計。
送出任務後,任務日誌依序出現「設置請求 URL」「查看發送請求 URL」,然後「執行完畢」。進容器看產物,CSV 檔案確實生成了,落在工作目錄的 files 資料夾下,狀態碼欄位寫著 200。也就是說,這套凍結兩年的平台,核心的抓取鏈路在今天仍然可用。
不完美的地方也真的遇到了。頁面標題這個欄位在 CSV 裡是空的,而且空的方式有點糟:表頭寫了兩欄,資料列卻只有一欄,因為輸出邏輯是「有值才寫」,值抓不到就整欄跳過,後面的欄位往前擠,檔案打開就是歪的。對照原始碼更確定這是行為而非偶發:輸出事件的處理函式對每個輸出項檢查是否為 null,null 就不加進資料列。要避開它,輸出前得先確認每個變數真的有抓到值,或者分開多次輸出。
另一個只會發生在「不照 UI 流程走」的人身上的坑:我起初用 API 直接組流程 JSON 繞過畫布,輸出節點少帶了檔案編碼欄位,任務直接失敗,錯誤是空的字元集名稱。用介面建流程時這個欄位有預設值,不會踩到;但這也說明這套系統對「欄位沒給」的容忍度很低,少一個欄位並不會自動補上預設值,而是直接倒下去。
自架一套要登入的平台,最該看清的是帳號資料怎麼存。這裡可以給得很直白:明文。登入的原始碼就是拿你輸入的密碼字串,和資料庫欄位裡的字串直接比對,全程沒有雜湊;我在資料庫裡查使用者表,剛才那組 111111 就原樣躺在密碼欄位。文件會教你用 SQL 建帳號,正是因為系統本來就預期密碼以明文存在表裡。
登入後的 session 權杖(token)設計也值得知道:產生方式是把當下時間、使用者名稱、密碼和一個亂數接在一起做 MD5。密碼參與了權杖的原料。另外,專案的最後一次提交修的是登入後 Cookie 設定的臭蟲,修法是把 Cookie 的安全屬性關掉,讓 HTTP 連線也能帶著權杖走。這些放在 2024 年的個人開源專案裡不算罕見,但放到今天自架,就是「位置擺對、預設從嚴」的問題:放內網、給它一組專用密碼、不要把 8086 連接埠暴露到網際網路上,做輕量資料採集沒問題;反過來操作,風險全在你身上。
前面提過任務失敗過幾次,過程裡最折騰人的不是失敗本身,是找原因。任務日誌對任何失敗都只寫一行「執行出錯」,沒有例外訊息、沒有堆疊、沒有失敗在哪個節點。翻原始碼找到解釋:執行流程的程式捕捉所有例外後寫日誌,呼叫日誌函式時只帶了流程名稱與任務 ID,把例外物件本身留在手上沒交出去。一行程式碼的事,除錯體驗就從「看日誌找原因」變成「自己進容器翻主日誌、對照原始碼猜」。
同樣不友善的還有 REST API。它的查詢端點會把請求裡的每個欄位都當成資料庫查詢條件,傳個分頁參數進去,系統直接拋例外;建立任務時的 metadata 參數,在文件與程式裡都拼成 matedata,而且傳物件會炸、要傳字串才收;編輯流程時 JSON 要以字串形態送出,用物件形態送會被靜默轉成另一種內部格式存進資料庫,之後任務必失敗,失敗原因同樣只有那一行字。對想拿它做自動化整合的人,這些 rough edge 意味著 API 目前只適合前端自己用,對外要再包一層。
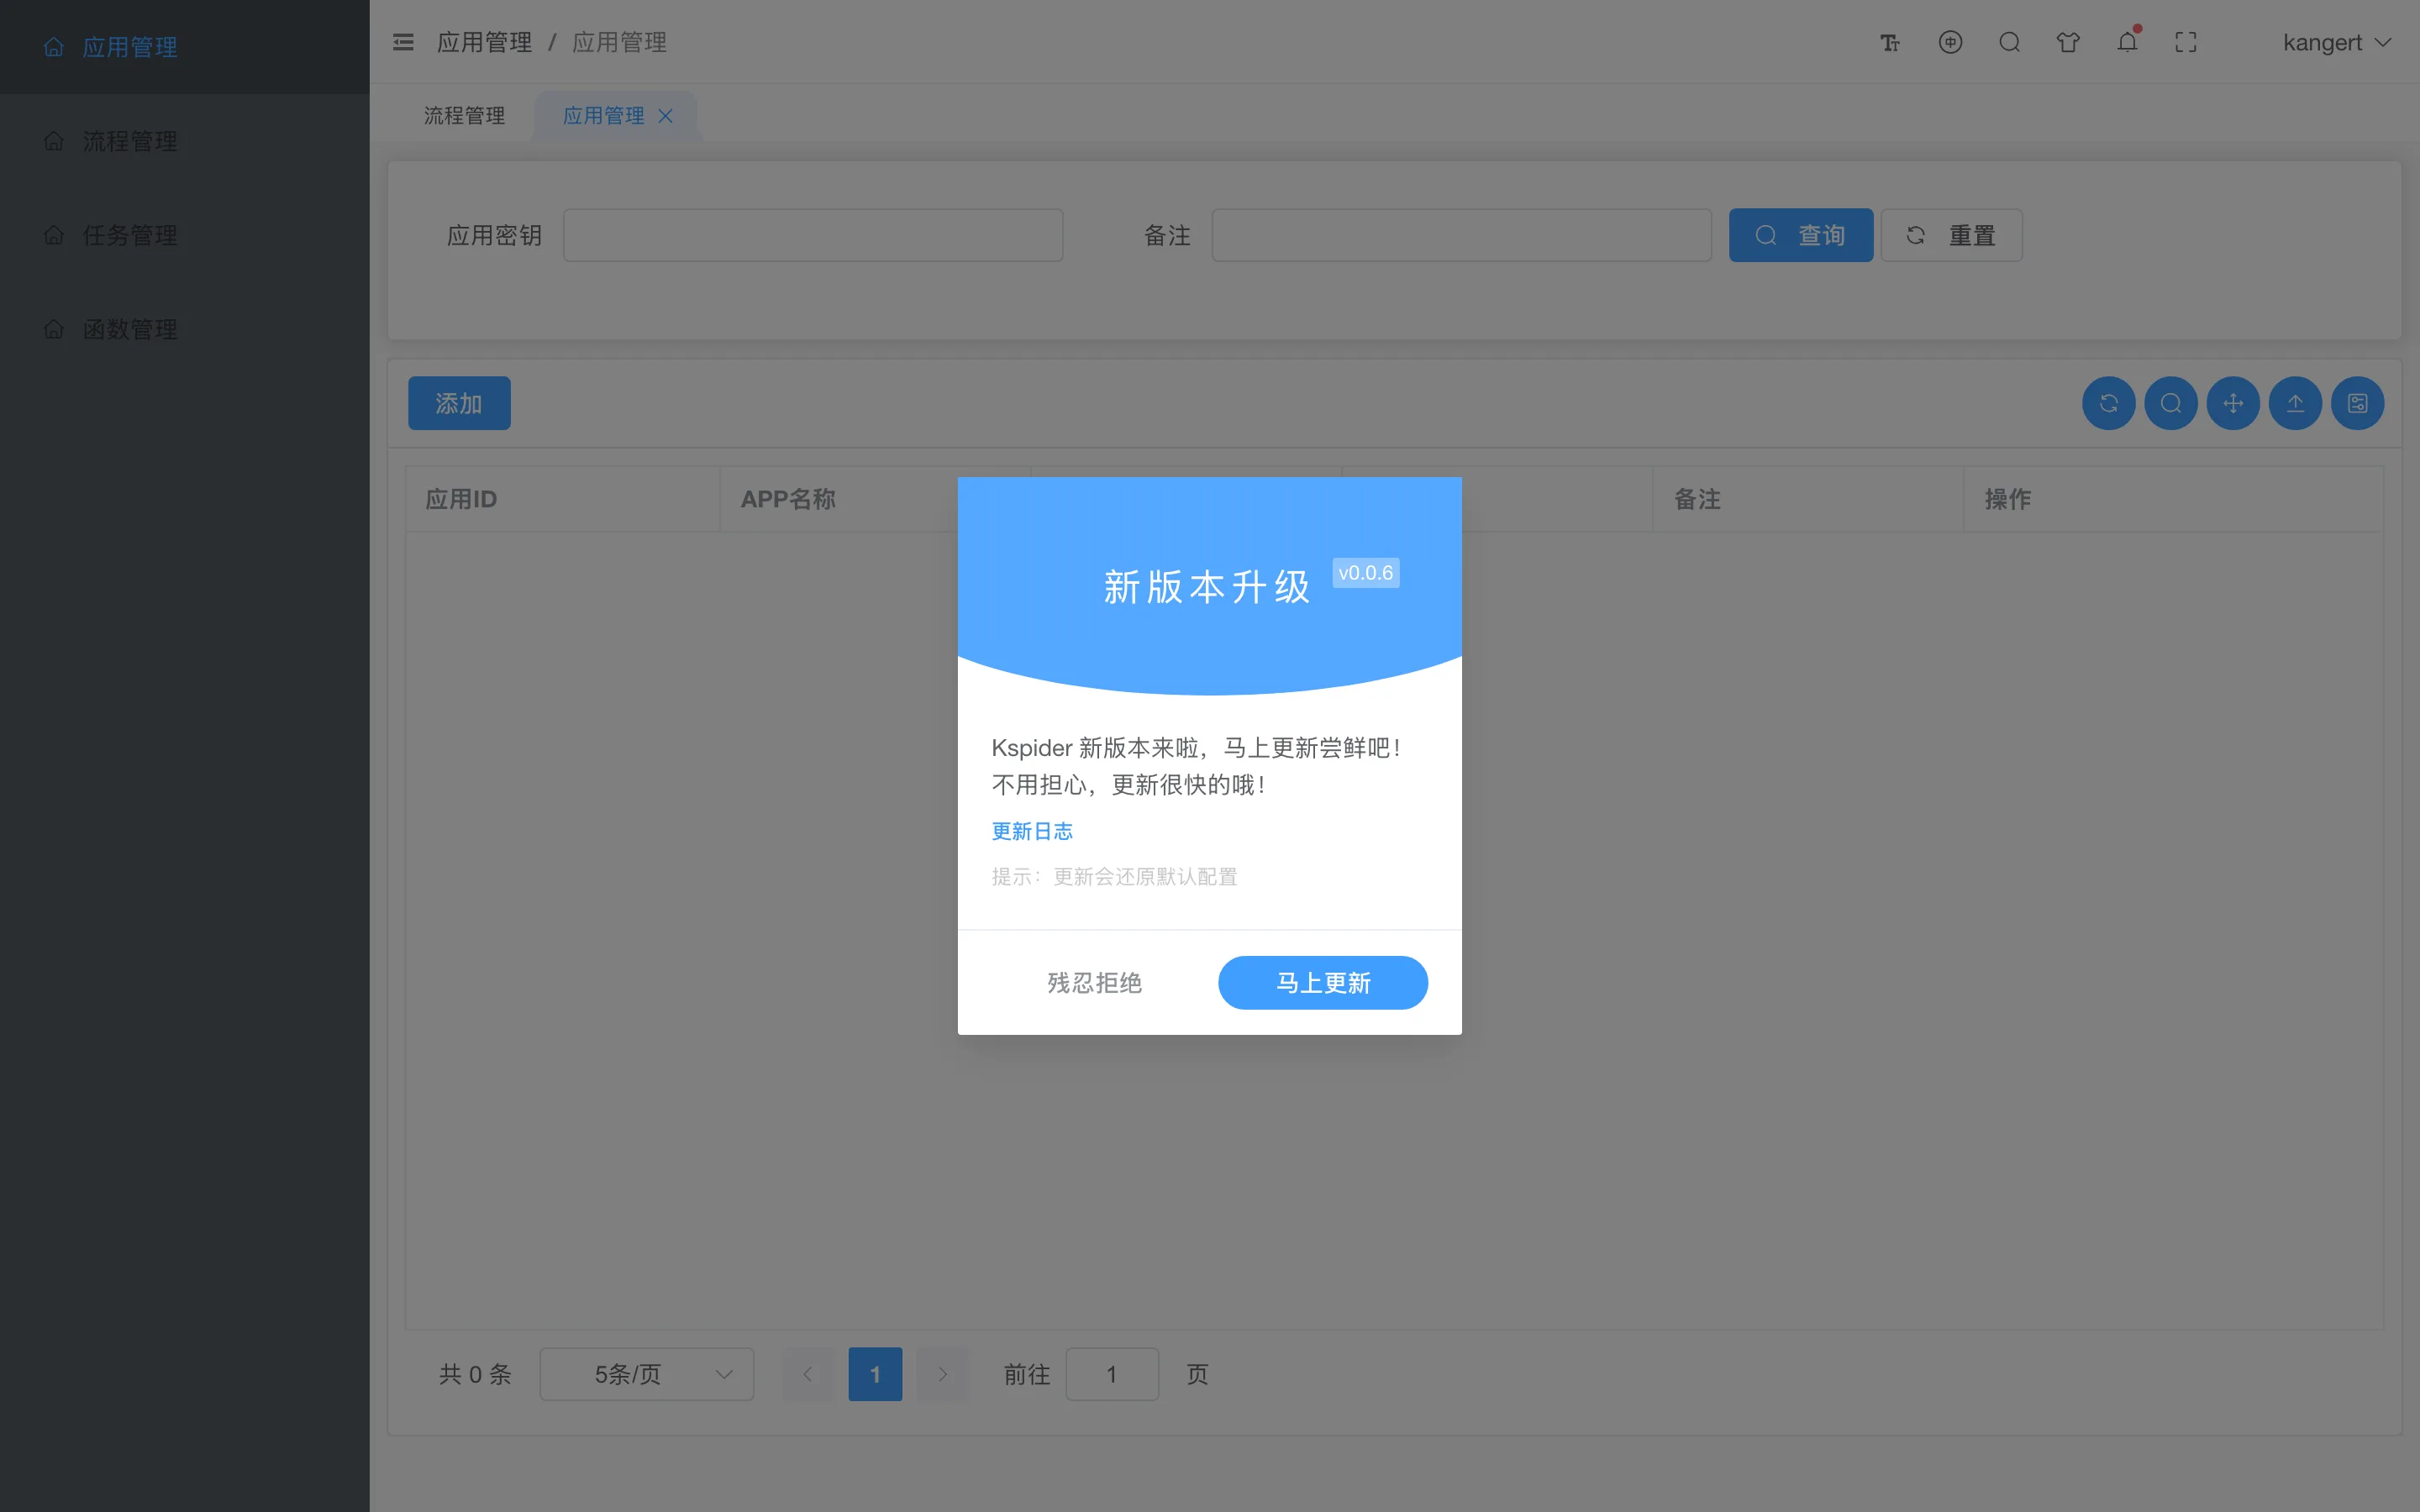
還有個第一次登入一定會遇到的小鬧劇:介面彈出「Kspider 新版本來啦」的升級提示,寫著 v0.0.6,但我跑的映像就是 v0.0.6,已經是最後一個版本。按下去會發生什麼?原始碼顯示那顆「馬上更新」按鈕做的是清掉瀏覽器的本地設定、重新載入頁面,沒有任何下載或升級動作;提示文字說更新會還原預設配置倒是真的,因為清的就是你的設定。那是前端管理模板內建的提示元件,比對對象是瀏覽器裡存的版本號,第一次造訪必彈。認清它是裝飾就好。
文件站上唯一的完整實戰教學,是爬豆瓣熱映電影:從首頁點進正在上映清單,逐部電影進詳情頁抓簡介與影評,再用循環節點跑完全部項目。值得注意的是它的起手式:這條流程用的是 Selenium 節點,而且要求另外準備一個遠端 WebDriver 環境,compose 檔裡對應的 selenium 容器預設是註解掉的。換句話說,文件中最完整的範例,需要的準備工作比「三個容器跑起來」多一截,而且那個 selenium/standalone-chrome 映像版本停在 2023 年。我這次沒有重現豆瓣這條流程,所以對動態頁爬取的實際表現不下判斷;但靜態請求、選擇器抽取、CSV 輸出這條主幹,實測是通的。
這也是評估此類專案時常見的落差:展示影片裡點兩下就抓完一頁動態內容,背後是瀏覽器驅動、版本相容、反爬對策一整套基礎設施。Kspider 在反爬這格有做功課:後端資源裡直接綁了一份瀏覽器反偵測腳本(stealth script),Selenium 節點驅動瀏覽器時可以帶著用,降低被目標站認出的機率。但它把整套複雜度誠實地留在 compose 檔的註解與原始碼裡,沒有藏,也沒有幫你消化。
評估它的關鍵問題只有一個:你的資料來源長什麼樣子。以靜態頁面為主的話,請求加選擇器加輸出的組合夠用,實測也驗證了這條路是通的;要抓的網站若大量依賴 JavaScript 渲染,就得連 Selenium 那整套一起扛,門檻立刻不一樣。在這個前提之下再疊兩個接受度:映像檔跑得起來不等於有人修 bug,遇到問題的求解路徑是原始碼加容器日誌,社群兩年沒有動靜;明文密碼與非安全 Cookie 的組合,決定了它只該活在內網。
這些前提都過了,它的定位其實相當明確:內網的個人採集工作台。流程圖式的操作對「會看 HTML 結構、不想維護腳本」的人有實質價值,MIT 授權讓你改了拿去內部用沒有法律負擔,README 列出 PostgreSQL、SQLite、Oracle 等多種資料庫支援(這次實測用 MySQL),也不綁死在特定環境上。若是個人想把網頁內容存檔留底,先前介紹過的 Maoxian 網頁剪藏走瀏覽器擴充路線更輕;若關心的是爬蟲工具本身的帳號與合規風險,NioLeads LinkedIn 爬蟲的實測提供了另一種視角;想把開源工具放進自己的基礎設施長期跑,NewsNow 熱榜聚合那篇對自建選項的盤點也值得對照。
一句話總結:Kspider 是一張凍結在 2024 年 8 月的完整藍圖,平台功能都在、爬取鏈路可用,安全與除錯的短板也原樣凍結在那裡。把它放對位置,它是一套誠實的開源工具;放錯位置,它是一套沒人幫你收尾的生產系統。