TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

ChatLab 是開源的聊天記錄分析工具,把匯出的 LINE、WhatsApp、Telegram 對話收進本機 SQLite,用圖表與 SQL 挖出說話規律。本文實測命令列版全程,並拆解它「本機優先」的三個但書,以及各平台匯出功能的真實門檻。
用 AI 摘要這篇文章:
想回顧自己跟某個朋友聊了三年的對話,大多數人能做的只有拿出手機一直往上滑。開源專案 ChatLab 給了另一條路:把聊天記錄匯出成檔案,丟進它的本機資料庫,然後用統計圖表和 SQL 查詢去挖它。這套工具在 GitHub 上已經累積超過 7,500 顆星,授權採 AGPL-3.0,桌面版與命令列版兩種官方安裝形態都免費。
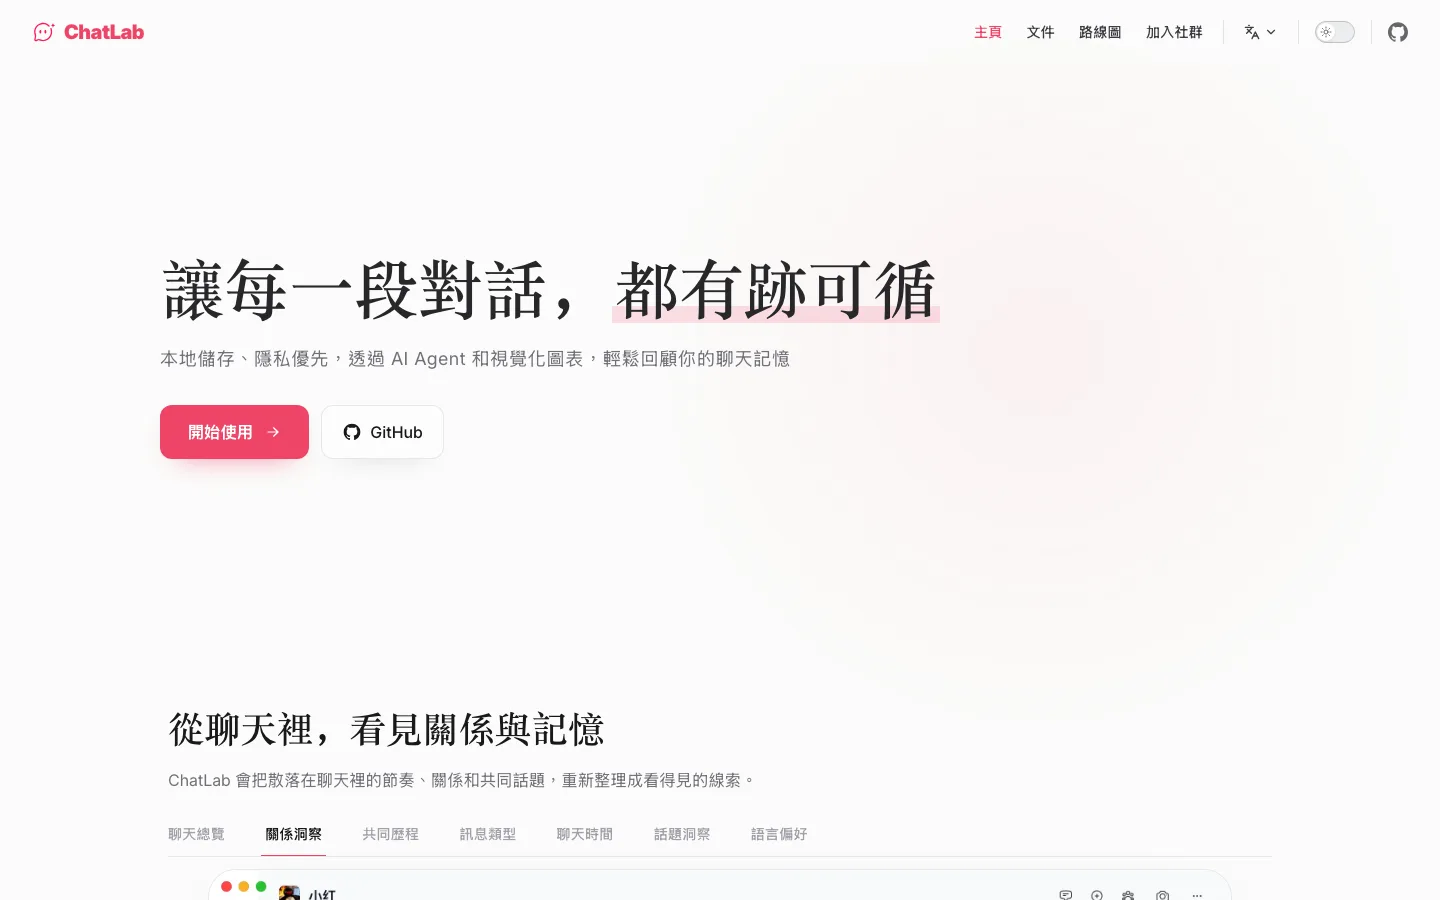
我這次實際用命令列版跑完整輪:安裝、起本機 API 服務、匯入 415 則測試訊息、下 SQL 查統計、再把資料原封匯出。先講結論:它對「資料留在本機」這件事是玩真的,訊息落地成你家目錄裡的一顆 SQLite 檔案,查詢引擎設成唯讀,連 AI 都不能改你的原稿。但官網那句「拔了網線也能用」有三個但書,而且這工具只負責「分析」這半段,你的對話能不能進來,先被各平台官方匯出功能的殘缺程度決定。下面就把這兩件事拆開講。
命令列版的安裝就一行 npm 指令,0.37.5 版連同依賴共 298 個套件,在我的機器上花了約十四秒。啟動用的是 clb web 指令,可以帶上自訂埠號與存取權杖,起來的是一個只綁在本機 127.0.0.1 的 API 服務,任何請求都要帶權杖才理你。開機過程它自己做資料庫結構遷移,日誌裡看得到從 v2 一路升到 v4,其中一個遷移把加密過的 API 金鑰搬進獨立的驗證設定檔,看得出金鑰的存放方式改過世代。
第一個反常的地方出現在這裡。官方網站的繁中版主打「本地分析,保護隱私」「拔了網線也能用」,但我眼前這個剛啟動的行程,第一件事是連回 chatlab.fun 下載一份中文斷詞辭典,5,071,843 bytes,抓完才安靜下來。翻原始碼可以對上:辭典下載位址就寫死在程式裡,服務啟動註冊路由時就會背景下載這份預設詞庫,抓不到也只是警告,工具照樣能跑。所以精確的說法是,第一次啟動需要網路,之後離線可用。這不是什麼大問題,但如果你是衝著「完全斷網也能用」這句話來的,要知道它有個第一次的例外。
我生了一份合成測試對話:三人小群組、跨 150 天、共 415 則純文字訊息,時間分布故意偏向傍晚,再照文件格式透過 API 推進去。回應很乾脆:收到 415 則、寫入 415 則、重複 0 則,對話建立起來,三位成員都進了名冊。
資料落在哪裡不用猜,就在家目錄的 .chatlab 資料夾底下,每個對話一顆獨立的 SQLite 檔案,我這顆 415 則的測試庫連同索引共約 170 KB。打開看結構,訊息表、成員表之外還有一張成員改名歷史表,群組裡誰換了暱稱都留得住記錄。這對「把資料握在自己手裡」是最實在的一種兌現:備份就是複製檔案,刪除就是刪掉檔案,邊界看得見。
查詢能力是真的。概覽統計一叫就回:我自己的帳號 174 則佔 41.93%,另外兩人 121 與 120 則,加總對得上匯入數。改用 SQL 下查詢,按人分組的計數跟概覽一致,按小時分組的查詢也立刻把合成資料裡傍晚偏重的分布拉了出來。更有意思的是防護設計:我送了一句刪除資料的敘述進去,伺服器直接回絕,只放行 SELECT 與 WITH 這兩種查詢語法,連嘗試的機會都不給。也就是說,後面那個會自己下 SQL 的 AI 助手,權限被鎖在只能讀、不能改,亂來也動不了你的原稿。
表結構裡還藏著兩個值得注意的設計。一張斷詞段落表,配合那份開機抓回來的中文辭典,負責把訊息切成詞給統計與主題分析用,這是中文用戶有被照顧到的證據。另一個是語意索引:依賴清單裡看得到它用了 sqlite-vec 這套 SQLite 向量擴充,連「用意思找句子」的向量搜尋都落在本機資料庫裡跑,而這個向量模型的設定又是指向哪台伺服器由你決定,與聊天 AI 的邊界同一套邏輯。
匯出方向也驗了:API 把整個對話包回標準 JSON 格式還給我,415 則一則不少,成員與詮釋資料都在。等於這顆資料庫有完整的進出雙向,不是只進不出的黑洞。
不想碰 SQL 的人,圖表層把最常用的問題都做成了現成畫面:字詞頻率與詞雲、發言排行榜、互動熱力圖、活躍時段分布、訊息類型分布,群聊與一對一對話各有自己的分析頁籤,連語言偏好都看得到。這些圖表背後跑的就是前面那顆 SQLite,同一份資料,懂 SQL 的人查得更細,不懂的人點得動,兩種使用者拿到同一個真相來源。
開發者角度補一件小事:文件頁寫的匯入端點是 /api/v1/import,實際打會得到 404,目前版本真正的路徑是 /api/v1/imports/ 加上你自訂的對話 ID。文件與程式碼之間的這種小漂移,整合的時候直接看原始碼最快。
隱私宣稱是我看這類工具最挑剔的地方,因為「不上傳」三個字可以被拆成好幾種真相。ChatLab 值得肯定的是它自己把層次講得比多數同類清楚,而我用原始碼與實測把三層各自對了一遍。
資料層,過關。訊息、索引、設定都住在本機檔案裡,服務起來之後我檢查過這個行程的網路連線,只剩本地監聽,沒有對外連線。協議裡寫的「預設零上傳」在這一層成立。
遙測層,兩種版本都一樣要看。官方使用者協議自己承認:為了改進產品,程式會回傳匿名識別碼、執行環境與功能使用情形,不含聊天內容,而且預設是開的,要到設定裡手動關。我讀了實作:回報走的是 Umami 這套開源統計服務,回傳位址與站點標識在官方釋出流程裡用金鑰烘進安裝包,我把 npm 上的命令列版整包解開來看,同樣找得到這組位址,換句話說桌面版與命令列版都帶著它出廠。事件清單包括應用啟動、每日活躍、匯入的開始與成敗、功能使用,以及 AI 請求的起訖,每筆都附帶一個 AI 是否已設定的布林值。實際動手的時機倒是值得記下:這些事件是網頁介面啟動時去按的,我用 headless 模式只開 API 跑完整輪,沒有介面就沒有事件,行程確實全程對外靜默。介意的人不必換版本,到設定裡把匿名統計關掉就好,兩種版本都有效。
AI 層,邊界寫得最明白,也最躲不掉。內建 AI 助手的設計是你自己填模型服務商、位址與 API 金鑰,文件拿 DeepSeek 當示範,要你自己去儲值開 key。官方對資料流的說法是:啟用 AI 之後,只會把當前問題需要、且經過處理的內容,送給你設定的模型服務商。換句話說,開了 AI,那一輪對話的相關內容就離開你的機器,去向你選的那家。不想出門的人有退路:它支援接本地模型,語意索引的向量模型另有獨立設定可以指向本機,官網自己也建議條件允許的話用本地模型。這一層的判準很簡單,鑰匙在誰手上,內容就到誰家。
廠商行銷句裡的「百萬訊息也能順滑瀏覽」與「24 個以上 Function Calling 工具」這兩個數字,我沒有那個量級的資料可以驗,就當官方宣稱聽。架構上它確實用串流解析與多執行緒平行在處理匯入,這部分與宣稱的方向一致。
ChatLab 在文件裡把話說得很白:本工具分析的是已經匯出成固定格式的聊天記錄,不提供任何解密、抓封包或匯出工具。這句話決定了使用體驗的真正瓶頸。進料有三條路:把檔案拖進主畫面、接外部來源自動同步、或開本機 API 讓腳本推送。但檔案從哪來,是你的事,而各平台給的官方匯出通道,殘缺程度差很多。
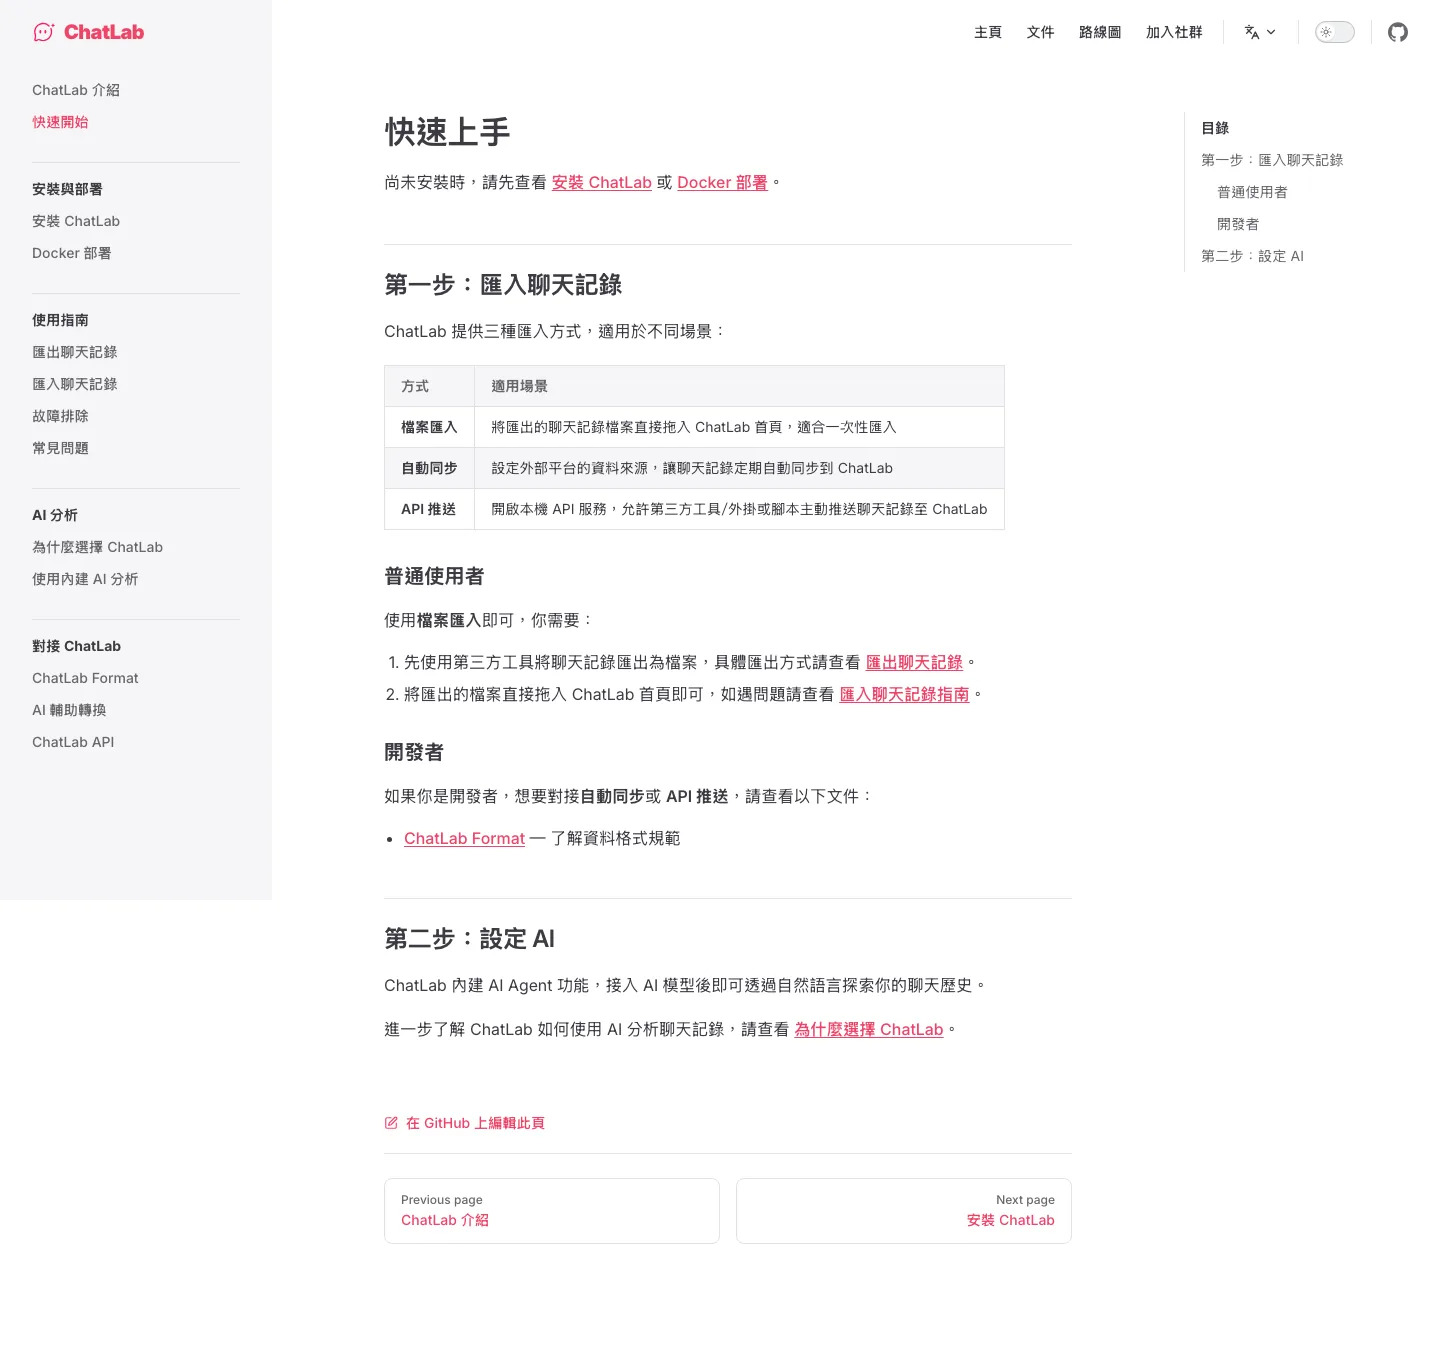
WhatsApp 走官方的「匯出聊天」,產出純文字檔,注意要選不含媒體的選項。Telegram 要用桌面版的匯出功能,格式選機器可讀的 JSON。Instagram 用官方的「下載你的資訊」,從壓縮檔裡找出對應的 JSON 檔,第一次申請要等平台處理。Google Chat 靠 Takeout 匯出,只吃 ZIP、不吃 tgz,首次匯出同樣要等上幾小時。Discord 官方沒有匯出功能,文件直接指引你用第三方開源工具 DiscordChatExporter。iMessage 最技術流:文件推薦一套 Rust 寫的第三方工具,用 cargo 裝起來直接讀 macOS 本機的訊息資料庫,然後轉成 ChatLab 的標準格式。
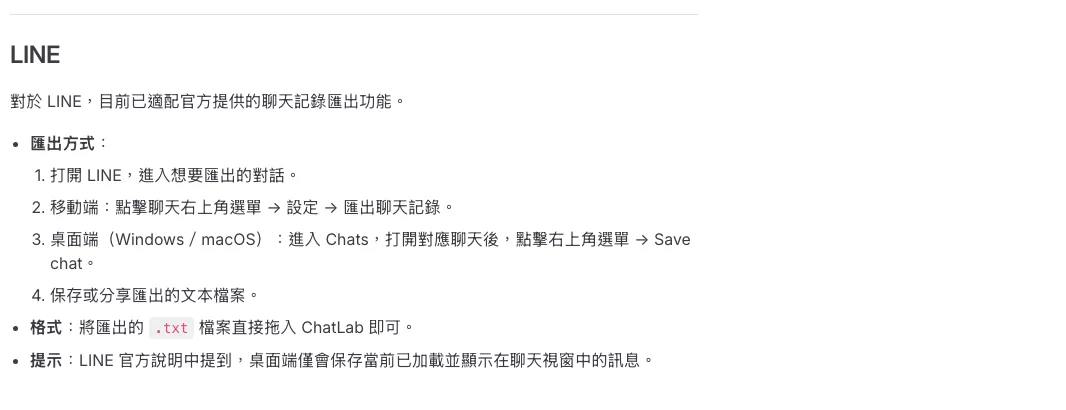
在台灣最要緊的當然是 LINE。手機版的聊天記錄匯出是正路:打開對話,右上角選單進聊天設定,匯出聊天記錄,產出純文字檔直接拖進 ChatLab 就行。但電腦版的「儲存聊天」有個官方限制,ChatLab 文件引了 LINE 官方說法提醒你:桌面版只會存下當時已載入、顯示在視窗裡的訊息,沒載入到的舊訊息不會進檔案。實際意思是你想分析一整年的群聊,要嘛在手機上慢慢匯,要嘛在電腦版使勁往上滑把歷史載完再存,否則拿到的是斷頭的記錄。這種限制跟工具無關,純粹是平台給多少你拿多少。
微信的處境更微妙。它的解析器還留在程式碼裡,能吃兩套第三方微信匯出工具的輸出檔,但 2026 年 6 月中一個提交把微信從官方支援名單上拿掉了,README 與匯出指南從此都不再列它。原因不難猜:微信沒有官方匯出通道,要拿到資料得靠第三方工具從本地資料庫動手腳,官方列名等於變相背書。現在的狀態是程式相容、官方不提,要用的人自己找匯出器、自己扛風險。QQ 也類似,README 列了支援,匯出指南裡卻沒有對應段落,實務上同樣要靠第三方匯出器。讀平台名單的時候記得一個原則:列了不等於好拿,沒列的也未必不能分析,ChatLab 另外提供 AI 輔助轉換,官方說法是可以嘗試把你的資料轉成標準格式,實際成功率視格式而定。
法律邊界它也寫了,而且值得抄下來:只能分析你自己參與、合法取得的對話;涉及他人隱私時要先取得當事人的知情同意;禁止用來監控或分析未經授權的他人資訊。工具本身中立,責任在使用的人。
這個專案的體質先講清楚:倉庫 2025 年 11 月底建立,到 2026 年 10 月中還有程式碼推送,2026 年 9 月一個月內連發五個版本,桌面安裝包蘋果晶片版約 166 MB,Windows 版約 129 MB。三種形態裡,桌面版是完整功能加圖形介面,命令列版少了 Electron 殼但功能齊全,還支援 MCP 協定讓外部 AI 代理接入,你桌上的 AI 助手可以透過標準介面拿唯讀查詢來讀你的社交資料;原始碼裡另外維護一套編成 WebAssembly 的純瀏覽器形態,但官方安裝文件只提供桌面版、命令列與 Docker 三條路,瀏覽器版要自己從原始碼建置。文件裡另外附了 Docker 部署指南,自架派有自己的路可走。官網上寫著它想做「社交記憶的基礎設施」,這個願景會不會成真另當別論,從解析器、資料庫到 AI 工具鏈都拆成可共用的模組,產品方向的連貫性至少看得見。更新節奏屬於活水準,不是標本專案。
授權上有個值得注意的張力。程式碼授權是 AGPL-3.0,這條授權本身並不禁止商業使用;但匯出指南頁尾的法律聲明另寫了一條「嚴禁任何個人或機構將本軟體或分析結果用於任何形式的商業盈利行為」。兩者並存,站方立場很明確,法律效力如何是另一回事。對一般個人回顧自己的對話毫無影響,但如果你想拿分析產出做商業內容,例如把某個群聊的統計做成付費報告,先想清楚這條聲明的存在。
內建 AI 助手能做的事,官方的說法是接上模型後用自然語言問它問題,它背後有一組可以呼叫的工具去搜尋、摘要、分析你的對話。配好金鑰之後,統計事件裡連「AI 是否已設定」都會跟著回傳,變成匿名資料裡的一個布林值。
我的建議是把 AI 功能當成第二階段再開。這工具的本體價值,圖表、排行、時段分布、SQL 引擎,全部不需要 AI 就能用,也都是零出網的。AI 是加值的問答層,代價是每一輪相關內容出本機。先用零出網的部分玩熟、確認資料乾淨,再決定要不要把鑰匙交出去,這個順序對大多數人比較穩。
這工具最對味的三種人很明確。文字聊天重度使用者,尤其是 LINE 或 WhatsApp 上有多年群聊史的人,匯出之後那些「到底誰最常講話」「這群都幾點在熱絡」的問題第一次有了精確答案。會一點 SQL 的開發者,本機 API 加 MCP 協定則給你的 AI 代理開了一扇正規的門,讓它用唯讀查詢讀你的社交資料。以及在意隱私、想把個人資料分析留在自己機器上的人,這套的資料層設計經得起檢驗。
先留在月台的人也具體:微信與 QQ 用戶,官方名單不列、匯出要自己想辦法,體驗是次等的。想拿分析結果做商業用途的人,文件裡那條禁止商用的聲明先讀完。期待「裝了就自動同步整個聊天史」的人也要想清楚,匯出是手動的苦工,平台還處處設限,把它當成一次性的考古專案比當常駐服務更實際。同樣把「找自己的資料」留在本機做的工具,可以順便看看先前介紹過的本機檔案語意搜尋 Mango Finder,一個管檔案一個管對話,思路同源。
### LINE 電腦版匯出的檔案為什麼少了舊訊息?
依 ChatLab 文件引述的 LINE 官方說法,桌面版的儲存功能只存「目前載入並顯示在聊天視窗中」的訊息。舊訊息沒載入就不會進檔案,想要完整歷史請改用手機版的聊天記錄匯出,或在電腦版先往上滑載入完再存。
### 開了 AI,對話內容會被上傳嗎?
會送到「你自己設定的」模型服務商,範圍是官方說法的「當前問題需要且經過處理的內容」。不想讓內容離開機器,就把 AI 留著不開,或設定裡接本地模型,兩條路都成立。
### 完全免費嗎?
工具本身開源免費。AI 功能的帳單算在你自己的模型服務商頭上,用多少付多少,跟這個專案沒有分成關係。
### 可以拿來分析別人的聊天記錄嗎?
官方條款寫死了:只能處理你自己參與且合法取得的對話,涉及他人隱私要事先取得知情同意,禁止監控或分析未經授權的他人資訊。這條線畫在授權條款裡,越線的後果自負。
把聊天記錄當資料庫來查,這個概念在 ChatLab 上的兌現程度比我想像的高:資料層的本機宣稱有一顆看得到摸得到的 SQLite 背書,查詢引擎有唯讀防護,匯入匯出雙向完整,遙測與 AI 的邊界也在協議與文件裡寫得相對誠實。要付的成本是匯出環節的人工與平台限制,以及決定要不要開 AI 時對資料流向的一次清醒選擇。它撐得起「本機優先」這四個字,前提是你把那三個但書一起讀完。對平台資料自主這個主題有興趣的人,微信讀書匯出工具 WeReadScan 與把微信讀書搬進輕量桌面視窗的 Weixin Reader 記錄了同一個大問題的另外兩種解法,對照著看會更有味道。