TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Multiverse Computing 2026 年 11 月白皮書在雙 Xeon 6767P 伺服器上以 vLLM 純 CPU 服務 Whisper large-v3-turbo 與其壓縮版,128 人併發最高跑到 711 倍即時;對照 OpenAI 官方 VRAM 表與 whisper.cpp 模型檔實數,整理本地跑 Whisper 的記憶體需求與硬體分流判斷。
用 AI 摘要這篇文章:
語音轉文字模型 Whisper 在伺服器上「一定要 GPU」的假設,首度被一份完整的可核對帳本挑戰。量子公司起家的 Multiverse Computing 在 2026 年 11 月 12 日產出技術白皮書《Enterprise speech-to-text, running on CPUs》,11 月 18 日出現在 Hacker News:一台不插任何顯卡的 HPE 伺服器,靠兩顆 Intel Xeon 6767P 處理器服務 Whisper large-v3-turbo,128 人同時使用時原版跑出 356 倍即時轉錄,壓縮版更衝到 711 倍,等於一天最多消化約 17,000 小時錄音。這件事影響的族群很明確:自架轉錄服務、手上有一堆通錄音要批次處理的團隊,以及正在規劃下一波採購的基礎設施決策者;已經有 GPU 的團隊不必急著換路線,但可以把白皮書的量測方法借來重驗自己的部署。至於直接呼叫 OpenAI API 或雲端轉錄服務的用戶,帳單與品質都不因這份白皮書改變,可以照舊。
值得先講清楚的是這份帳本的份量。這是四頁的白皮書,把測試硬體、作業系統與核心版本、核心綁定方式、資料集與每一項量測指標都攤開:HPE ProLiant DL380 Gen12、兩顆 Xeon 6767P(每顆 64 個效能核心、合計 128 個實體核、256 個執行緒)、512 GiB 記憶體、Ubuntu 22.04,推論引擎用 vLLM 的 CPU 後端跑 BF16 精度。白皮書開宗明義寫出動機:客服中心等級的語音業務「今天通常跑在 GPU 上」,而 GPU 基礎設施的代價是龐大的機房足跡,於是他們問的問題是壓縮版模型能不能在純 CPU 的通用伺服器上撐住生產流量。一個耐人尋味的細節是,這份白皮書在 Hacker News 上只拿到 2 分,幾乎沒有被社群放大,也就是說這條「CPU 服務 ASR」的路線目前還很冷門,先讀完的人先拿到採購判斷的時間差。同時這條路不是白皮書獨門:vLLM 官方食譜在 2026 年 8 月 19 日就把 whisper-large-v3 的 Intel Xeon 6 CPU 服務標為已驗證(要求 vLLM 0.7.0 以上、BF16 精度)。換句話說,「用處理器服務 Whisper」已經從能不能跑的問題,變成能跑多快的問題。
白皮書的核心數字集中在 128 人同時使用的情境,音檔統一為約 30 秒的 LibriSpeech 樣本、每個併發水位各量滿 1,000 筆再平均:原版 large-v3-turbo 跑出 356.2 倍即時、每秒輸出 707.6 個 token、首字平均等 2.11 秒;換上 Multiverse 用自家壓縮工具 CompactifAI 縮過的 Slim 版,同樣的機器變成 711.2 倍即時、每秒 1,412.9 個 token、首字 1.10 秒。711 倍即時的意思是一秒鐘的運轉時間消化 711 秒的音檔,我自行換算全天運轉約 17,069 小時錄音,白皮書寫「約 17,000 小時」,數字對得起來。壓力拉到 192 人同時使用時兩邊的延遲都退到 3.45 秒與 6.68 秒,白皮書的判讀是 128 人附近就是這台機器的甜蜜點,與每節點 64 個實體核的上限一致;對延遲敏感的場景還有另一組可用數字:96 人同時使用時 Slim 版的延遲仍壓在 0.65 秒、原版 1.38 秒,都在一秒線附近或以內。
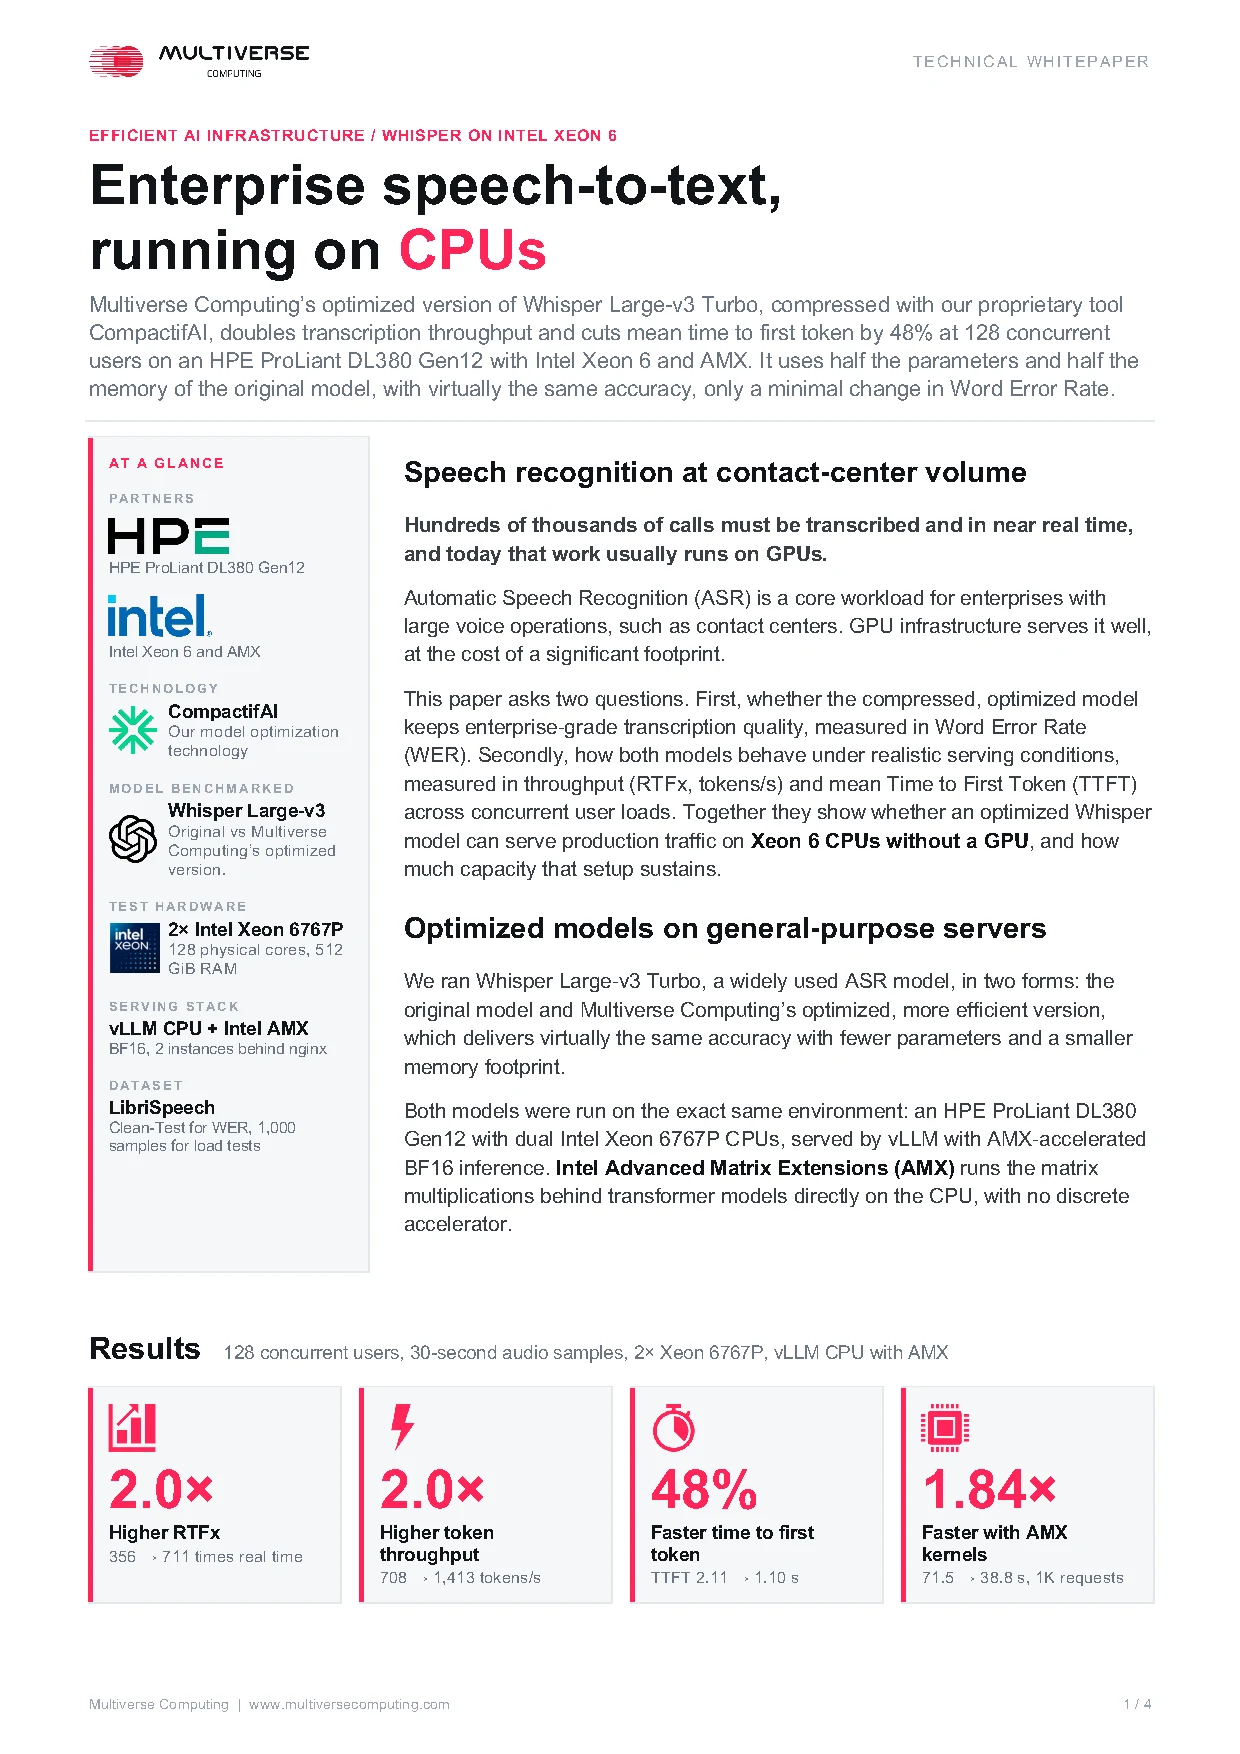
這台伺服器有兩個配置細節,比總吞吐更值得抄筆記。一個是綁核功夫:兩顆處理器各有 64 個實體核心,團隊把 vLLM 開成兩個實例、用 nginx 做輪詢分流,每個實例綁定在自己的 NUMA 節點上,執行緒只綁實體核、不碰超執行緒,避免兩條執行緒搶同一組運算單元;這是 CPU 推論與 GPU 推論最不一樣的地方,GPU 卡上的記憶體全卡共用,CPU 伺服器則要自己處理「記憶體掛在哪個插座旁」的問題,綁錯節點就多付一次跨節點存取的延遲。另一個是處理器本身的矩陣運算單元:Intel Xeon 6 效能核心內建 AMX(白皮書以 CPU flags 驗出 amx_bf16、amx_tile、amx_int8),可以把 transformer 推論裡最花時間的矩陣乘法交給專屬的區塊式硬體,白皮書稱開啟 AMX 加速核心後,同一批 1,000 筆請求從 71.5 秒縮到 38.8 秒,快 1.84 倍。精度選 BF16 也有出處:vLLM 的 CPU 文件明講,float16 在 torch CPU 支援不穩,建議直接指定 bfloat16。此外團隊把記憶體從 512 GiB 換成 128 GiB 重測,在測試的併發範圍內量不出差異,也就是說這套服務的記憶體需求遠低於帳面配備,錢該花在核心數與 AMX 上,記憶體照模型檔大小加預留就夠。
Slim 版的帳目也很透明:large-v3-turbo 原版約 808M 參數、FP16 檔案 1.51 GB;Slim 版約 394M 參數、0.73 GB,記憶體與儲存空間都省一半以上。要理解這個壓縮的起點,得先知道 turbo 本身就是一次壓縮:Hugging Face 模型卡明寫它是「修剪後的 large-v3」,解碼器層數從 32 層砍到 4 層再微調(2024 年 10 月問世、參數量約 809M),Multiverse 再用官方產品頁所稱的張量網路(tensor network)技術壓掉另一半,等於同一個模型血統連續瘦身兩次。品質在 LibriSpeech Clean 測試集上量測(約 2,600 筆英文樣本),錯字率(WER)從 2.14% 升到 2.75%,多了 0.61 個百分點。這組數字要誠實地讀:測試集是英文有聲書、朗讀清晰、無背景噪音,中文場景與會議室噪音的表現白皮書沒有量,不能自動延伸。
更有感的一點是,這個壓縮版今天拿不到。CompactifAI 與 Multiverse 在 Hugging Face 上目前都沒有公開的 Whisper Slim 權重可下載,官方產品頁把 CompactifAI 定位為商業服務(託管 API 或私有部署、聯絡銷售制),白皮書的角色比較接近這條商業路線的技術說明書。所以 711 倍這個數字目前是單一廠商自報、無法第三方重現的帳。開源世界裡最接近的替代品其實就在 whisper.cpp 的模型清單裡:large-v3-turbo 的 q5_0 量化版只有 547 MiB,比 Slim 的 0.73 GB 更小,large-v2 與 large-v3 也各有對應的 q5_0 版;量化是砍精度、張量網路是砍結構,兩條路省下的記憶體幅度相近,但量化後的錯字率變化沒有官方對照數字,要自己用音檔量。
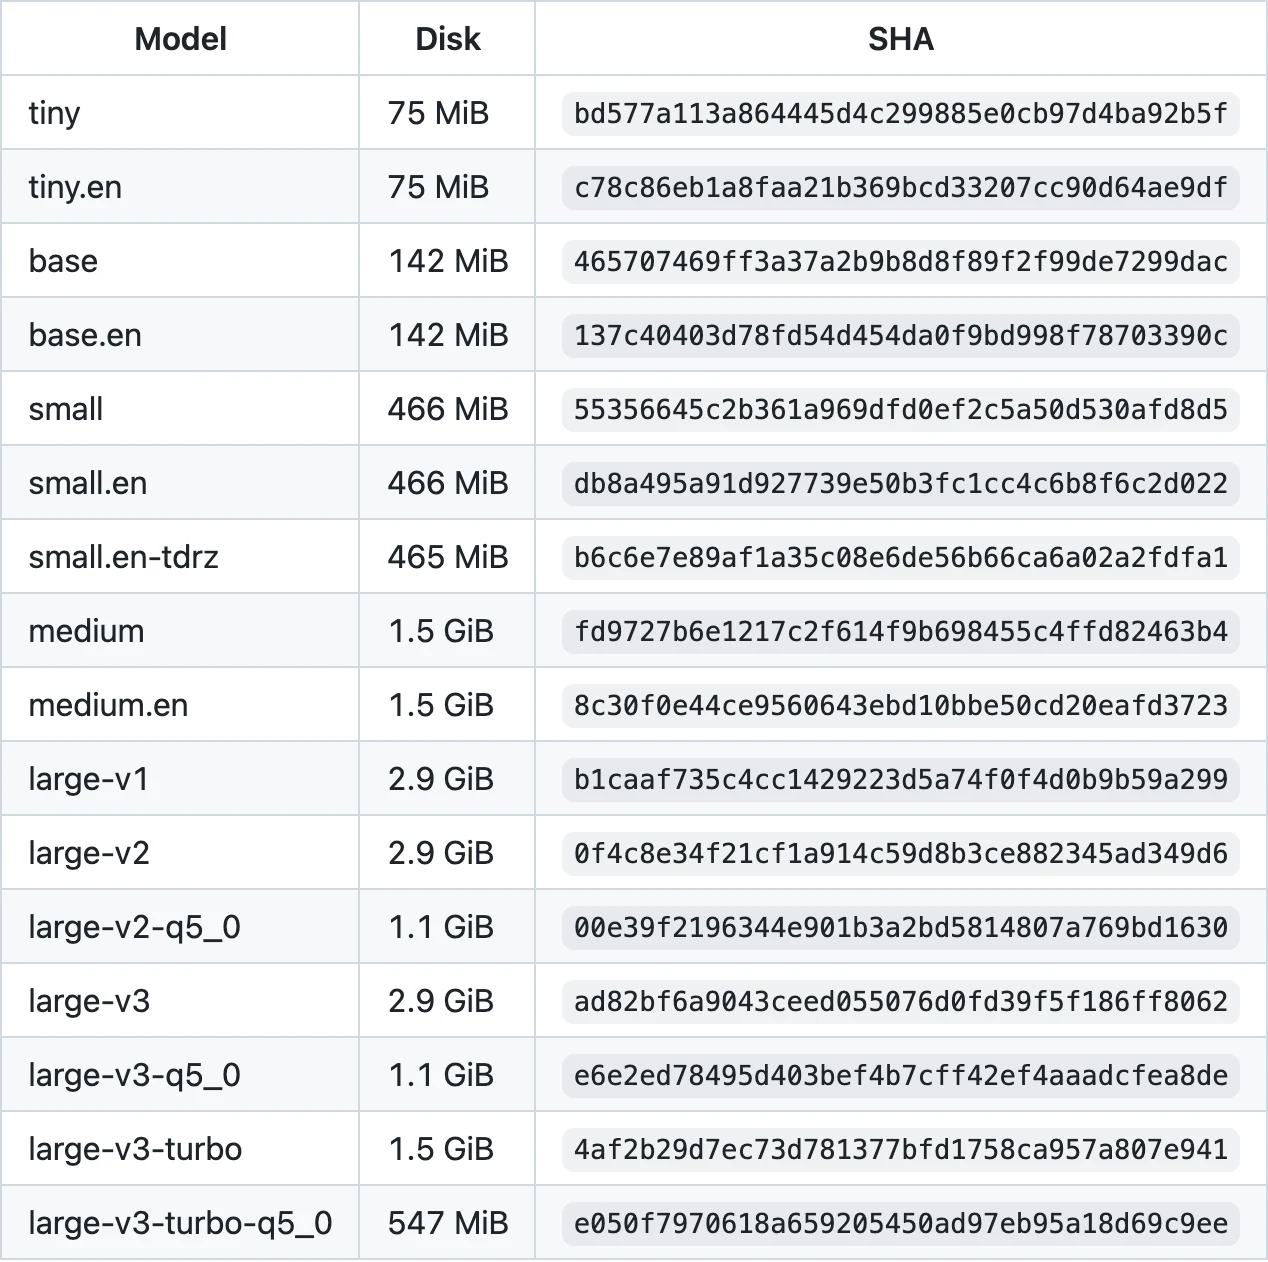
把視角從機房拉回自己的書桌,Whisper 的硬體需求其實有官方階梯可以查。OpenAI 在 openai/whisper 的 README 給出顯示卡記憶體需求表:tiny 與 base 約 1 GB、small 約 2 GB、medium 約 5 GB、large 約 10 GB、large-v3-turbo 約 6 GB(速度基準為 A100 上的相對值)。whisper.cpp 的模型清單則給出檔案實大小:base 142 MiB、small 466 MiB、medium 與 large-v3-turbo 各 1.5 GiB、large-v3 完整版 2.9 GiB。兩張表對起來看,結論很樸素:模型檔多大,機器的記憶體地板就多高,而 turbo 是其中的甜點位置,參數 809M、檔案 1.5 GiB,速度卻標到約 8 倍於 large。
| 模型 | 參數量 | 檔案大小(whisper.cpp) | 顯示卡記憶體(OpenAI 表) |
|---|---|---|---|
| tiny | 39M | 75 MiB | 約 1 GB |
| base | 74M | 142 MiB | 約 1 GB |
| small | 244M | 466 MiB | 約 2 GB |
| medium | 769M | 1.5 GiB | 約 5 GB |
| large-v3 | 1550M | 2.9 GiB | 約 10 GB |
| large-v3-turbo | 809M | 1.5 GiB | 約 6 GB |
| large-v3-turbo q5_0 | 809M | 547 MiB | 官方表未列 |
細看會發現一個值得記住的落差:turbo 的模型檔 1.5 GiB,官方 VRAM 表卻寫約 6 GB。兩邊都沒算錯,只是量的位置不同:官方表量的是 PyTorch 官方實作跑起來的整體需求;whisper.cpp 的數字則是 GGML 格式檔案本身(多為 F16 版,另有更小的 q5_0 量化版),載入後的佔用貼著檔案大小走。同一張顯卡,換執行工具常常就是換一個記憶體等級,這也是為什麼挑模型前要先問「用哪一套工具跑」。選模型還有兩個小地方值得留意:OpenAI 在 README 列出 tiny 到 medium 都有英文專用的 .en 版,並稱差異在 tiny、base 最明顯;而多語言版從 tiny 到 large 都涵蓋中文,要的是那一欄 VRAM 與檔案大小對得上的機器。
三種硬體路線在這張階梯上各有走法。走 CPU 的話,16 GB 記憶體的一般桌機與筆電放得下量化後的 turbo,讀檔後預留系統與其他程式的空間仍夠,只是速度要看核心數與記憶體頻寬,一小時錄音可能要等好幾倍時長,批次量大時要有耐心;whisper.cpp 的 CPU 版本到處能編,Intel 平台另有 OpenVINO 後端可選。走 Apple Silicon 的 Mac,whisper.cpp 官方文件標明推論全程走 Metal GPU,編碼器還能另走 Core ML 上神經引擎、官方稱比純 CPU 快超過 3 倍,社群的 ANEForge 路線在 tiny 到 medium 之間再快約 2 倍,統一記憶體架構直接吃模型檔大小,這與我們先前整理過的 Mac 跑本地大模型記憶體帳是同一套邏輯(見〈Mac 64GB vs 128GB 跑本地大模型的記憶體帳〉)。走 NVIDIA 顯卡就照 OpenAI 表對號入座:4 GB 卡舒服跑 small、6 GB 卡正是 turbo 的門檻、24 GB 卡可以全文跑 large,還能兼職跑本地大模型(見〈16GB 顯卡跑本地大模型的記憶體帳〉)。工具鏈方面,whisper.cpp 對 NVIDIA 卡走 cuBLAS 與自製 CUDA 核心,Python 原生版則直接吃 PyTorch 的 CUDA 支援,兩條路都很成熟,裝好驅動就能用。
白皮書對個人用戶最大的價值,是把「要不要 GPU」這個問題拆成看工作負載的三個分流。單人聽寫、逐字稿偶爾轉一小時錄音:不需要為此買顯卡,現有機器先跑 small 或量化 turbo,速度不滿意再考慮升級,離線聽寫工具的選擇可參考〈CapsWriter Offline 離線聽寫〉與〈ASRTools 語音轉文字〉。每天都有幾十小時錄音要批次消化:多核心 CPU 與中階顯卡都合理,但 AMX 等級的 Xeon 6 或支援矩陣加速的伺服器處理器,採購時值得列進比價清單,記憶體則照模型檔大小加預留即可,不需要往上堆;也要對吞吐有合理的預期,白皮書那台伺服器有 128 個實體核,多數個人電腦與筆電的核數多半不到它的八分之一,把 711 倍按核數規模折算再保守一點看,才是自己機器的合理想像。要開放多人同時使用的轉錄服務:白皮書給的 NUMA 綁核、nginx 分流、BF16 CPU 後端是一套可以直接照抄的起手式,vLLM 的部署細節與記憶體調度,我們在〈vLLM 24GB 顯卡部署〉整理過同一套引擎的 GPU 側帳本。
中文用戶在這裡要多留意。Whisper 的多語言版涵蓋中文,但這份白皮書的品質數字只量了英文有聲書,國語與台灣口音的錯字率、繁簡用詞的輸出傾向,都得用自己的音檔實測再下結論;OpenAI 官方也提醒 turbo 不支援翻譯任務,要翻譯語音就換 medium 或 large。這也是為什麼「先拿代表性音檔測一輪」永遠排在「看別人的實測數字下單」前面。
自己測一輪的做法可以很省事:挑一段十分鐘、內容貼近實際用途的錄音(含專有名詞、數字、多人對話更好),記下工具與版本、模型名稱與量化格式,量「模型載入時間」與「轉錄總時間」兩個數字,再用音檔長度除以處理時間算出倍率。十分鐘音檔五分鐘轉完就是 2 倍即時,白皮書的 711 倍、356 倍也是同一個單位,只是量測環境換成 128 人併發的伺服器。測完順便抽查人名、數字與中英切換的位置,速度之外,這些位置最容易暴露品質差異;只看倍率下單,往往就是品質出問題的開始。
這份帳本有三個地方還沒關上。Slim 壓縮模型未公開,711 倍是原廠自報數字,第三方重現要等 Multiverse 釋出權重,或有人用原版 turbo 加開源量化、在同級 Xeon 6 上重跑 128 併發的量測;在那天之前,356 倍(原版 turbo 的數字)才是目前能動手驗證的那一半。同時要提醒:白皮書從頭到尾沒有跑 GPU 對照組,它證明的是「純 CPU 撐得住」,沒有證明「CPU 比 GPU 便宜」或「CPU 比 GPU 快」,總擁有成本的比較要自己拿電價、機箱與 GPU 市價另算。中文與噪音場景的品質未量,英文有聲書的 0.61 個百分點代價不能直接搬到中文會議,中文用戶的判斷順序應該是先量準確率、再比速度。這套數字還綁定 2026 年 11 月的 vLLM CPU 後端與 Xeon 6 平台,vLLM 的版本演進很快(前一版才把 KV 快取預設值翻頁),whisper.cpp 穩定版停在 10 月初的 v1.9.5、其後只有每日建置持續推進,之後的版本與新處理器出來,數字會位移;動手採購前,以 vLLM 官方文件與 whisper.cpp 倉庫的現況為準。白皮書本身值得抓下來讀,四頁的篇幅把 CPU 推論該注意的綁核、快取與精度細節示範了一遍,就算不買 Xeon,也是一份很乾淨的量測方法範本。