TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

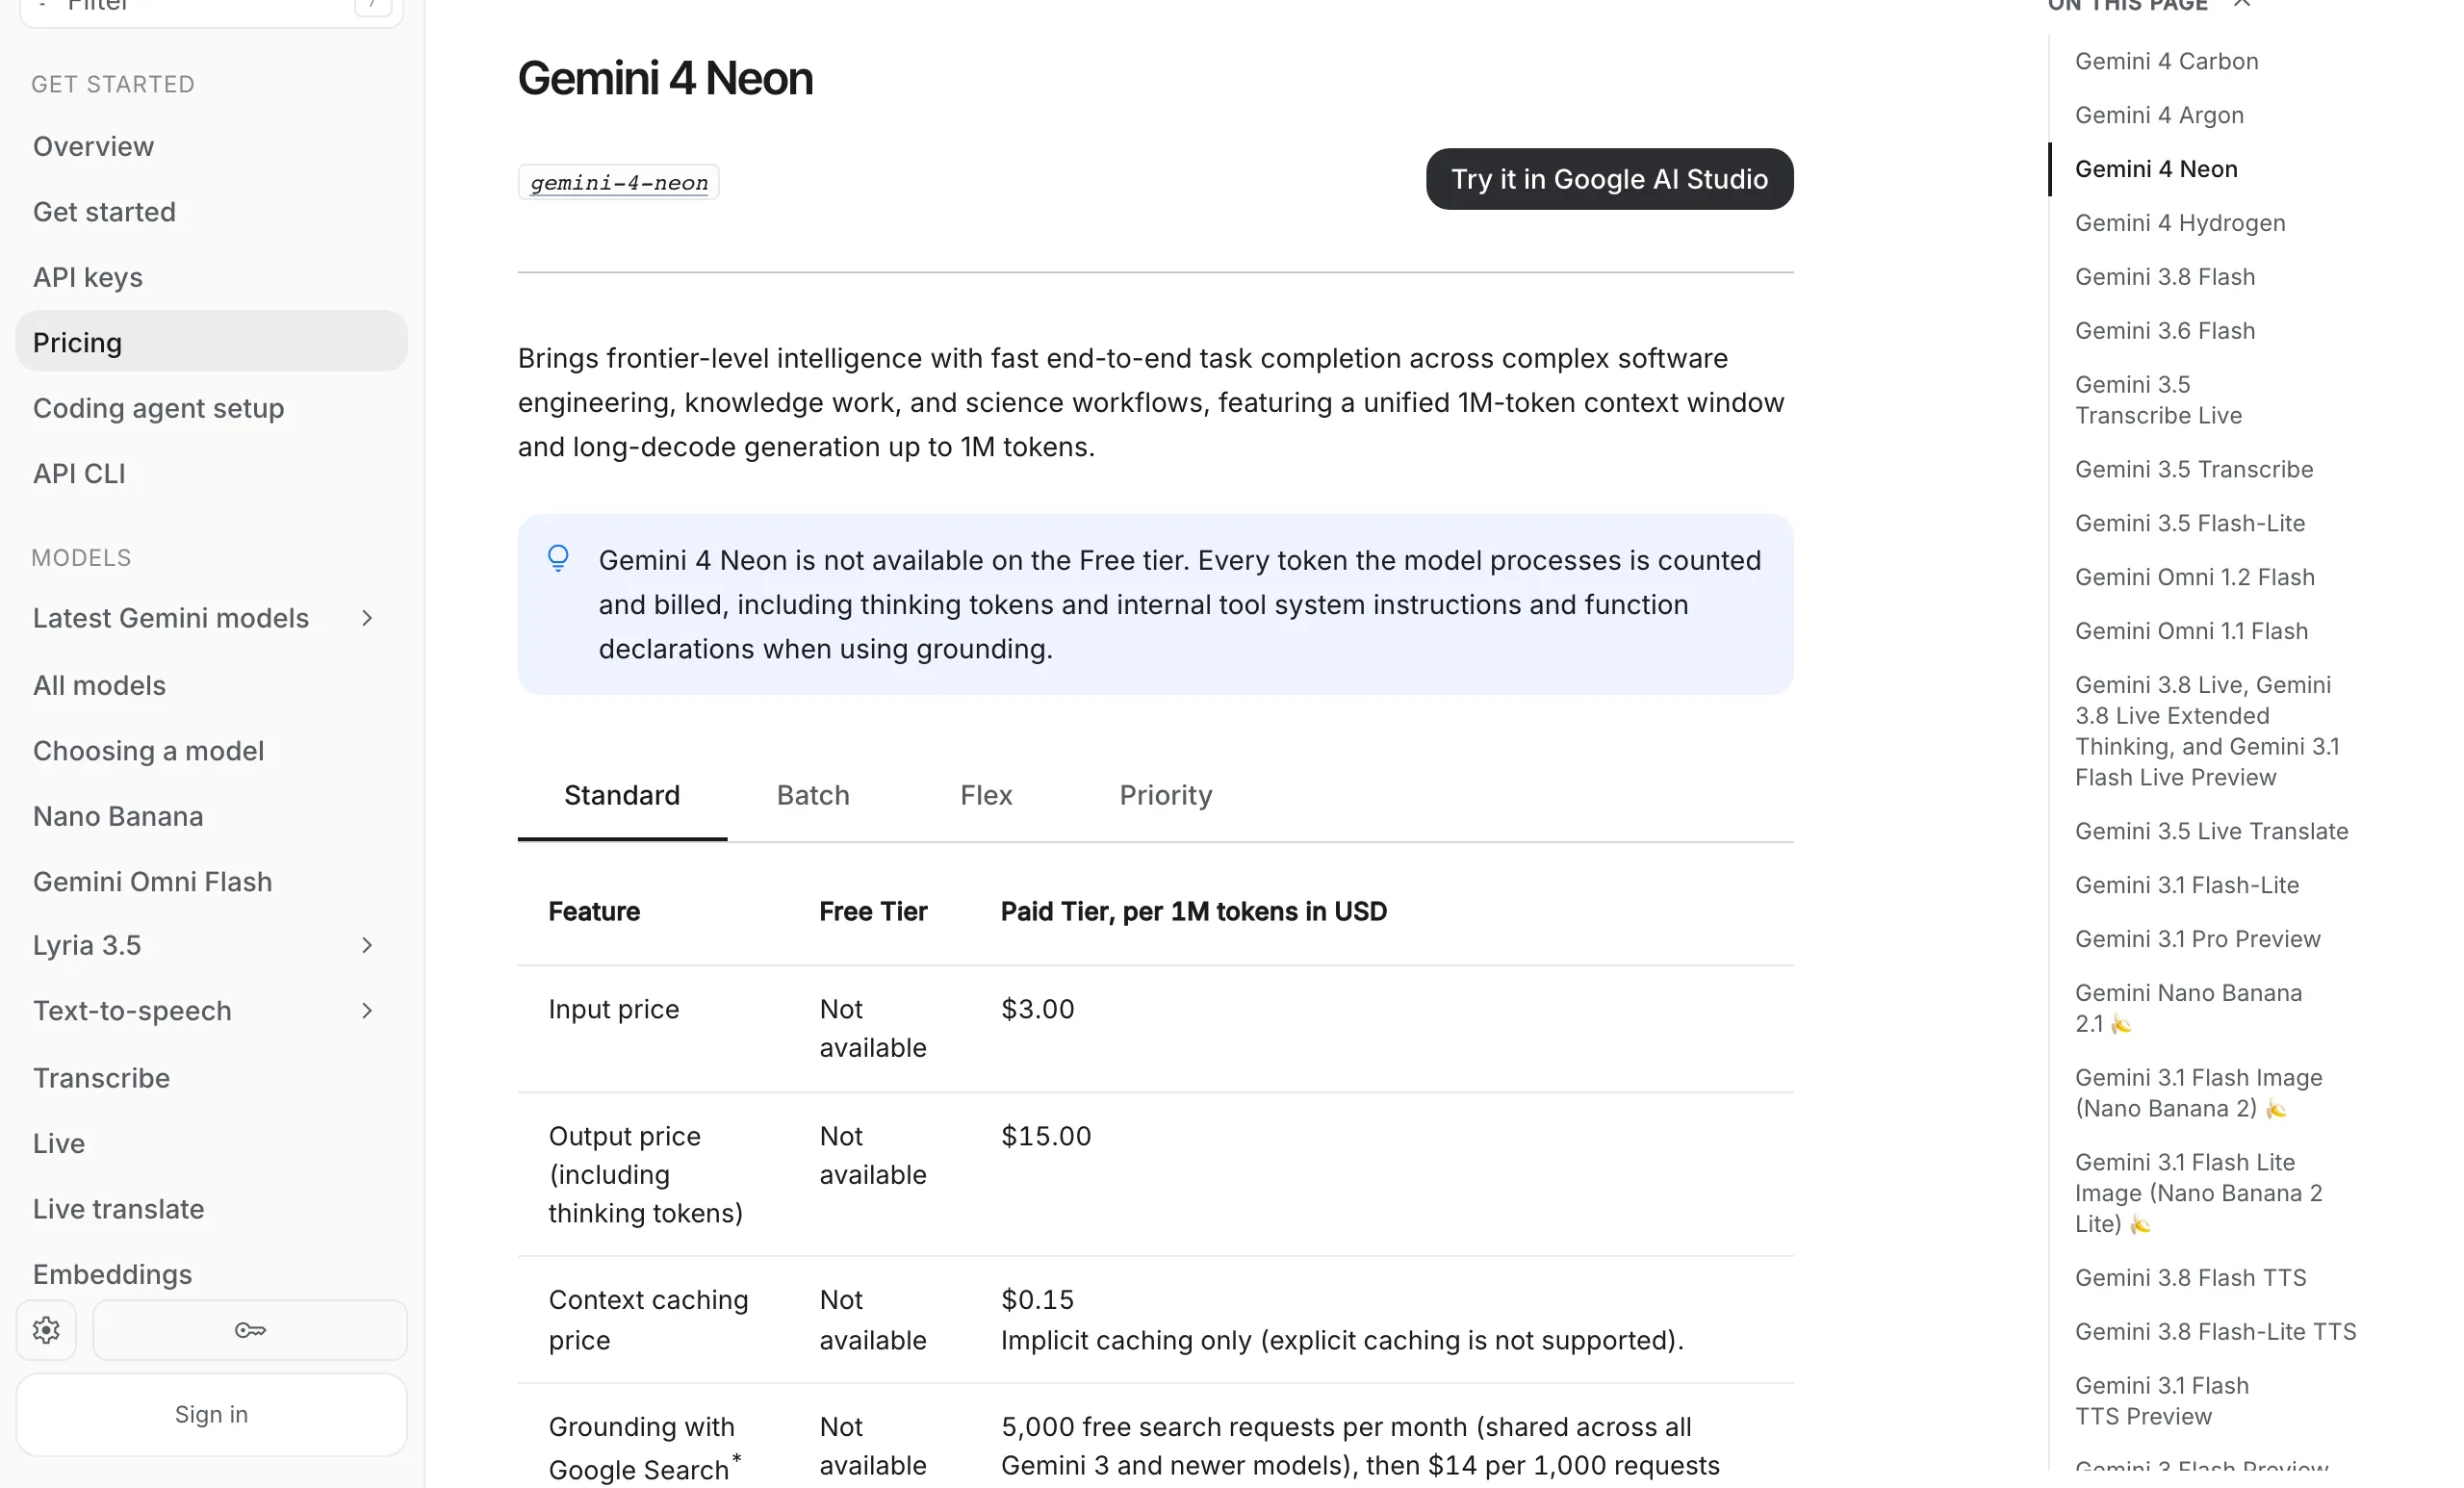
Google 於 11 月 18 日發布 Gemini 4 Neon,定位在 Carbon 與 Hydrogen 之間,API 牌價每百萬 token 輸入 3 美元、輸出 15 美元。官方資料顯示同一個模型在 mini-SWE 框架與 Antigravity 的程式修復成績相差三倍,選型單位已經從模型變成模型、入口與框架的組合,牌價、思考等級計費規則與四個開放入口是必看的三個面。
用 AI 摘要這篇文章:
Google 在 2026 年 11 月 18 日晚間 9 點(UTC,台北時間 19 日清晨 5 點)於官方部落格發表 Gemini 4 Neon,文章同樣由 Google DeepMind 資深副總裁、Google 首席 AI 架構師 Koray Kavukcuoglu 掛名。官方給它的位置很明確:夾在Gemini 4 Carbon與 Hydrogen 之間,負責複雜軟體工程、知識工作與科學任務,走的是前沿推理能力加上較快完成整段工作的路線。牌價每百萬 token 輸入 3 美元、輸出 15 美元,付費 API、Gemini 商務版、Antigravity 與 Gemini 應用程式的訂閱用戶當天起陸續可用。
這次公告裡最值得停下來看的數字,反倒不在模型本身。在程式修復基準 SWE-sweep 上,同一個 Neon 在精簡的 mini-SWE 代理框架跑出 12.8%,放進 Google Antigravity 的完整環境變成 39.0%,官方自己用「翻了三倍以上」形容,並把差距歸給框架解鎖的能力。換句話說,開發者透過 API 單買模型,與付費訂閱 Antigravity 拿到的成績,是同一個模型的兩種處境。選型決策的單位,從「挑哪個模型」變成「模型加入口加框架」的組合,這篇以 11 月 18 日發布的官方公告,加上 API 定價頁與模型文件的現行內容為準,逐項拆開看。
Google 給 Gemini 4 家族的分工,在公告與開發者文件裡說得一致:Carbon 負責最難的架構、除錯、科學與資安問題,走長程任務;Hydrogen 是日常 coding 與代理工作的預設款;Neon 補中間那一段,需要前沿推理品質、但工作頻率高、也希望快點看到成果的場景。官方一句話定位是「在深度與效率之間取得平衡」,模型代號 gemini-4-neon,文件標示為穩定版本,最近更新時間為 2026 年 11 月。
第三方評測機構 Artificial Analysis 的榜單數字也能對上:Neon 在最高思考等級 xhigh 下的 Intelligence Index 為 61 分,Google 引用時給的名次是總排第三、領先同等級模型,前面是 Claude Fable 5.2 與 GPT-6.2 Astra,兩者在榜上的最高成績分別為 65 分與 62 分。有個細節值得知道:榜單把同一模型的不同思考設定分列條目,61 分之上共有五個 65 或 62 分的條目,「總排第三」是以模型最佳成績合併計算的口徑,引用名次時要把這個條件一起講。該頁獨立標記的發布日期 2026 年 11 月 18 日與 1 百萬 token 上下文視窗,也與官方文件一致。
知識工作與科學推理這兩條線,官方給的第三方與專業基準成績相當密集:Vals Index 排第二(70.9%)、法律研究基準 Legal Research Bench 與稅務代理基準 Tax Agent Bench 都是第一,讀專業圖表的 Chartography 拿到 73.5%,科學與數學推理方面 Terminal-Bench Science 70.5%、RiemannBench 84.0%、HLE-Diamond 71.3% 都是該類最佳。
程式這條線另有 Artificial Analysis Coding Agent Index 總排第一(58.6 分)、Terminal-Bench 4.1 的 65.2%,以及預設 high 等級下 FrontierCode 2.0 的 46.2%。這些數字的支持面足夠廣,但每項都綁著指定的思考等級與評測條件,公告沒有列出全幅設定,引用時保留條件比引用名次重要。
對照家族牌價(每百萬 token、標準付費層):Hydrogen 輸入 1.5 美元、輸出 7.5 美元,另有免費層;Neon 輸入 3 美元、輸出 15 美元,僅付費層;Carbon 目前輸入 2 美元、輸出 10 美元,但這是推出期價格,12 月 1 日起調為輸入 4 美元、輸出 20 美元。也就是說,11 月底之前,Neon 的牌價其實比 Carbon 貴五成;12 月起兩者對調,Neon 反而成為家族裡價格居中的選項。任何「哪個划算」的比較,都必須標上時間基準,這一點後面再展開。
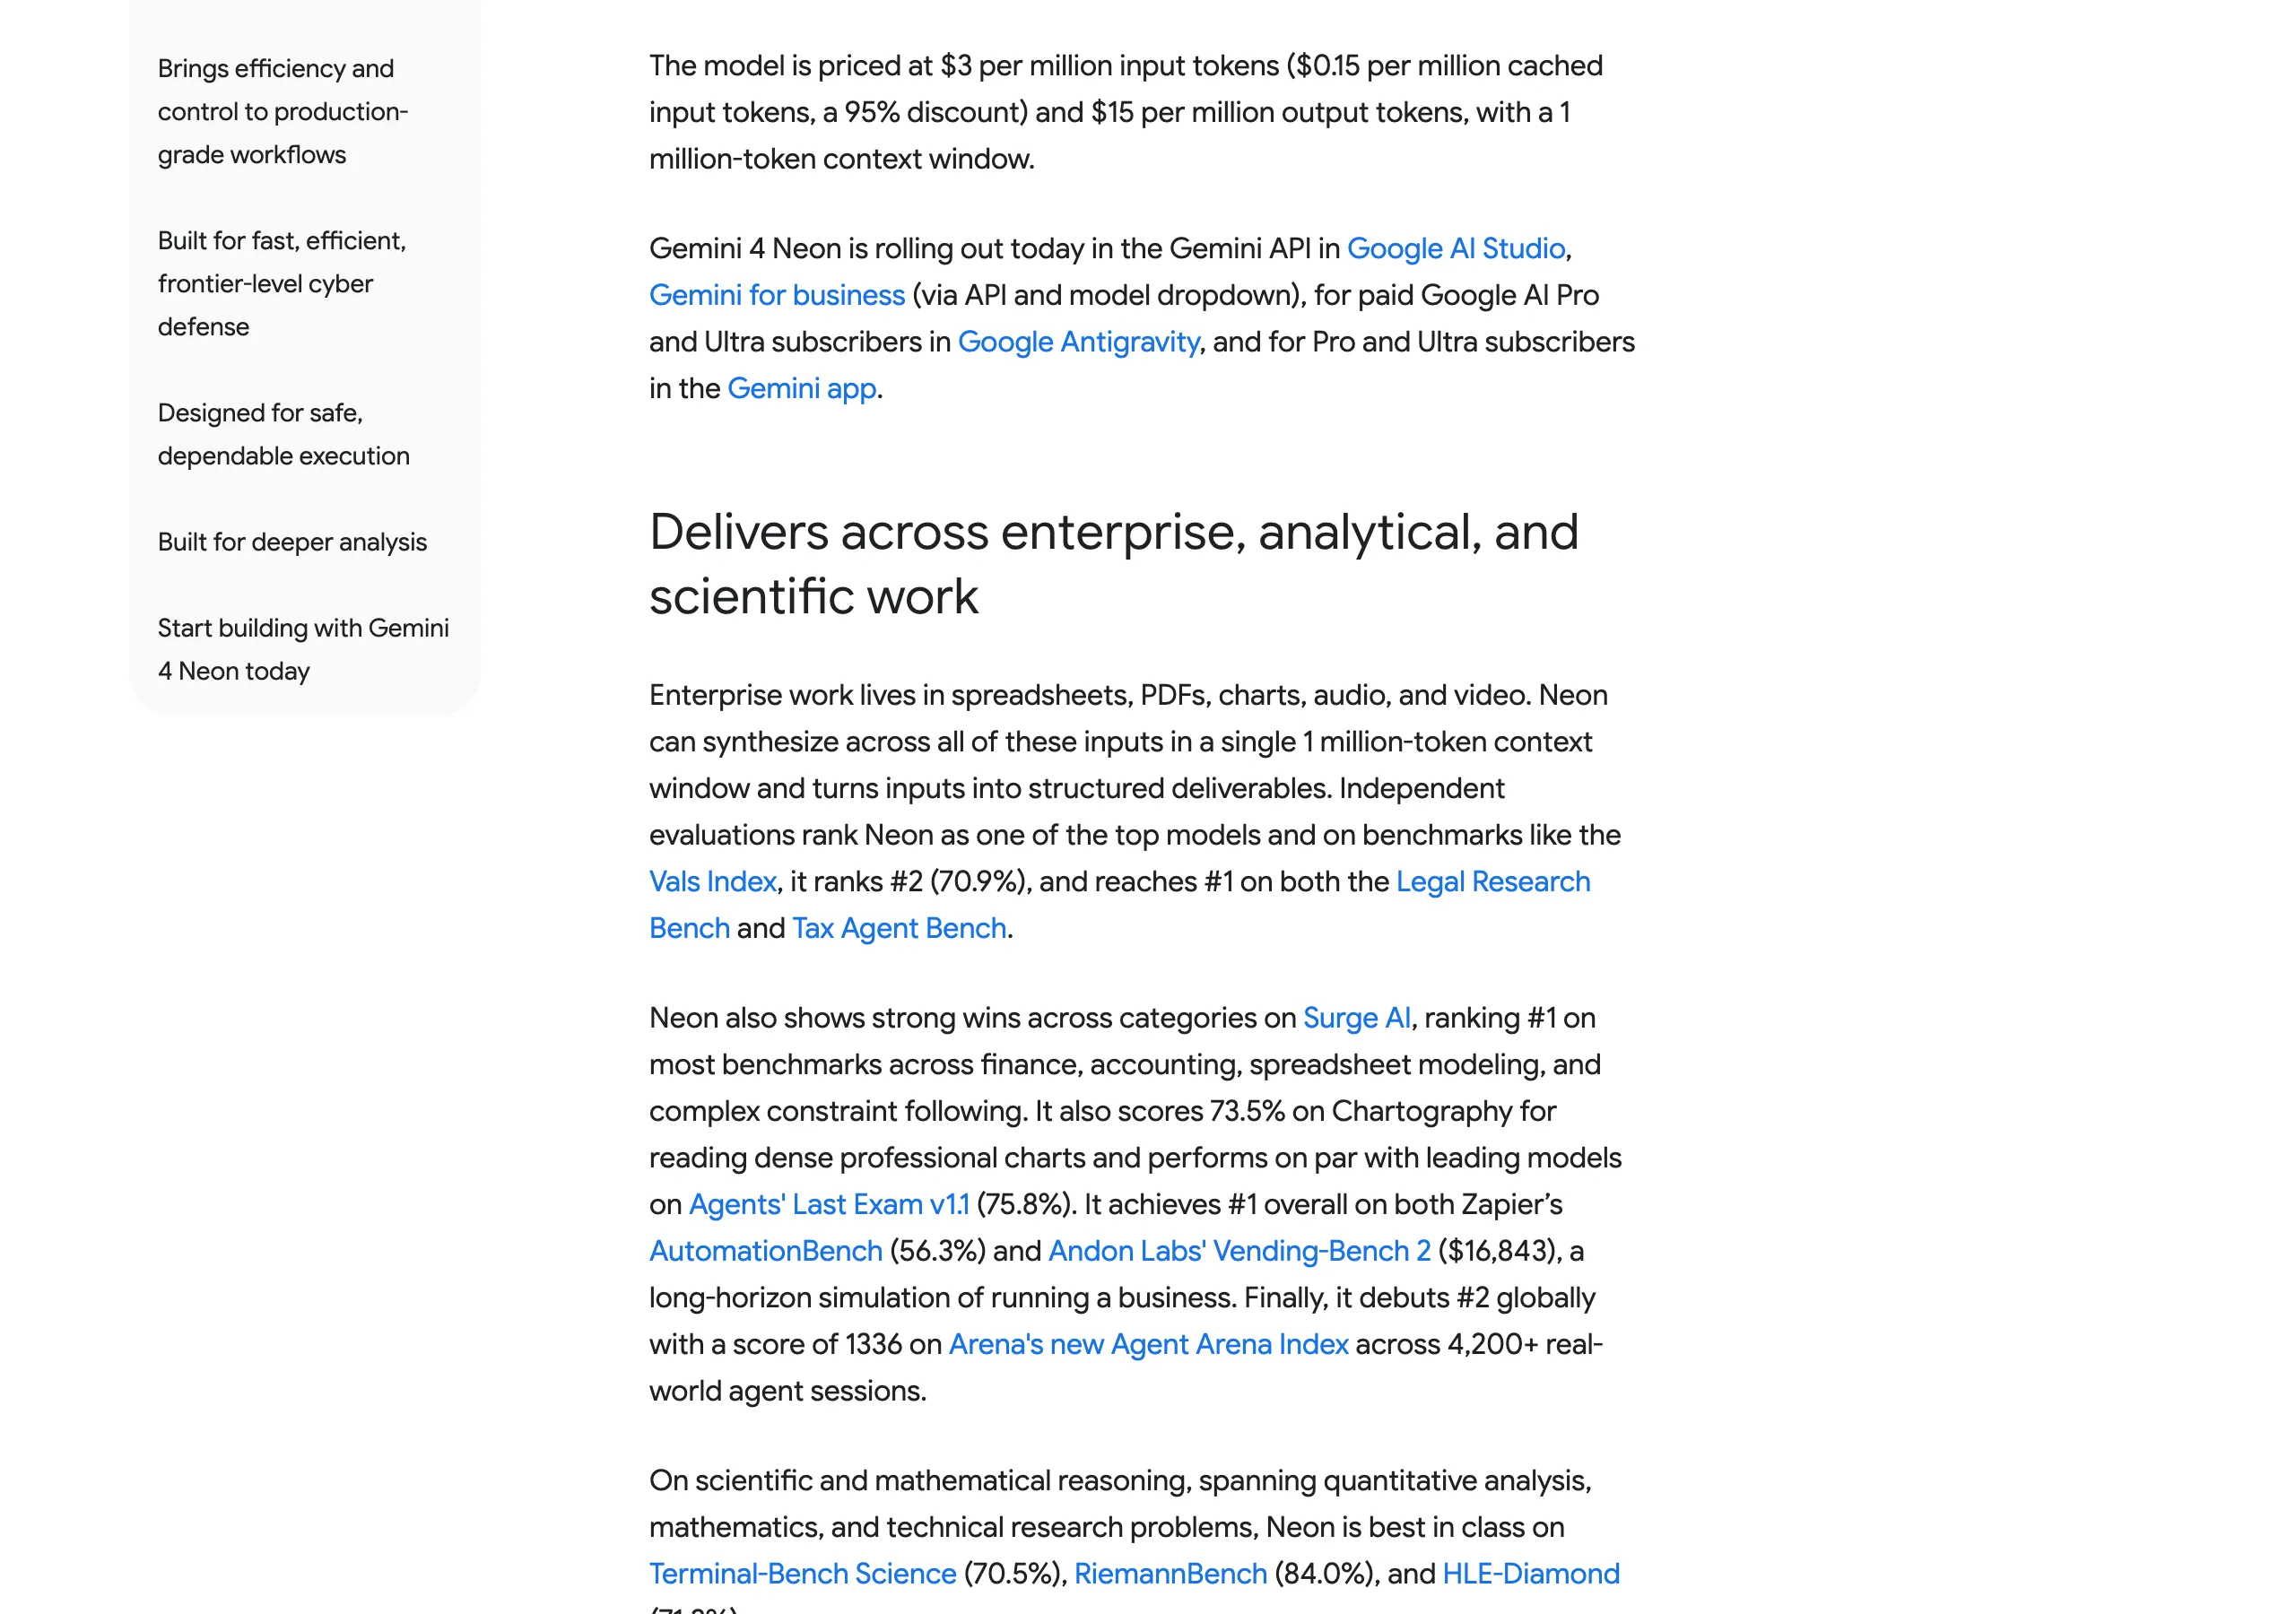
SWE-sweep 那組數字值得單獨看。公告原文寫得很清楚:Neon 在 mini-SWE 框架上以 12.8% 領先,放到 Google Antigravity 裡「翻了三倍以上」到 39.0%,是該基準目前最好的成績,官方並註明這展示的是「Antigravity 框架解鎖了什麼」。兩邊跑的是同一個模型,一邊是 mini-SWE 這套精簡的代理框架,另一邊是 Google 的完整代理開發環境 Antigravity,差距全部來自外圍安排。
官方把外圍的差異歸納成幾件事:Neon 減少重複讀檔、邊做邊共享進度、在長工作階段可靠地處理上下文壓縮,並且可以在 Antigravity 裡扮演總指揮(Orchestrator),調度平行的 Hydrogen 子代理分工。這些聽起來是工程細節,對成本與結果的影響卻是數量級的:代理框架決定模型看得到哪些資訊、重試幾次、上下文何時被壓縮重送,每一項都直接反映在 token 用量與最終帳單上。
對台灣的開發團隊,這組數字的實際含義是:經過 API 直接呼叫 gemini-4-neon,拿到的是 12.8% 那一側的能力;39.0% 的成績需要 Google AI Pro 或 Ultra 訂閱,在 Antigravity 的框架裡才拿得到。自建代理流程的團隊等於要自己補齊讀檔策略、進度保存與上下文管理,這些正是兩個數字之間的差距來源。先前 Argon 世代那個用 Blender 蓋三維教堂的官方示範,可以搭配這篇逐幀拆解看上一個世代在類似展示裡實際交出了什麼。
同一段公告裡的四個展示也全部發生在 Antigravity 環境:用 /swarm 指揮 Blender MCP 蓋出以化學元素意象呈現模型家族的三維實驗桌、從零寫出 10,200 行自訂著色器的滑雪模擬器、重建 Alan Turing 1936 年在劍橋國王學院的書房、把單張照片變成十萬格試算表並用超過 50 萬條即時公式做邊緣偵測與三維深度。這些是能力展示,證明框架加模型這套組合的上限,而這套組合本身是訂閱產品,不是 API 單價裡自動包含的部分。
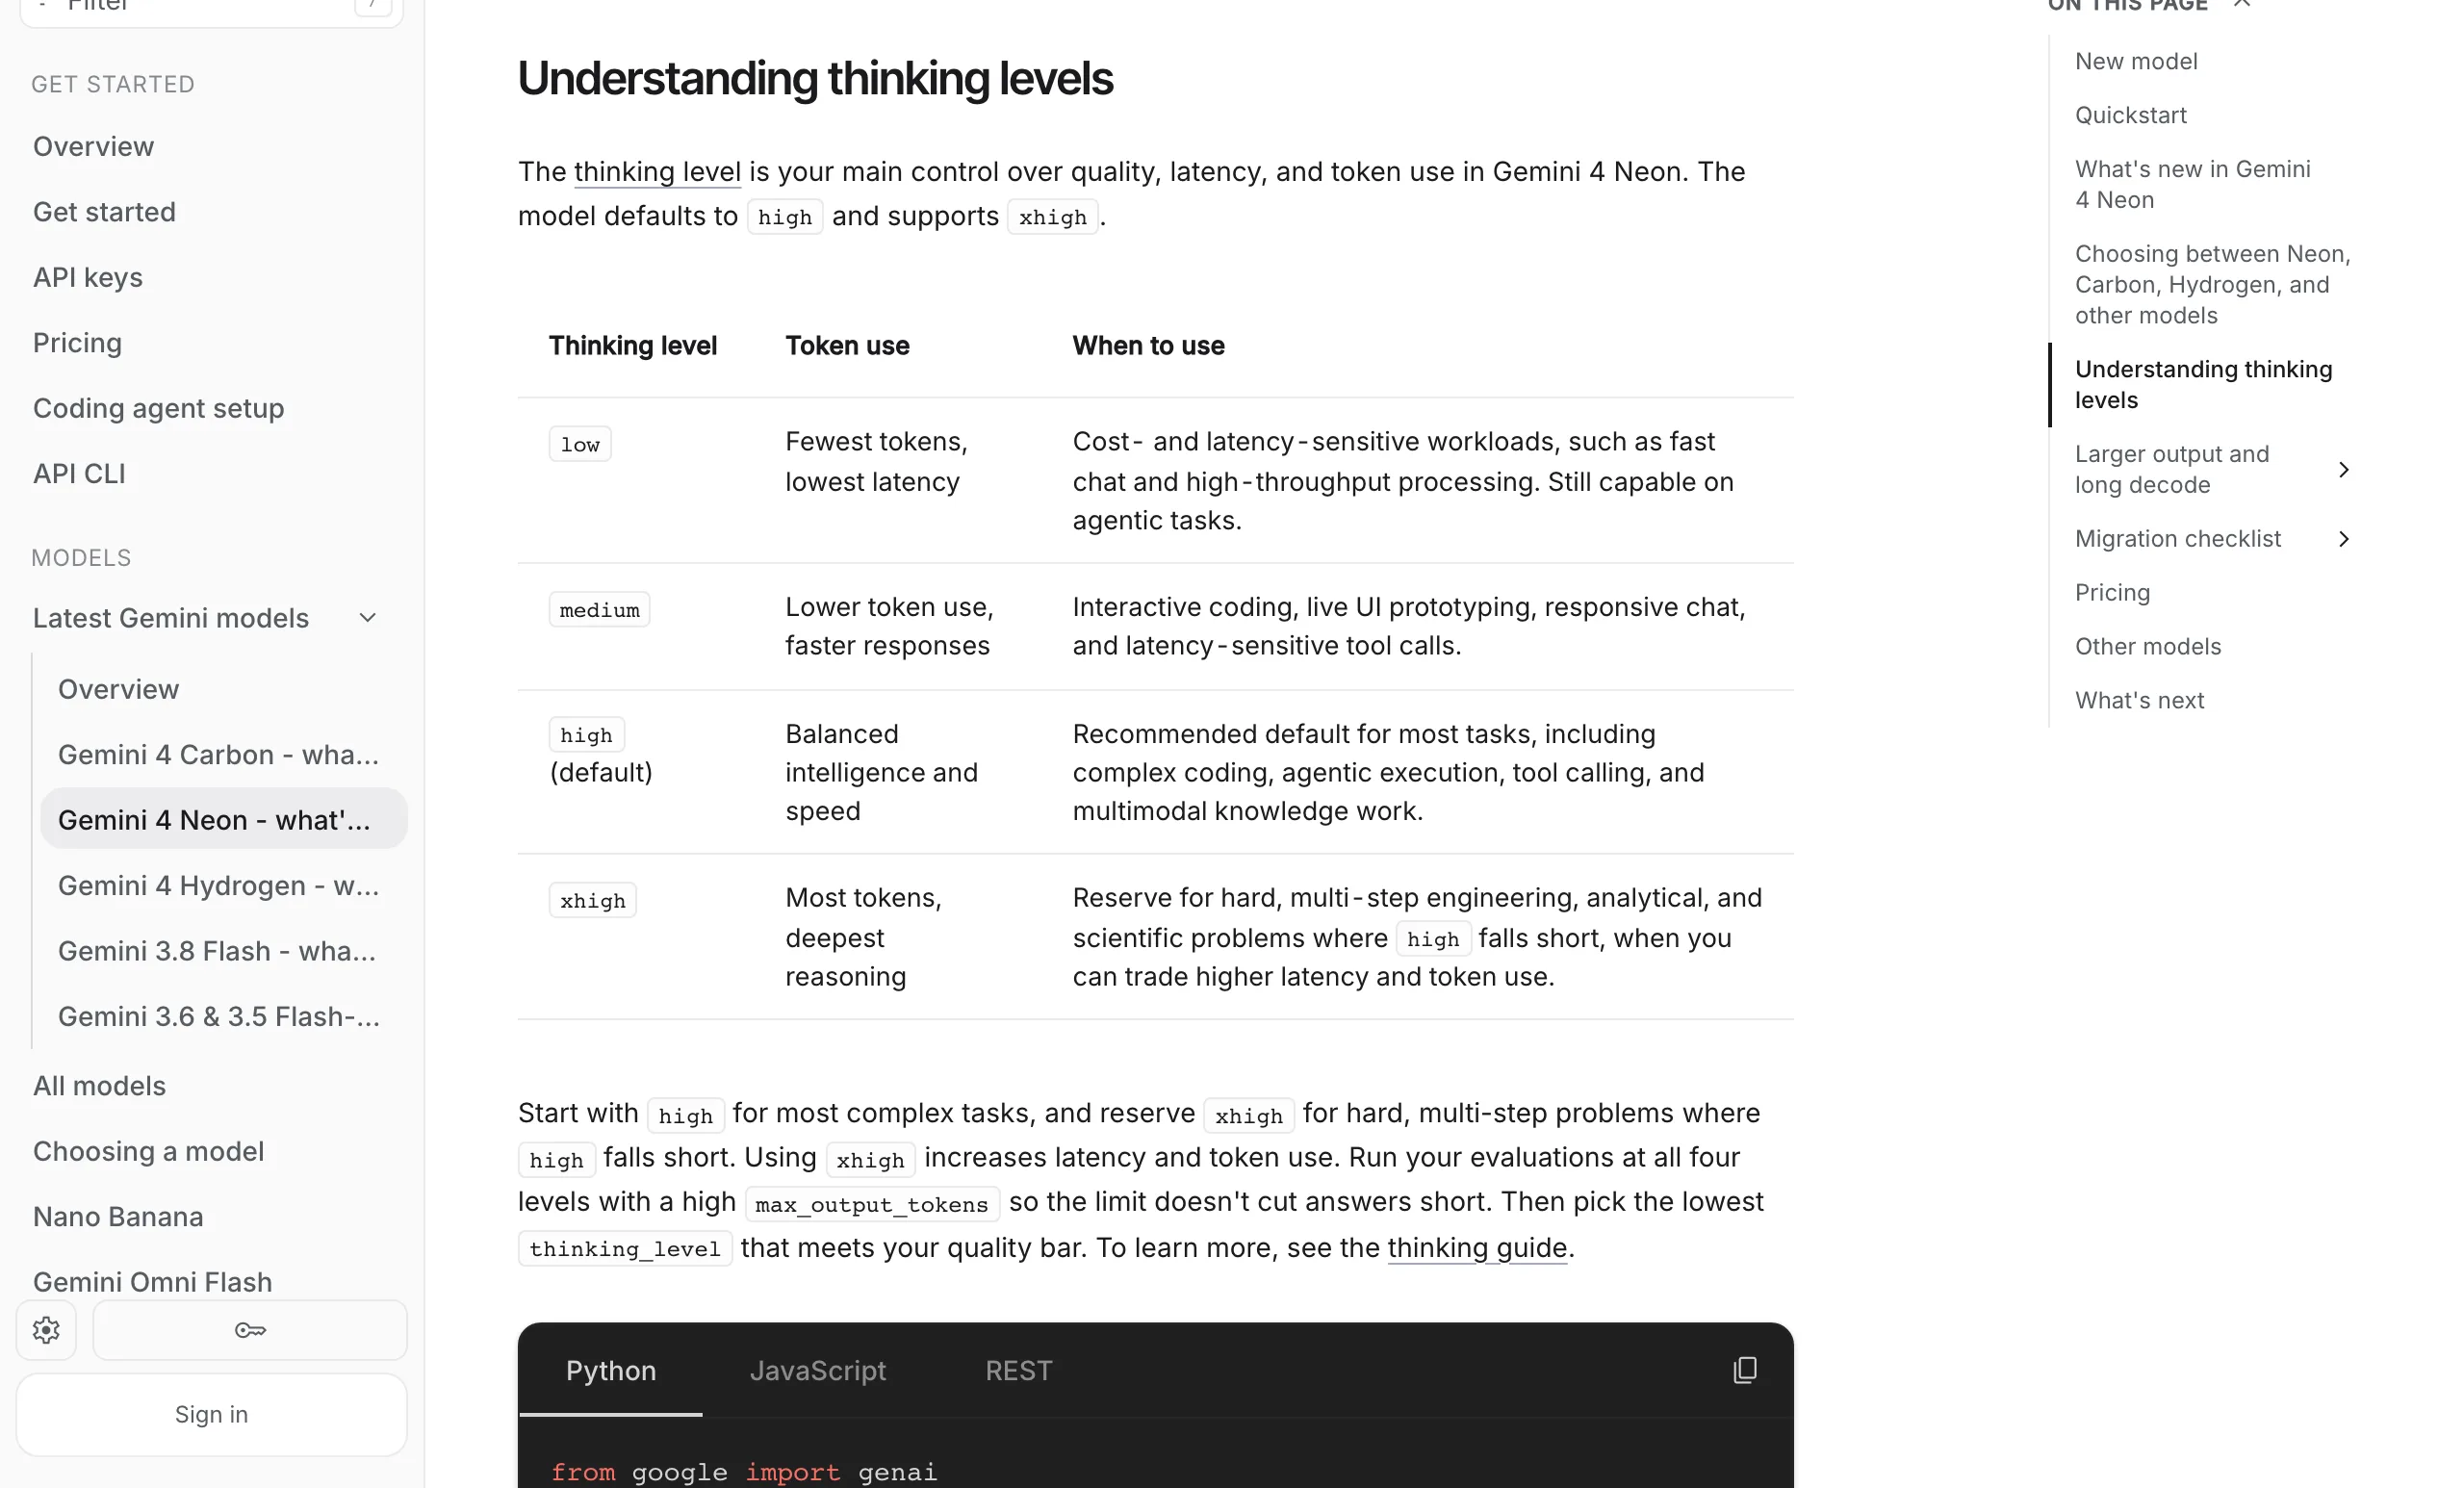
Neon 的計費結構,比單看牌價複雜一段。思考等級直接改變用量:模型支援 low、medium、high(預設)與 xhigh 四檔,官方建議多數任務直接用預設的 high,xhigh 留給 high 跑不動的最難多步驟問題,並提醒換檔會同時改變延遲與用量。遷移文件還給了一個實用的評測建議:在四個等級都跑一輪自己的測試,並把 max_output_tokens 開高避免答案被截斷,然後選一個能過品質門檻的最低等級,把等級當成可調的成本旋鈕而不是榮譽的象徵。
計費口徑同樣要細看:API 文件明文寫著,模型處理的每個 token 都計費,包含思考 token,甚至在 grounding 功能裡由系統注入的工具指示與函式宣告也一併計入。
上下文額度方面,輸入、思考與輸出共用同一個 1,048,576 token 上限,同步輸出最多 65,536 token,要更長的輸出得走長解碼(背景執行或客戶端接續)拉到百萬級。
快取的規則也有但書:輸入牌價 3 美元,快取命中降到 0.15 美元,等於 95% 折扣,但只支援隱含快取,明示快取不支援,也就是哪些內容能吃到折扣由服務端決定,不是開發者指定。批次與彈性推論的價格是標準牌價的一半(輸入 1.5 美元、輸出 7.5 美元),優先推論則是 1.8 倍(輸入 5.4 美元、輸出 27 美元),對能接受排隊的離線工作,半價是實實在在的選項。
| 計費層 | 輸入(每百萬 token) | 輸出(每百萬 token) | 快取輸入 |
|---|---|---|---|
| 標準 | 3 美元 | 15 美元 | 0.15 美元 |
| 批次/彈性 | 1.5 美元 | 7.5 美元 | 0.075 美元 |
| 優先 | 5.4 美元 | 27 美元 | 0.27 美元 |
| Gemini 4 家族 | 定位 | 輸入/輸出牌價 | 免費層 |
|---|---|---|---|
| Hydrogen | 日常 coding 與代理工作預設 | 1.5/7.5 美元 | 有 |
| Neon | 前沿推理加快速完成 | 3/15 美元 | 無 |
| Carbon | 最難的長程任務 | 11 月 30 日前 2/10 美元,12 月 1 日起 4/20 美元 | 無 |
官方同時主張成本效率:在預設 high 等級下,Neon 每任務成本比 Carbon 低 32%;在 Vals 與 Agent Arena 兩個第三方指標的前沿上,比頂級競品低約五到八成;開到 xhigh 也仍比競品最高檔便宜 36% 以上。要注意這些是 Google 自家口徑的比較,計算細節未公開,而且公告發布時 Carbon 適用的還是促銷牌價。把官方的「每任務成本」與牌價表的「每 token 單價」放在一起看,牌價貴五成、任務成本反而低三成,兩者並不矛盾,中間的差額就是思考與重試次數的節省,但實際在自己的工作負載上能省多少,仍要用自己的用量資料驗證。
Neon 的開放面分成四個入口,條件各不相同。開發者走 Gemini API 的付費層,在 Google AI Studio 與 Android Studio 使用,兩種呼叫介面(generateContent 與新的 Interactions API)都支援,訂閱 Pro 或 Ultra 的用戶也能在 AI Studio 裡直接試用;企業用戶走 Gemini 商務版,可從 API 或模型選單選用;已經付費訂閱 Google AI Pro 或 Ultra 的用戶,可以在 Antigravity 與 Gemini 應用程式裡直接從模型選單切換。免費層明確不供應 Neon,文件另註明費率與供應狀態可能變動。
在 Gemini 應用程式這一側,官方同步宣布應用內的 Tasks 功能可以改用 Neon 執行,處理多步驟工作比大型模型更快,訂閱方案的使用額度也因此用得更久,對照帳單時要記得應用程式額度與 API 用量是兩套不同的計量。Google 生態裡另一條開發者線,可以對照Apps Script 側欄剛轉正式版的進度。
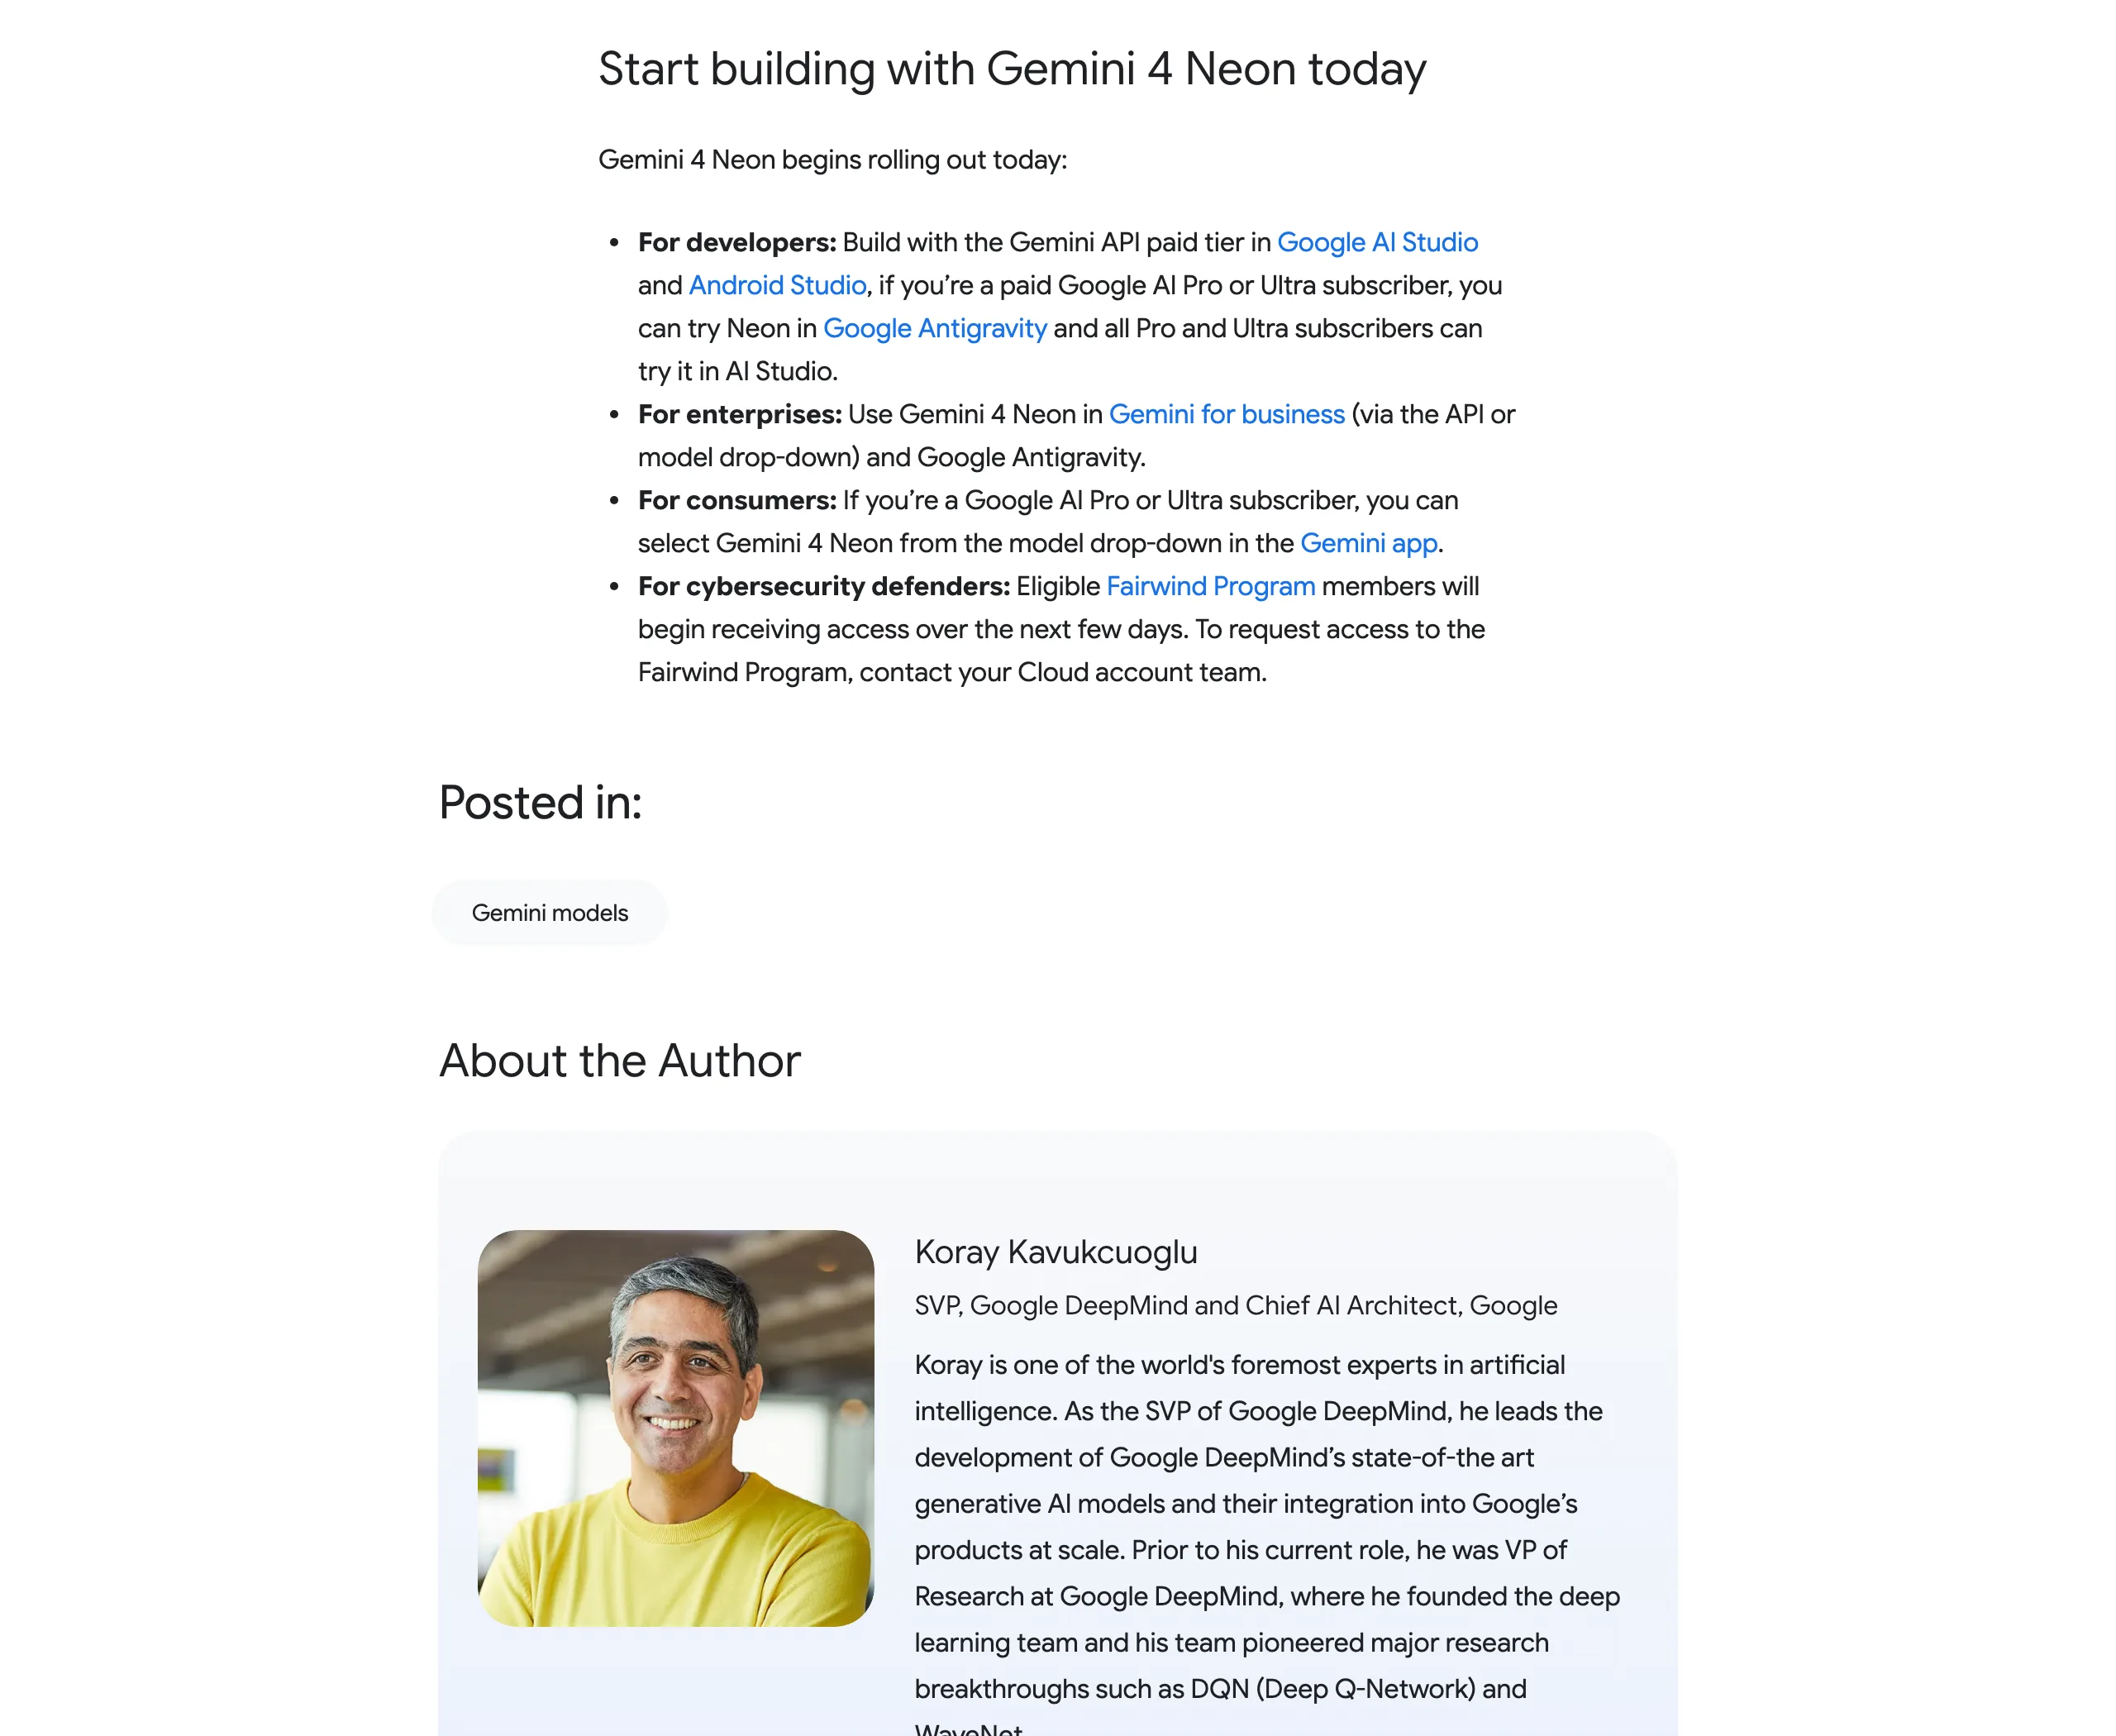
資安方向是獨立軌道:名為 Neon for cyber 的雙用途防禦能力,會在未來幾天提供給 Fairwind 計畫中符合資格的可信任防禦者,一般付費方案拿不到,要經由 Google Cloud 帳戶團隊申請。公告同時列出一系列資安基準成績,包括滲透測試基準 WebExploitBench v1.2 的 51.26%(約競品一半成本)、漏洞修補基準 CWE-bench v2 的 70.7%,這些屬於防禦版本的主張,與一般開發者用的標準版不能直接劃上等號。
入口確認是台灣團隊最先該做的事:公告與文件都沒有列出區域排除,但應用程式與 Antigravity 的實際可用性受帳號層設定影響,最可靠的做法是登入自己的帳號看模型選單有沒有出現 Neon,而不是假設官方展示的內容每個入口都拿得到。
公告的安全段落給了一組少見的具體數字,但每個都綁著條件。間接提示注入方面,在 Gray Swan 的 IPI 基準上,Neon 於最高思考等級搭配即時防護的設定下擋下全部攻擊,攻擊成功率 0%,官方註明這是與其他 Gemini 模型同級的成績,且結論僅限該基準的攻擊集合。誤拒方面,Terminal-Bench 4.0 上只拒絕了 1.98% 的正當任務,Terminal-Bench-Science 為 0%,官方的對照點是維持 Carbon 級的誤用防護、同時更少擋掉正常工作。
行為紀律方面,Terminal-Bench 4.0 作弊率 0.0%,內部 coding 評測的抄捷徑率 2.45%,是 Gemini 4 系列最低,代理安全套件的錯位行為率 0.09%,代理誠實評測通過率 99.2%,未服務率比 Carbon 減少 43% 到 56%,越權行為減少 15% 到 35%。
這些數字全部來自 Google 的內部評測與特定基準,方法細節在模型卡。對要讓代理接觸正式系統的團隊,合理的讀法是把它們當篩選參考,再用自己的邊界案例驗證,特別是涉及對外傳送或修改正式環境的權限,分段開放仍是最穩的做法。
還有幾件事,官方資訊尚未補全。帳號層的實際可用性:Gemini 應用程式與 Antigravity 的模型選單會依方案與地區逐步推出,公告用的是 rolling out 的說法,沒有給每個入口的完整時間表。Fairwind 資安版的「未來幾天」同樣是相對時間,實際進度要看計畫頁公告。價格方面,Carbon 的促銷價在 11 月 30 日結束,12 月 1 日起家族牌價排序會變動,屆時以 API 定價頁的即時數字為準。
如果這週要評估 Neon,順序比結論重要:先確認手上的入口(API 付費層、應用程式訂閱還是 Antigravity),再固定一段可驗收的工作,把思考等級從預設 high 開始跑,記下完成品質、來回次數與實際用量。模型名稱、入口與思考等級三個欄位一起記,之後比較對象換成 Carbon 或 Hydrogen 時,這份紀錄才比得下去,也才看得出差距來自模型本身還是外圍安排。11 月 26 日前後值得再回頭確認一次,屆時 Fairwind 進度、各入口開放狀態與 12 月牌價變動都會更明朗。