TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Contra Labs 與 BenchFlow 發布 Frontier Design Benchmark,用 33 個真實客戶委託案與 35 位專業設計師的 4,311 張盲測票評比 AI 網站設計。發布推文的 3,591 票快照由人類設計師居首,即時榜單已由隱藏身分的 Gestalt 以 Elo 1931 越過人類參考稿的 1739;設計評分規準把六個模型排在人類之前、設計師仍投給人類的分歧,正好畫出 AI 設計驗收的邊界。
用 AI 摘要這篇文章:
Contra Labs 與評測基礎設施公司 BenchFlow 在 11 月 18 日(台北時間 19 日凌晨)公開 Frontier Design Benchmark,一份用真實客戶委託案評比 AI 網站設計能力的基準。發布推文在 3,591 票的快照下寫著「設計師排名第一」;11 月 19 日查詢的即時榜單上,第一名的位置已經換成一個標註為隱藏身分(stealth)的參賽者 Gestalt,Elo 1931,人類設計師的參考稿以 1739 排在第二。
兩個快照都對,也都要帶著時間戳引用。這份榜單值得看的地方有三個:Gestalt 是官方認證「第一個評分越過人類參考稿的模型」,而且它的 95% 信賴區間下緣(1866)高於人類參考稿的區間上緣(1798);評測把設計品質拆成三個互相制衡的指標,其中評分規準與人類投票的分歧點,正好畫出 AI 設計驗收該畫的邊界;以及每個模型的單站成本與排名明顯脫鉤,最貴與最便宜的前段模型相差將近百倍。
先看榜單本身。11 月 18 日版本的官方資料集列出 17 個參賽者:一個是人類參考稿(官方稱 human golden),另外 16 個是模型,涵蓋 Anthropic、OpenAI、Google、Meta、xAI、Moonshot AI、阿里巴巴、DeepSeek 與 Z.ai。每個參賽者至少累積了 400 場以上的成對比較,票來自 Contra 平台上的專業設計師。
| 參賽者 | 組織 | Elo | 勝率 | 單站成本 |
|---|---|---|---|---|
| Gestalt(stealth) | 未揭露 | 1931 | 90% | 未揭露 |
| Human golden | Contra 設計師 | 1739 | 74% | 未揭露 |
| Claude Fable 5.2 | Anthropic | 1713 | 73% | 127.22 美元起 |
| Claude Opus 5.5 | Anthropic | 1691 | 73% | 24.26 美元 |
| GPT-6.1 Sol | OpenAI | 1668 | 70% | 1.31 美元 |
| Claude Sonnet 5.5 | Anthropic | 1667 | 69% | 20.49 美元 |
| Kimi K3.1 Pro | Moonshot AI | 1663 | 71% | 1.91 美元 |
| GPT-6 Astra | OpenAI | 1638 | 66% | 7.33 美元 |
| Qwen3.8 Max | 阿里巴巴 | 1434 | 39% | 8.13 美元 |
| DeepSeek V4 Pro | DeepSeek | 1121 | 12% | 0.46 美元 |
模型明顯分成兩群。前段六個模型擠在 1638 到 1713 之間,各自贏得 66% 到 73% 的比較;後段九個模型落在 1121 到 1434,勝率只剩 12% 到 41%。兩群之間的斷層有 204 分,是前段內部差距的兩倍以上。換句話說,設計能力的競爭目前發生在一段很窄的分數區間裡,掉出這個區間就是另一個世界。
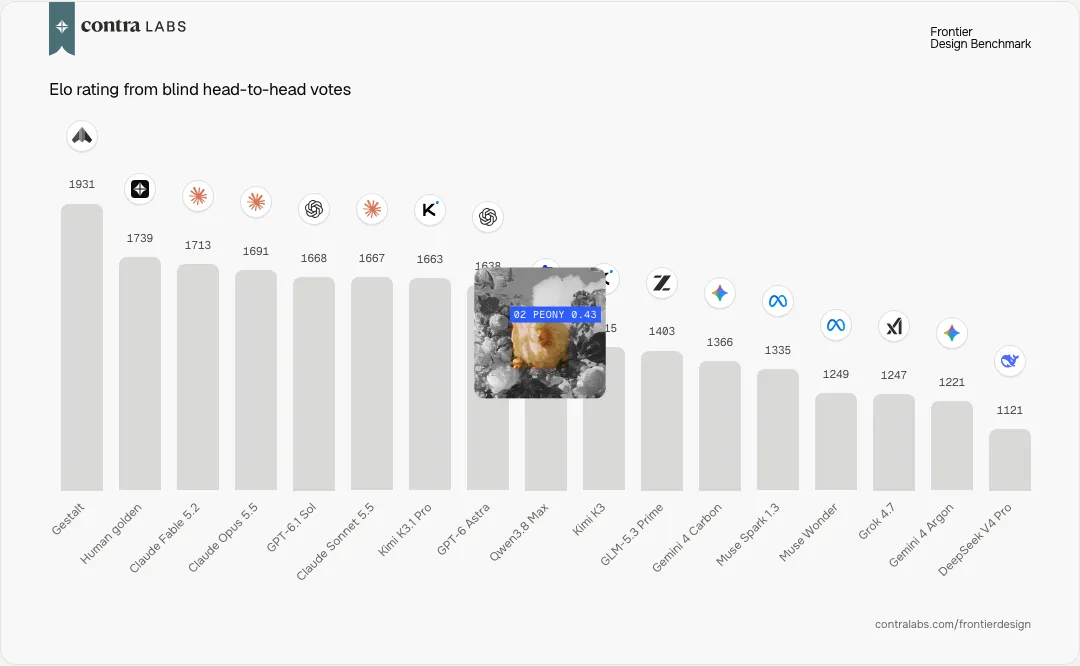
斷層也呼應成本軸。前段的 GPT-6.1 Sol 每個網站只花 1.31 美元、Kimi K3.1 Pro 1.91 美元,卻排在第五與第七;Claude Fable 5.2 是已公開模型裡評分最高的,但官方標記的成本是 127.22 美元起,而且註明這只是下界。墊底的 DeepSeek V4 Pro 每站 0.46 美元,我們先前介紹過這個系列在成本結構上的激進定位,這次它在設計評測的成績單上則清楚顯示:便宜買得到完成度,買不到設計師的偏好。
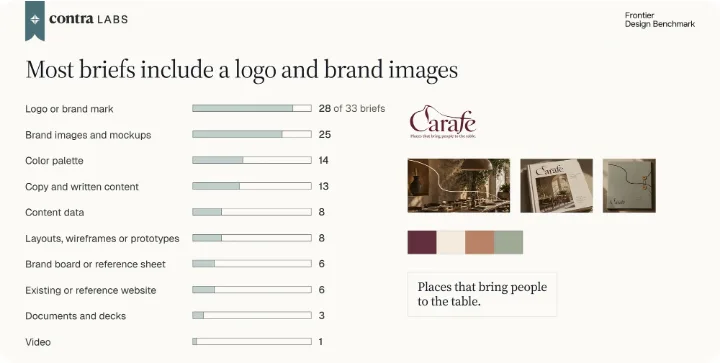
現有的設計評測常拿「做一個咖啡廳的 landing page」當題目。官方分析了 Contra 平台過去一年的 4,600 個網站專案後指出,真實委託案的中位數規格書有 138 個英文字、預算中位數 1,050 美元,而且 75% 的案子會疊加兩種以上的約束條件,例如品牌素材、目標客群或商業目標。
所以這份基準的 33 道題目裡,27 道改寫自 Contra 上的真實工作(換成虛構客戶以保護原案),另外 6 道來自新創公司的真實專案,附帶這些公司自己的品牌素材、現有網站檔案與產品圖。在 27 道工作題裡,19 道直接給客戶的標誌當起手素材,17 道要求網站在手機上要好用。交付類型橫跨多頁行銷網站(例如賣票的音樂節網站)、活動頁、有完整流程的網頁應用程式(例如群眾募資結帳、含測驗與結業證明的線上課程),以及兩個行動應用(美術館語音導覽、給館方人員的語音筆記本)。
題目的交付標準也值得注意。以其中一題為例:Broomwagon,一個給單車維修工作室發布數位服務選單的網頁應用程式,規格書開頭就寫明「不會技術的工作室老闆,要能自己上架選單、從管理後台更新」,接著列出 12 項交付功能,從帶定價預覽的活動頁、免密碼信箱登入、初次設定引導、管理後台、服務項目與價格編輯、作品相簿、營業時間與聯絡資訊,到發布前的桌面與手機預覽、對外的公開選單頁。交付物標明是可在 390、768 與 1440 像素寬度實際運作的網站。這一題有 15 個模型參賽、累積 168 票,人類參考稿在該題贏得 83% 的比較,模型之中目前由 Claude Sonnet 5.5 領先。題目本身就是一張驗收單,這是這份基準對實務最有參考價值的設計。
兩邊的製作條件刻意不同。人類參考稿由 Contra 上的專業設計師製作:先交付三個方向的情緒板,接受官方團隊的回饋後,用自己選的工具把網站做起來,之後還有一輪回饋與修改。AI 端由 BenchFlow 的沙盒環境執行,記錄完整軌跡與成本,模型透過 OpenRouter 串接,而且「只要做得到,就讓每個模型跑在它自己實驗室的 agent harness 裡」。
官方把兩邊的製作條件公開寫在方法學裡;據此推讀,總分反映的是整套製作過程的組合,包含人類那邊的回饋迴圈與模型那邊的原生工具。這意味著榜單量的是「哪種交付方式在這些題目上贏得設計師偏好」,要把它讀成純模型能力,得先接受這個前提。這也是我們報導過的幾款評測共同在處理的問題:RAG 評測工具 Ragas 把各指標拆開檢驗,是同一個方向的另一個例子。
人類稿在官方文件裡的定位也值得知道:每題一份,用來展示「什麼叫高品質的人類設計」,並當成模型要追的目標。實際投票時,它與模型作品匿名並排出現,所以 574 場有它加入的比較裡,設計師面對的是「看不見誰做的」的真實選擇,輸贏都算進榜單。
投票端有 35 位設計師,分五輪投出 4,311 票。Contra 平台上的設計師遍布 150 多個國家、自報領域年資中位數八年,官方把進榜門檻設在 10 張計數票,還沒跨過門檻的參賽者會標成尚未排名。每票是同一題的兩個匿名作品二選一,設計師可以補充色彩、字體、版面、可用性或需求遵循的理由。票數用 Bradley-Terry 模型轉成 Elo 分數,勝率則附 95% 信賴區間。穩定性檢查是把設計師隨機對半分組、各自排名,兩份榜單的平均排序相關係數 0.95(200 次分組平均)。
除了投票,每個作品還過兩道輔助量測:一套 10 個維度、35 個細項的設計評分規準(字體層級、留白、對比、渲染完整性之類),以及一個 0 到 100 的 AI 臉偵測器。規準分數與設計師的模型排名相關係數 0.94,看起來高度一致。
有趣的地方在分歧處。按評分規準,人類參考稿拿 73.6 分,排在第六個參賽者之後:Claude Fable 5.2(83.8)、Claude Opus 5.5(83.5)、Gestalt(83.3)、GPT-6.1 Sol(79.4)、Claude Sonnet 5.5(79.3)、GPT-6 Astra(78.7)全部更高。參考稿被扣的分來自設計師能指著說的執行錯誤,例如按鈕文字與背景對比不足、字標被上方區塊切掉。但面對同一批參考稿,設計師在 574 次比較中仍然投給它 425 次,74%。
官方自己的結論寫得很直白:規準量的是所有設計師都該避免的錯誤,量的東西裡不含品味,而品味正是設計師投票時在投的東西。這個分歧點對要用 AI 出網站的團隊是現成的驗收架構:把可檢查的錯誤(對比、留白、渲染、回應式)交給規準清單逐項核對,把不可檢查的品味交給真人對照組,而且兩邊的結論要分開記錄,不要互相覆寫。
AI 臉偵測器的訓練素材是人類做的頁面與 AI 做的頁面,輸出「這個頁面看起來比多少比例的 AI 頁面更像 AI」的讀數,並附帶驅動分數的特徵。人類參考稿的讀數是 0.9,模型落在 1.2 到 66 之間,而且讀數跟著實驗室走:三個 Claude 模型 31 到 38,兩個 GPT 模型 41 到 53,兩個 Gemini 模型 54 到 57。
兩個極端都是 1.2,原因相反。DeepSeek V4 Pro 大量頁面根本沒做完,不像典型 AI 頁面;Gestalt 頁面完成度高、又被設計師選走 89% 的比較,是「最不像 AI 的完成品」。
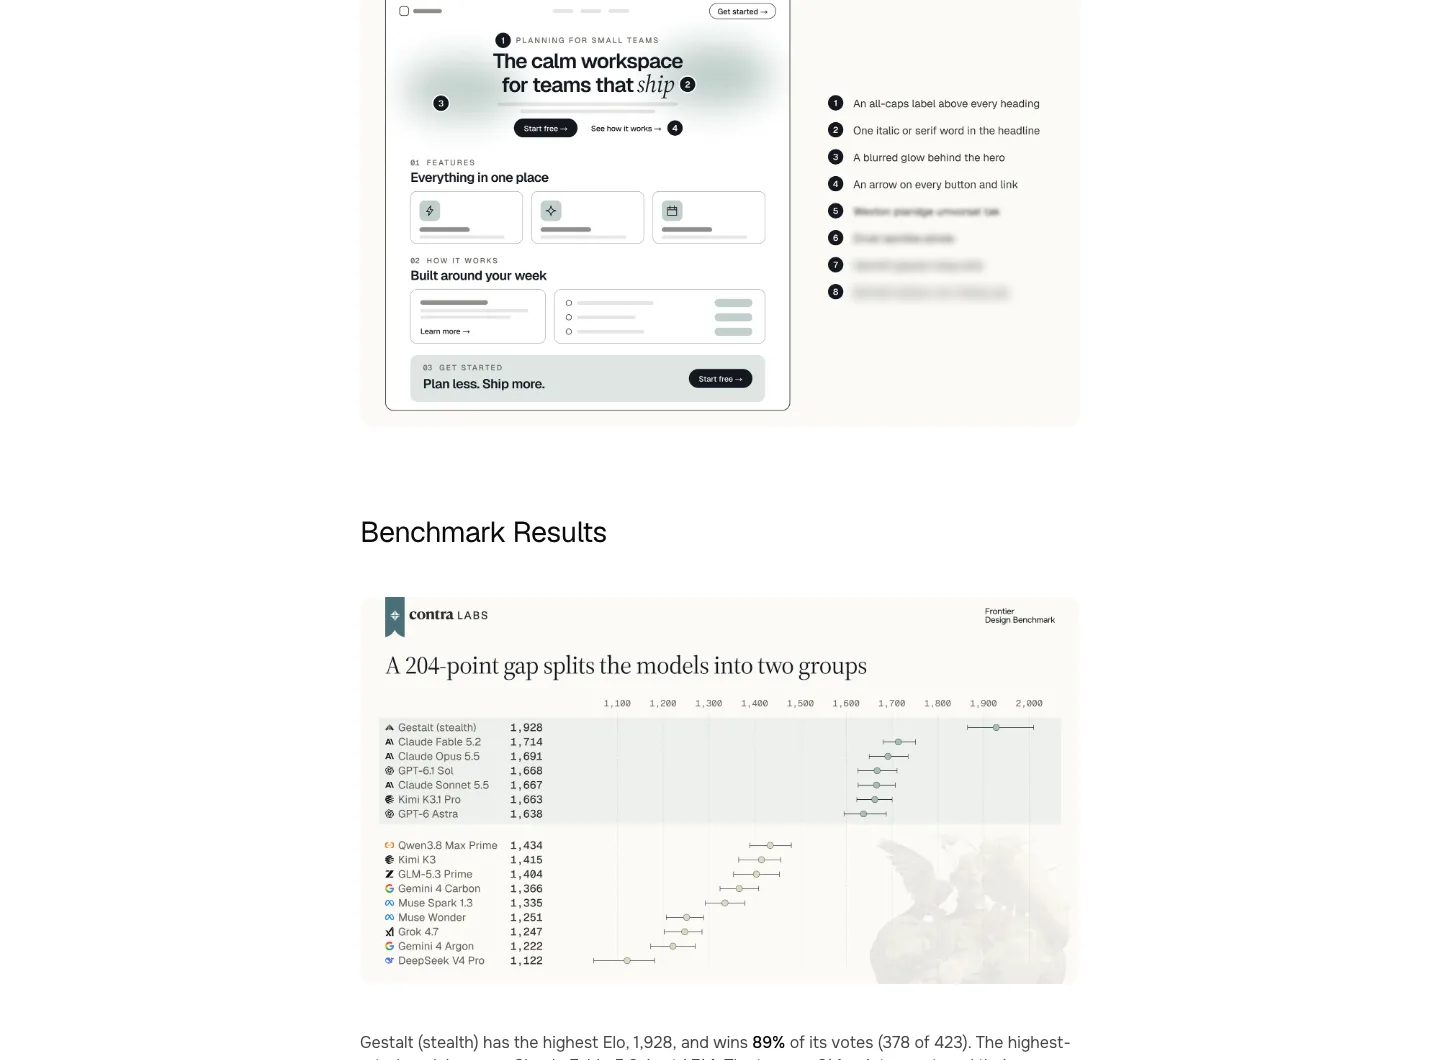
官方也把設計師口中「看起來很 AI」的模式整理成清單,幾個高頻項可以直接抄進團隊的驗收表:
實驗室指紋也存在。Claude 模型愛用橫向箭頭(80% 到 90% 的頁面,其他廠 49%),GPT 模型愛用斜向箭頭(84% 到 92%,其他廠 15%);GPT-6.1 Sol 有 48% 的頁面把標題寫成兩三個短句並列的口號(其他廠 2%),內文則停在好處、不講產品怎麼運作(68% 對 11%);Gemini 4 Argon 反向把行銷區塊寫成規格表(92% 對 29%);DeepSeek V4 Pro 一半頁面的每個區段標題都置中,其他所有廠牌加起來 322 頁裡只有 1 頁這樣做。這份清單官方承諾會隨模型演化持續更新。
Gestalt 是這次發布的另一個焦點。官方在發布文裡把它定位為「目前正在隱藏階段的高品質設計模型」,用與其他模型相同的盲測配置評測,並表示正在與其團隊合作持續評測與回饋。它的成本欄位是空的,與其他走 OpenRouter 計費軌道的模型不同。
它背後是誰,官方沒有說,榜單上也只有 stealth 標籤。把某一個未發布產品猜成 Gestalt,會把一份可查證的榜單變成傳聞,這裡照官方口徑如實保留未知。可以確認的是成績:Elo 1931、420 場比較贏 376 場、與 golden 直接對決時 28 次裡被選走 20 次,而且 95% 信賴區間與人類參考稿完全不重疊。
先看數字口徑,站內自己就不一致。官網首頁橫幅寫「68 位專業設計師」,方法學頁與榜單的投票面板口徑是 35 位;方法學頁的票數停在約 3,600 票、分組排名相關係數 0.92,發布文則是 4,311 票與 0.95。引用時標明出處頁面,兩套數字不要混接。
榜單本身是動態的。發布當天的推文快照(3,591 票、設計師第一)與 11 月 18 日資料集(4,311 票、Gestalt 第一)落在同一天內,網站也開放了公開投票頁讓任何人匿名二選一,這些票如何計入官方面板,站方沒有明說。任何名次都應該帶查詢日期。
最後是身分與適用範圍。Gestalt 是 stealth 參賽者,16 個模型裡也有多個是以各家自家 harness 出賽,名次對應的是「模型加工具鏈」的組合。它不量網站上線後的轉換率、維護成本或載入速度,把榜單當採購指南之前,先想清楚自己要的是設計師偏好還是營運指標。
這份基準對一般團隊最大的價值,或許是可以直接搬走的方法。規格書範本就藏在官方對 4,600 個專案的分析裡:客戶資訊、目標受眾、頁面與使用者流程、品牌素材,加上行動優先、載入快速、無障礙這類實務要求,五個元素補齊就是一張可驗收的設計需求單。接著讓兩種製作方式匿名對決,把小標籤、斜體、編號、卡片化這類 AI 臉清單放進驗收表,再讓一組真人對照投票。上週剛宣布徵題的個人代理評測基準 PALE 還在等第一批考題,Frontier Design 已經帶著 4,311 票的成績單上線;兩份基準相隔三天出現,說明「用真實工作評 AI」正在從口號變成可操作的評測產品。榜單會繼續更新,Gestalt 的身分與斷層會不會被填上,值得在一到兩週後回來再看一次。