TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Google DeepMind 發表 AlphaGenome 2,把基因變異預測從組織平均推進到可指定細胞類型與狀態:1 億 700 萬份細胞圖譜做後訓練,TenK10K 測試的致因變異召回率從 16% 提高到 30%。研究 API 對非商業用途免費,商用在私人預覽,臨床診斷官方明寫未驗證也未核准。
用 AI 摘要這篇文章:
Google DeepMind 在 2026 年 11 月 11 日發表 AlphaGenome 2。這次更新的重點可以壓成一句話:以前把一段 DNA 丟給模型,拿回的是整塊組織平均出來的答案;現在要先告訴模型你問的是哪一種細胞、處於什麼狀態,它才回答這段序列在那個條件下會怎麼運作。心臟、大腦與免疫系統共用同一份 DNA 序列,單字母變異為什麼只在某些細胞裡釀成疾病、卻放過其他細胞,這正是官方公告開場設定的問題。
換了問法,成績單也換了計法。在涵蓋 28 種免疫細胞類型的 TenK10K 測試裡,固定 90% 精確度或準確度的門檻下,AlphaGenome 2 找回致因變異的比例從上一代的 16% 提高到 30%,基因活動方向的預測從 23% 提高到 43%。這些是研究基準測試的數字,衡量的是模型能不能幫團隊多找回可驗證的線索,與個人疾病診斷的準確率是兩回事,後面會把口徑拆開。
取得方式也畫了清楚的線:非商業研究當天就能透過 AlphaGenome API 免費使用,商業用途仍在私人預覽階段,模型權重沒有開放下載,官方聲明明寫它未經臨床或診斷用途的驗證或核准。以下依官方公告、78 頁論文與 API 文件,拆解這次實際改變了什麼、數字怎麼判讀、誰現在能用。
先看前後差異。2025 年推出的 AlphaGenome(下稱 AG1)已經能從一段約 100 萬個 DNA 字母的序列預測多種分子訊號,但它的輸出是固定的組織平行輸出:同一個問題,拿回的是一批 bulk 組織與細胞株的平均答案。之後的 AlphaGenome Atlas 再把人類基因體所有 90 億種單字母變異的效果預先算好,做成可查詢的資料庫。
AlphaGenome 2(AG2)把「條件」搬進輸入端。論文摘要的寫法很直接:模型接收一段 1-Mb 的 DNA 序列,外加一個指定組織、細胞類型或細胞狀態的條件,預測遺傳變異如何影響數百種人類細胞。同一段序列在巨噬細胞和在紅血球前驅細胞裡,會被讀成不同的活動訊號,這件事從模型的輸入就開始反映。
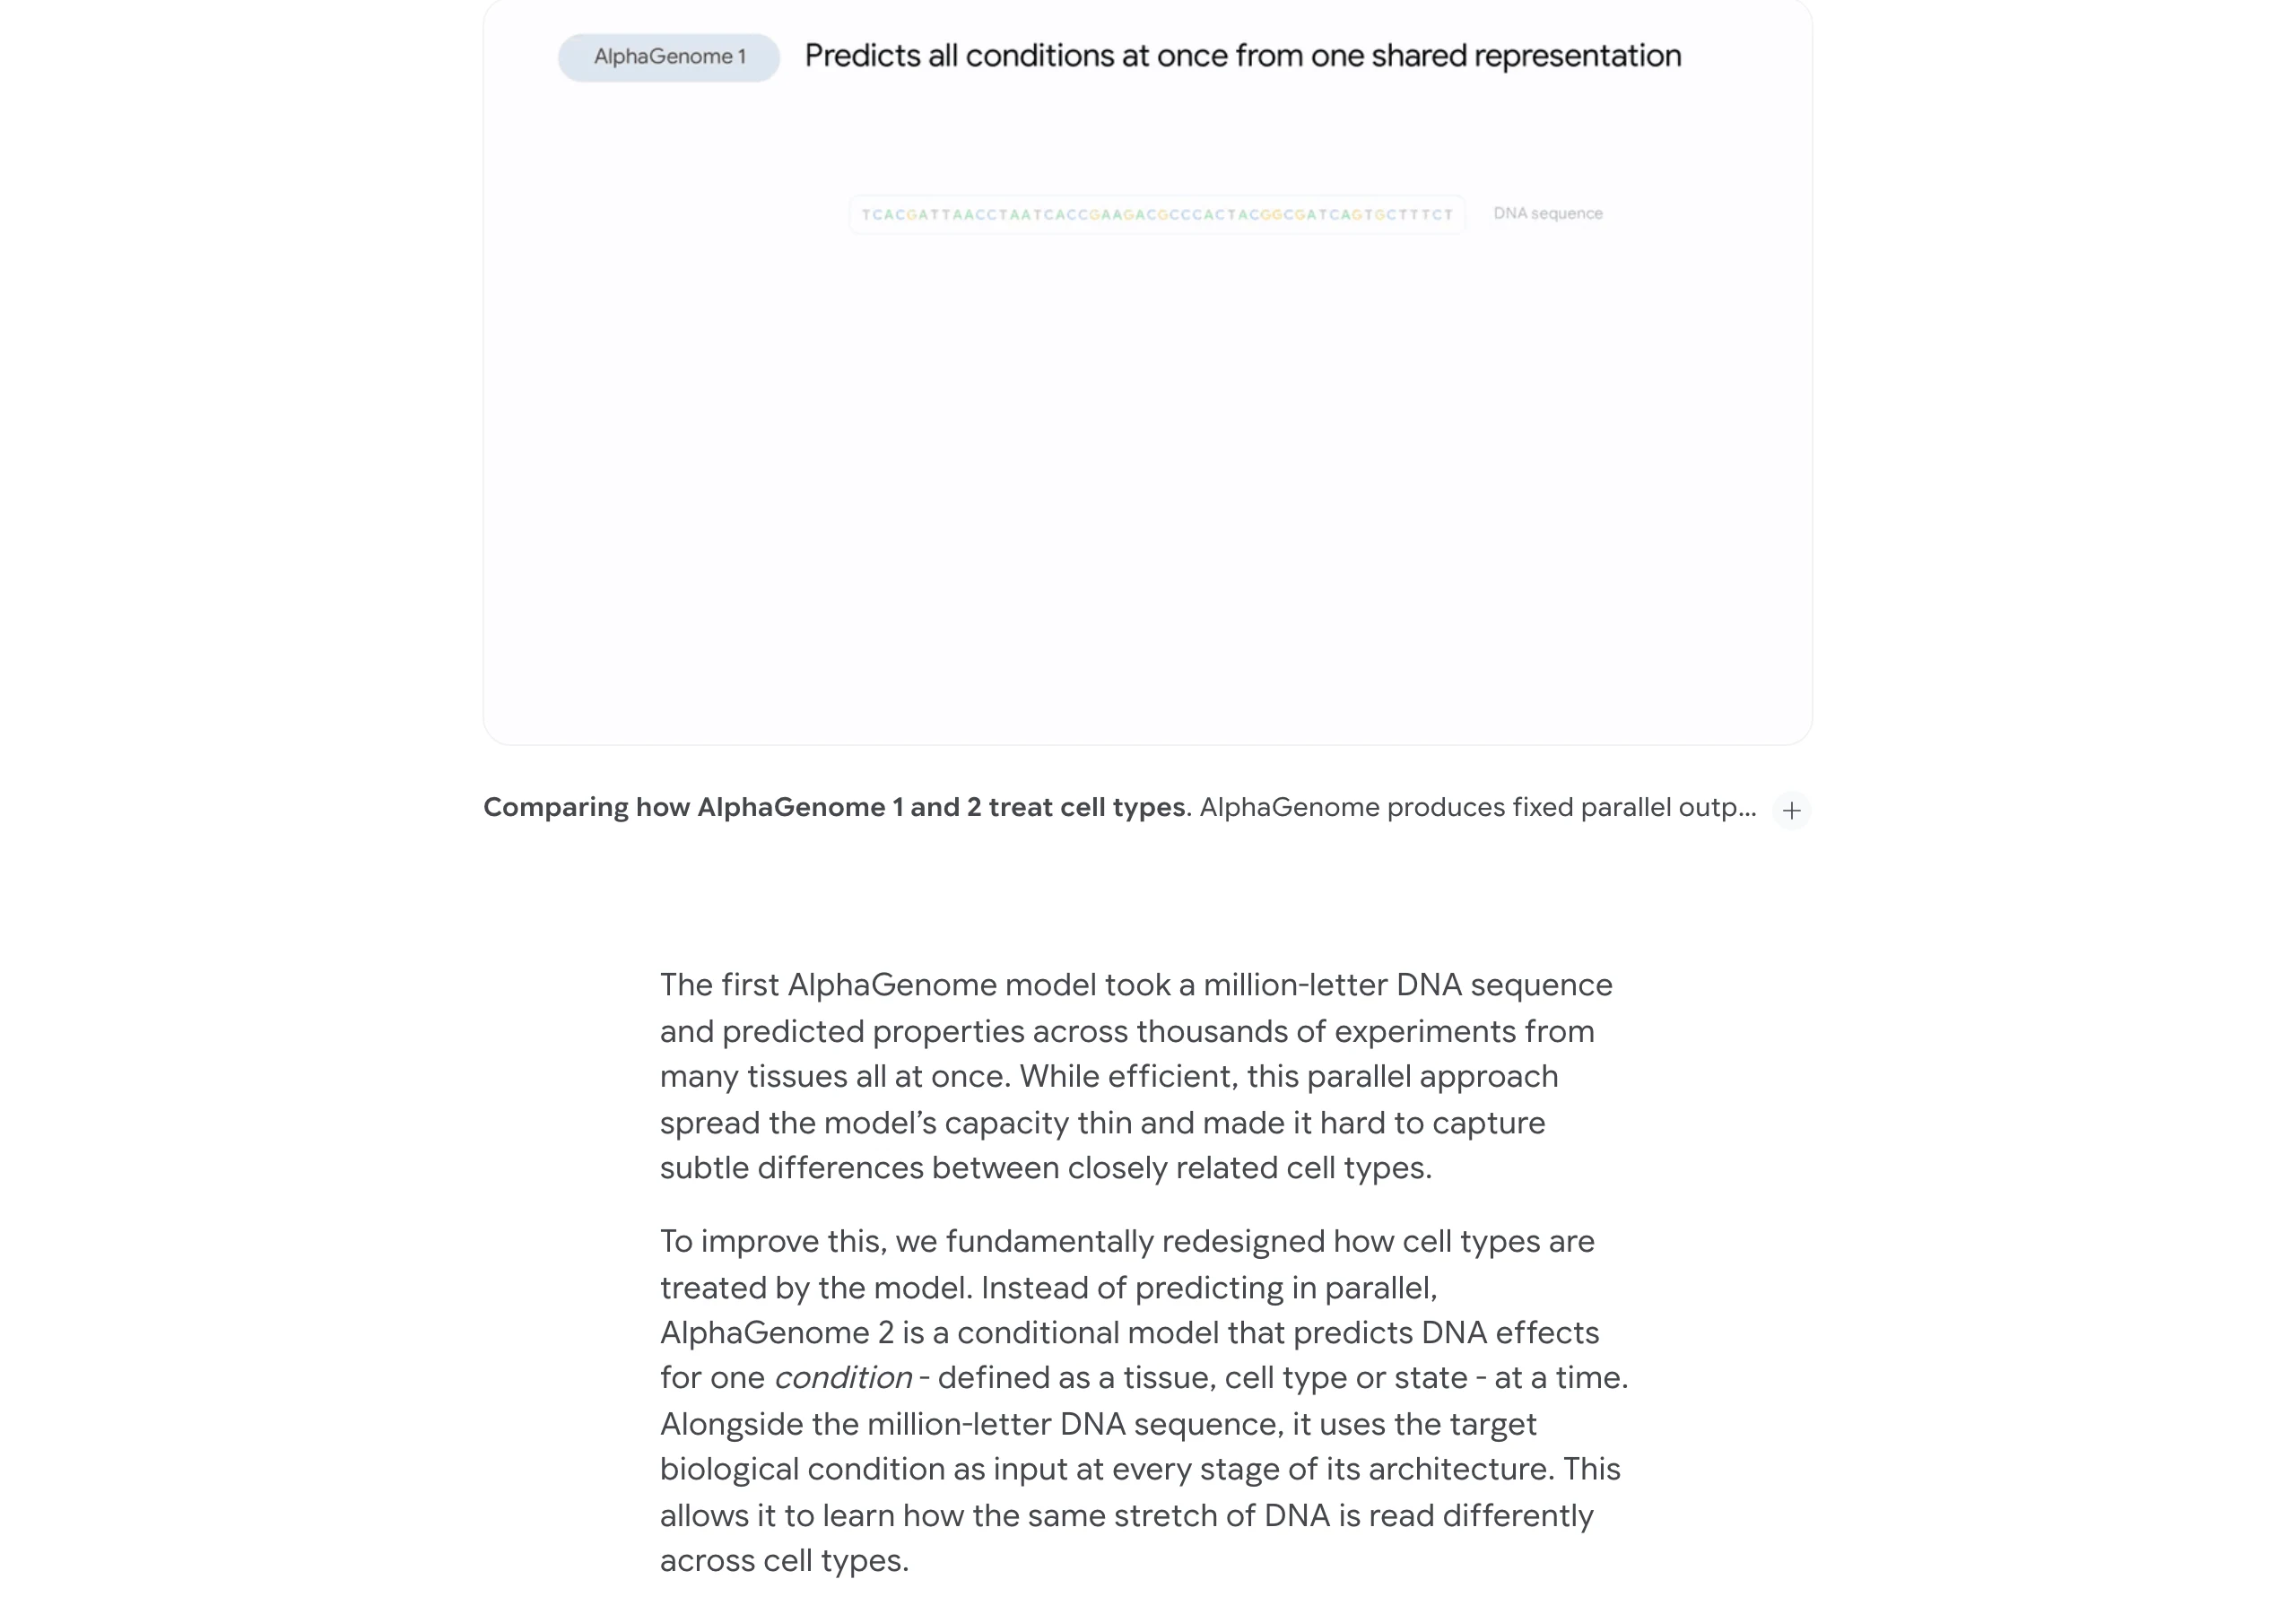
為什麼組織平均會成為瓶頸。基因調控指細胞決定哪些基因在什麼時候被使用、活動程度多高;某個變異可能只干擾一小群細胞的這套開關。把整塊組織的資料混在一起平均,這群細胞的訊號就會被其他細胞稀釋,研究者在 bulk 資料裡追不到變異的去向。AG2 的條件式設計,就是讓「在哪種細胞裡問」變成問題的一部分。
輸出端同步擴充。AG1 既有基因表現、組蛋白修飾與染色質可及性等訊號,AG2 加入 DNA 甲基化,一種附在 DNA 上的化學標記,是官方說明裡點名「被廣泛要求」的新項目。條件式架構也讓模型能補推估未量測的訊號:若某種細胞只量過部分活動,模型可以推估其他訊號再由研究者決定哪些值得補做測量。
一個容易混淆的點先釐清:Atlas 與 AG2 是分工,不是資料庫改名。Atlas 查的是預先算好的 90 億筆變異效果,適合大規模檢索;AG2 回答的是「在我指定的細胞條件下做一次新預測」,兩者走不同入口,速率條件也不同。
訓練資料的正確口徑值得單獨看。AG1 只用 bulk 測定資料訓練;AG2 加入 36 項人類與小鼠研究的 3,977 個單細胞偽體(pseudobulk)資料軌,收了 185 個人類參考條件的 CpG 甲基化資料,並在最後階段用取樣自 1 億 700 萬份人類單細胞 RNA 定序圖譜的細胞做後訓練,涵蓋 68 種組織。
這個數字常被讀成「一億多位受試者」,兩者差距很大。一億零七百萬是細胞層次的量測紀錄:不同捐贈者的檢體經單細胞定序後逐顆計數。它支撐的是模型見過多少種細胞狀態,不是人口代表性,資料量大也不代表所有族群、組織與疾病狀態被均等涵蓋。研究者把自己的問題對上去之前,仍要核對目標細胞是否在訓練與評測範圍裡。
數字要看它的測試設定。TenK10K 是一張大型單細胞圖譜,量測週邊血 28 種免疫細胞類型裡變異對基因表現的效果(單細胞 eQTL)。論文的口徑:在 90% 精確度的區間,AG2 把致因變異的召回率從 16% 提高到 30%,對照組是拿單細胞資料微調過的 AG1 與其他專門模型;整體 AUPRC 為 0.76,高於微調 AG1 的 0.72 與專門模型 Scooby 的 0.69。另一個獨立資料集 IBDverse(47 種腸道細胞類型)上,方向預測從 31% 提高到 45%。
| 測試 | 指標 | 對照 | AlphaGenome 2 |
|---|---|---|---|
| TenK10K(28 種免疫細胞) | 致因變異召回率 | 16% | 30% |
| TenK10K(28 種免疫細胞) | 基因活動方向預測 | 23% | 43% |
| IBDverse(47 種腸道細胞) | 基因活動方向預測 | 31% | 45% |
三行數字都落在固定 90% 精確度或準確度的區間,對照組是微調過的 AG1 與專門模型,門檻高於隨機基準。它能推出的是:在同樣的驗證資源下,模型先排序出更多值得做實驗的候選變異,把全基因體關聯研究(GWAS)找到的大段關聯區段,推進到「哪個變異、作用在哪個基因、發生在哪種細胞」的層級。GWAS 的老問題正是統計關聯落到致因變異之間的鴻溝。
它推不出的也一樣明確。90% 精確度的意思,是模型每指出十個候選,平均有九個經得起後續檢驗,代價是放過部分真訊號;16% 到 30% 的召回率就是在這個門檻下量出來的,換個門檻數字就會不同。它沒有回答帶著某個變異的人會不會發病,把 30% 改寫成「疾病診斷準確率三成」,等於把研究工具的篩選成績換算成醫療承諾,兩者測的不是同一件事。研究排序與臨床診斷使用不同層級的證據,醫師的診斷要綜合檢查、病史與家族資訊,這條線官方自己在免責聲明裡也畫死了。
官方挑的驗證案例是發炎性腸道疾病(IBD)。Stankey 等人的研究在原代人類巨噬細胞裡,結合染色質構形捕獲、CRISPR-Cas9 擾動與 MPRA(大量平行報告測定)三種證據,定論 21q22 位點的 rs2836882 是驅動風險的變異:它上調遠在約 29 萬個字母之外的 ETS2 基因,而非更近的候選基因。這是 AG2 回驗的標準答案,三種實驗證據在論文裡都有對應。
AG2 在這個位點交出的答案是三個成分全部重現。對可信集合裡的七個變異逐一計分,只有 rs2836882 預測出大效果;變異選擇性連到 290 kb 之外的 ETS2,放過其他基因;效果限於單核球與巨噬細胞,其他細胞類型大致不受影響。模型在沒有被餵進實驗結論的前提下,把變異、細胞與下游基因的機制關係組回來了。
判讀這個案例要守住界線:重現一項已知發現,證明的是模型抓得到對應訊號,不是發現了新療法。它的價值在於把「一段序列的分數」換成「可追查的機制關係」,研究團隊接著要自己設計:在哪個細胞條件下改動序列、觀察哪個基因訊號、用什麼實驗排除其他解釋。預測給方向,實驗才給新的觀察。
規模化的那一面也已經先算好。DeepMind 用 AG2 對約 700 萬個變異(Open Targets 平台的精細定位 GWAS 可信集合,加上 gnomAD 的常見變異)跨 510 個組織與細胞條件預先計分,並把增強子與目標基因的連接圖擴及原代人類細胞類型,例如腦中支撐神經元的星狀膠細胞。不想自己跑大規模運算的研究者,可以直接查這批預計算結果。
條件式設計還有第二個後果:對新的細胞狀態做預測,不必重新訓練模型。研究者上傳一份單細胞 RNA 定序快照,模型把其中的基因活動壓縮成細胞狀態表示,拿它當條件,就能對訓練時沒見過的狀態預測。論文測了取樣極限:每種細胞類型只取 128 顆、16 顆甚至單顆細胞,在 TenK10K 上的變異效果預測仍維持水準。
一個具體案例來自 COVID-19 mRNA 疫苗研究。疫苗誘導的 CD8 陽性 T 細胞(VI-A)是打完加強針後擴增的稀有族群,其中只有 111 顆細胞量過染色質可及性。AG2 僅用 RNA 資料當條件,補推估出的可及性差異與實測差異正相關(37,035 個可及區域上 Pearson 相關係數 0.46);它還指出與重症相關的變異 rs13066062(位於 3p21.31 的 FYCO1 內含子)在活化狀態下對基因活動的干擾更強,靜止的 T 細胞裡看不到這個效果。疾病或疫苗造成的狀態,往往是 bulk 資料追不到的那種。
界線同樣要畫清楚。少量細胞就能問,是特定方法在特定測試上的結果,不能讀成任何疾病只要幾十顆細胞就有足夠證據;條件化省掉的是重新訓練的負擔,取樣與量測品質仍然是研究者的責任。樣本與實際問題差太遠,模型拿到的條件就跟著偏,預測自然不可靠。
學術研究這條路已經開了。官方文件明寫 API 對非商業用途免費,查詢速率隨需求變動;Atlas 查表允許的速率高於即時模型預測,文件點出的適用量級在數千次預測這一級,更大的檢索量要靠速率較寬的 Atlas 查表。表現條件(expression conditioning)的互動式 Colab 教學與 AG2 同天上線,研究者可以從自己的單細胞資料開始試。
商業用途還在排隊。公告把商業研究放在私人預覽,需要申請,沒有給全面開放的時間表;能呼叫服務與能下載權重自己部署是兩件事,這次公告沒有釋出權重的承諾,對資料敏感或需要大規模自建算力的團隊,可用性就停在服務邊界上。
臨床這條線官方寫得最白,官方免責聲明寫道:「AlphaGenome 與 AlphaGenome 2 僅供研究使用,未經臨床或診斷用途的驗證或核准」。模型面向的是研究假設的排序與機制追查,個人的健康判斷不會因為這次發表變準。
時程上還有兩個回查點。官方說 AlphaGenome 2 Skills 即將進入 Google Antigravity 這個代理開發平台,化學資訊類的科學技能已經在上面上線過一輪,這次是把基因體預測接進同一種工作流;社群徵集使用案例的表單到 11 月 30 日截止,入選計畫有機會獲得額外配額與點數,那批案例正是後續觀察實際產出的主要素材。
把整次發表收攏成一個判讀框架。遇到基因體模型的新數字,先分辨它衡量的是哪一層:候選召回(模型找回多少已知致因變異)、分子預測(模型推估的訊號與實測多接近),還是臨床結果(對病人的診斷或治療有沒有幫助)。這次 AG2 的進步全部落在前兩層,而且是「問對細胞」換來的;第三層這次沒有前進,官方也沒有宣稱前進。
研究者現在能做的,是拿 Colab 教學把自己的細胞類型對進參考條件,比較條件式預測與既有工具在自己資料上的排序差異;一般讀者把「召回率近翻倍」記成研究工具的進步即可,它不會出現在任何人的健檢報告裡。AI 模型在生物研究裡的位置,可以先看先前對 Omnii-1 噬菌體計畫的分析:打通設計管線與證明治療效果是兩件事,同一條界線在基因體預測模型上一樣成立;蛋白質結構那端,先前也有 Claude 團隊解出原核 vault 顆粒結構的案例,走的同樣是模型給線索、實驗給證據的分工。
接下來值得追蹤的訊號依序是 Antigravity Skills 的實際上線、商用預覽轉正式的條件,以及 11 月 30 日表單截止後官方釋出的使用案例。數字會繼續出現,把層級分清楚,就不會把研究工具的進步誤讀成醫療承諾。