TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

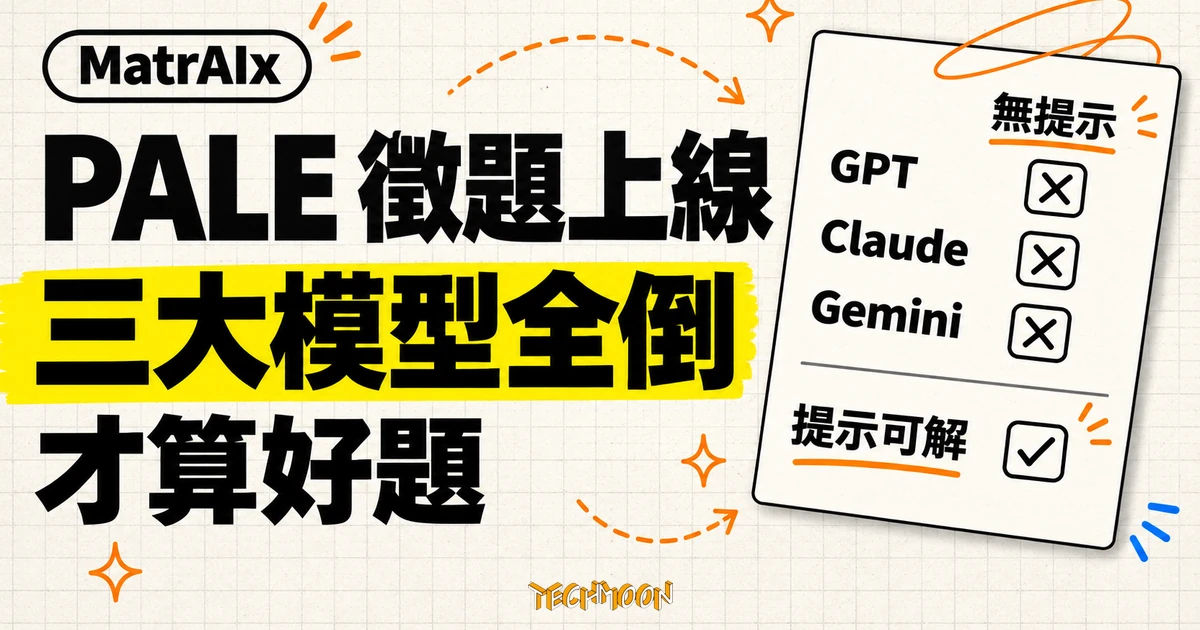
MatrAIx 於 2026 年 11 月 15 日開源個人代理評測基準 PALE(Personal Agents' Last Exam),這是 10 月中發表第一版的 PersonalAgentEval 的開源版本。本次上線開放環境與任務兩軌提案:題目必須讓 GPT、Claude、Gemini 的指定模型在無提示實測全數未通過且平均分數低於 50%,另跑提示輔助版達 100% 才算合格。倉庫目前只有徵題模板與同步腳本,統一執行基礎設施與首份模型名單尚未發布,上線隔天起約 31 小時內湧入 53 件提案。
用 AI 摘要這篇文章:
2026 年 11 月 15 日,MatrAIx 團隊把個人代理評測專案 Personal Agents’ Last Exam(簡稱 PALE)放上 GitHub 開源。這次上架的並非一套能直接跑出分數的評測工具,而是徵題機制:環境(Environment Track)與任務(Task Track)兩軌的提案 PR 同日開放,README 的 News 段明載基礎設施「即將釋出」。PALE 是 MatrAIx 在 2026 年 10 月 14 日發表第一版的 PersonalAgentEval 評測之開源版本,定位是讓外部研究者一起幫「個人 AI 代理」出考題。
對照時間軸可以看出這次開源的節奏:GitHub 倉庫 MatrAIx-ai/Personal-Agents-Last-Exam 於 11 月 9 日建立並寫入第一筆 commit,11 月 15 日官方宣布正式上線並開放提案,到 11 月 17 日仍維持每天多次更新,多數是提案清單的自動同步。換句話說,從閉源前版到開源徵題,中間只隔了約一個月。
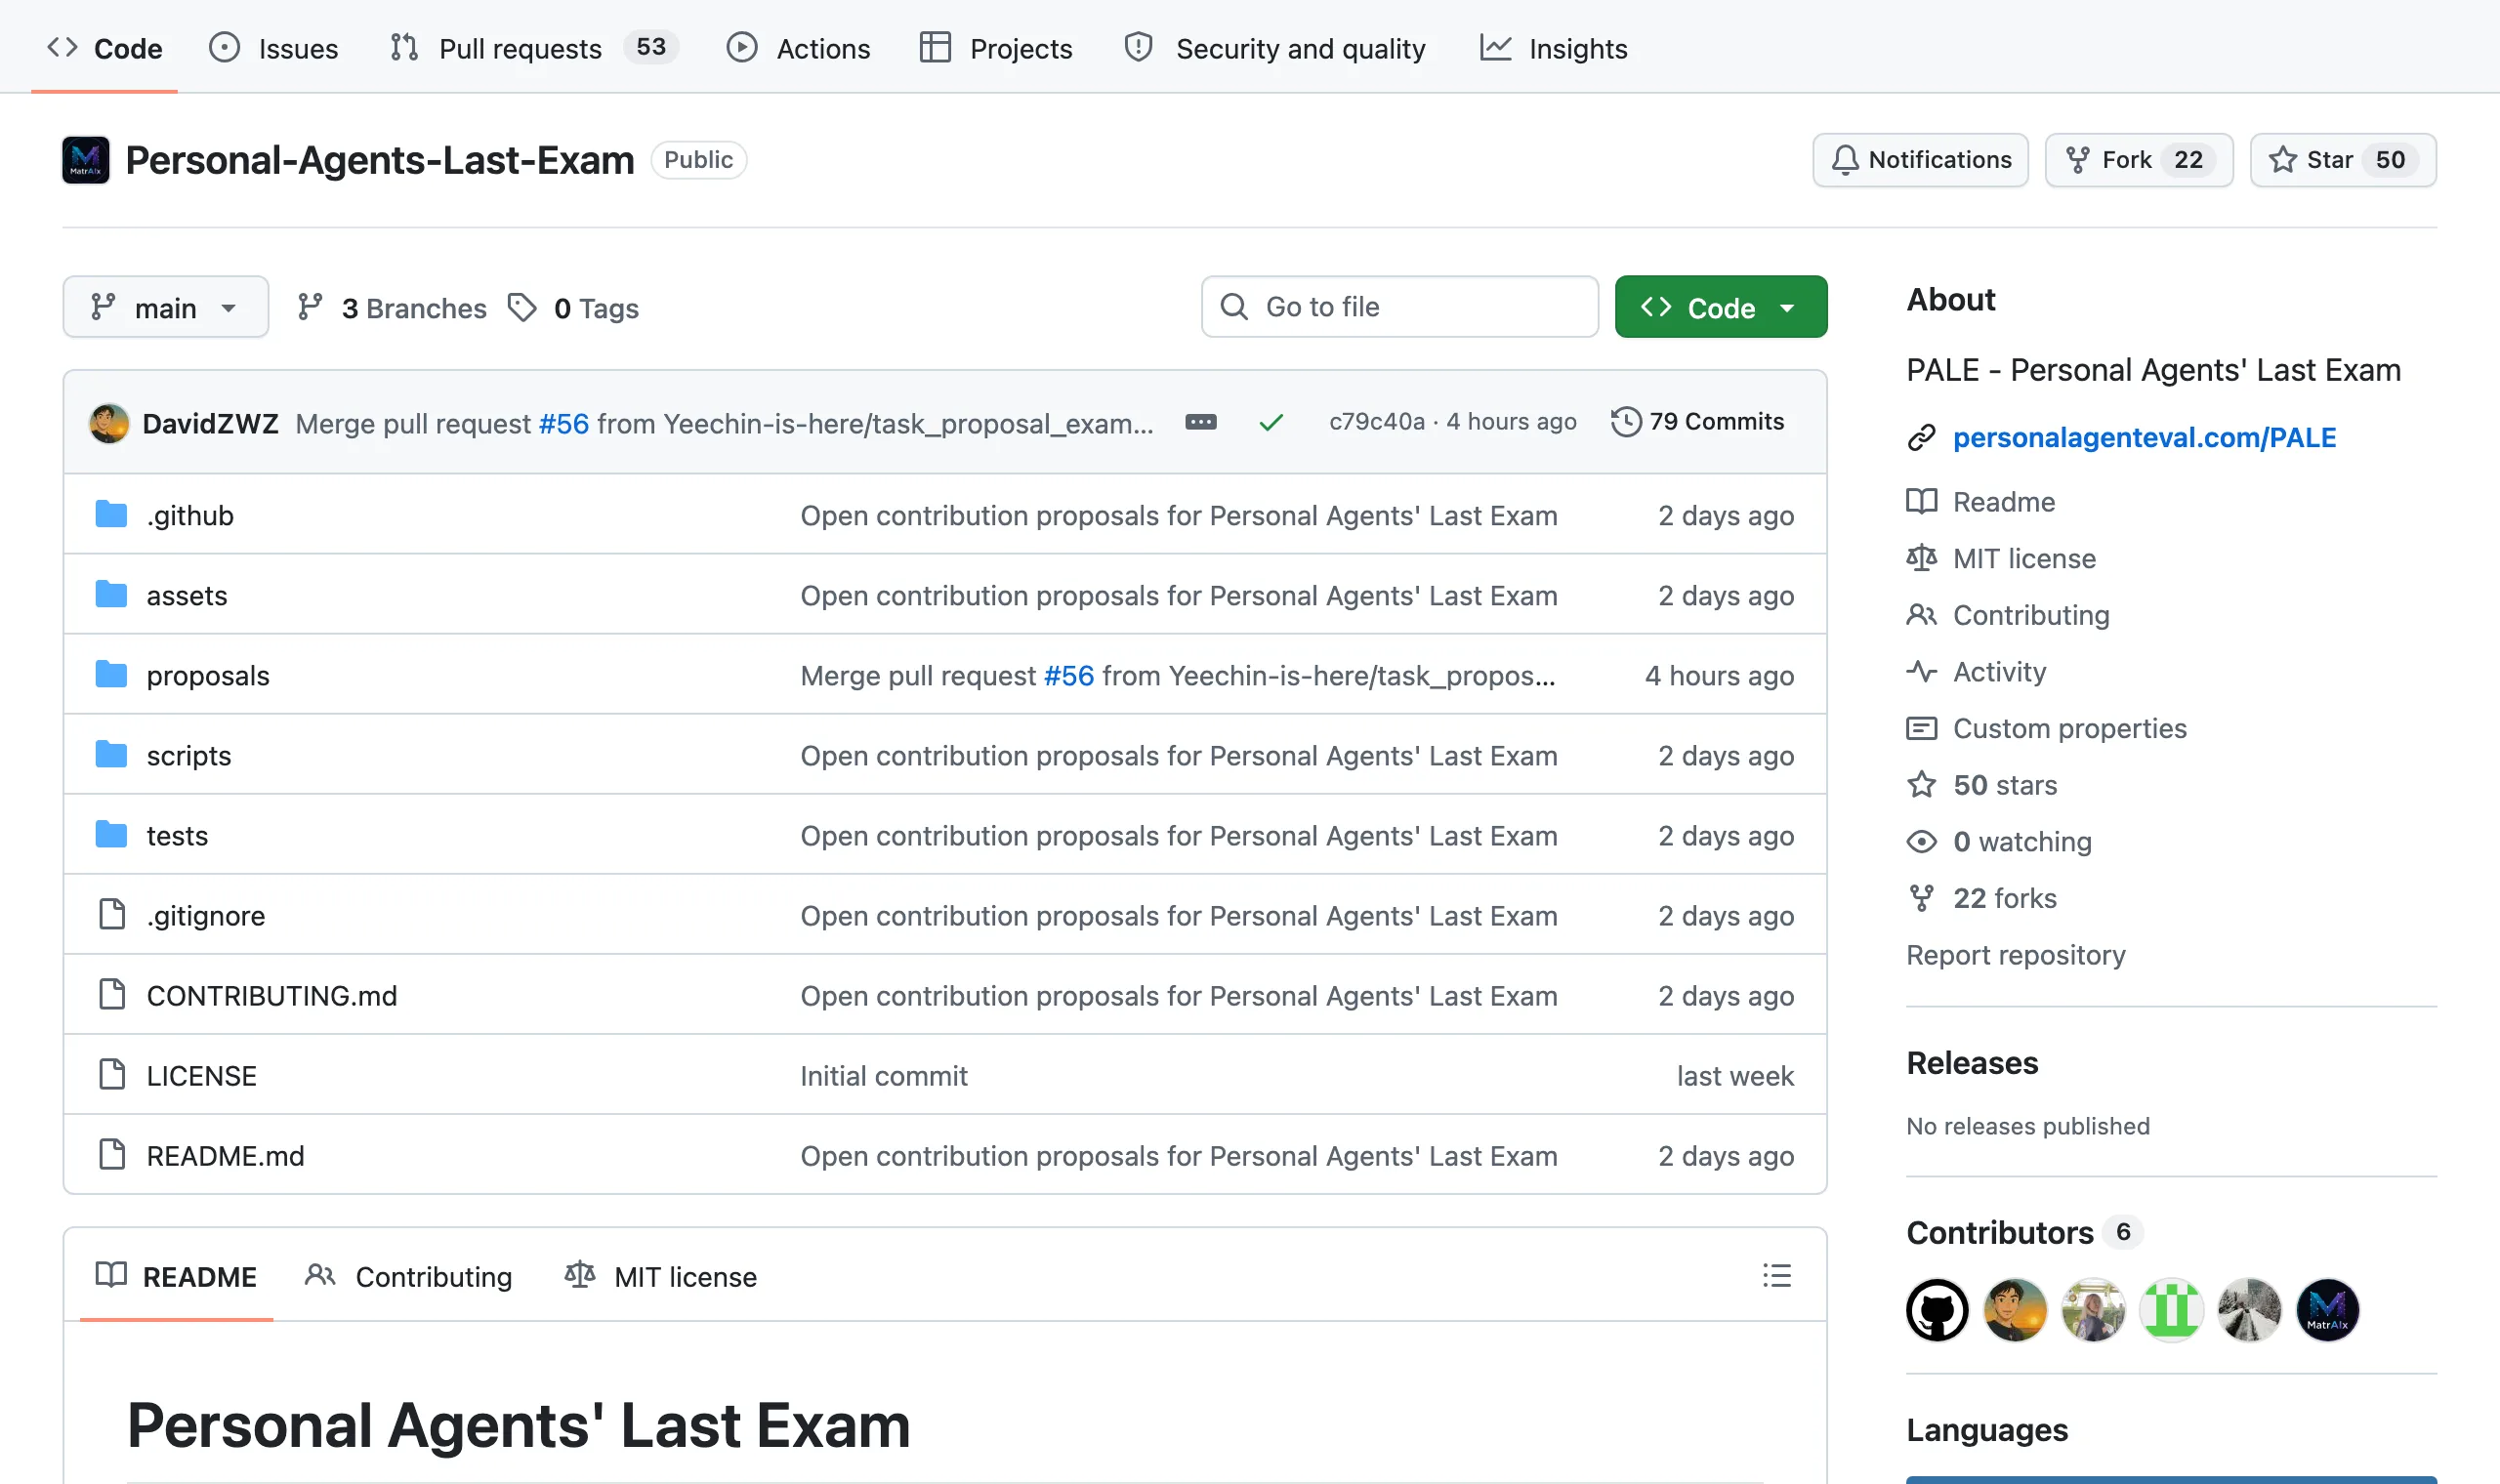
親自把倉庫 clone 下來看,現階段能得到什麼?答案是規格與模板,而不是考場。截至 11 月 17 日,整個 repo 只有 16 個檔案:README、貢獻指南(CONTRIBUTING.md)、三份提案模板(環境提案、任務提案、PR 摘要)、一份名為 Lena Spring Gathering 的範例任務、提案清單(proposal-list.md)、兩支 GitHub Actions 工作流程,以及把 PR 自動彙整進清單的同步腳本 scripts/sync_proposals.py 和它的測試。目錄裡找不到評測執行器、任務環境或計分程式的任何一行程式碼;README 也直說基礎設施「即將釋出」。
MatrAIx 官網的研究牆同樣誠實:PALE 卡片的結果欄全部是 Results pending 與六個 To be announced 佔位。同一面牆上,閉源前版 PersonalAgentEval 已經列出六款代理產品的解決率,從 Instinct 的 60.5% 排到 Gemini Spark 的 25.7%。這組數字屬於閉源前版,跟剛開源的 PALE 是兩回事,看到「MatrAIx 評測」字樣的截圖時值得多看一眼出處。
官網的呈現方式也把「示範」與「評測」分得很開。personalagenteval.com/PALE 頁面用一位虛構使用者 Lena 的十二個月生活,展示代理如何跟著人際、行程與環境變動一路工作,任務時間軸把十二天濃縮成幾秒的動畫;頁面上每個應用介面都標註「公開產品介面參考,非評測 rollout」,明確告訴讀者這些畫面是示意,不是任何模型的實測紀錄。
所以對代理開發者的當下答案很明確:PALE 暫時不能用來跑分或比較模型。它現在的價值是那份把「難」量化成驗收條件的投稿規格,以及已經湧入的數十份環境設計可以當評測參考素材來讀。
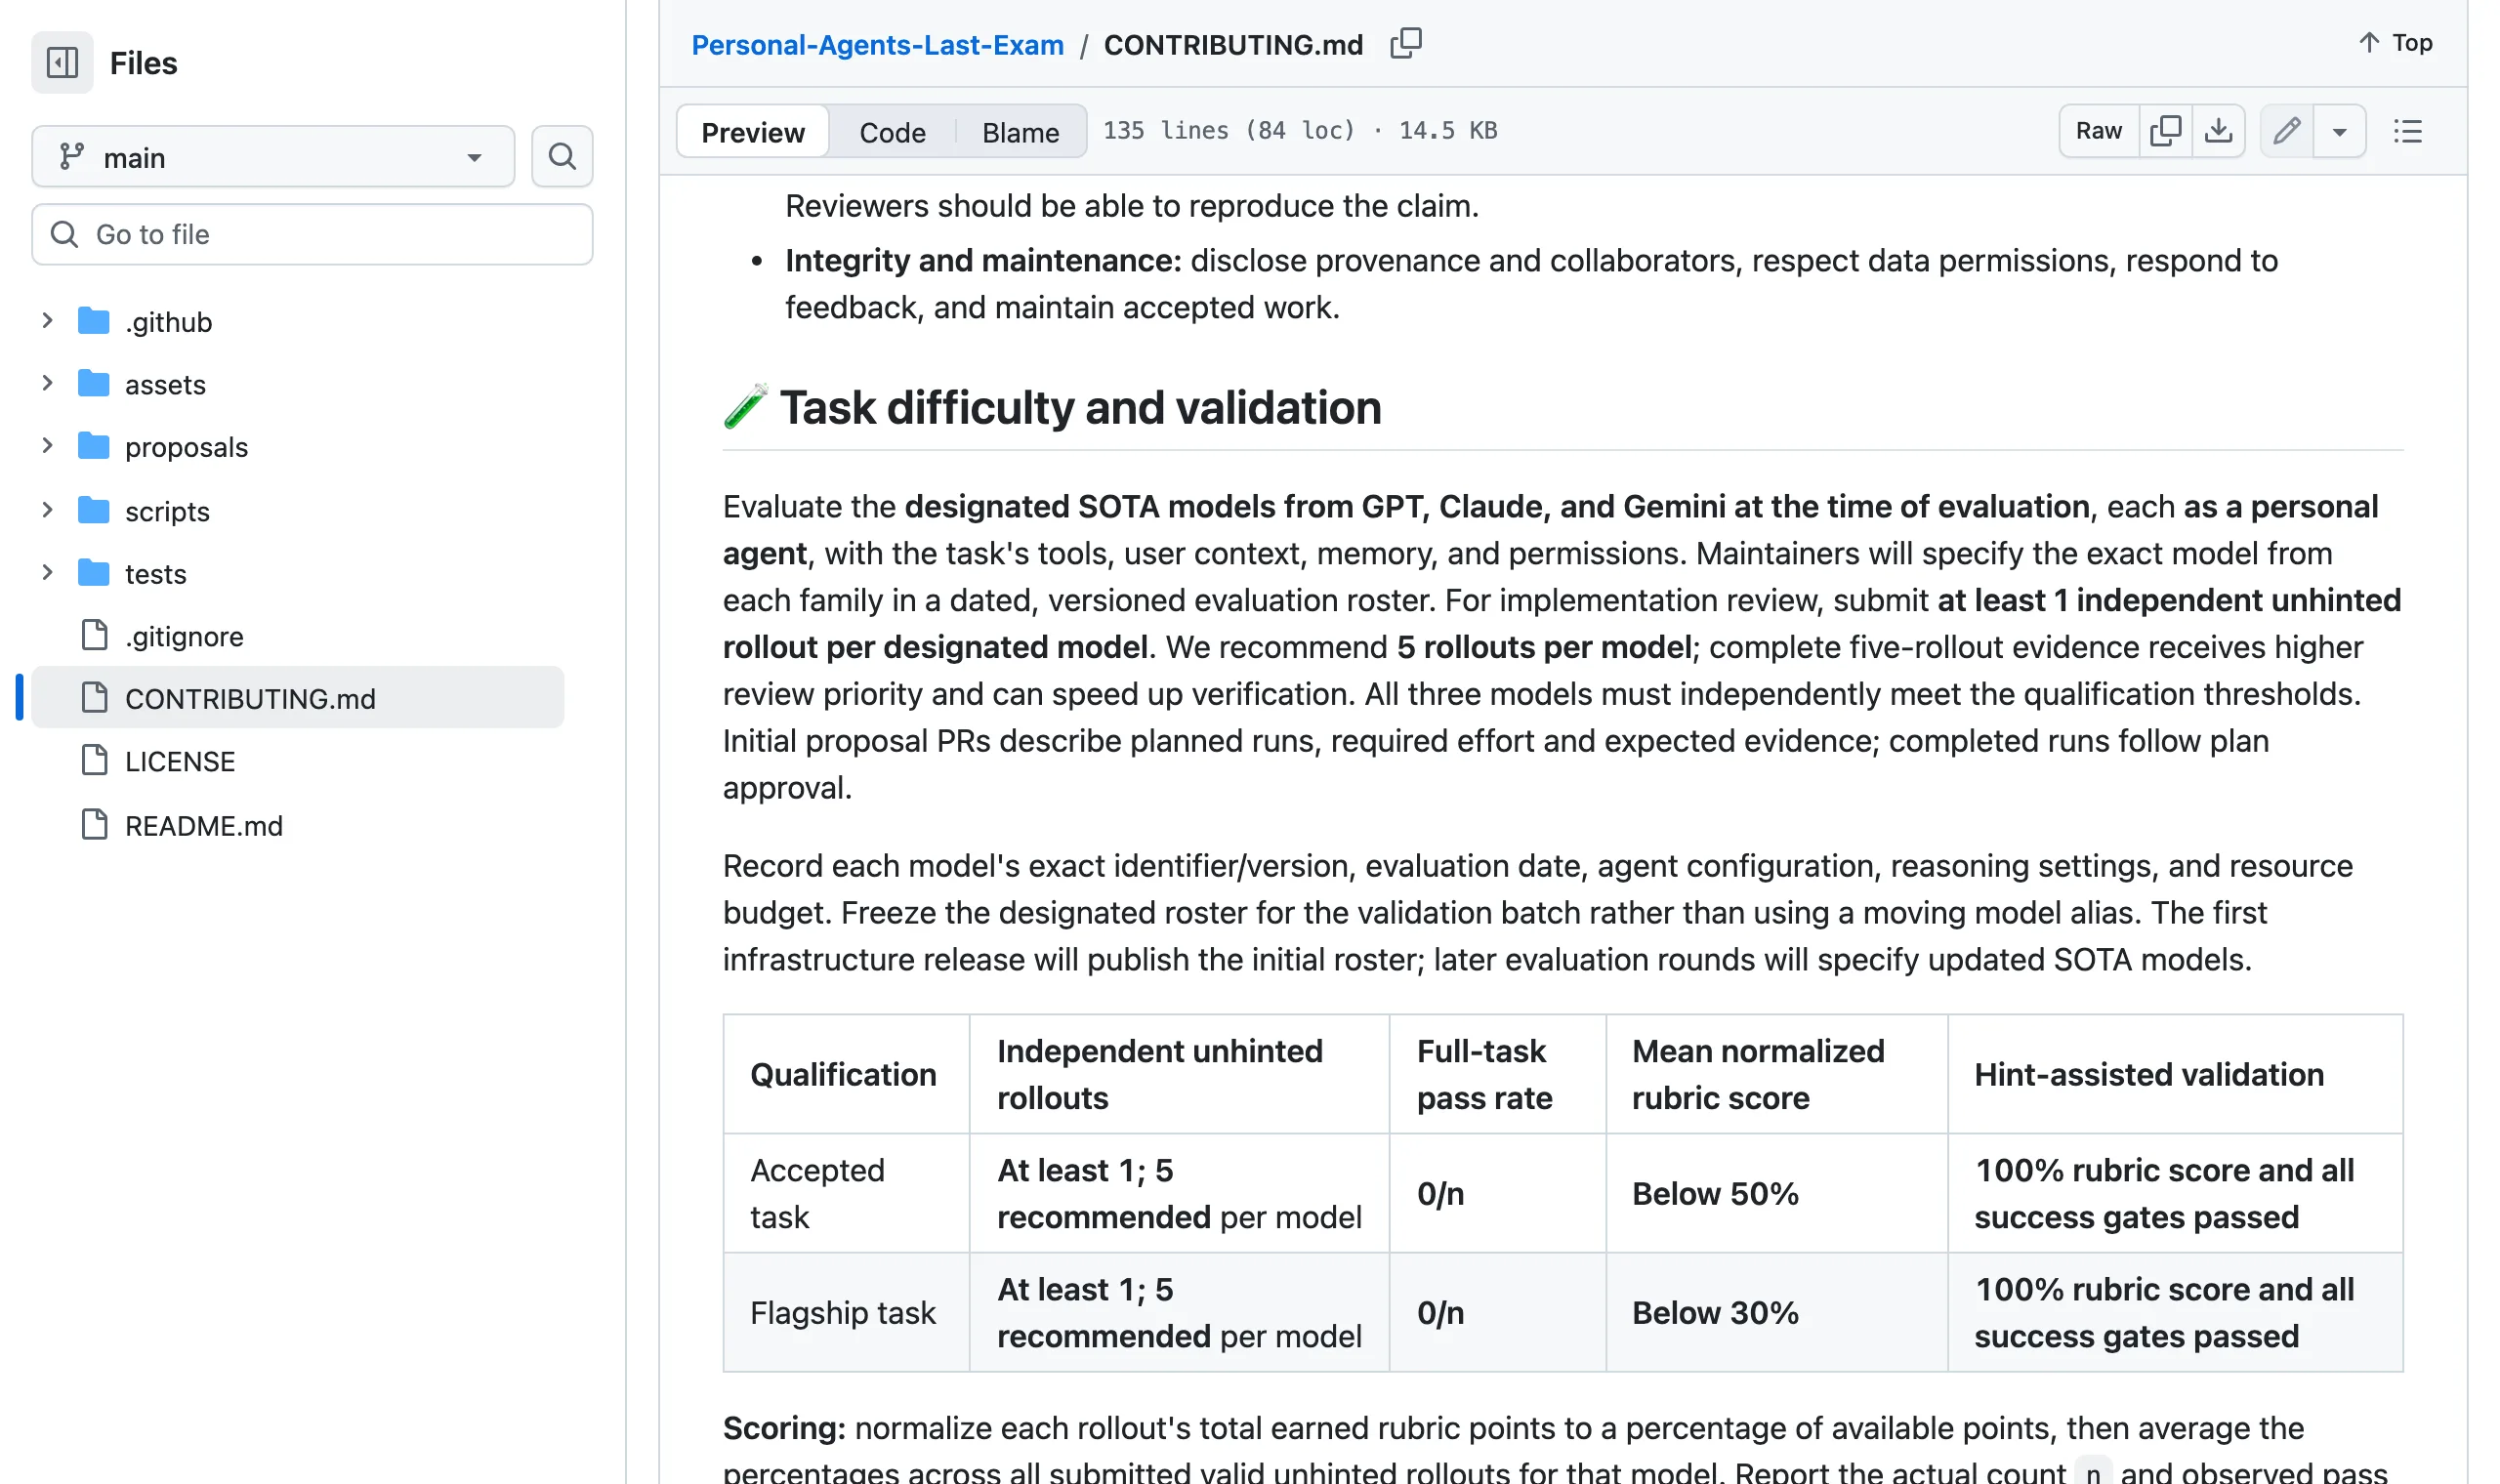
PALE 最有辨識度的設計,是它把投稿題目的難度變成兩道可複驗的門檻,寫進貢獻指南的資格表:
| 資格 | 無提示獨立實測 | 全任務通過率 | 平均正規化 rubric 分數 | 提示輔助驗證 |
|---|---|---|---|---|
| 一般題目 | 每模型至少 1 次,建議 5 次 | 0/n | 低於 50% | 100% 且通過所有成功閘門 |
| 旗艦題目 | 每模型至少 1 次,建議 5 次 | 0/n | 低於 30% | 100% 且通過所有成功閘門 |
幾個名詞值得先講清楚。Rollout(推演軌跡)指讓某個模型在模擬環境中從頭到尾完整跑完一次任務的執行紀錄,包含每一次工具呼叫、對話與最終狀態。「無提示」(unhinted)就是盲測,模型只拿到使用者會拿到的資訊;「提示輔助」(hint-assisted)則是另跑一版,給代理一段固定、有紀錄的提示,把注意力指向關鍵的個人脈絡或推理步驟。
這兩道門檻合起來才是完整的難度定義。無提示版必須全倒:評測時點自 GPT、Claude、Gemini 三家族各指定一名 SOTA 模型扮演個人代理,三個模型都要獨立達到 0/n 的通過率與低於門檻的平均分數,指南特別強調恰好 50% 或 30% 不算過關,也不得把三個模型的成績合併計算來掩蓋某個模型表現較好。提示輔助版必須全對:拿到提示的代理要達到 100% 並通過所有成功閘門,用來證明題目本身可解、失敗確實源自推理或記憶能力,而非環境工具壞掉。提示不得洩露計分內部或直接給答案,也不計入無提示的實測次數。
防止「事後挑好成績」的規則也寫得很細:跑無提示實測前要先凍結題目、rubric、模型設定與資源預算;每一次軌跡、種子、工具版本、成本與失敗分析都要提交,不能只挑失敗的跑交差;如果設計改了,整批驗證要重跑;基礎設施故障不能拿來當作題目很難的證據。至於讀者最好奇的「到底會考哪些模型」,答案是還沒揭曉:維護者會按評測時點公布逐批凍結的版本化名單(dated, versioned evaluation roster),首份名單將伴隨第一次基礎設施發布出場,之後每一輪換上當時的 SOTA;投稿者則要記錄每個模型的確切識別碼與版本、評測日期、代理設定、推理設定與資源預算,驗證批次內不得改用會漂移的模型別名。
PALE 想測的「個人代理」,難度設定與單輪問答基準明顯不同。環境面畫出 15 個領域:金錢與保險、購物與雜貨、旅遊與通勤、健康與照護、餐飲、社群與社區、居家與水電、公共服務與法律、媒體與娛樂、學習與研究、工作與商務、新聞與資訊、天氣與戶外、遊戲、健身與身心健康,由郵件、行事曆、訊息這類個人應用串接起來。
考驗分三組。理解這個人:從未明說的偏好推論、更新過時的脈絡同時保留過去的承諾、回應情緒線索但不擅自假設使用者內在狀態。行動與協調:尊重隱私與支出上限、判斷此刻該直接動手、先問人還是再等等、協調工作家庭健康旅遊財務之間的相依關係(代理越權時誰要負責,可以對照我們先前對 加州訴 OpenAI 代理控管案 的解析)。在變動環境中演化:介面改版、登入過期、存取被封鎖時仍要完成流程,使用者意圖改變時要重用有效的工作而不是重來。README 給了三個代表性案例:Priya 的例行補貨要對上女兒的過敏、最近的商品召回與托兒所裡已有的庫存;Sofia 的替代班機降在不同機場,代理要顧及已訂的車與伴侶未回的訊息;Wei 的一句處方核准,要觸發兩次對話之前交代的郵購藥與照顧者簡報。
兩軌提案各自要交的東西也不一樣。環境軌提案一個 app 或網站:主要領域與次要領域、代理能用的工作流程與應用連接,加上涵蓋資料資產、交付項目、品質檢查與工作量的施工計畫;任務軌提案一個情境:領域、使用者角色、故事與個人化洞察,同樣要附施工計畫,內容涵蓋使用者情境、脈絡、計分方式、模型 rollout 與工作量。
收件品質標準寫在貢獻指南的驗收條件裡,五條都指向「這是不是一道好題」:難度須來自推理、脈絡、協調或執行,不能出自工具故障或被藏住的需求;要可重現,依賴、種子、事件排程、資源上限與重置行為都要有紀錄;計分要有效,得證明參考解法會過、什麼都不做會不過、常見的錯誤或部分完成會被正確處理;要有獨立證據,審查者要能重現「三個 SOTA 模型全倒」的主張;最後是誠信與維護,揭露出處與協作者、尊重資料授權、持續維護被接受的作品。審查也分兩關:提案審查看領域與構想清不清楚、劇本與洞察夠不夠有說服力、施工計畫可不可以審;實作審查看交付的環境或任務有沒有兌現核准的設計、重置與參考解法能不能動、軌跡可不可以重現。
這套設計對應的正是長週期任務(long-horizon)評測的核心假設:世界會在任務進行中改變。人、計畫、權限與環境都會變,代理必須把歷史記憶與最新證據對齊,在多個應用之間協調,並決定何時行動、何時發問、何時等待。想看 Agent 評測怎麼把不同框架的執行紀錄放上同一把尺的讀者,可以參考我們先前對 AWS 開源 UAEF 評測框架的解析,兩者走的路線不同但面對的是同類問題。
徵題機制的動員速度超出一般開源專案的日常。逐行清點提案清單:從 11 月 16 日 01:49 UTC 第一件提案,到 11 月 17 日 09:00 UTC 最後一件,約 31 小時內累積 53 案,環境軌 28 案、任務軌 25 案,出自 17 個不同的 GitHub 帳號。狀態分佈是 49 案設計審查中、3 案已關閉、1 案草稿,沒有任何一件走完「提案、核准、實作、驗證、合併」的全流程。倉庫全部 PR(含基礎倉庫作業)共 61 件,stars 50 顆、fork 22 個(11 月 17 日快照)。
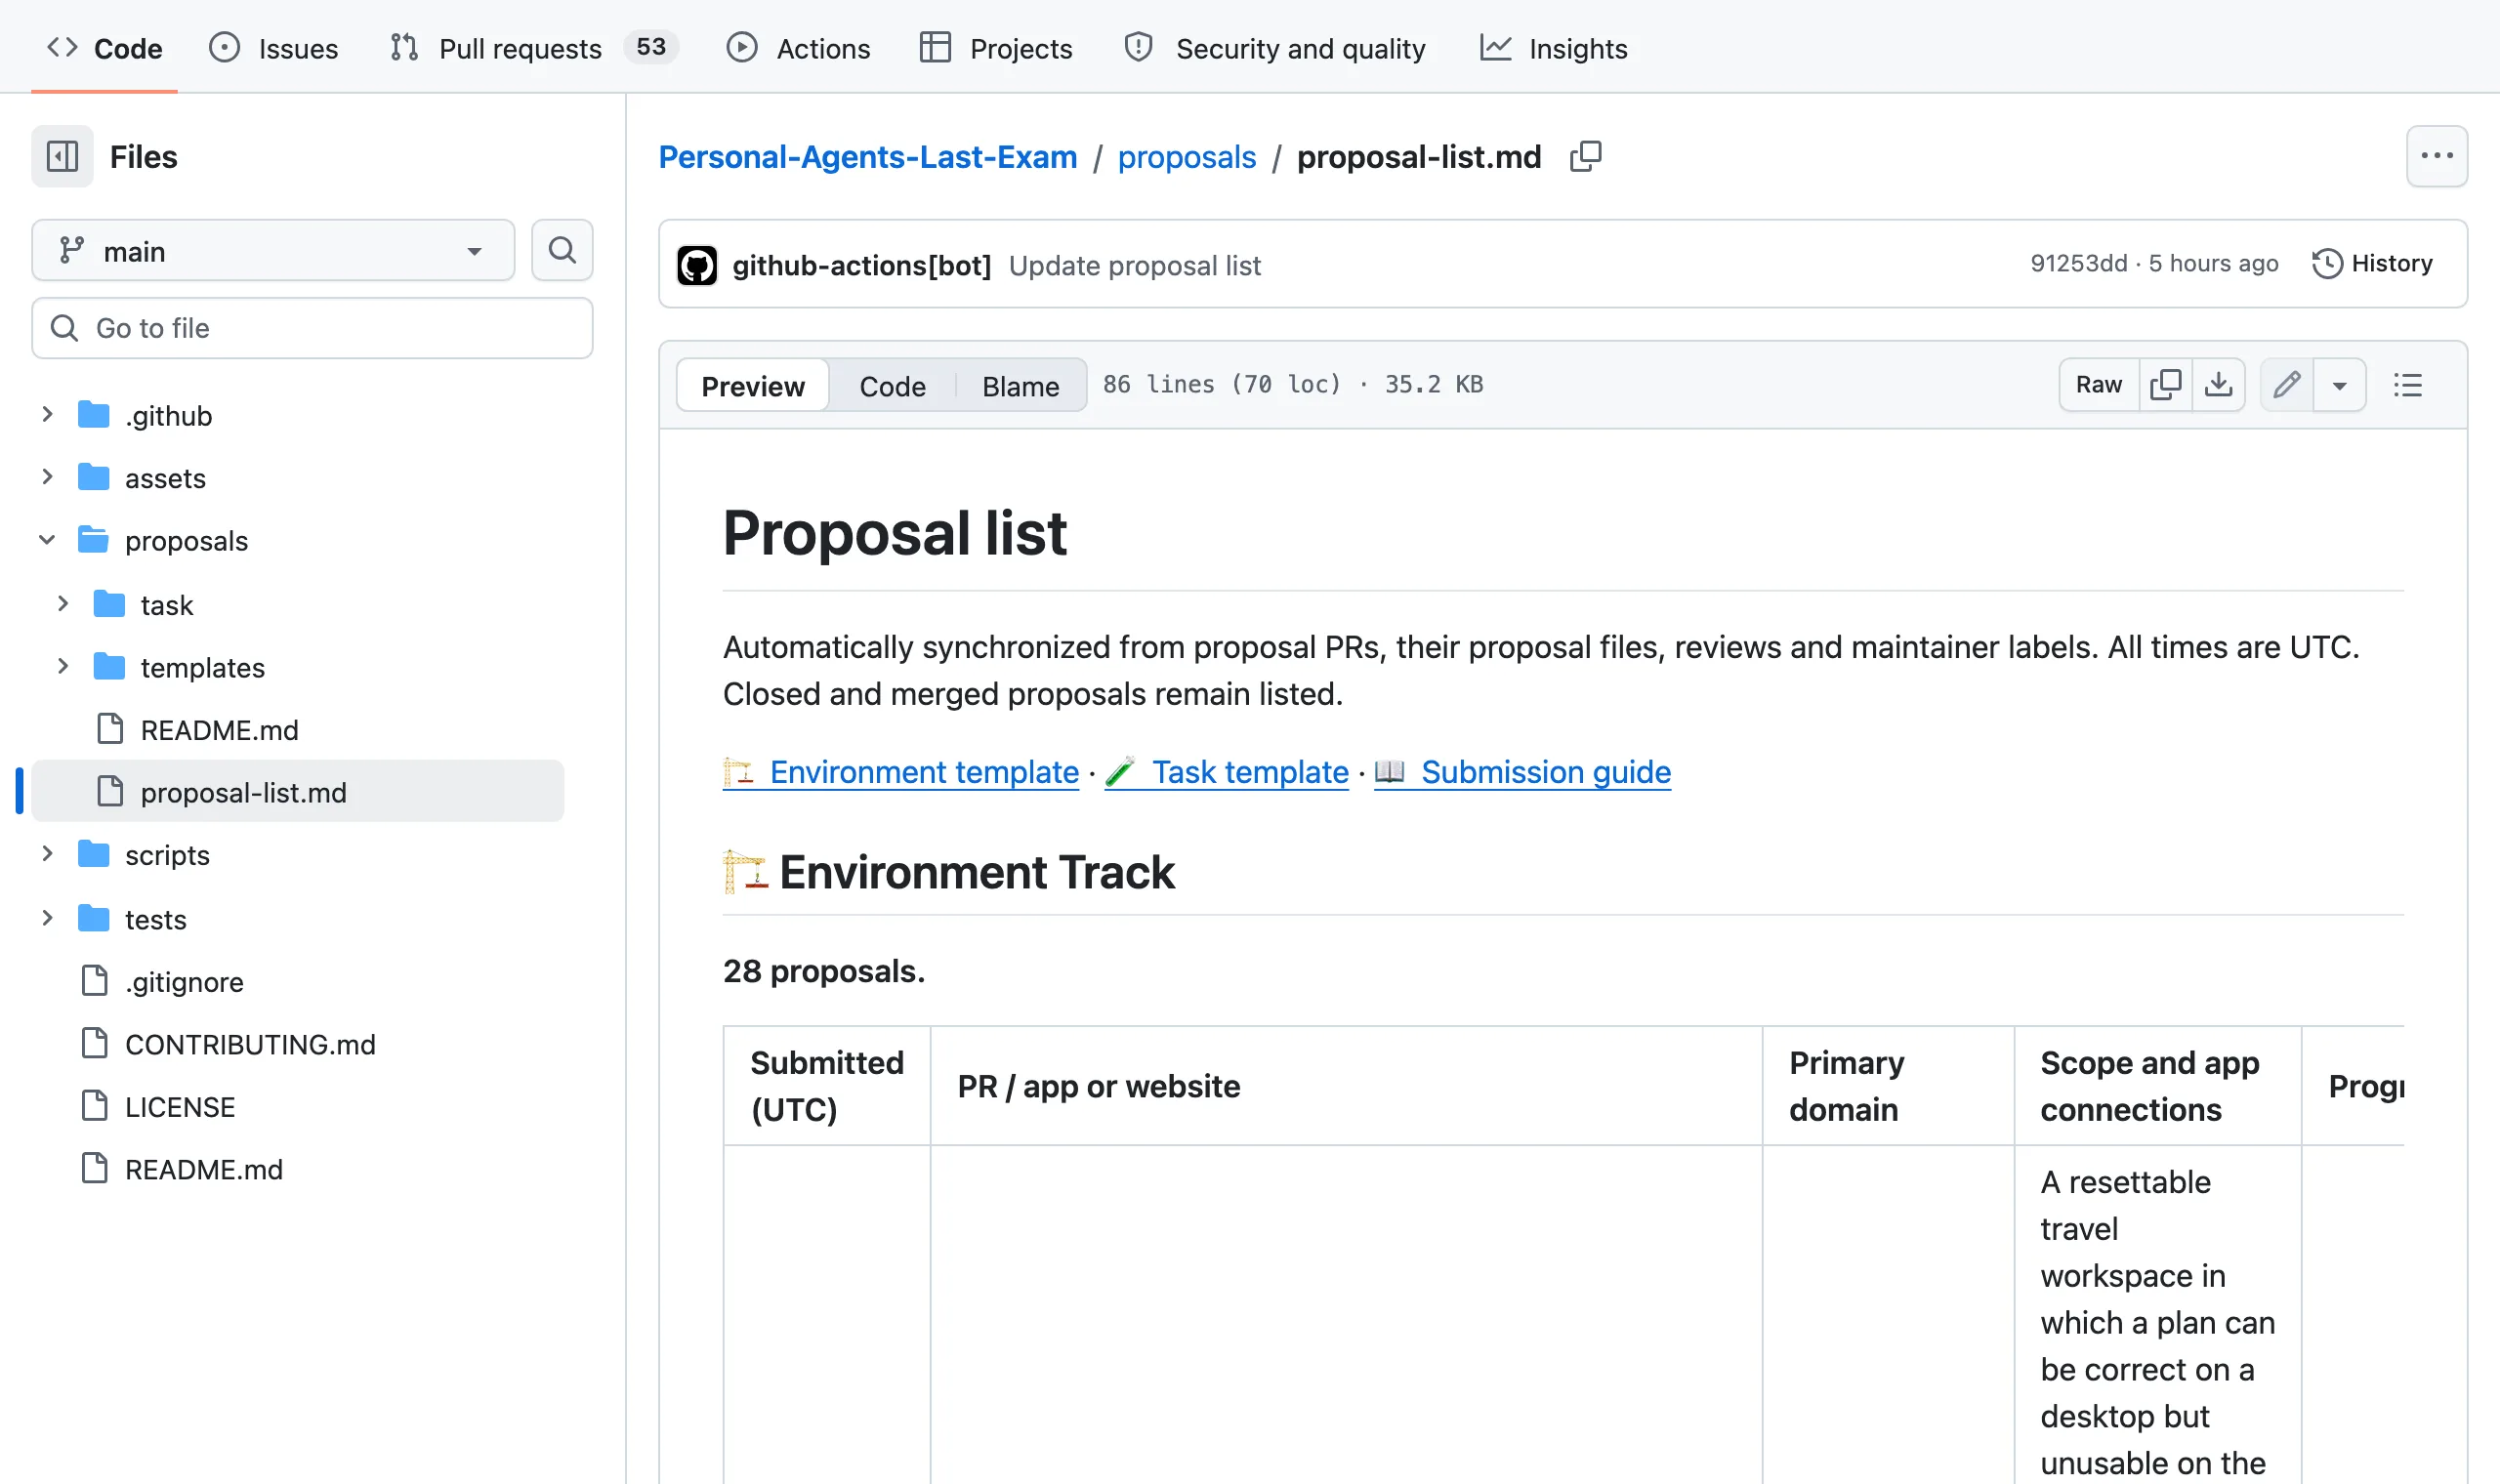
挑一件看得出設計意圖的例子:11 月 17 日的環境提案 TrailPocket 是一個獨立品牌的合成旅遊工作區,賣點在於同一份行程計畫在桌機上正確、換到旅人的手機上卻可能不可用,六個檢視畫面串起行程、區域交通資訊、現場觀察與可下載的行程手冊。任務軌的題目名稱則更像一句生活難題,例如「在時刻表對不上山路時保住一日健行」、「在手機失去訊號後讓博物館語音導覽仍可用」、「用累積中的點數訂週年旅行而不動到還在賺取的點數」。
環境提案的主流蓋法很一致:獨立品牌的合成 app,可重置,並註明以哪個真實服務為公開互動參考。雜貨配送參考 Instacart、社群活動參考 Meetup、演出票務參考 Ticketmaster 的轉票指南、租屋搜尋參考 Zillow Rentals、通行費帳戶參考 E-ZPass;也有提案以開源專案為參考藍本,例如文件管理 Paperless-ngx 與家庭自動化 Home Assistant。這個模式讓任務在可控環境裡可重複驗證,同時不必碰真實服務的條款與資料。
背後的驅動力之一是共同作者權。PALE 明定首篇論文的共同作者門檻:3 個不同的被接受任務,或 3 個不同的被接受環境,而且要附上貢獻文件、維護、失敗分析與實質的論文參與,不是丟個 PR 就算數。流程是提案 PR、設計審查、計畫核准後在同一個 PR 裡實作,最後驗證合併,只有驗證合併的貢獻才被算數。對照常駐代理的設計討論,這種把信任、記憶與權限變動都納入考題的取徑,與業界 讓代理長時間待命的設計討論 是同一條問題軸線。
分流來看。評測研究者與代理開發團隊:現在能把 PALE 當規格書讀,特別是雙門檻、名單凍結與軌跡提交那幾段,比多數基準的文件更具體;但在基礎設施釋出前,別對外宣稱用 PALE 評過任何模型。想貢獻的開發者:首份模型名單與基礎設施發布前是提交提案的時機,初期提案只需描述計畫中的實測、工作量與預期證據,計畫核准後才補完整驗證批次。一般使用者與採購端:這是新聞不是產品更新,現階段沒有需要採取的動作。
還沒確定的事照樣列清楚。基礎設施與首份模型名單沒有公布時間表,「即將釋出」是 README 原文。53 件提案尚無任何一件通過設計審查或合併(其中 6 案已收到審查意見),最終收錄率可能很低。MatrAIx 自述其先前相關研究獲 Nature 投稿邀請與多篇 NeurIPS 2026 錄取,並稱協作對象涵蓋 Stanford、MIT、Harvard 等校研究者、諾貝爾獎得主與 OpenAI、Anthropic、Google DeepMind 的研究人員;這些是 MatrAIx 在 README 的單方面自述,可當背景脈絡,不宜當成品質保證。stars 與提案數都是動態數字(本文快照為 11 月 17 日)。
回查點設在兩處:第一次基礎設施發布(首份模型名單隨之出場,投稿規則可能從「描述計畫」轉為「附完整實測」),以及首批提案進入實作與合併階段時。到時候 PALE 會從徵題公告變成真正的考場,那才是判斷這個基準能不能立住的時刻。