TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

TechMoon 精選圖|Langford 離職與 Recycler、FBT 兩篇論文對照。
微軟研究院 AI Frontiers 共同創辦人 John Langford 證實離職,並在 X 稱 ByteDance 的 Recycler 就是 FBT、只差不重要的細節。他的部落格、推文與兩篇論文原文對得上時間軸,但「兩倍大」在論文裡是三種不同單位的數字,成本減半也還沒有實測支撐。
用 AI 摘要這篇文章:
微軟研究院 AI Frontiers 共同創辦人 John Langford,11 月 6 日在一篇名為「The End of AI Frontiers」的部落格文章裡證實離開微軟。三天前,他在 X 上寫下這陣子被轉傳最多的一句話:ByteDance 發表的 Recycler,就是他共同署名的 Full Bandwidth Transformer(FBT),差別只在不重要的細節。
這句話確實出自他本人,但流傳版本把它講成了另一個故事:資深科學家的研究連被認真考慮都沒有,接著 ByteDance 發表了「同一個想法」。回到文件本身會看到三件事。時間軸比懶人包完整得多,從論文發表到離職宣告隔了近三個月。兩篇論文確實共享同一個核心機制,而且 ByteDance 自己在論文裡引用了 FBT、把它稱為同期工作,並列出具體差異。至於「等於兩倍大的模型」「成本減半」這些推論,是把三種單位不同的數字壓縮成一句話,兩篇論文裡都找不到支持成本減半的換算,也還沒有獨立團隊重現過。
把五份第一手文件按時間排開,事件骨架比任何轉述都清楚。
FBT 論文在 2026 年 8 月 9 日以第一版登上 arXiv(編號 2608.08888),八位作者最後一位就是 Langford,前兩位作者的註腳寫明研究是在 Microsoft AI Frontiers 實習期間完成。8 月 17 日,對應的程式碼倉庫在 GitHub 建立,採 MIT 授權。9 月初,AI Frontiers 整個被併入 Microsoft AI;9 月 14 日,實驗室頁面出現更新:「Microsoft Research AI Frontiers is now part of Microsoft AI」。10 月 1 日 FBT 釋出論文第二版,10 月 25 日,ByteDance Seed(Seedream 系列模型的研究團隊)發表 Recycler 論文。
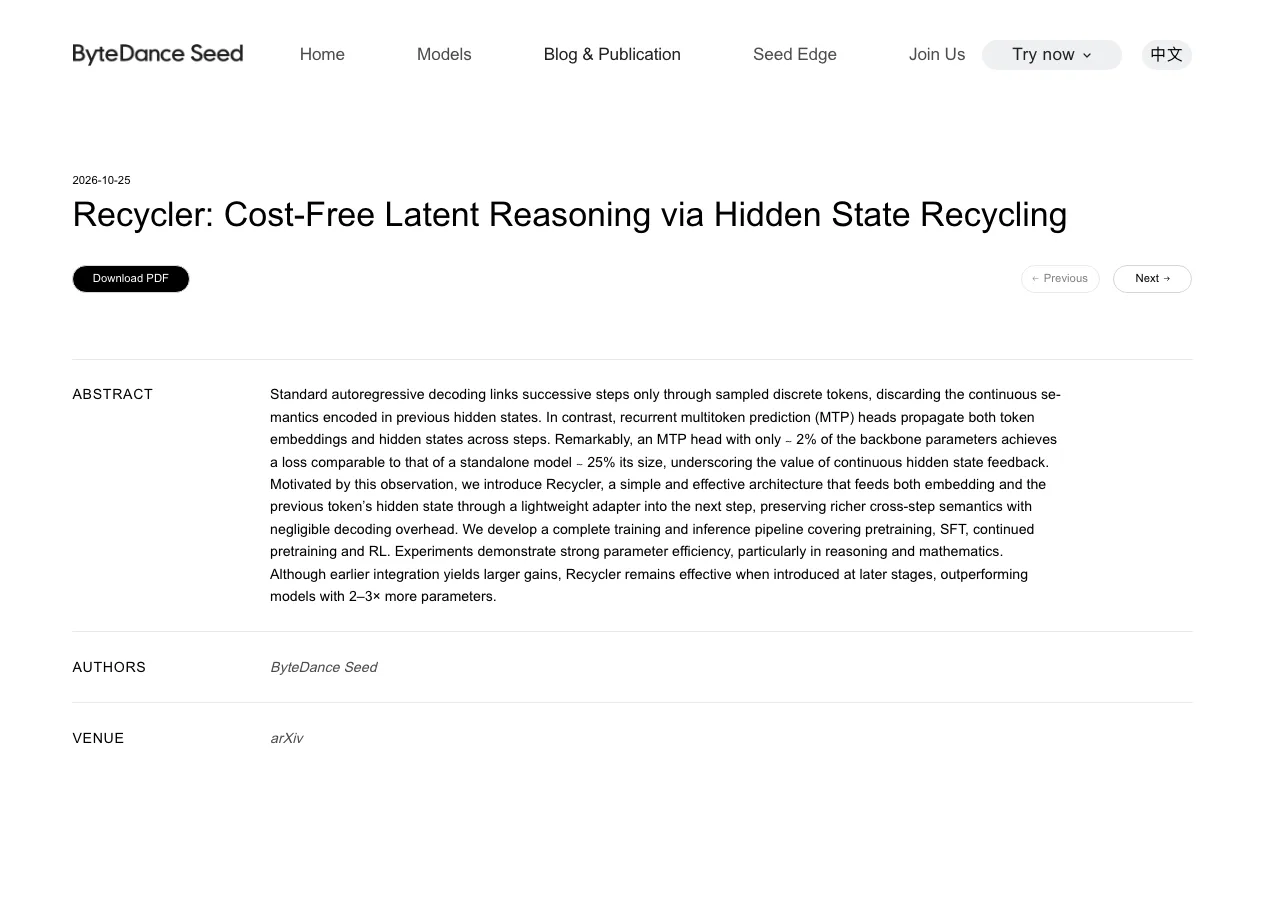
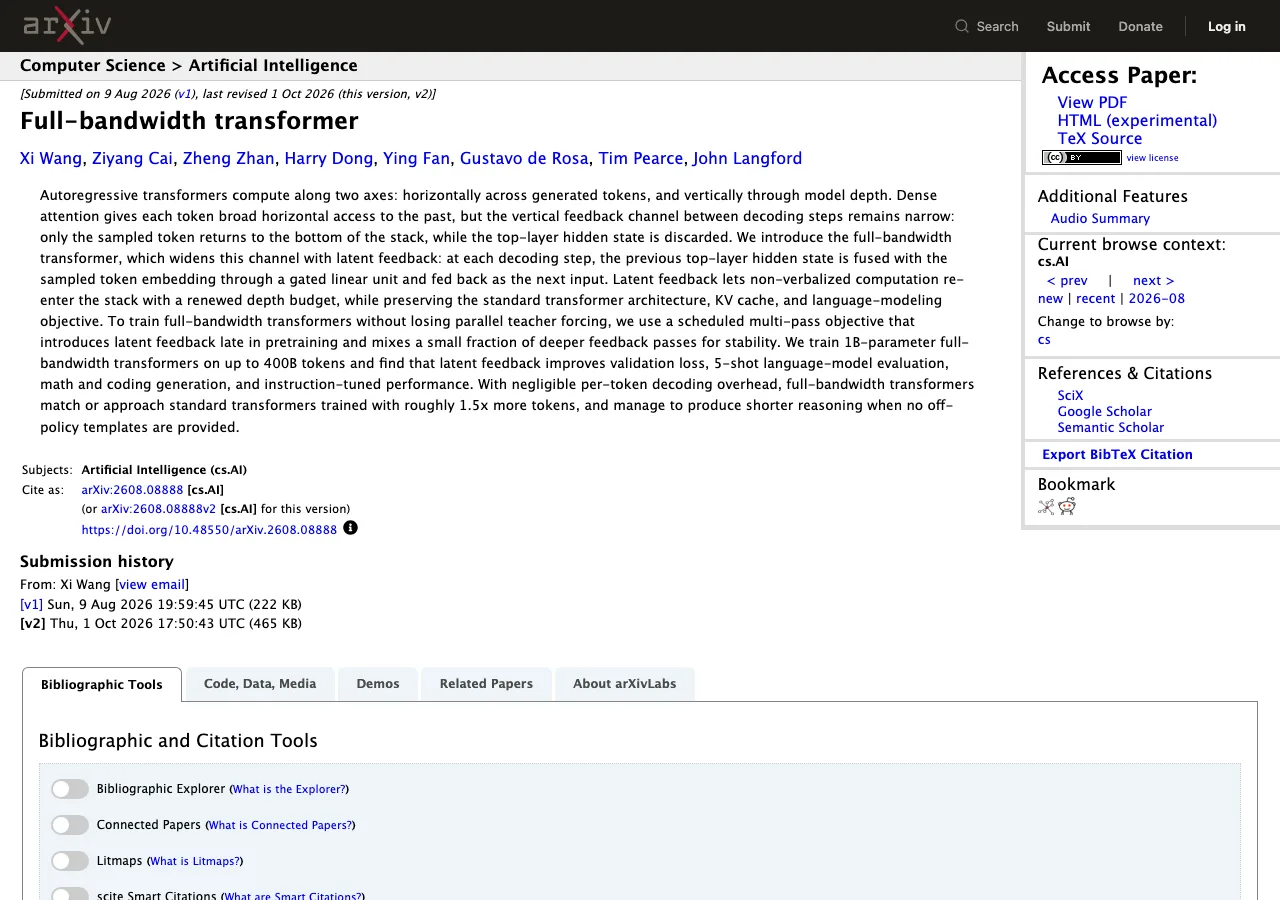
接著是十一月的三步。11 月 3 日深夜(UTC 23:17,台北時間 4 日上午 7:17),Langford 在 X 發文稱 Recycler 是 FBT、「只差在不重要的細節」(up to inessential details),並稱讚 ByteDance 的實驗更完整,結尾寫了「Nice work!」。11 月 6 日(台北時間 7 日凌晨)他發表離職部落格,同日稍晚回覆質疑者時引用了「大 2.4 倍模型」的比較。11 月 13 日(UTC)Windows Latest 報導離職消息並註明微軟沒有公開回應;11 月 15 日另一個帳號把事件重新包裝成「資深微軟 AI 科學家離職,然後 ByteDance 發表了他稱為同一個想法的成果」,這則二手貼文才讓整件事在部落格發表九天後再度擴散。
還有一個引用時容易踩坑的細節:截至 11 月 17 日,FBT 在 arXiv 用編號或標題都查得到,Recycler 用標題和關鍵詞檢索則完全沒有結果,目前唯一的版本掛在 ByteDance Seed 自己的出版頁,PDF 內頁標注日期 10 月 25 日。要引用 Recycler,來源得寫 Seed 出版頁,寫 arXiv 會查不到。
「The End of AI Frontiers」是 Langford 的第一手敘述,不是微軟的官方說法,讀的時候要先分清這一層。
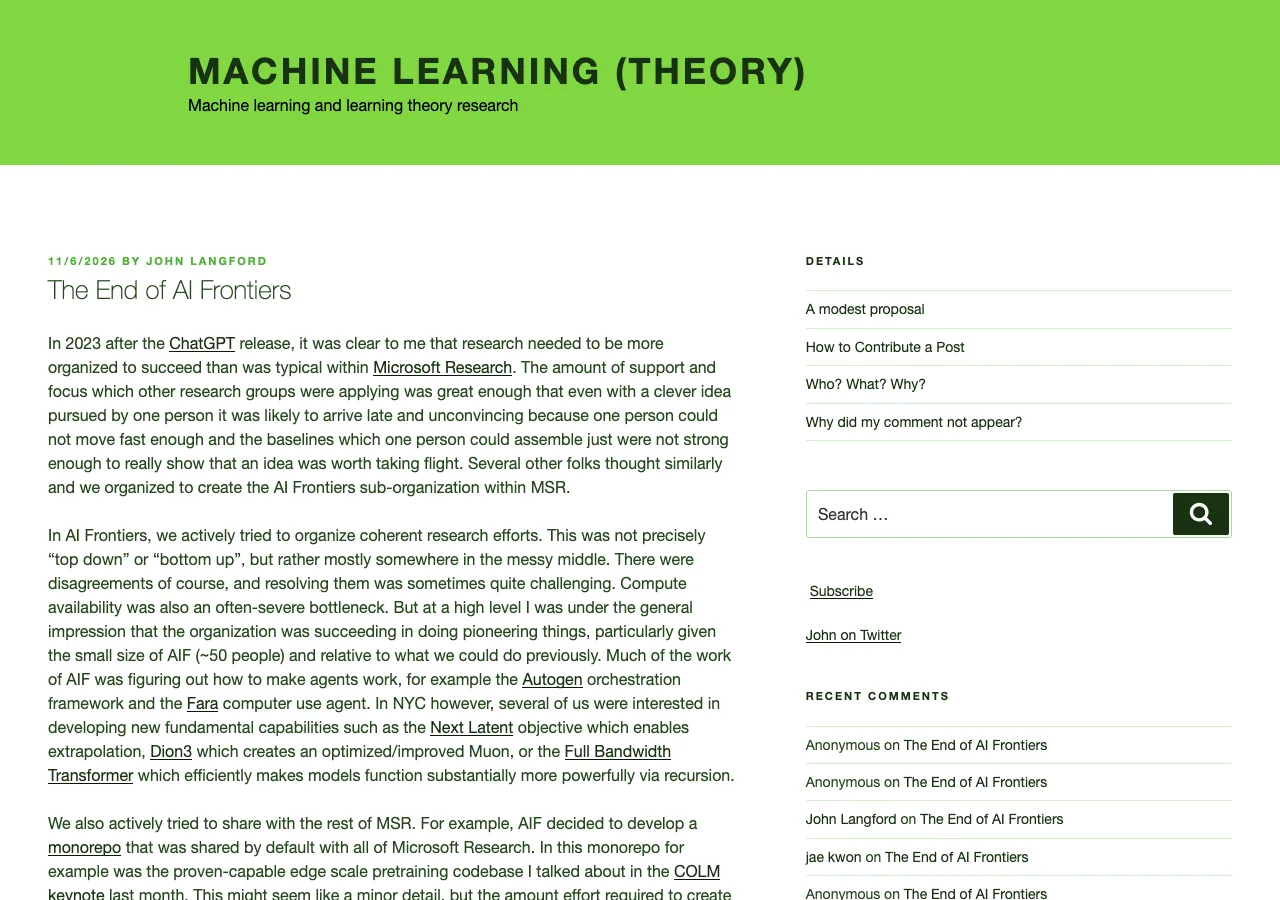
他寫道,AI Frontiers 是 2023 年 ChatGPT 發布後,他與幾位同事在微軟研究院內部創立的子組織,規模約 50 人,做過的東西包括 AutoGen 編排框架與 Fara 電腦操作代理,紐約團隊則發展包括 FBT 在內的基礎能力研究。2026 年 9 月初團隊被併入 Microsoft AI。他認為這個合併表面上合理,實際上領導層(他形容為 ex-Inflection 出身、以擴大規模為核心哲學的團隊)與研究的取向不相容,原文寫得相當直接:「The core philosophy there is scaling, and aggressively not research」,而且「有足夠跡象顯示他們並不真的想要我們」。
離開的經過本身寫得很平淡:安置好自己的團隊成員之後離開,其他創始領導成員「似乎也得出相近結論」。他沒有寫下一站去哪裡,也預告明年不會有 AI Frontiers 的實習生名額。
至於為什麼不回微軟研究院,他給了兩個理由。其一,他不願待在一個「研究沒有通往實際使用的路」的公司,並說自己在 Microsoft AI 期間「沒能讓創新進入使用,甚至很難被認真考慮」,原文用的正是後來被媒體拿去當標題的「no path to real use」。其二,他擔心微軟研究院「做好研究就會有好事發生」的基本約定已經失效,因為團隊是在沒有共識的情況下被整併掉的。
部落格提到 ByteDance 的位置值得注意:不是控訴,而是拿來證明「研究的回報是真實的」。他寫 ByteDance 的實驗顯示 FBT 的變體可能與兩倍大的模型相當,若成立,同樣能力的訓練與推論成本都會大幅下降,接著反問:在一個投資金額接近一兆美元的產業,把訓練與推論成本砍半值多少錢。「成本減半」這四個字就是從這個反問句來的,它是 Langford 的推論,不是任何論文的實測數字。
微軟方面能查到的公開文字,只有 AI Frontiers 頁面上那則 9 月 14 日的更新:實驗室已成為 Microsoft AI 的一部分,會在新的組織裡延續代理與模型研究,頁面也列出 Phi 模型家族、AutoGen、Fara、Magentic 系列等歷年成果。這段文字與 Langford 的部落格描述的是同一次併購的不同層面:官方說研究會延續,Langford 說他眼中的團隊已經結束。兩種說法並存,目前沒有仲裁,微軟也沒有針對他的評價發布任何回應。
另外要把範圍講清楚:Langford 寫的是 AI Frontiers 的結束,微軟研究院本身持續運作,雙方文字都沒有說整個研究院關閉。
要判斷「像不像」,得先知道這兩篇論文在做什麼。概念不難,用一個比喻就能講完。
語言模型生成文字的方式是一個詞元接一個詞元(詞元是模型處理文字的基本單位,約略是一個字或字的一部分;架構背景可以看我們整理過的位置編碼圖解教學)。模型每生成一個詞元,內部會算出一組數字,稱為頂層隱藏狀態,可以想成它對目前上下文的內部理解。標準做法只把挑出來的那個詞元送回下一步當輸入,這組內部理解直接丟棄。用考試來比喻,就像每答完一題只把最後答案抄到下一題,上一題的計算草稿整張丟掉。
兩篇論文做的都是把草稿留下來:把前一個詞元的頂層隱藏狀態與詞元嵌入合併,一起送回模型底部當下一步的輸入。差別在合併的方式。FBT 用閘控線性單元(一種讓模型自己學習取捨的融合層)把兩者融合;Recycler 用輕量轉接器以加法合併。兩篇論文都強調同一個賣點:模型架構與 KV 快取不用改,每個詞元的解碼成本幾乎不變,FBT 原文寫「融合只增加兩個矩陣乘法」,Recycler 則寫解碼成本與 KV 快取佔用與同尺寸標準模型相同。
如果這條路走通,意義在於成本結構:同一水平的表現可以用小一點的模型達成,推論端每個詞元的成本就會下降。這也是為什麼一個架構研究會被講成「省一半成本」的故事。
Recycler 論文在相關工作段落明確引用了 FBT,參考文獻完整列出 FBT 的八位作者與 arXiv 連結。原文寫道:同期工作同樣在做隱藏狀態回收,其中 Full-Bandwidth Transformer 用閘控線性單元把前一個頂層狀態與下一個詞元嵌入融合,而「Recycler 在注入位置上與後者接近,但使用更簡單的加法轉接器,以及依賴解碼時外推的較淺 MTP 式多次傳遞近似」。
換句話說,方向相近這件事是 ByteDance 自己寫的,差異也是他們自己列的。兩篇論文各自寫明的內容整理如下。
| 項目 | Full Bandwidth Transformer | Recycler |
|---|---|---|
| 發表 | arXiv 第一版 2026 年 8 月 9 日,第二版 10 月 1 日 | Seed 出版頁標注 2026 年 10 月 25 日 |
| 出發點 | 拓寬解碼步驟之間的回饋通道 | 觀察到 MTP 頭(約 2% 參數)損失接近約四分之一大小的獨立模型 |
| 合併方式 | 閘控線性單元融合 | 輕量轉接器、加法合併 |
| 訓練做法 | 前 75% 維持單次傳遞,回饋後期引入,混入 3% 三次傳遞批次 | 固定兩次前向傳遞起跳,部分步驟加第三次傳遞 |
| 涵蓋範圍 | 預訓練與微調,1B 參數、最多 400B 詞元 | 預訓練、微調、持續預訓練與強化學習,跨多個模型尺寸 |
| 論文自述的效率 | 與約 1.5 倍詞元訓練的標準模型相當或接近 | 勝過參數多 2 至 3 倍的模型 |
| 程式碼 | 公開倉庫,MIT 授權 | 論文未附官方程式碼連結 |
Langford 說「只差在不重要的細節」,是把合併方式與訓練排程這些差異評為次要;ByteDance 的措辭則是同期工作加差異清單。兩種說法並不必然矛盾,一個強調核心機制相同,一個強調方法細節不同,但哪一種描述更貼近事實,目前沒有第三方的判決依據。
事件裡最容易被壓縮失真的是數字。把所有倍數放回原文,會發現它們的單位根本不同。
FBT 摘要寫的單位是訓練資料:解碼額外成本可忽略的情況下,與用約 1.5 倍詞元訓練的標準模型相當或接近。FBT 導論另有一個更強的版本:讀提示詞的階段跑兩到三次傳遞時,可匹敵用兩倍詞元訓練的基準。Recycler 摘要寫的單位是參數量:勝過參數多 2 至 3 倍的模型。到了 Recycler 正文與 2.4 倍大小基準的實際對照,下游平均分數是 64.76 對 66.43,差距 1.68,接近而沒有超過,論文也明說這三個端點不是等訓練預算的比較。
Langford 部落格寫「兩倍大小」、推文寫 2.4 倍,兩者講的都是模型規模,來源都是 ByteDance 的對照實驗(Recycler 摘要的 2 至 3 倍與正文的 2.4 倍基準);他自己論文裡更強的主張,用的則是「兩倍詞元」這個訓練資料單位。這幾個數字被流傳版本疊在一起之後,變成「FBT 等於兩倍大的模型」,但詞元倍數、參數倍數與基準分數是三種不能互換的單位,任何一種都不等於成本帳。讀加速倍數的宣稱時先確認單位與量測條件,這個原則我們在 Next-Concept Modeling 的 31 倍加速分析也用過:同一個「加速」,牽涉的可能是訓練、推論或端到端時間,口徑不同就不能直接比。
真正的成本推論只有一個出處:Langford 部落格那句反問。把訓練與推論成本「砍半」是他從模型規模比喻推導出來的說法,兩篇論文都沒有提供支持這個比例的成本換算。也出現了公開質疑:輝達資深研究員 Hatamizadeh 在回覆中直接問「兩倍大小從哪來的」,並說 FBT 是推論端的低成本改動,用更多訓練算力換更好的資料利用,「不會讓模型大小或訓練成本減半」。這是第三方意見,但點出的單位問題與論文原文一致。
「解碼不加成本」不等於「訓練免費」,這筆帳兩篇論文都自己算了。
FBT 表 1 把 400B 詞元的訓練排程折算成相當於 512B 或 600B 詞元的計算量,也就是說效率是用訓練端的額外算力換來的;排程上前 75% 維持單次傳遞(因此可以從標準預訓練檢查點接著跑),回饋在後期引入,再混入 3% 的三次傳遞批次,原因是純兩次傳遞訓練出來的遞迴在超過訓練深度後會發散,加入三次傳遞才能穩定。Recycler 寫得更直白:訓練成本是標準模型的 2 倍,起跳配置是兩次前向傳遞,為了解決外推問題再對部分步驟做第三次傳遞,多付 3.3% 訓練成本。論文標題裡的「Cost-Free」指的是解碼(推論)端不增加成本,不是訓練免費。
所以比較公平的讀法是:兩篇論文都在賭同一個方向,用訓練端的額外算力與多 pass 的麻煩,換解碼端成本不變之下的能力提升。至於這筆交換在真實大規模訓練帳上值不值得,論文等級的證據還給不出答案。
到這裡可以確認的:時間軸、兩篇論文的機制與差異、引用關係、各方原文的措辭。還不能確認的,同樣值得列清楚。
兩篇論文的效率數字都是各自團隊的自述,截至 11 月中旬沒有看到獨立團隊的重現結果,FBT 雖然有公開程式碼與 MIT 授權,重現工作也要有人做了才算數。「同一個想法」是 Langford 的單方判斷,ByteDance 只寫了同期工作與差異,從頭到尾沒有任何一方指控誰沿用了誰,Langford 對 Recycler 的公開態度是稱讚,把離職與 ByteDance 的發表連成因果的是 11 月 15 日的二手貼文,不是他的原文。微軟對 Langford 的評價沒有公開回應,併購的內部決策過程也僅有他一方的敘述。另外,Langford 在 11 月 13 日轉述了一個第三方帳號的縮放整理,宣稱這類回饋「用四行程式碼就能以少得多資料達到相同表現」,這是未經同儕審查的第三方說法,他的原話也只說參數越多、每個參數對應訓練資料越多,效益越明顯。
後續值得回查的訊號有四個:微軟是否公開回應、Recycler 是否登上 arXiv 出現正式版本、Langford 的下一個落點、以及有沒有獨立團隊重現任何一組數字。在那之前,這則新聞最穩當的讀法是把四層文件分開擺:他的部落格、他的推文、微軟的官方頁面,以及兩篇論文各自寫下的內容。四層都讀過,能確認什麼、不能確認什麼,界線自然就浮出來了。