TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

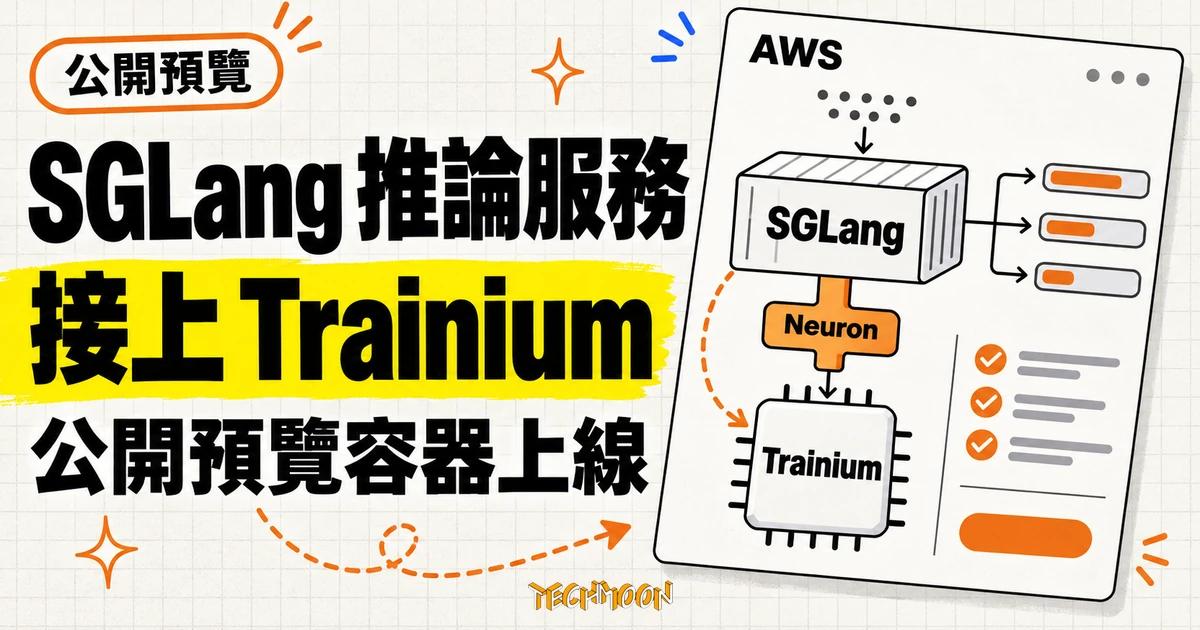
AWS 於 2026 年 11 月 12 日開放 SGLang-Neuron 公開預覽容器 v0.1.0,由 SGLang 背後的 RadixArk 與 Annapurna Labs 合作發布:Trainium3 沿用熟悉的 SGLang 介面服務 GPT-OSS-120B、Qwen3.5-397B-A17B、Kimi-K3 等九個語言模型家族,支援 NIXL 加 EFA 的分離式推論與接流量前的編譯暖機;但核心釘死在 SGLang 修訂 43881a7 與 Neuron SDK 2.33.0,預設貪婪取樣會拒絕未帶溫度的請求,LoRA 與嵌入服務這版全被拒。
用 AI 摘要這篇文章:
2026 年 11 月 12 日,AWS 在機器學習部落格宣布 SGLang-Neuron 公開可用,透過 AWS 深度學習容器(Deep Learning Container)發布,由 SGLang 背後的 RadixArk 團隊與 AWS 的 Annapurna Labs 合作完成。白話講:現在可以用你已經在用的 SGLang 介面,在 AWS 自家的 AI 加速晶片 Trainium 上服務模型、產生強化學習的推論軌跡,應用端呼叫的還是同一套生成 API。
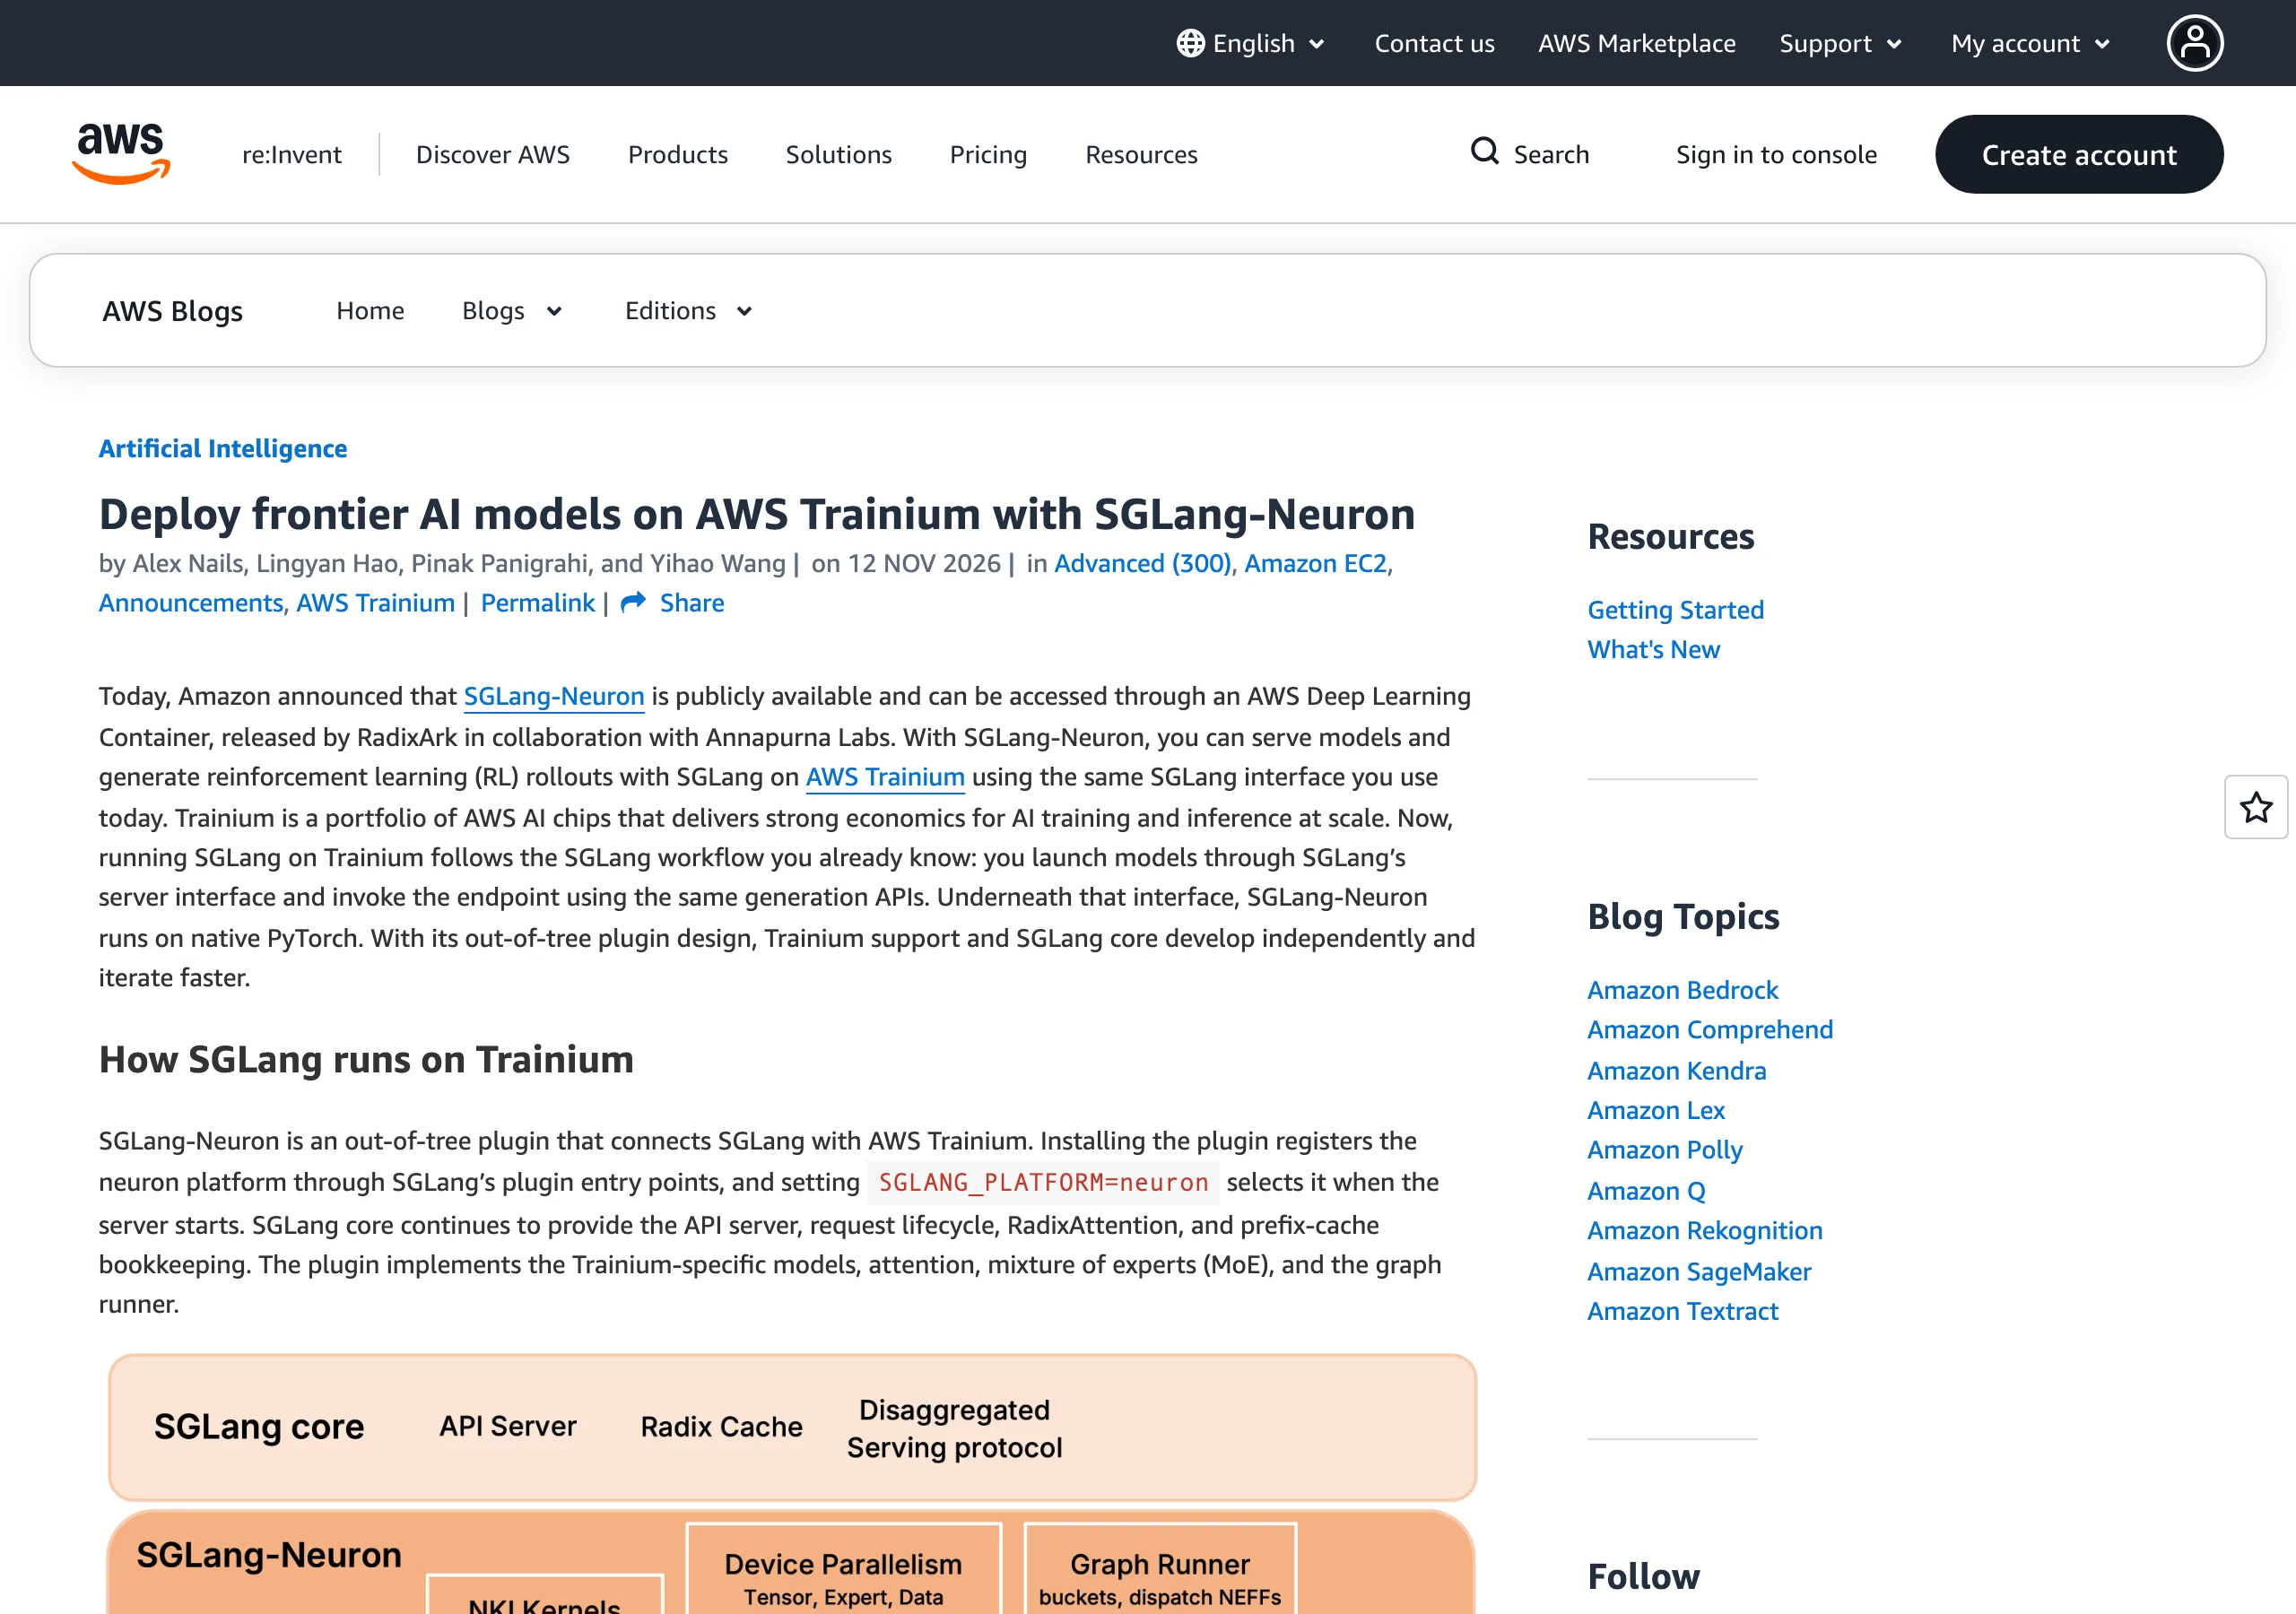
先把可以防守的判斷放在前面。介面沿用的真正價值在上層整合:應用不必重寫呼叫流程、不必換客戶端。但介面之下的執行層是一套全新的契約,核心版本被釘死、取樣預設會拒絕沒帶溫度的請求、伺服器接流量前要先把每個形狀的計算圖編譯暖機完畢、LoRA 與嵌入服務這一整類用途被明確拒絕。把 SGLang 服務搬到 Trainium 的實際工作,就是把這些差異逐一核對;把請求網址換到另一台機器,並不算完成遷移。
兩個名詞先定位。SGLang 是開源的推論服務框架,常用來把大型語言模型包成 API 服務,管理請求排程與前綴快取(把共用開頭的提示算過的部分留著重用);Trainium 是 AWS 自研的 AI 晶片家族,Neuron 則是圍繞它的軟體開發套件。專案自己標明這次是公開預覽:介面、支援模型與功能都還會調整,現階段的組合不該當成長期不變的產品契約。文中行為描述以 AWS 公告與專案官方文件為準,效能與成本數字,官方此次並未提供。
SGLang-Neuron 的定位是一個 out-of-tree 外掛(不在 SGLang 主儲存庫裡的獨立外掛程式)。啟動容器後設定 SGLANG_PLATFORM=neuron,SGLang 就會透過外掛入口點載入它。分工官方畫得很清楚:SGLang 核心繼續負責 API 伺服器、請求生命週期、RadixAttention 與前綴快取的帳務;外掛補上 Trainium 專屬的模型實作、注意力運算、專家混合(MoE)層與圖執行器。
再往下還有一層。TorchNeuron 把 Trainium 註冊成原生的 PyTorch 裝置,模型執行路徑走標準 PyTorch 運算,搭配用 Neuron Kernel Interface(NKI)寫的效能核心,再由 torch.compile 把這些運算編譯成 Neuron 可執行檔(NEFF)。編譯出來的圖對應一個靜態形狀,執行時把每一步補到放得下它的最小形狀,這個設計會一路影響後面講的啟動暖機與快取行為。這種拆法的好處 AWS 講得直接:Trainium 支援與 SGLang 核心可以各自獨立演進,不用等同一個儲存庫慢慢合併。
對遷移者來說,這個分工決定了看問題的位置。請求排不動、排程怪怪的,先查 SGLang 核心那層;模型編譯不過、裝置執行出錯,要查的是外掛與 Neuron 工具鏈那層,兩者的日誌與排查路徑不同。理解責任在哪一層,故障排查才會精確。
README 寫明這個外掛釘死在上游 SGLang 的特定修訂(commit 43881a7),並指定 Neuron SDK 2.33.0。把上游 commit 拿去查,那是 2026 年 11 月 1 日進到 SGLang 主線的修訂,距離公告日只有十一天;而 Neuron SDK 的 2.33.1 已經在 11 月 11 日、也就是公告前一天發布。換句話說,這份容器是一個往前釘住核心、往後落後一個修補版的版本快照。
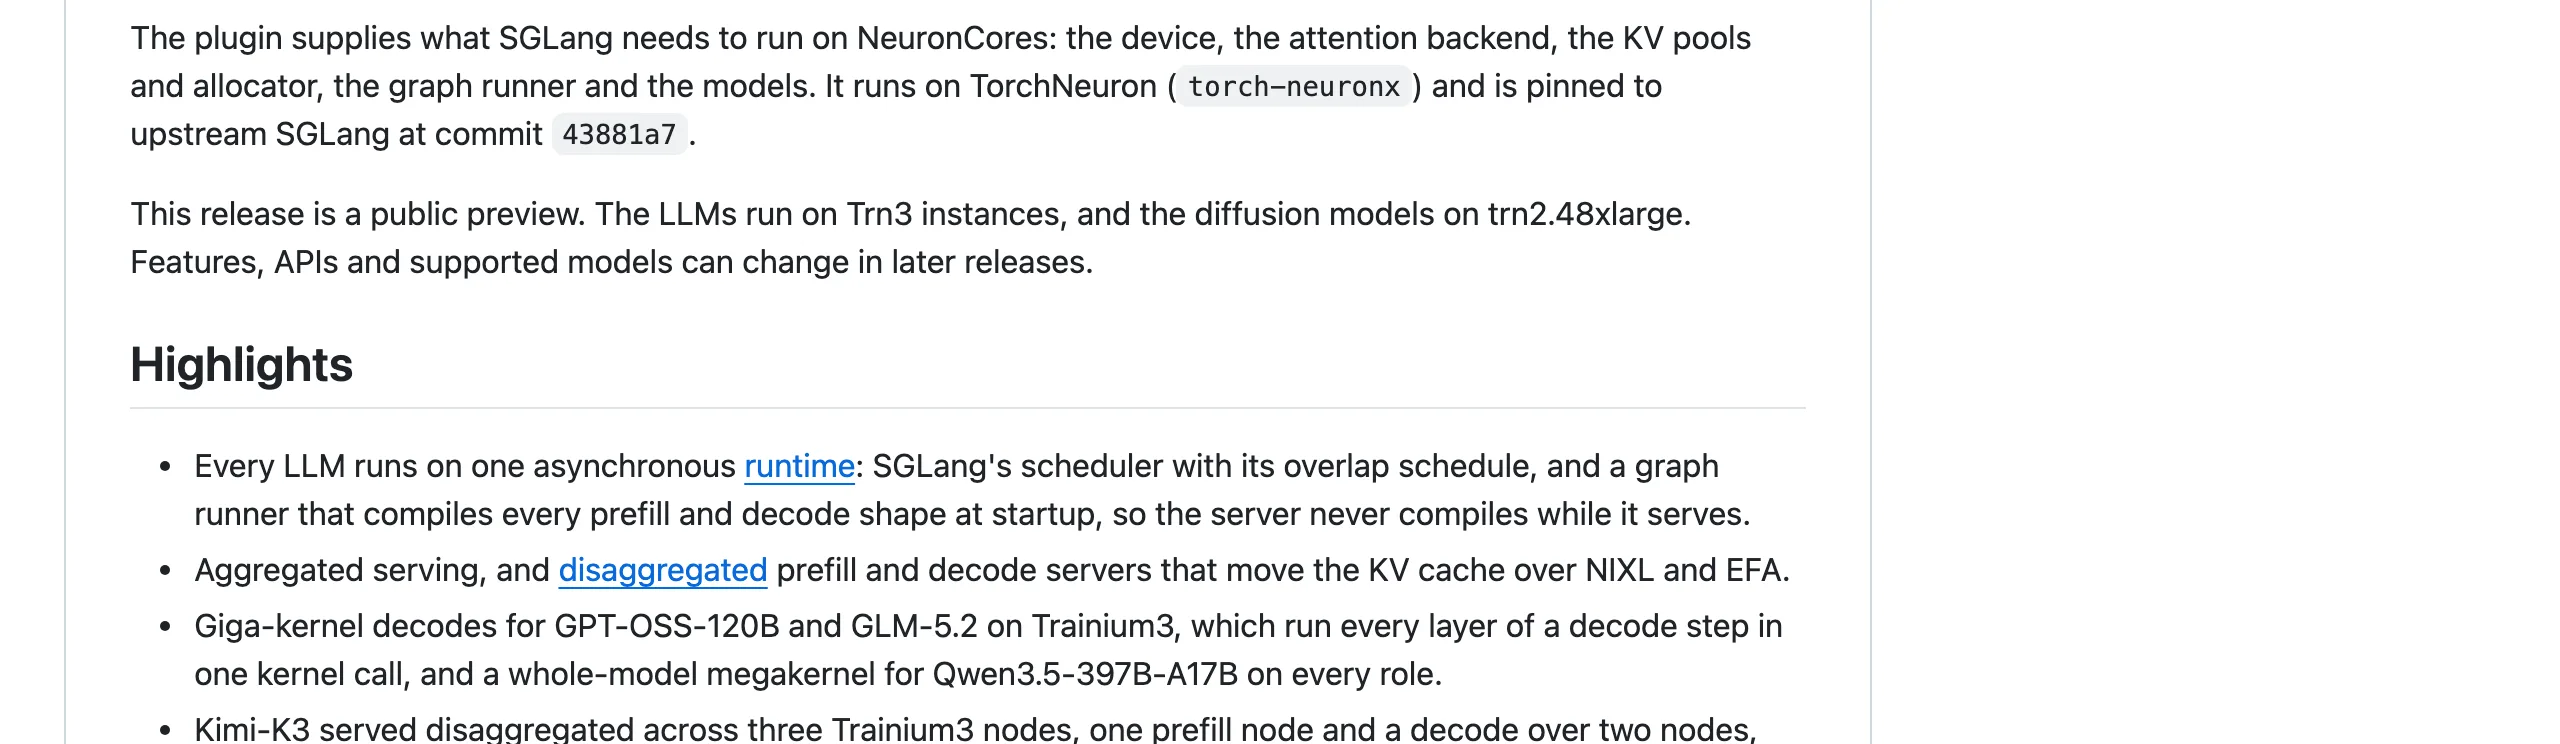
這不是疏失,是設計。原始碼安裝路徑會核對核心版本,不符合的較新修訂同樣可能被拒,避免外掛與框架內部介面對不上。所以「把所有套件升到最新版再說」在這裡是錯誤直覺,對應版本組合才是正確姿勢。容器映像的標籤本身就帶著這份資訊:v0.1.0-neuron-py314-sdk-2.33.0-ubuntu26.04,版本、Python 3.14、SDK 版號、作業系統一次寫清楚;官方文件還提示可用 docker inspect 讀映像標籤,確認外掛修訂、SDK 版本與 SGLang commit。
實務上值得養成的習慣是保存完整環境識別:映像標籤、SGLang 修訂、SDK 版本、模型檔版本與啟動旗標。日後任何一項換掉,就知道要重驗哪些東西,免得只剩「用了 SGLang」這種無法重建的描述。
文件裡最容易被既有應用踩到的一條:預設取樣模式是裝置端的貪婪取樣(每一步都選當下機率最高的文字單位),在這個模式下,每個請求都必須明確帶上 temperature=0 或 top_k=1,其他請求一律在進場檢查(admission)階段被拒絕,包括那些完全沒設溫度的請求。省略參數在 GPU 版 SGLang 上通常沒事,在這裡會直接收到拒絕。
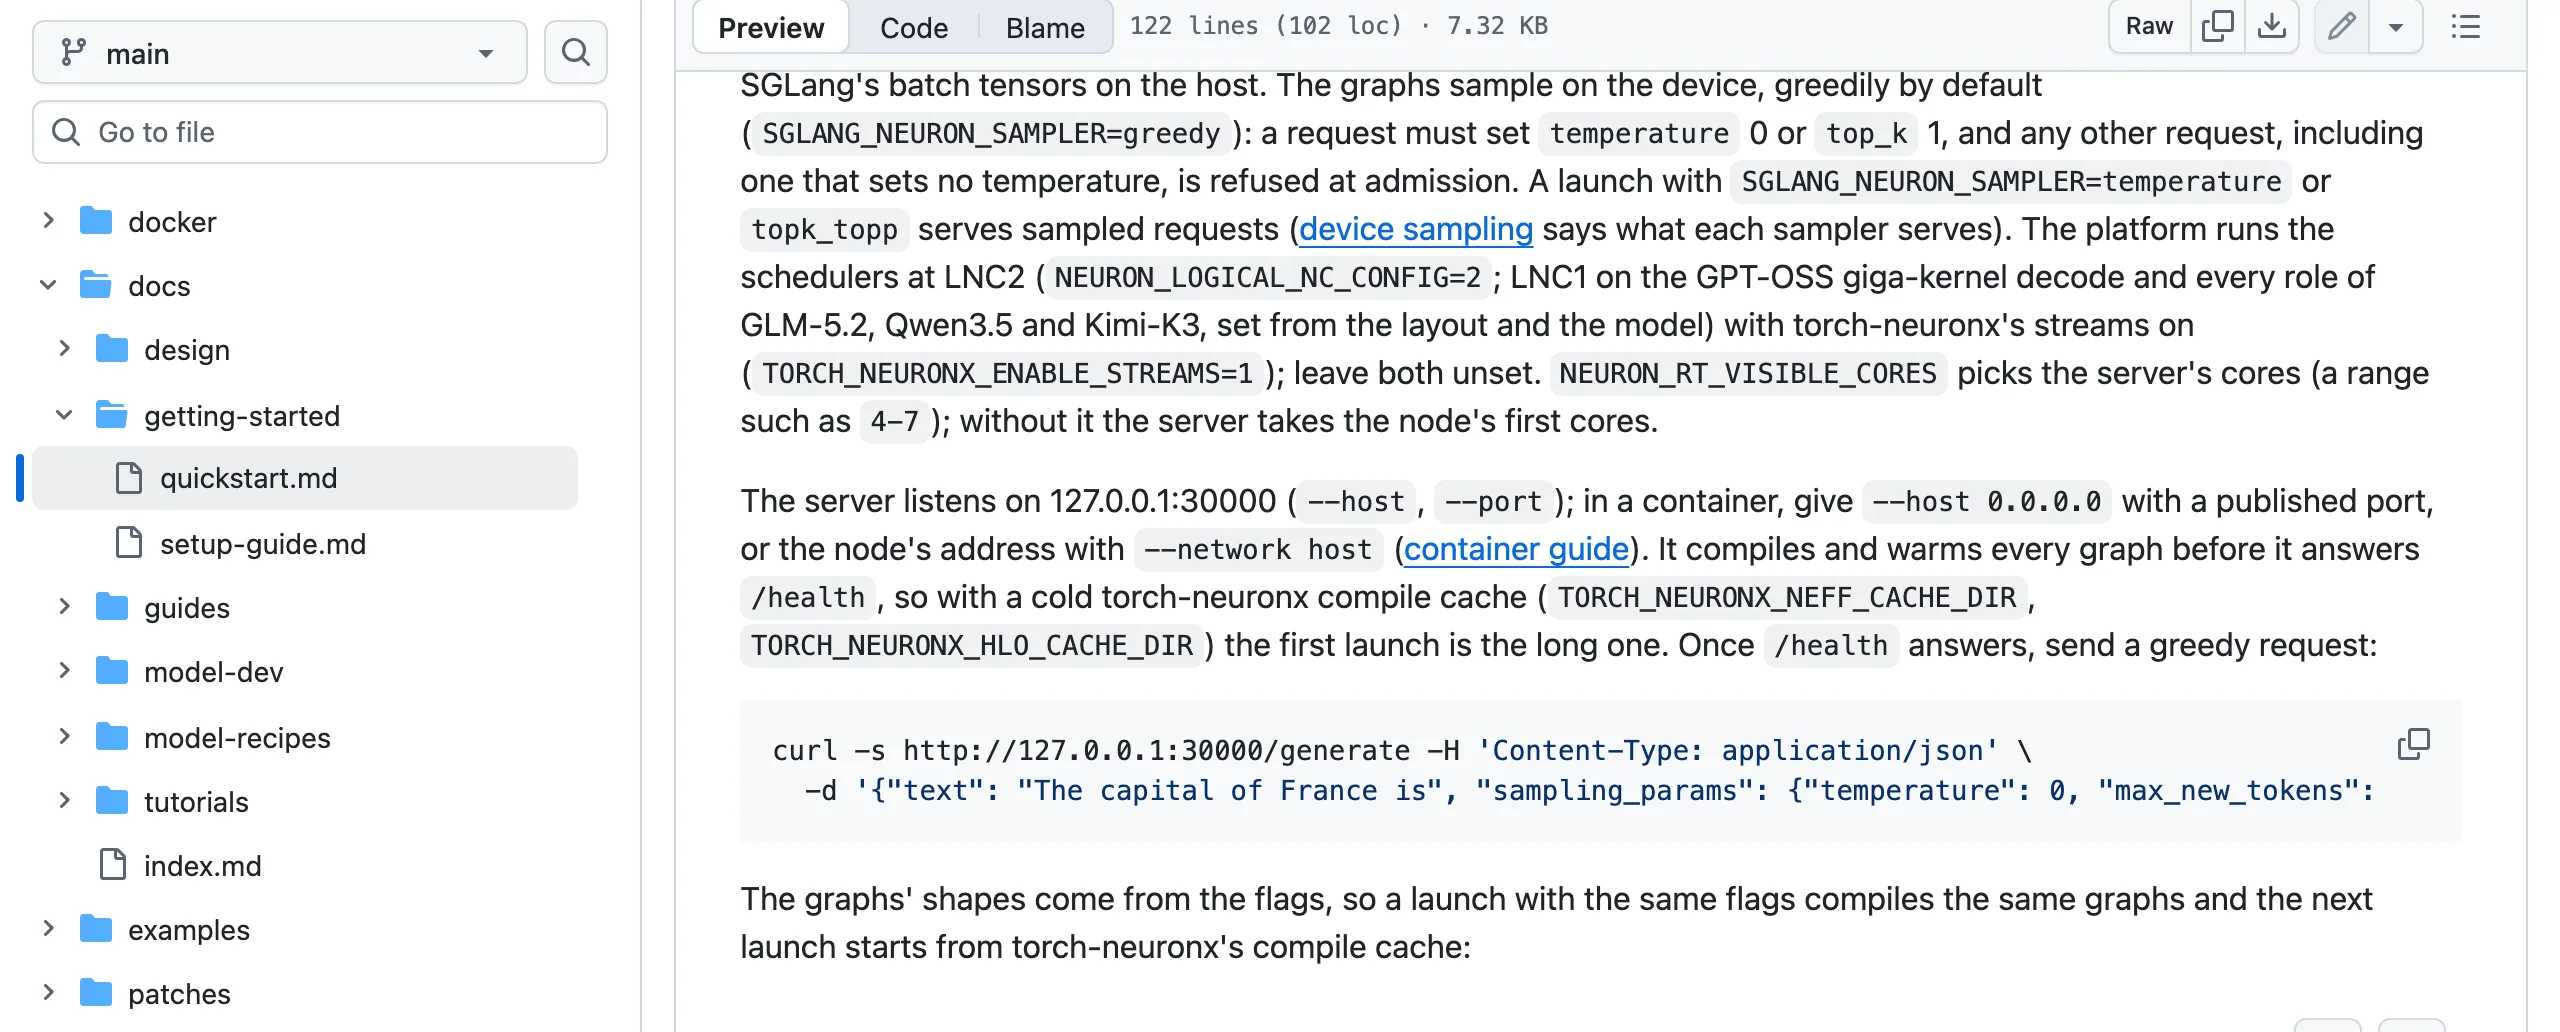
要服務帶隨機性的生成,得在啟動伺服器時改用 temperature 或 topk_topp 取樣模式,兩種模式各自服務的請求型態文件另有明細。取樣發生在裝置端,也就是說取樣這件事被編進了執行圖裡,客戶端給的參數會在進場時被逐項檢查,不會拖到伺服器內部才由軟體兜著算。這對搬遷的意義是:先把客戶端的請求分成固定答案與隨機生成兩類,逐類核對取樣參數,再決定伺服器用哪種模式啟動,而不是只改一個請求欄位就上線。
進場檢查拒絕的不只取樣。以 input_embeds 給提示、詞彙表外的 token id,都會被拒;beam search 在每一種取樣器上都不可用。功能相容表把更大的一批能力標成全模型拒絕,留到後面一起講。
支援清單本身是這次公開預覽最有份量的部分。語言模型九個:GPT-OSS-120B、Qwen3-0.6B 與 Qwen3-8B、Qwen3-30B-A3B、GLM-4-9B-0414、DeepSeek-V2-Lite、GLM-5.2 的 MXFP4 版、Qwen3.5-397B-A17B,以及 Kimi-K3(與先前介紹過的開放權重 Kimi K3.1 Pro 同家族)。擴散模型五個:FLUX.1-dev、MiniMax-H3、Wan2.2 A14B、FLUX.3-Action、LingBot-World-V2,走 SGLang Diffusion 服務。
| 部署對象 | 驗證硬體 | 值得注意的條件 |
|---|---|---|
| 語言模型(整個清單) | Trainium3 的 Trn3 執行個體 | GPT-OSS 的計算圖只在 Trainium3 上跑;Kimi-K3 的提示計算伺服器同樣僅限 Trainium3 |
| 擴散模型(五個管線) | Trainium2 的 trn2.48xlarge | 與語言模型分屬兩代晶片,配置不能混用 |
| 公告示範(GPT-OSS-120B) | Trainium3 執行個體 | 張量平行 8、專家平行 8、FP8 KV 快取、上下文 10240 的驗證組合 |
每個家族的並行配置不是自由填空,文件逐個給了驗證過的版型:Qwen3 系列走張量平行 4,GPT-OSS-120B 聚合式是張量平行 8 加專家平行 8,分離式則可以是五個張量平行 4 的提示副本餵一個 64 路的解碼伺服器;GLM-5.2 與 Kimi-K3 的版型更大,前者解碼用到 128 個 NeuronCore,後者的專家平行開到 256。投機解碼也在清單上:GLM-5.2 用官方的多 token 預測方法,Kimi-K3 用 DSPARK 演算法且可設不同猜測長度,這是追求解碼吞吐的團隊會用到的能力。
清單裡有幾個部署形態超過一般認知中的推論服務。GPT-OSS-120B 與 GLM-5.2 在 Trainium3 上的解碼走 giga-kernel:一步解碼的所有層在同一個核心呼叫裡跑完;Qwen3.5-397B-A17B 更進一步,整個模型收進一個全模型級的 megakernel;Kimi-K3 以分離式配置橫跨三個 Trainium3 節點,一個節點算提示、兩個節點生答案,提示最長到 100 萬 token。這些是官方文件的記述,屬於這一版驗證過的部署證據,實際表現仍要自己量。
Neuron 的編譯模型是每個靜態形狀編一張圖,執行時把每一步補到放得下它的最小形狀。因此這套伺服器的啟動順序是:把提示計算與解碼需要的所有形狀的圖都編譯、暖機完畢,健康檢查端點才會回答就緒。冷編譯快取的第一次啟動會明顯拉長;同樣的旗標重啟才吃得到快取,換旗標就換了一組形狀,等於重編。
對部署觀察的直接影響:容器程序活著,不等於模型準備好接流量;健康檢查通了,也不代表每種請求都在支援範圍內。值得分開記錄三個時間點,程序啟動、圖準備完成、第一個成功回應。會把服務縮到零的團隊尤其要注意,編譯成本會在每次冷啟動時回來找你。快取還綁映像版本,官方明說伺服器會拒絕用其他核心來源建立的快取並明確報錯,每個映像版本該有自己的快取目錄。
主機端有三個必要條件容易漏。主機要裝 Neuron SDK 2.33.0 對應的驅動(aws-neuronx-dkms 2.31.7.0 或更新);容器要加 --ipc=host,因為 Docker 預設的共享記憶體只有 64MB,不夠 SGLang 行程交換張量;還要 --cap-add SYS_NICE,讓 NUMA 函式庫與 NIXL 能正確放置記憶體。埠發布官方建議只掛在 loopback,遠端客戶端走 SSH 轉發,不要把推論端口直接開到對外網路。
分離式推論(prefill/decode 分離)這版就支援:負載平衡器把每個請求同時交給一台提示計算伺服器與一台解碼伺服器,解碼端先預約自己的快取頁,提示端算完提示的 KV 快取後經 NIXL 走 EFA 網路傳過去,解碼端接著生答案;兩種伺服器各自跑 SGLang 的排程器與請求生命週期,驗證過的配置把它們放在不同節點上。要注意邊界:傳輸後端只接受 nixl,啟動時指定其他值會被直接拒絕;映像裡的 NIXL 帶著分離式推論所需的修補,這不是隨便裝一個 NIXL 套件就能替代的組合。
同時,功能相容表把三類用途標成全模型拒絕:LoRA 與混合 chunk、嵌入伺服器、記憶體節省模式。加上前面講的 beam search,這版沒有路的用途相當明確。靠 LoRA 做多租戶模型變體的、靠嵌入服務做檢索的團隊,這版先留在原路徑上,等支援範圍擴大再評估。聊天範例跑通,不代表這些邊緣用途一起通了。
對已有 SGLang 服務、而且用得起 AWS Trainium 執行個體的團隊,合理的起點是從官方驗證過的模型挑一個,用最簡單且符合文件的請求先確認環境,再逐項加上自己需要的能力。Quickstart 給的驗證組合是 Qwen3-8B、張量平行 4、上下文 4096;公告的示範是 GPT-OSS-120B 的完整旗標。環境跑通之後,固定一組涵蓋短提示、長提示與不同回答長度的請求,先驗文字結果與必要功能,再上並行負載看排隊行為,這是文件沒給、只能自己量的部分。量測時把冷啟動與同條件重啟分開記,前者反映新環境的準備成本,後者反映日常恢復;用到縮到零部署的話,兩個數字會直接決定服務的可用性體驗。
成本這件事要說清楚:公告與文件都沒有提供任何吞吐、延遲或價格數字。AWS 對 Trainium 的「strong economics」說法屬於官方行銷語,能不能省、省多少,要拿自己的工作負載在已驗證模型上量出來,無法從容器發布直接推算。這也決定了結論的邊界:介面沿用省下的整合成本是真的,換硬體後的品質與資源成本是未知數,兩者要分開結算。
在 Google 那側,開源訓練框架 MaxText 剛把千萬 token 序列訓練變成設定值等級的配置;AWS 這步把 SGLang 介面接進自研晶片,代表自研 AI 加速器陣營(Google 的 TPU 8tx 與 8i Max、AWS 的 Trainium)都在往「開源框架原生支援」靠攏,硬體的差異正在被框架層吸收,同一套服務框架也在往流量變了就跟著重編的方向演化。對使用者的意義很實際:框架選 SGLang 的團隊,硬體選項多了一個,而切換成本第一次低到值得認真評估。
公開預覽四個字要認真對待:README 明言功能、API 與支援模型在後續版本都可能變動。效能與成本零官方數字,任何「Trainium 推論比 GPU 便宜」的說法目前都沒有第一手依據。公告提到 Trainium3 的 EC2 執行個體,但沒列具體機型型號與可用區域,租用前要自己確認。截至本文查證的 2026 年 11 月 15 日,專案儲存庫與 v0.1.0 release 都是 11 月 12 日當天建立與發布的新儲存庫,採 Apache-2.0 授權,後續版本節奏還看不出來。
回查時間點建議設在兩處:sglang-neuron 的下一個 release,以及 Neuron SDK 的版本更新。SDK 已經走到 2.33.1、上游 SGLang 每天都在推進,這份容器是快照,支援範圍只會往兩個方向變,擴大或調整,值得定期回來對表。