TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

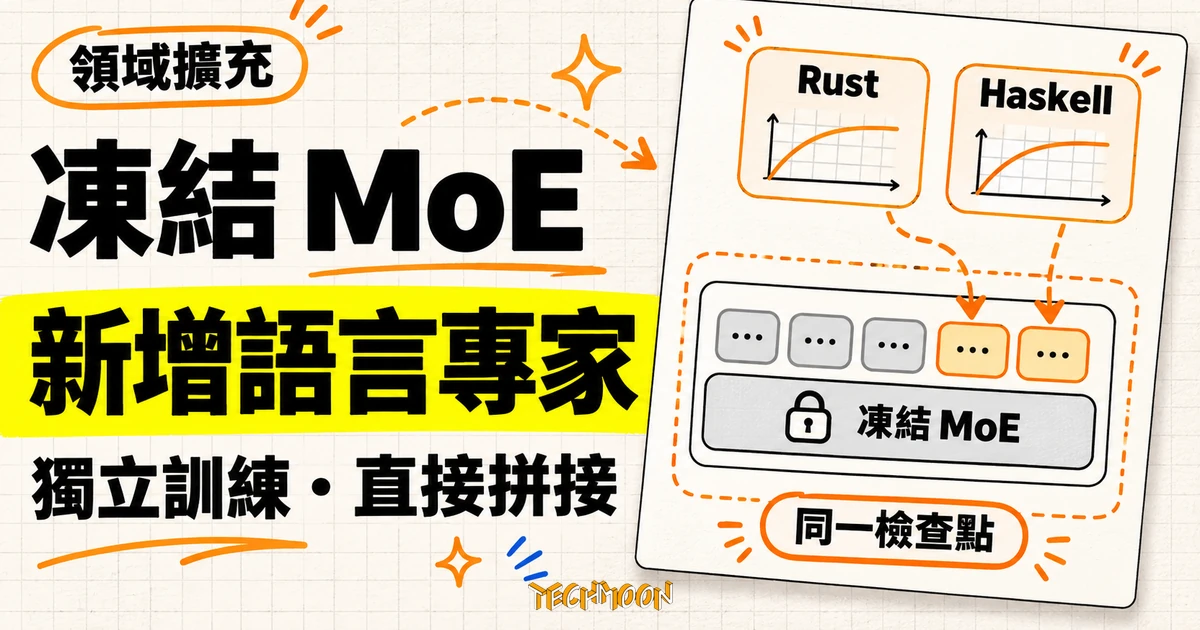
TNG Technology Consulting 於 2026 年 11 月 10 日公開 Bring Your Own Expert 實驗:以 Qwen3.5-35B-A3B-Base 為凍結基座,只訓練新增的 Rust 與 Haskell 專家與路由參數,pass@1 分別提升 11 與 19 個百分點;兩份專家直接合併仍保有大部分能力,官方對照中兩份 LoRA 平均合併則塌回基準附近。程式碼與權重未隨文釋出。
用 AI 摘要這篇文章:
德國顧問公司 TNG Technology Consulting 在 2026 年 11 月 10 日於 Hugging Face 部落格公開一份名為 Bring Your Own Expert 的實驗:把混合專家模型(Mixture-of-Experts,MoE)的既有權重全部凍結,只在旁邊新增可訓練的領域專家與對應的路由參數,讓同一個基座分別學會 Rust 與 Haskell 兩種程式語言,再把兩份獨立訓練的專家直接拼接進同一個模型檢查點。文章發布與實驗公開是同一天,沒有分階段生效的時間表;性質是方法示範與成果公布,不是產品上線。
這條路線針對的痛點很常見:團隊替同一個模型各自微調出兩種領域能力後,兩份更新很難一起放回模型,互相干擾會讓能力彼此抵銷。TNG 公布的數字顯示,新增專家後 Rust 的程式生成 pass@1 從 0.62 提高到 0.73,Haskell 從 0.32 提高到 0.51;兩份專家直接合併進同一個檢查點後仍有 Rust 0.70、Haskell 0.50,一般能力維持基準水準。作為對照,官方同批訓練的兩份最佳 LoRA 微調結果用平均方式合併後,Haskell 掉到 0.36,幾乎退回基座原點。
pass@1 在這裡指第一次生成就通過指定測試的比例,衡量單次生成的解題成功率;它是程式生成基準的常用指標,不代表模型在所有真實程式任務上的正確率。以下依 TNG 官方文章與 Hugging Face 上的 Qwen3.5-35B-A3B-Base 模型頁,整理這次實驗改了什麼、官方數字怎麼判讀、誰需要留意。
直接相關的是手上有模型訓練資源、正在開放權重 MoE 模型上做多領域客製化的團隊:同時維護多個領域版本、或已經在用 LoRA 做單領域微調的人(先前介紹過的 WeClone 微調數位分身就是這類例子),會在這份實驗裡看到合併階段的另一種做法。這裡說的訓練資源,具體是指能排到一個 8 卡 B200 等級節點半天到一天、有能力整理領域語料、並自建評測流程的團隊;把模型當服務用的單位,這個門檻本身就是一道過濾。TNG 過去在 MoE 領域發表過 Chimera 模型與 Assembly of Experts 等研究,這次是他們把「模組化專家」想法往前推一步的公開成果。
反過來說,透過 API 使用聊天模型、或直接下載別人微調好的完成品模型的讀者,這份實驗短時間內不影響你使用的服務。另外要留意實驗對象是 Qwen3.5-35B-A3B-Base:Base 指基礎模型,還沒有經過對話、工具使用與安全調整的後訓練流程,實驗結論不能直接換算成某個聊天助理會變強。想理解 Qwen 家族目前公開到哪裡,可以先看先前對 Qwen4 雲棲大會四款型號的整理。
混合專家模型可以用一句話講清楚:模型每一層裡放了很多組小網路,一個路由器會為每個輸入的 token 挑出其中一部分來運算,所以模型總容量很大,單次運算只用到一小部分。TNG 在文章裡先澄清一個常見誤解:這些專家是預訓練過程自然湧現的分工,並沒有對應人類理解的領域,看到模型裡有很多專家,不代表每個專家都剛好擅長某種語言或某類知識。美國 Allen Institute for AI 今年稍早的研究已示範過領域專家可以被訓練出來,TNG 沿著這個方向問了一個更實際的問題:能不能替一個已經很強、只有特定領域偏弱的模型,直接加上新的領域專家。
LoRA 微調動的是共享權重。它在凍結的基座上插入小型可訓練矩陣,修改的是模型本來就在使用的運算;兩份各自訓練的 LoRA 改到同一段權重,合併時自然互相牽制。TNG 的做法換了一個位置:在每一層新增一個專家與一行路由權重,路由器自己學會什麼時候叫新專家、什麼時候回頭用原有專家,不屬於新領域的 token 幾乎照原樣運算。因為新舊參數不重疊,合併兩個領域的專家時就只是把張量接起來,組合本身就是拼接。
實際運算時的分工可以想成這樣:一個 Rust 相關的 token 進來,路由器看到 Rust 專家對它評分最高,就把這個 token 交給新專家處理;換成日常中文或另一種語言的 token,路由器多半還是選原有專家,模型行為貼近原本的基座。這也是官方敢說既有能力不受影響的結構原因:不是把舊權重改小,而是給新能力一個獨立的房間,讓路由決定何時開門。
新專家有自己的起步問題。剛加入時它還沒有作用,路由器很快就會學會不再選它,訓練等於提前結束。TNG 的解法是讓新專家與新路由行從每一層最常被啟用的既有專家複製權重出發,先給它一個已知有用的起點,並在訓練初期短暫凍結路由,讓專家有時間先學到東西,之後再放開讓路由自己分配。訓練完成後,新專家直接接上基座的專家張量;TNG 表示結果是標準的 Hugging Face 檢查點,只是配置上的改變,不需要為了這個模型另外寫推論程式。
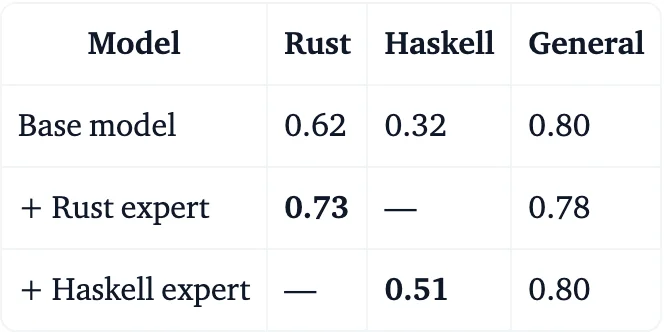
TNG 用程式生成任務的 pass@1 衡量領域能力,另外用七項一般能力測試(ARC Easy、ARC Challenge、BoolQ、HellaSwag、MMLU、PIQA、WinoGrande)檢查既有能力有沒有退步。官方公布的完整對照如下,數字均出自 TNG 自己的實驗報告。
| 模型版本 | Rust pass@1 | Haskell pass@1 | 一般能力 |
|---|---|---|---|
| 基座 Qwen3.5-35B-A3B-Base | 0.62 | 0.32 | 0.80 |
| 加 Rust 專家 | 0.73 | 未公布 | 0.78 |
| 加 Haskell 專家 | 未公布 | 0.51 | 0.80 |
| 兩專家直接合併 | 0.70 | 0.50 | 基準水準 |
| 最佳 Rust LoRA | 0.74 | 未公布 | 0.78 |
| 最佳 Haskell LoRA | 未公布 | 0.48 | 0.77 |
| 兩份 LoRA 平均合併 | 0.67 | 0.36 | 維持 |
單獨訓練階段,Rust 專家把 Rust 生成從 0.62 帶到 0.73,Haskell 專家把 Haskell 從 0.32 帶到 0.51,兩者在七項一般能力測試都維持在基準附近,官方認定變動在雜訊範圍內。合併階段是這份實驗的主要展示:兩份獨立訓練、彼此沒見過對方的專家放進同一個檢查點後,Rust 0.70、Haskell 0.50,各自保留大部分增益,一般能力維持基準。
接著 TNG 只用 Rust 與 Haskell 各半的混合資料,小量重訓路由列,專家權重全程保持不動;官方描述 Rust 與一般能力因此完全恢復,Haskell 甚至能超過單獨訓練的版本。換句話說,合併後的額外訓練成本集中在路由這一小段,不用回頭重訓專家本體,更動不到基座。
判讀這張表還要留意兩件事。pass@1 只看第一次生成有沒有通過指定測試,同一個 0.73 背後可能是語法正確但邏輯錯誤的各種失敗組合,官方並沒有公布未通過樣本的分析,想知道模型輸出的程式碼在自己任務上的品質,還是得用自己的測試跑一遍。一般能力的七項測試也不是全能體檢,它們多集中在常識、推理與閱讀理解,長文件、多輪對話或工具使用都不在範圍內。
單領域階段兩邊各有勝場。TNG 用同一個基座與同一批資料訓練 LoRA 對照組,並掃過學習率與秩(rank)取最佳結果:最好的 Rust LoRA 達到 0.74,略高於 Rust 專家的 0.73;最好的 Haskell LoRA 是 0.48,低於 Haskell 專家的 0.51。一般能力兩邊都守得不錯,LoRA 版本為 0.78 與 0.77。
差距出現在合併。兩份 LoRA 用平均方式合併後,Rust 掉到 0.67、Haskell 掉到 0.36,官方形容領域能力幾乎塌回基座;改用相加方式更糟,Rust 甚至明顯低於基座,Haskell 與一般能力也一起變差。兩種失敗方式剛好對稱:平均是妥協,兩份更新各讓一步,弱勢領域容易被蓋掉;相加是加碼,兩份更新疊在一起,連基座本來的表現都被推離原位。TNG 據此強調的重點在組合階段,單領域誰略勝一籌反而是次要問題:專家活在互不重疊的參數空間裡,拼接本身就是合併,不需要再找調和權重的演算法。
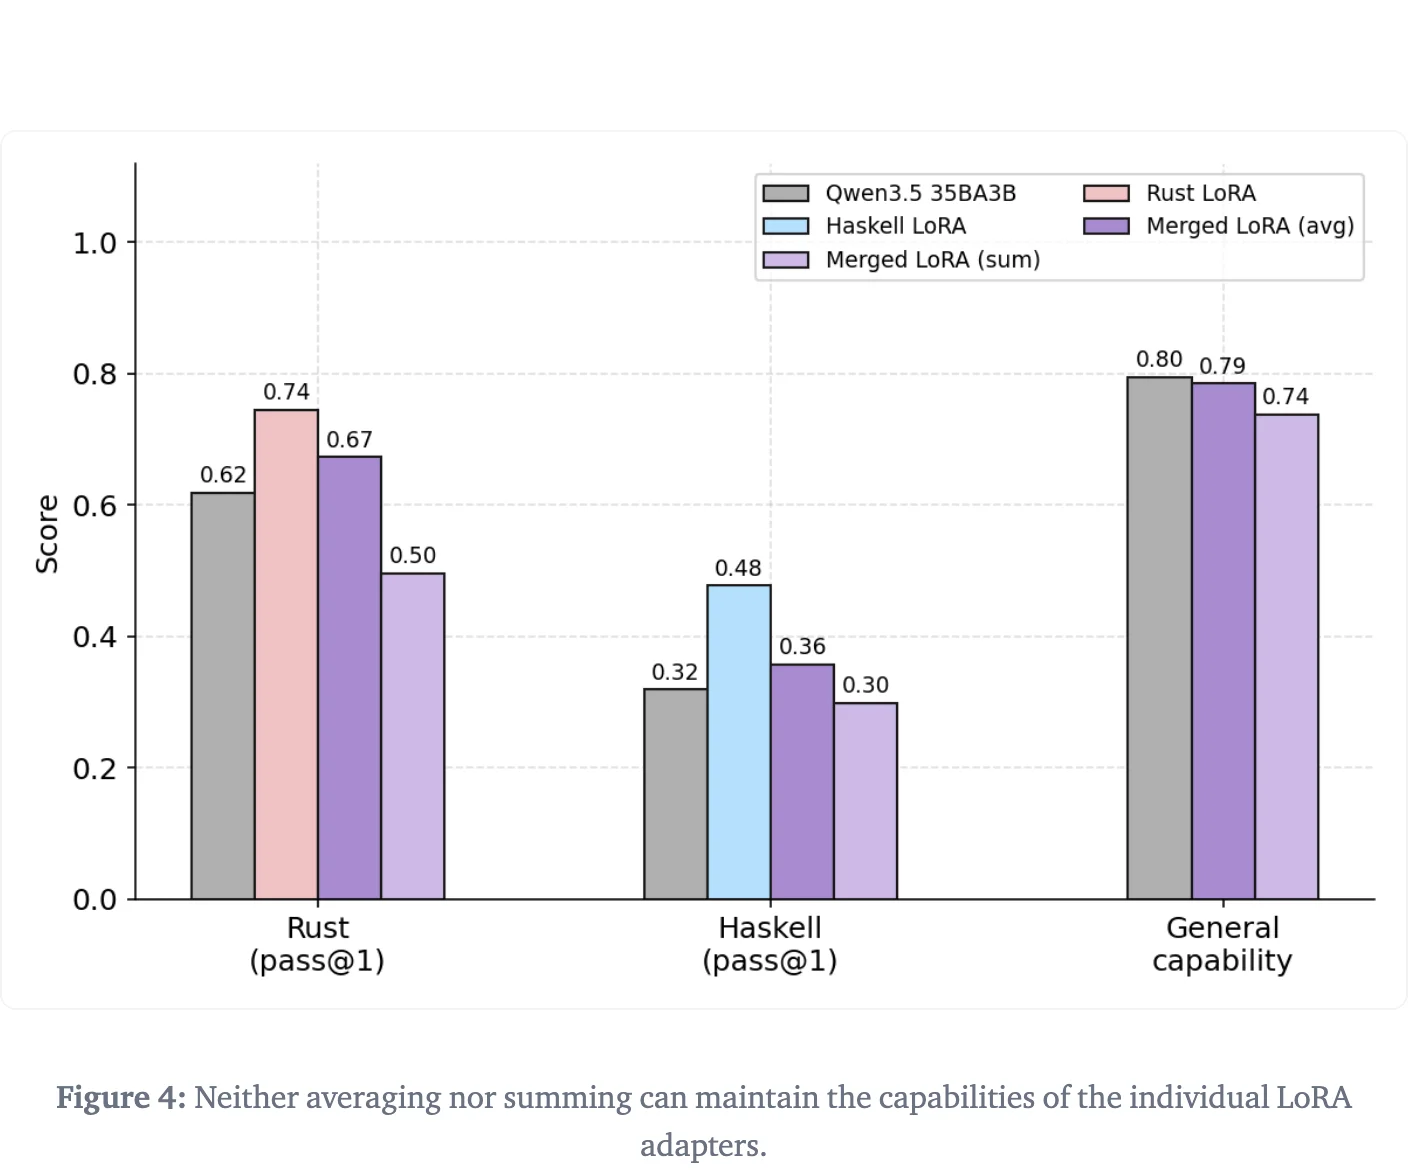
這組對照的範圍要說清楚。它測的是同一個基座、同一批資料、掃過超參數的 LoRA,加上平均與相加兩種合併方式;官方沒有測遍所有 LoRA 合併演算法,單領域分數也顯示 LoRA 並非全面落後。把這份實驗讀成「LoRA 被淘汰」會超出這些數字能支持的範圍,它真正支持的是:在這個設定下,需要多領域共存時,新增專家的組合方式保住了更多能力。
資源門檻要先看清楚。官方訓練設定是:資料取自 The Stack v1 去重版的 Rust 與 Haskell 子集,框架用 NVIDIA 的 NeMo AutoModel,序列長度 4096,在一個 8 張 NVIDIA B200 的節點上做資料平行訓練,單一領域約訓練半天。每個新專家約 1.25 億參數,相對約 350 億參數的基座是小數目;但新增參數少不代表便宜,整個基座在訓練與推論時都必須完整載入並持續參與運算,資料準備、評測與部署是另外的工作量。B200 等級的推論與訓練資源怎麼規劃,可以先參考先前整理的 NVIDIA Dynamo 把開放模型收進 B200 推論叢集的做法。
就成本結構推論(這一段是編輯判斷,非官方數字):如果這條路線後續被驗證,多領域客製化的整合成本會從反覆重訓與調整合併權重,移向訓練各自專家加上一段路由微調,領域之間可以先分工再組合。部署端則要留官方自己劃出的界線:直接附加專家可能破壞專家平行(expert parallelism)與負載平衡,也就是多 GPU 推論時分配專家的效率;TNG 把這列為開放問題,並設想結合專家剪枝技術來緩解,而不是已解決的事。
截至 11 月 14 日,這份實驗公開的是方法與數字,拿不到可直接執行的程式與權重。官方文章沒有附程式碼倉庫連結,TNG 在 Hugging Face 的組織頁面上沒有這次新增專家的對應模型,GitHub 上也沒有 Bring Your Own Expert 的倉庫。想現在跟進的團隊只能照文章描述自行實作:從每層最活躍的既有專家初始化新專家、訓練初期短暫凍結路由、先驗證單領域成績再談合併。
多數讀者不需要做任何事。有訓練資源、正好卡在多領域合併問題上的團隊,可以把這份實驗當路線圖:先拿一個小領域確認路由學得起來,再考慮多專家並存;單領域版本記得留存,合併版退步時才有對照組可回頭。
官方自己在文章裡列出的未解問題有三個方向:走完完整後訓練流程之後,專家能力是否保留;專家數量放大之後,彼此是否仍互不干擾;推論效率的實際影響。三個問題裡,後訓練相容性對實際採用影響最大:真實產品很少直接使用基礎模型,對話、工具呼叫與安全調整都發生在後訓練階段,若專家能力在這個階段被洗掉,方法就得重新設計。
值得放在雷達上的還有 TNG 描述的長期方向:一個凍結的基座,配上隨插即用的領域專家庫,要加能力就訓練一個新專家放進去,要換方向就把它換下來。這個願景離成品還很遠,但它點出了 MoE 結構有別於稠密模型的可能性:模組化的單位從整個模型縮小到單一專家。這篇文章的保存期限也就畫在這裡:TNG 釋出程式碼、發布後續實驗,或 Qwen 基座改版時,上述判斷都需要回查。到時候最值得看的數字,是多個領域專家放進同一個檢查點後,能不能繼續保住各自帶來的增益。