TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

Tether 旗下 QVAC 開放 BotPsy-0.8B 模型權重,以 Qwen3.5-0.8B 為基底針對工具呼叫訓練;六項工具與代理測試五項高於 2.5 倍大的 Qwen3.5-2B-Think,對基底接近翻倍,但銀行多輪全數不及格、搜尋與記憶子項落後,模型卡明文排除金錢、個資與健康用途。
用 AI 摘要這篇文章:
Tether 旗下 Tether AI Research 的 QVAC 計畫在 2026 年 11 月 11 日開放了 BotPsy-0.8B 的模型權重,走 Apache-2.0 授權,任何人都能從 Hugging Face 下載。這個模型只有八億參數,以阿里巴巴開源的 Qwen3.5-0.8B 為基底,專門針對工具呼叫做訓練。官方評測讓它對上同系列大它 2.5 倍的 Qwen3.5-2B-Think,六項工具與代理測試拿下五項,只有一項落後,對自己基底的改善則接近翻倍。
同一張評測表也把界線畫得很清楚。需要長時間搜尋、要跨輪記住條件的測試,BotPsy 的絕對分數仍然偏低;銀行客服情境裡五個受測模型全部不到五分;模型卡更明文把它排除在涉及金錢、個人資料與健康的用途之外。會挑對工具,與能交付完整任務,中間還隔著應用層的權限設計。接下來拆開這些數字怎麼讀、哪些任務現在可以試、哪些先不要交給它。
先說測試在量什麼。工具呼叫指模型把「幫我把會議改到明天下午」這類口語要求,轉成行事曆服務能執行的具體操作;代理測試再進一步,要求模型連續做多步決定,並根據每步回傳的結果調整下一步。官方讓五個模型全部開啟思考模式、用同一套評測架構跑分,BotPsy 以 BF16 精度透過 vLLM 推論框架執行,量的是模型本身的決策品質。
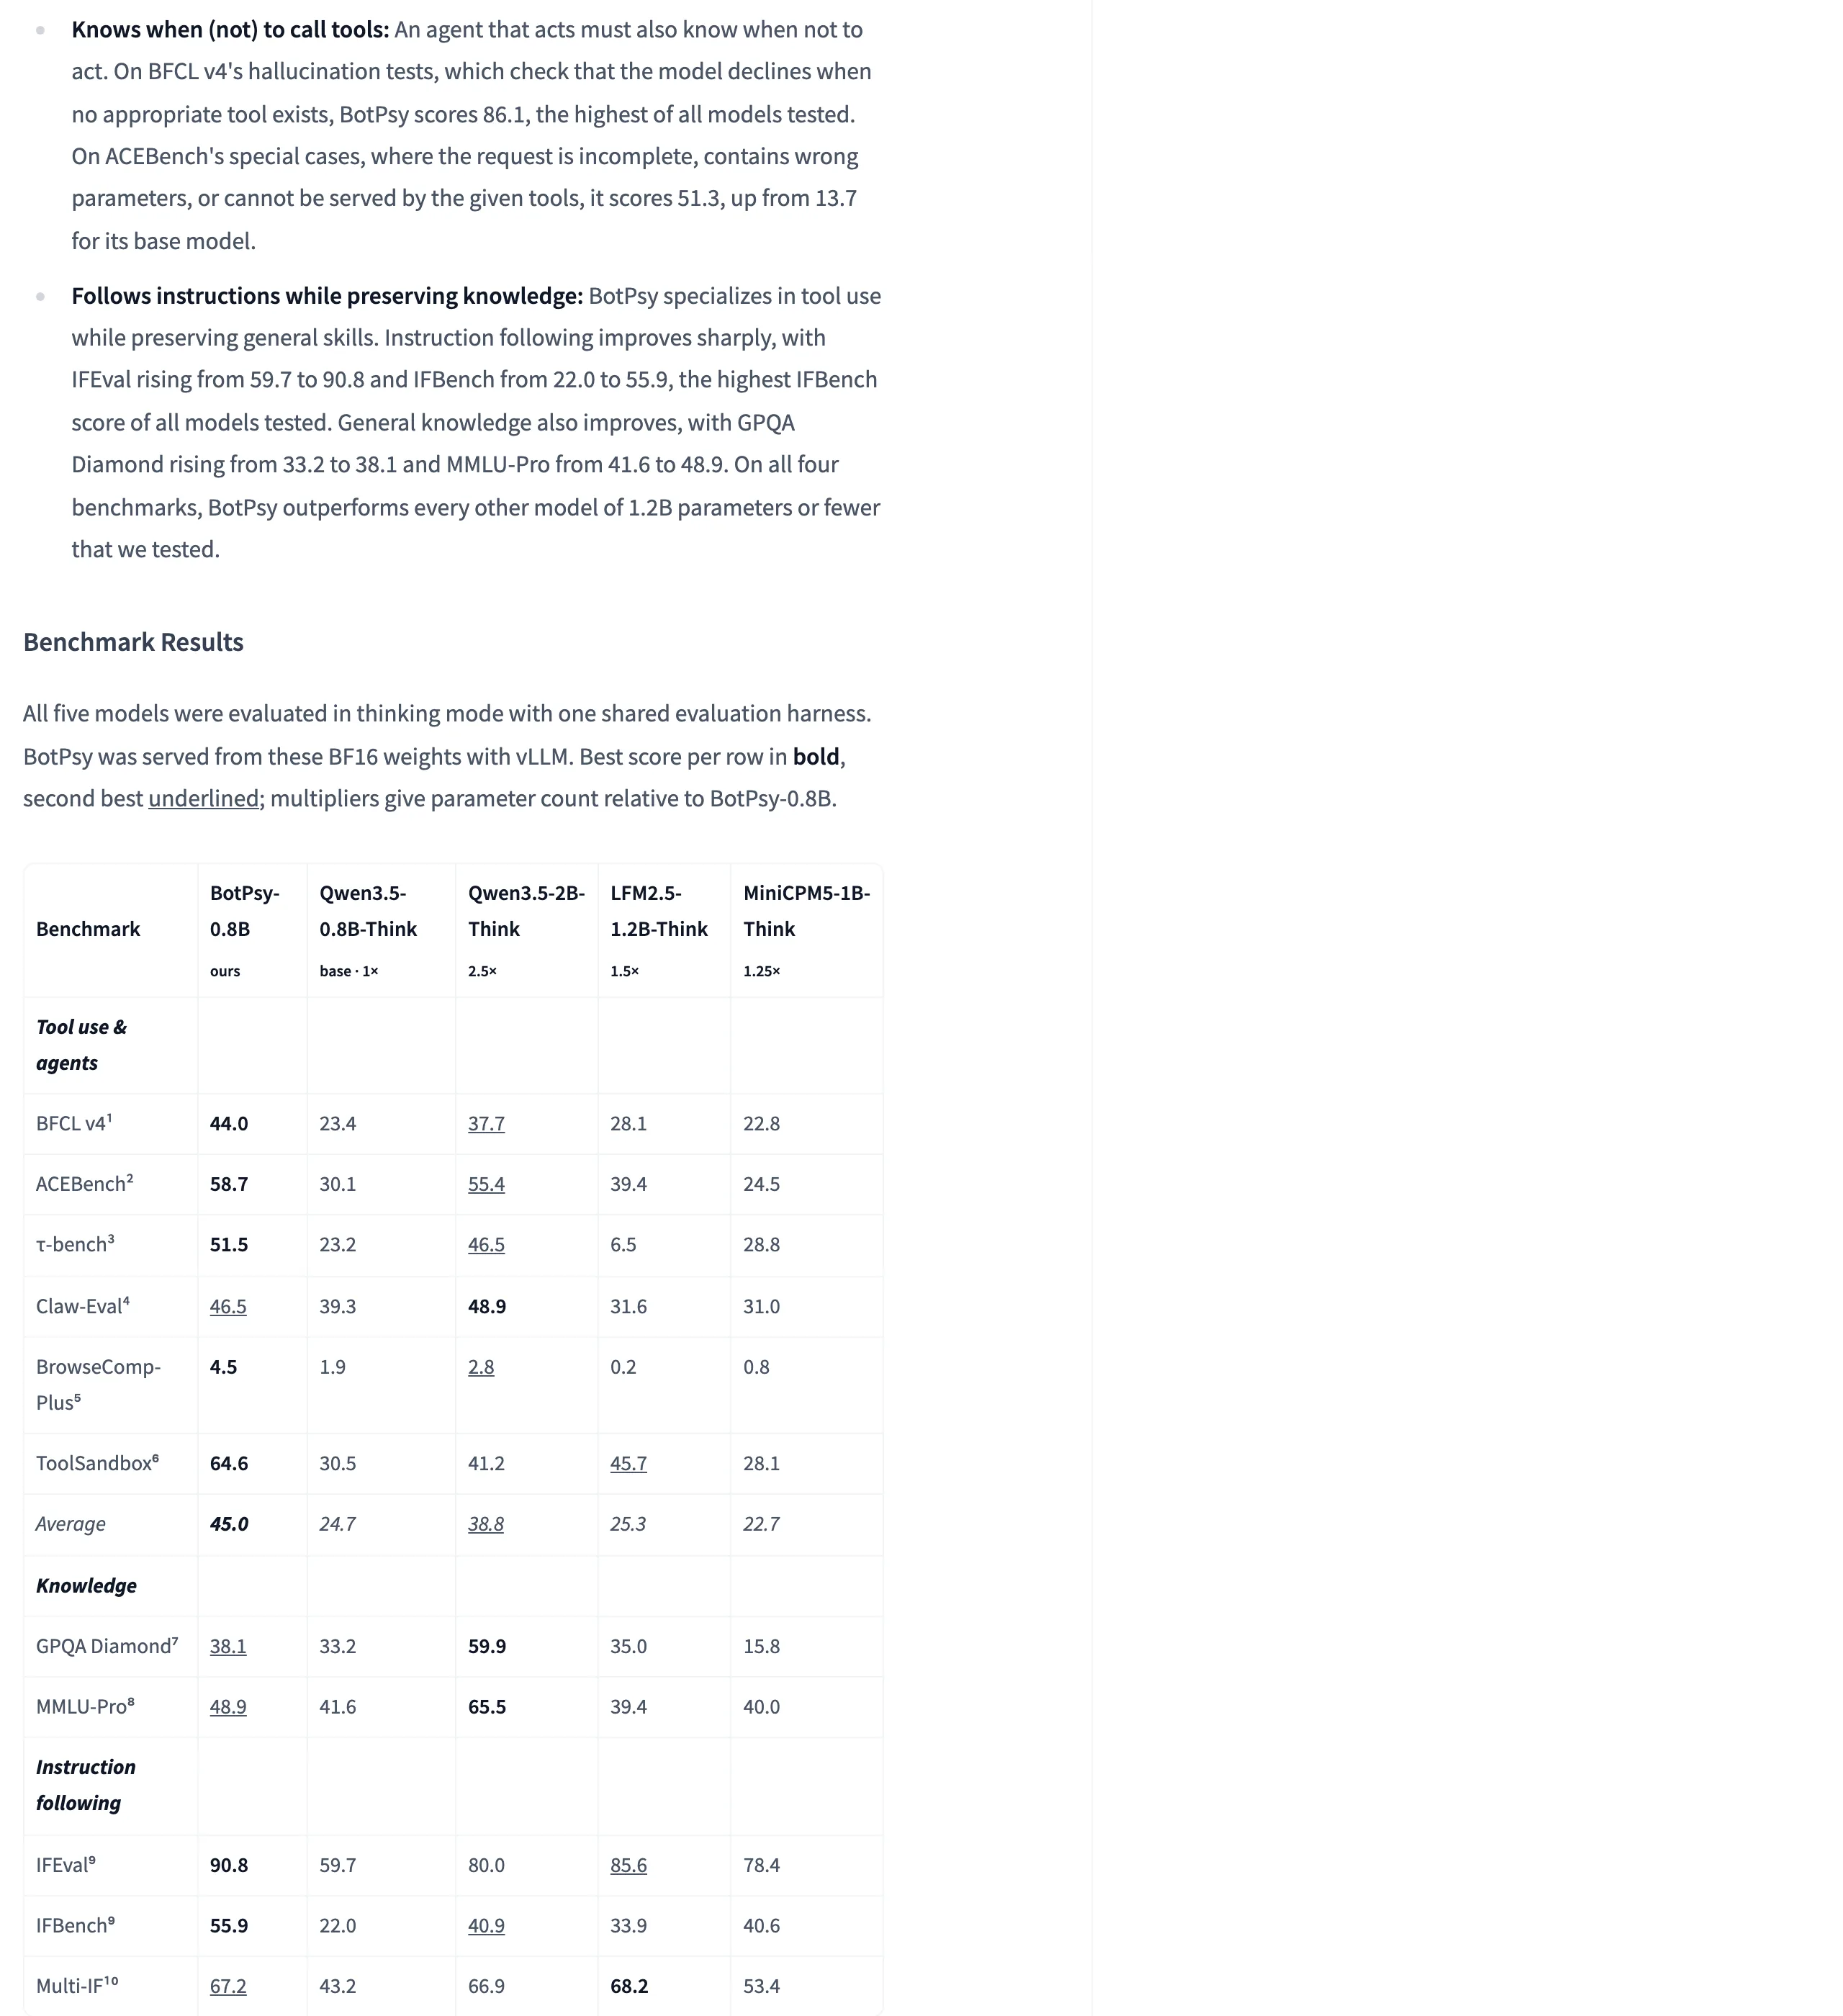
| 測試 | 量什麼 | BotPsy-0.8B | 基底 0.8B | Qwen 2B | LFM2.5-1.2B | MiniCPM5-1B |
|---|---|---|---|---|---|---|
| BFCL v4 | 選對工具並組織呼叫 | 44.0 | 23.4 | 37.7 | 28.1 | 22.8 |
| ACEBench | 多步任務分解執行 | 58.7 | 30.1 | 55.4 | 39.4 | 24.5 |
| τ-bench | 客服多輪對話三情境平均 | 51.5 | 23.2 | 46.5 | 6.5 | 28.8 |
| ToolSandbox | 互動環境連續操作 | 64.6 | 30.5 | 41.2 | 45.7 | 28.1 |
| Claw-Eval | 任務完成與穩健度加權 | 46.5 | 39.3 | 48.9 | 31.6 | 31.0 |
| BrowseComp-Plus | 開放網路搜尋與整合 | 4.5 | 1.9 | 2.8 | 0.2 | 0.8 |
六項平均 BotPsy 45.0,Qwen 2B 是 38.8,基底只有 24.7。對基底的改善最接近翻倍:BFCL v4 從 23.4 拉到 44.0,ACEBench 從 30.1 到 58.7,τ-bench 從 23.2 到 51.5,ToolSandbox 從 30.5 到 64.6。對 2B 的戰績是五勝一敗,輸的只有 Claw-Eval,46.5 對 48.9,差距不到兩分半。
分數的計法也寫在評測腳註裡,引用前值得看一眼。BFCL v4 的總分是官方加權:代理佔 40%、多輪佔 30%、線上與非線上各 10%、幻覺 10%,取三次運行的平均;ACEBench 用函數呼叫模式跑、取兩次平均;τ-bench 是零售、電信、銀行三情境的平均,航空情境被排除在計分外。所有需要外部 API 的測試都在 2026 年 11 月 3 日執行。知道這些計法才能跟其他來源的分數對照,加權方式不同的數字沒有直接可比性,拿總分去比子項也是常見的誤讀。
兩種對照要分開讀。跟基底比,說的是專門化訓練把工具能力塞進小模型的幅度;跟 2B 比,回答的是小模型能不能頂替大一點的同門。新聞稿標題寫它在日常手機任務上「打敗 2.5 倍大的模型」(Beats Models 2.5x Its Size),對照表顯示這句話在五項測試成立、一項不成立,平均領先約六分,贏得不算壓倒性。想練習讀這類開放權重模型成績表的讀者,可以搭配另一份同樣走 Apache 授權的推理模型對照一起看,重點都一樣:先確認對照組是誰、測試環境在哪,再談誰贏。
子項分數比總分更能看出訓練重點。BFCL v4 的多輪子項,BotPsy 拿 46.1,Qwen 2B 是 23.8,基底只有 7.5。這類題目模擬使用者中途補充條件的情況:改時間時對方說那個時段有衝突,模型要能回頭查空檔、重提時間、再動行事曆。基底在這種題目近乎棄守,BotPsy 把這一層補上了。
幻覺子項量的是反方向的能力:沒有合適工具時,會不會硬挑一個來呼叫。BotPsy 拿 86.1,是五個模型裡最高。這個能力對代理特別重要,不該動作的時候硬選工具,後果往往比坦白說辦不到更麻煩,例如把「提醒我打電話」硬解成刪除行事曆項目。
τ-bench 的電信情境給了更具體的參考:BotPsy 82.5,高於 Qwen 2B 的 69.3 與 MiniCPM5 的 74.0。情境是模型扮演客服,照規範引導使用者排查問題,中途要查資料、判斷授權範圍。零售與電信這類流程明確、規則寫得死的領域,正是它表現最好的地方。
效率數字值得單獨記。在同樣答對的題目上,BotPsy 用掉的思考 token 比基底少約 2.7 到 3.1 倍,GPQA Diamond 測試 3,690 對 11,563,MMLU-Pro 是 1,912 對 5,105。新聞稿另舉了一個 ACEBench 案例:訊息因為 Wi-Fi 關著而且收件匣滿了而送不出去,BotPsy 先開 Wi-Fi、清出空間再重送,基底則反覆重試同一個失敗動作。這是官方挑的展示案例,實際效果要自己驗,但方向與子項分數一致。
指令遵循是另一組橫向佐證。IFEval 的嚴格口徑 BotPsy 拿 90.8,Qwen 2B 是 80.0;IFBench 進一步量模型守不守得住沒有明寫的規則,BotPsy 55.9 對 40.9。工具呼叫的前提是把使用者的指令讀對,這組數字與工具測試的方向一致,也暗示訓練重心確實放在聽懂指令這一層。
先看搜尋。BrowseComp-Plus 量開放網路搜尋再整合資訊,BotPsy 的 4.5 已是五個模型裡最高,居次的 2B 只有 2.8,但相對高分要回到絕對值看:滿分一百的題目拿不到五分,代表需要多輪檢索、交叉比對來源的研究型任務,這代模型全部撐不起來,小模型更沒有例外。
BFCL v4 的兩個子項把弱點指得更準。網路搜尋子項 BotPsy 14.0,輸給 2B 的 19.8;記憶子項 16.3,輸給 26.1。記憶在這裡指在多輪任務中維持先前條件的能力,與有沒有外接資料庫無關。一個任務只要需要記住使用者第三輪說過的預算上限、到第七輪還守得住,這兩個數字就是警訊。
ACEBench 底下還有一個特殊案例子項,處理不完整或寫錯的請求,BotPsy 51.3 輸給 2B 的 58.0,不過對基底的 13.7 已是一大步。真實對話裡使用者打錯字、條件給不齊全的情況很常見,這類題目量到的正是那種場景,分數落後代表小模型在資訊缺漏時補對意圖的能力仍然差一截。
銀行情境最刺眼。τ-bench 拆開看,銀行子集 BotPsy 4.1,與基底完全持平,Qwen 2B 也只有 4.8,五個模型全數不到五分。轉帳、改綁定手機這類一步出錯就難以回復的操作,現在沒有任何受測模型達到可交付的水準。模型卡把定位寫在前面:它為推進技術與支援研究教育而開發,這個分數就是那句定位的底層原因。
知識題回到規模優勢。GPQA Diamond BotPsy 38.1 對 2B 的 59.9,MMLU-Pro 48.9 對 65.5。專門化訓練把工具能力搬進小模型,對基底的知識分數其實也有小幅提升(GPQA 33.2 到 38.1、MMLU-Pro 41.6 到 48.9),但幅度追不上參數量,遇到要靠背景知識判斷的環節,較大的模型仍然明顯佔優。工具分數的勝利掩蓋不了知識分數的差距,兩者要放在一起看。
自動化紅隊測試跑了六類危害情境,BotPsy 的不安全回應率 21%,基底是 36%,同尺寸的 LFM2.5 為 35%、MiniCPM5 為 47%,BotPsy 是受測小模型裡最低。提示注入測試與代理的關係更直接:這類攻擊把指令藏在網頁或郵件等外部內容裡,誘導代理偏離原本任務,BotPsy 的不安全率從基底的 46% 降到 31%。
方向是對的,數字也誠實。三成的失敗率代表代理讀完不可信內容後,仍有機會做出錯誤操作,而裝置端代理恰恰會頻繁接觸外部內容。這正是模型卡接著把高風險用途排除的原因:它不建議用於安全關鍵的自動決策,也不建議用於涉及金錢、個人資料、健康與其他敏感主題的應用。授權再開放,也不構成把轉帳或病歷處理交給它的許可。
Tether 執行長 Paolo Ardoino 在新聞稿裡的說法是同一套邏輯:使用者該自己決定助理能存取什麼、連接哪些外部服務。服務連接、帳號權限與執行控制留在應用程式那一層,這是新聞稿明寫的架構前提,與模型卡的高風險排除條款出自同一套思路。想在系統層面了解這類防護怎麼設計,可以參考Google 提出的代理安全雙層架構,把權限判斷放回應用層正是兩份文件共同的結論。
換句話說,這次開放的是代理的決策核心,不是成品助理。模型會提出該呼叫哪個工具,但行事曆怎麼接、帳號怎麼授權、哪一步要使用者按下確認,全都要開發者自己建。對想評估的人,這代表「裝起來就能用」的期待要先收起來。
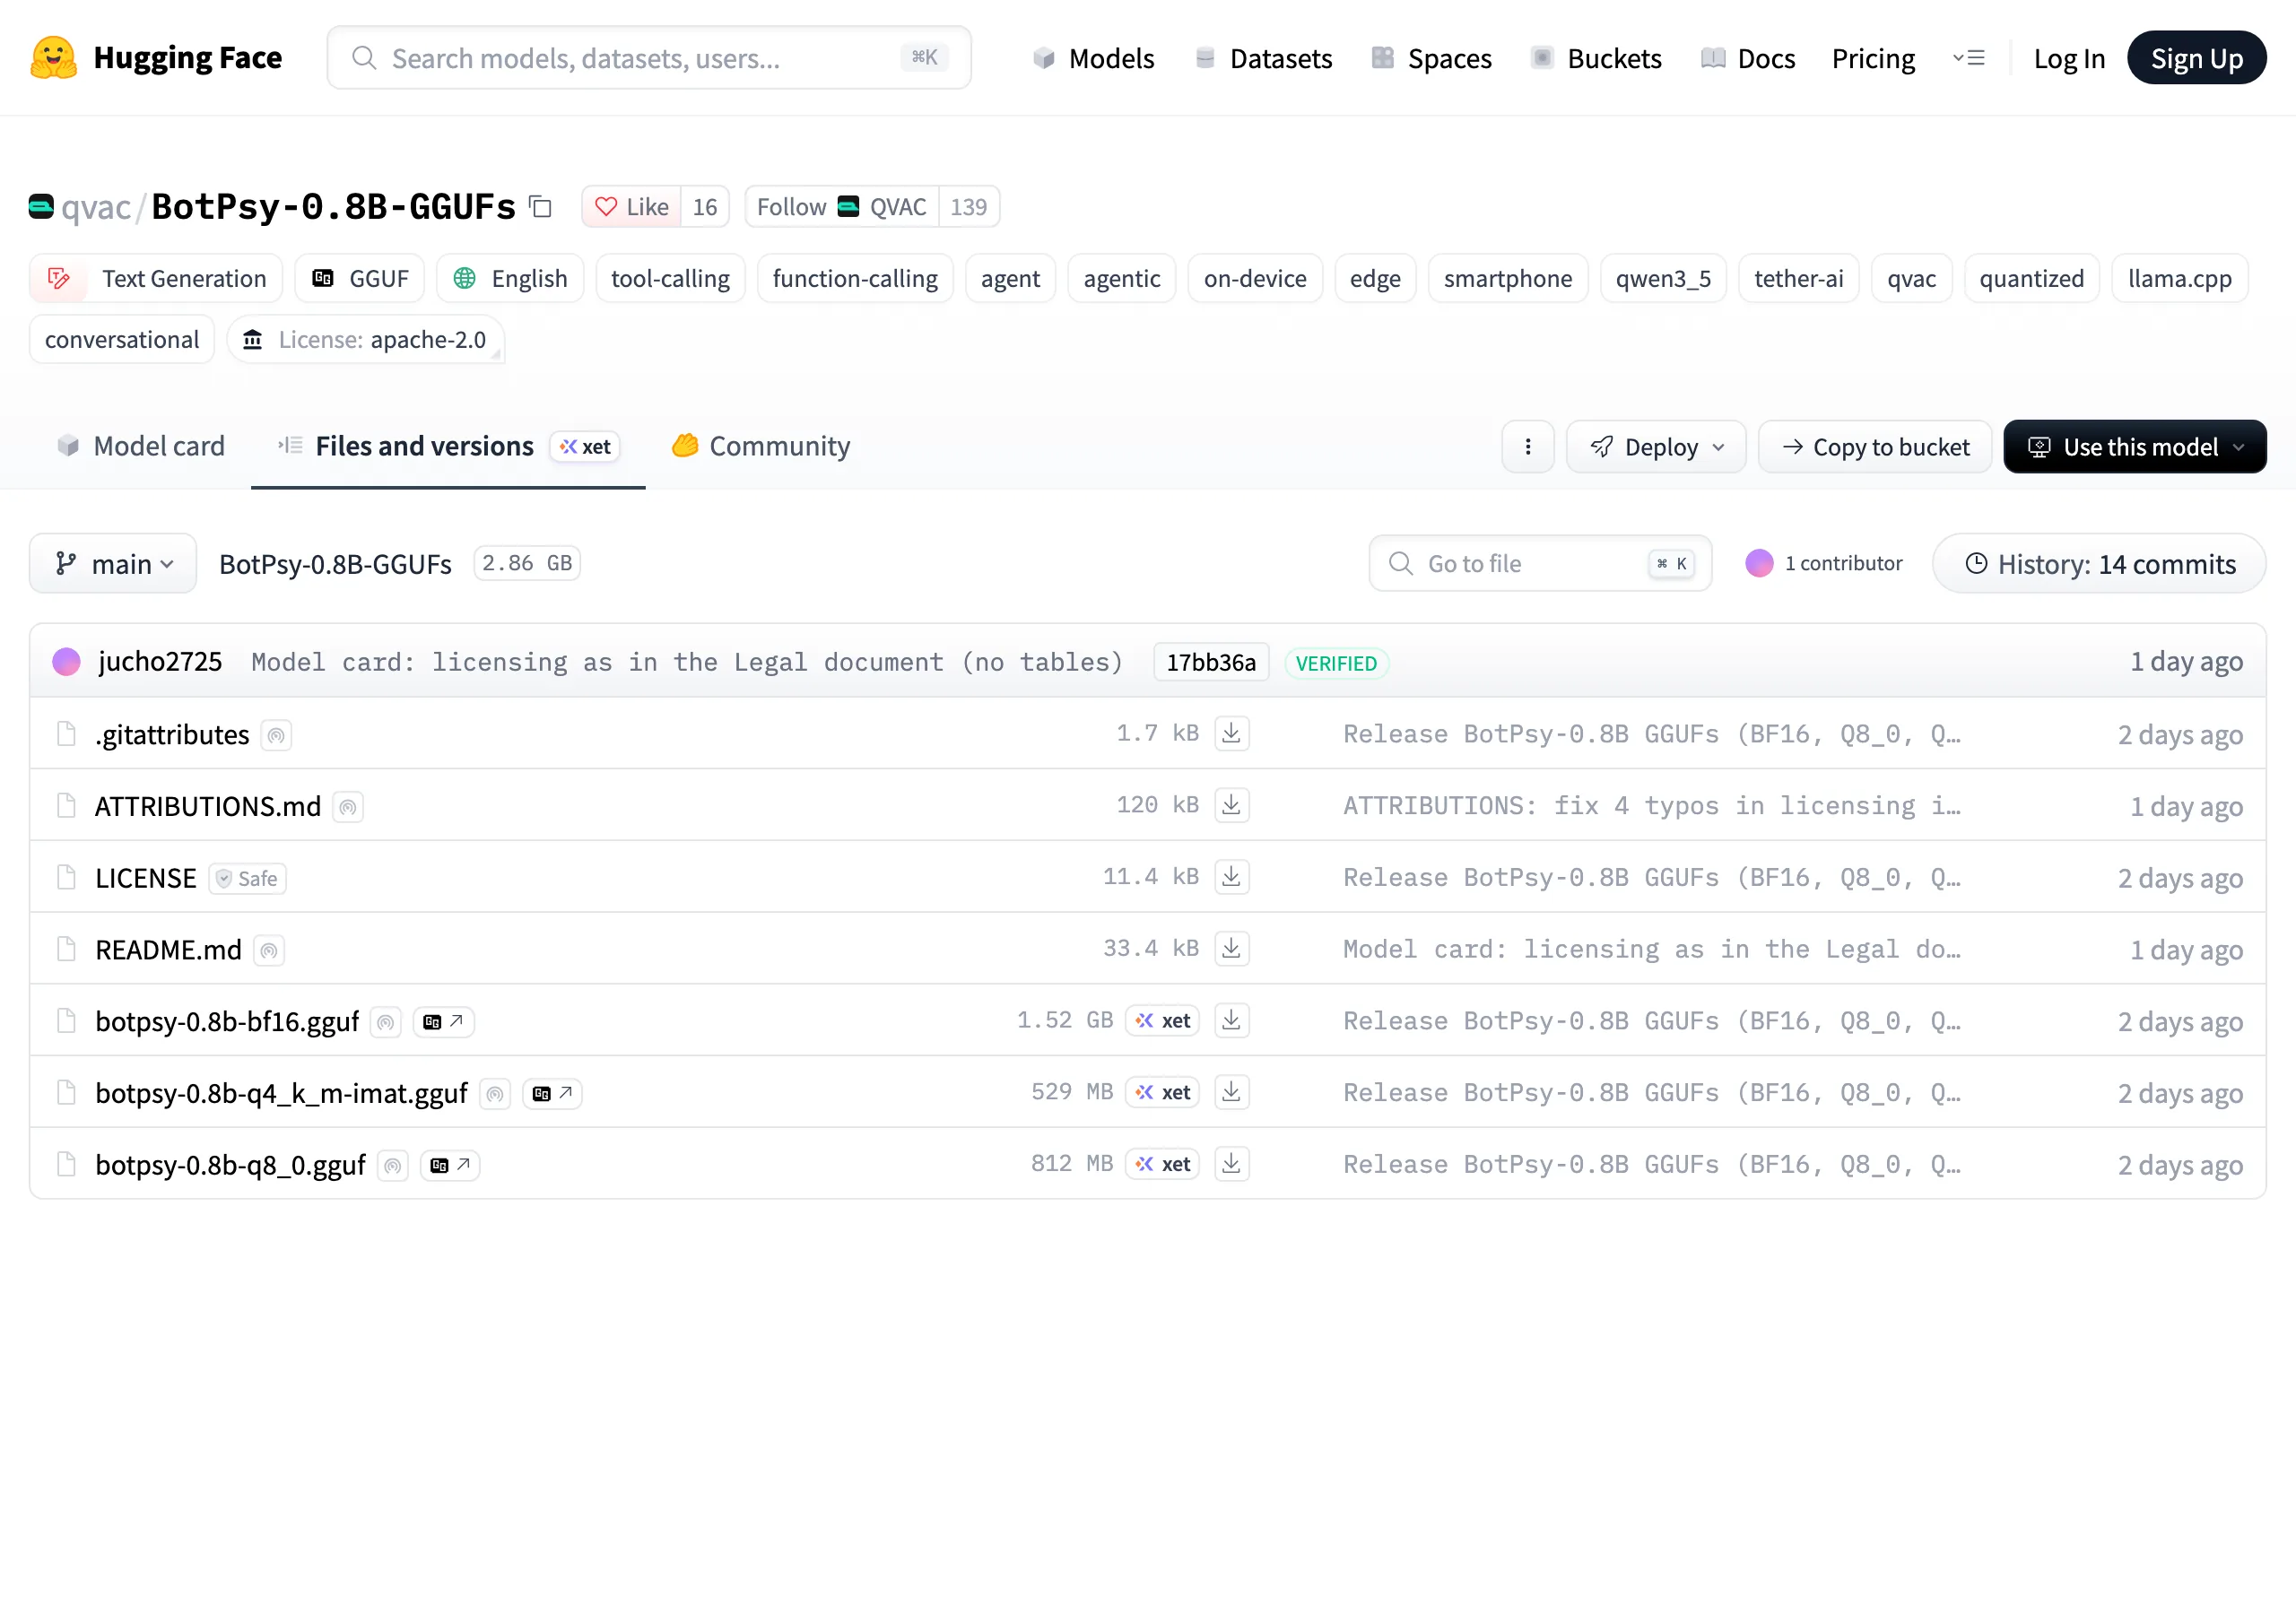
Hugging Face 上有兩個儲存庫。qvac/BotPsy-0.8B 放 BF16 精度的 safetensors 原始權重,qvac/BotPsy-0.8B-GGUFs 放三種精度的 GGUF 檔,對應 llama.cpp 與 QVAC SDK 兩種執行環境,全部走 Apache-2.0,商用與修改都不必另談授權。GGUF 是 llama.cpp 生態的通用模型格式,量化指把權重的數值換成較精簡的表示,用準確度換取速度與容量。三個檔位可以照體積挑:BF16 檔 1.52 GB,最接近評測條件;Q8_0 檔 812 MB,每個權重用 8 位元表示;Q4_K_M 檔 529 MB,最省容量,適合先在手機上把流程跑通。模型卡附了對話 API 的工具呼叫範例程式碼,跑得起 vLLM 或 llama.cpp 的環境就能接。
模型卡列出的預期領域涵蓋網路搜尋研究、旅遊生活、電子商務與金融、企業與客戶作業、裝置與車輛控制、檔案文件、行事曆、電子郵件與訊息,同時標註因參數量小,最適合低到中等難度的任務。對照前面銀行與搜尋的分數,這份清單讀起來更務實:清單裡有電子商務與金融場景,評測裡的金融多輪卻全數不及格,官方自己的定位與測試結果要放在一起看,而不是只挑順眼的那半邊。
下載前要有兩個心理準備。評測分數是在 BF16 精度、伺服器端推論環境量出來的,手機上實際會用的 Q4 量化檔體積小得多,工具能力要折損多少,官方沒有給保證數字,這部分要等第三方實測。語言條件同樣要自己驗:模型在英文上訓練與測試,模型卡建議以英文使用;Multi-IF 測試涵蓋中文在內的七種額外語言,官方公布的數字裡,英文等六種語言落在 72 到 80 的區間,印度文 24.5 與俄文 57.6 明顯偏低,中文的確切分數沒有單獨公布,人名、地址與日期格式的表現要自己測。
Tether 把 BotPsy 放進 QVAC 家族,與視覺的 VisionPsy、語音轉文字的 TranscribePsy、醫療的 MedPsy、翻譯的 TranslatePsy 並列。新聞稿描繪的長期方向是手機與家用電腦協作、查詢走點對點加密連線,這部分屬於願景敘述,這次實際交付的只有模型權重與文件,沒有隨附任何 App 或雲端服務。想讓網頁直接借用本機模型,目前瀏覽器端已有Opera WebAI 早期預覽這類實驗路線可對照。
綜合這些數字,這次開放對三種人最有感:想在手機或邊緣裝置上做代理原型的開發者、研究小模型工具行為的人、以及想比較不同量化檔效率的人。第一次實驗建議挑低風險任務,用測試資料限制可讀取的範圍,並把模型每一次提出的工具呼叫記錄下來,事後對照結果檢查,這比直接接上真實帳號更能看出它的可靠度,出了錯也只是測試資料出錯。
反過來說,三種任務現在先不要交給它:需要多輪開放搜尋的研究型任務、需要跨輪記住條件的長對話、任何碰到錢或敏感個資的操作。這條線並非 BotPsy 獨有,銀行子集全員低分說明它是這一代小模型共同的能力上限,差別在 BotPsy 的模型卡把界線寫得比多數廠商明白,連「不建議」的三個領域都列了出來。
後續值得追蹤的變化有三個:量化檔在實際手機上的第三方測試、QVAC SDK 與家族裡其他模型的整合進度、中文環境的社群評測。這些數字出現時,回到模型卡與技術部落格對照原始設定,會比看二手轉述可靠,也更容易看出哪個環節被轉述者加料。