TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

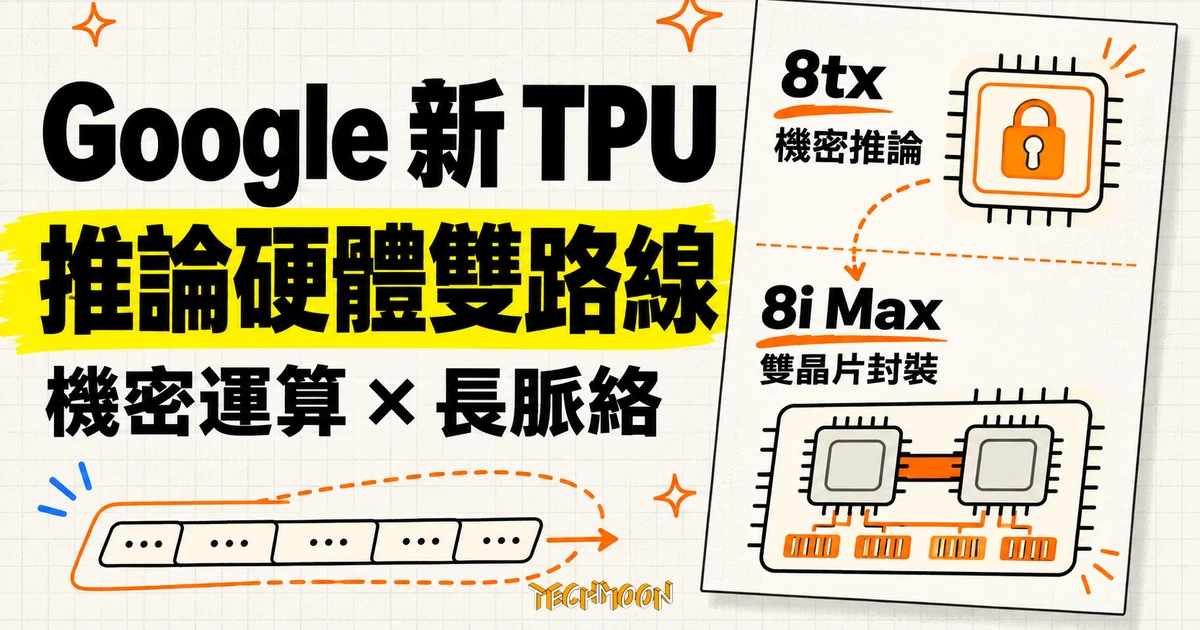
Google 在 2026 年 11 月 9 日發表兩款第八代 TPU 新系統:8tx 用第五代 AMD EPYC 主機與機密運算保護使用中的資料與模型權重,8i Max 把兩顆 8i 晶片裝進同一封裝,計算、SRAM 與 HBM 頻寬都翻倍,分別對付代理式推論的安全與長脈絡資料搬運兩個瓶頸。
用 AI 摘要這篇文章:
Google 在 2026 年 11 月 9 日(台北時間當晚)發表兩款新的 TPU 系統:8tx 與 8i Max。這兩款都不是從頭設計的新晶片,而是沿用第八代既有晶片,重新配置封裝、主機與網路,分別對付代理式 AI 工作的兩個瓶頸:敏感資料在運算中的保護,以及超長脈絡造成的資料搬運等待。加上 4 月登場的 8t 與 8i,Google 首度在單一年度內推出四套 TPU 系統。
看這次規格有個關鍵:所有翻倍的數字都集中在特定軸向。8i Max 翻倍的是計算、SRAM 與 HBM 頻寬;8tx 給的是延遲與安全性的宣稱值。至於租用價格、供應地區與開放時程,兩篇官方公告到發布為止都沒有交代。
發表的訊息當天就擴散到三個官方通道:blog.google 的公告全文、Google Cloud 部落格的同文重刊,以及 Google Cloud 的 X 帳號在當天張貼的四系統分工摘要。公告同時把讀者導向一場名為 The Future of AI Infrastructure 的官方直播,兩款新系統的細節在直播中另有展示。
官方公告特別花了一段解釋「晶片」與「系統」的差別,這正是讀懂這次發表的入口。設計一顆新晶片,是在矽晶圓上安排數十億個電晶體,受物理定律與漫長製造週期約束,以年為單位推進。系統講的則是晶片周圍的算力、網路與儲存怎麼組合,包括封裝方式、高速記憶體、光學網路與安全配置,改的是這些可以用月為單位出貨的東西。
Google 從第一顆 TPU 就押注模組化,把 TPU 當成積木,工程師可以快速調整晶片周圍的封裝、記憶體與網路。官方部落格的說法是,這讓 Google 能在幾個月內交付特殊用途的超級電腦,不必等上幾年。8tx 與 8i Max 就是這條路線的產物:晶片基礎分別來自 8t 與 8i,配置針對兩種明確需求重做。
設計流程本身也在加速。公告提到 Google 已經用強化學習系統 AlphaChip 設計晶片布局,並用 Gemini 把布局工作從數週縮短到數小時。這段敘述算不上規格,更像是 Google 對「為什麼一年生得出四套系統」的解釋,採購方不需要據此推算下一代時程,但可以看出硬體更新的節奏確實在縮短。
這個節奏背後是需求面的變化。官方在同一篇公告裡揭露,TPU 已經是一門接近一百個客戶的生意,客戶涵蓋前沿實驗室、交易公司、零售商與大學。當運算從人的規模走向代理的規模,企業開始要求兩件事:能讀懂超長脈絡的算力,以及給受監管工作負載的加密能力。對採購方的意義在於,同一年內出現四種定位不同的系統,挑選時該問的問題是自己的工作卡在哪一段,產品名稱的新舊排不上優先。
一般的加密保護的是兩種狀態:資料存在硬碟裡,以及資料在網路上傳輸。可是當資料被載入記憶體、模型實際拿來計算時,它必須被解開,這段時間的保護傳統上靠軟體與管理制度。機密運算(confidential computing)要把「使用中」的保護也納入硬體與執行環境的設計,讓資料在整個生命週期都不以明文暴露。
8tx 用的是與 8t 相同的晶片,搭配第五代 AMD EPYC 主機,把安全做進硬體層,讓敏感資料與模型權重在作用中仍保持保護與隔離。這裡值得注意的是它保護的不只輸入資料,還包括模型本身。對跑私有模型或專有模型權重的團隊來說,模型檔案外流與客戶資料外流是兩種不同的損失,8tx 把兩者放進同一個信任邊界。
網路方面,8tx 採用原本為即時推論設計的 Boardfly。官方宣稱,相較 8t,8tx 的延遲最多降至二分之一,而安全機制帶來的效能損失接近零。這兩個數字是供應商的公告宣稱值,公告沒有附上可比較基準,例如測試的模型、輸入長度或同時請求量。延遲本身也有多種口徑,等第一個輸出與等整份回答完成的時間,對互動式代理的意義不同,後文 TPU Sync 宣稱改善的首 token 等待時間就是前一種口徑。延遲對代理式工作尤其敏感,因為一個任務往往要反覆呼叫模型數十次,單次等待會沿著步驟累積;也因為這樣,拿到實際配置後用固定的工作流程重測,才會知道減半的宣稱在自己的負載上剩下多少。
8tx 同時被定位為小規模訓練的選項:訓練等級的算力配上低延遲推論網路,讓團隊可以在同一套系統上用私有資料微調模型、把大模型蒸餾成小模型、用強化學習訓練代理,不必把敏感資料在叢集之間搬來搬去。官方點名的適用者是受監管企業與政府單位;對金融、醫療這類輸入資料與模型都不能離開信任範圍的產業,資料少搬一次,就少一次合規審查與風險暴露。
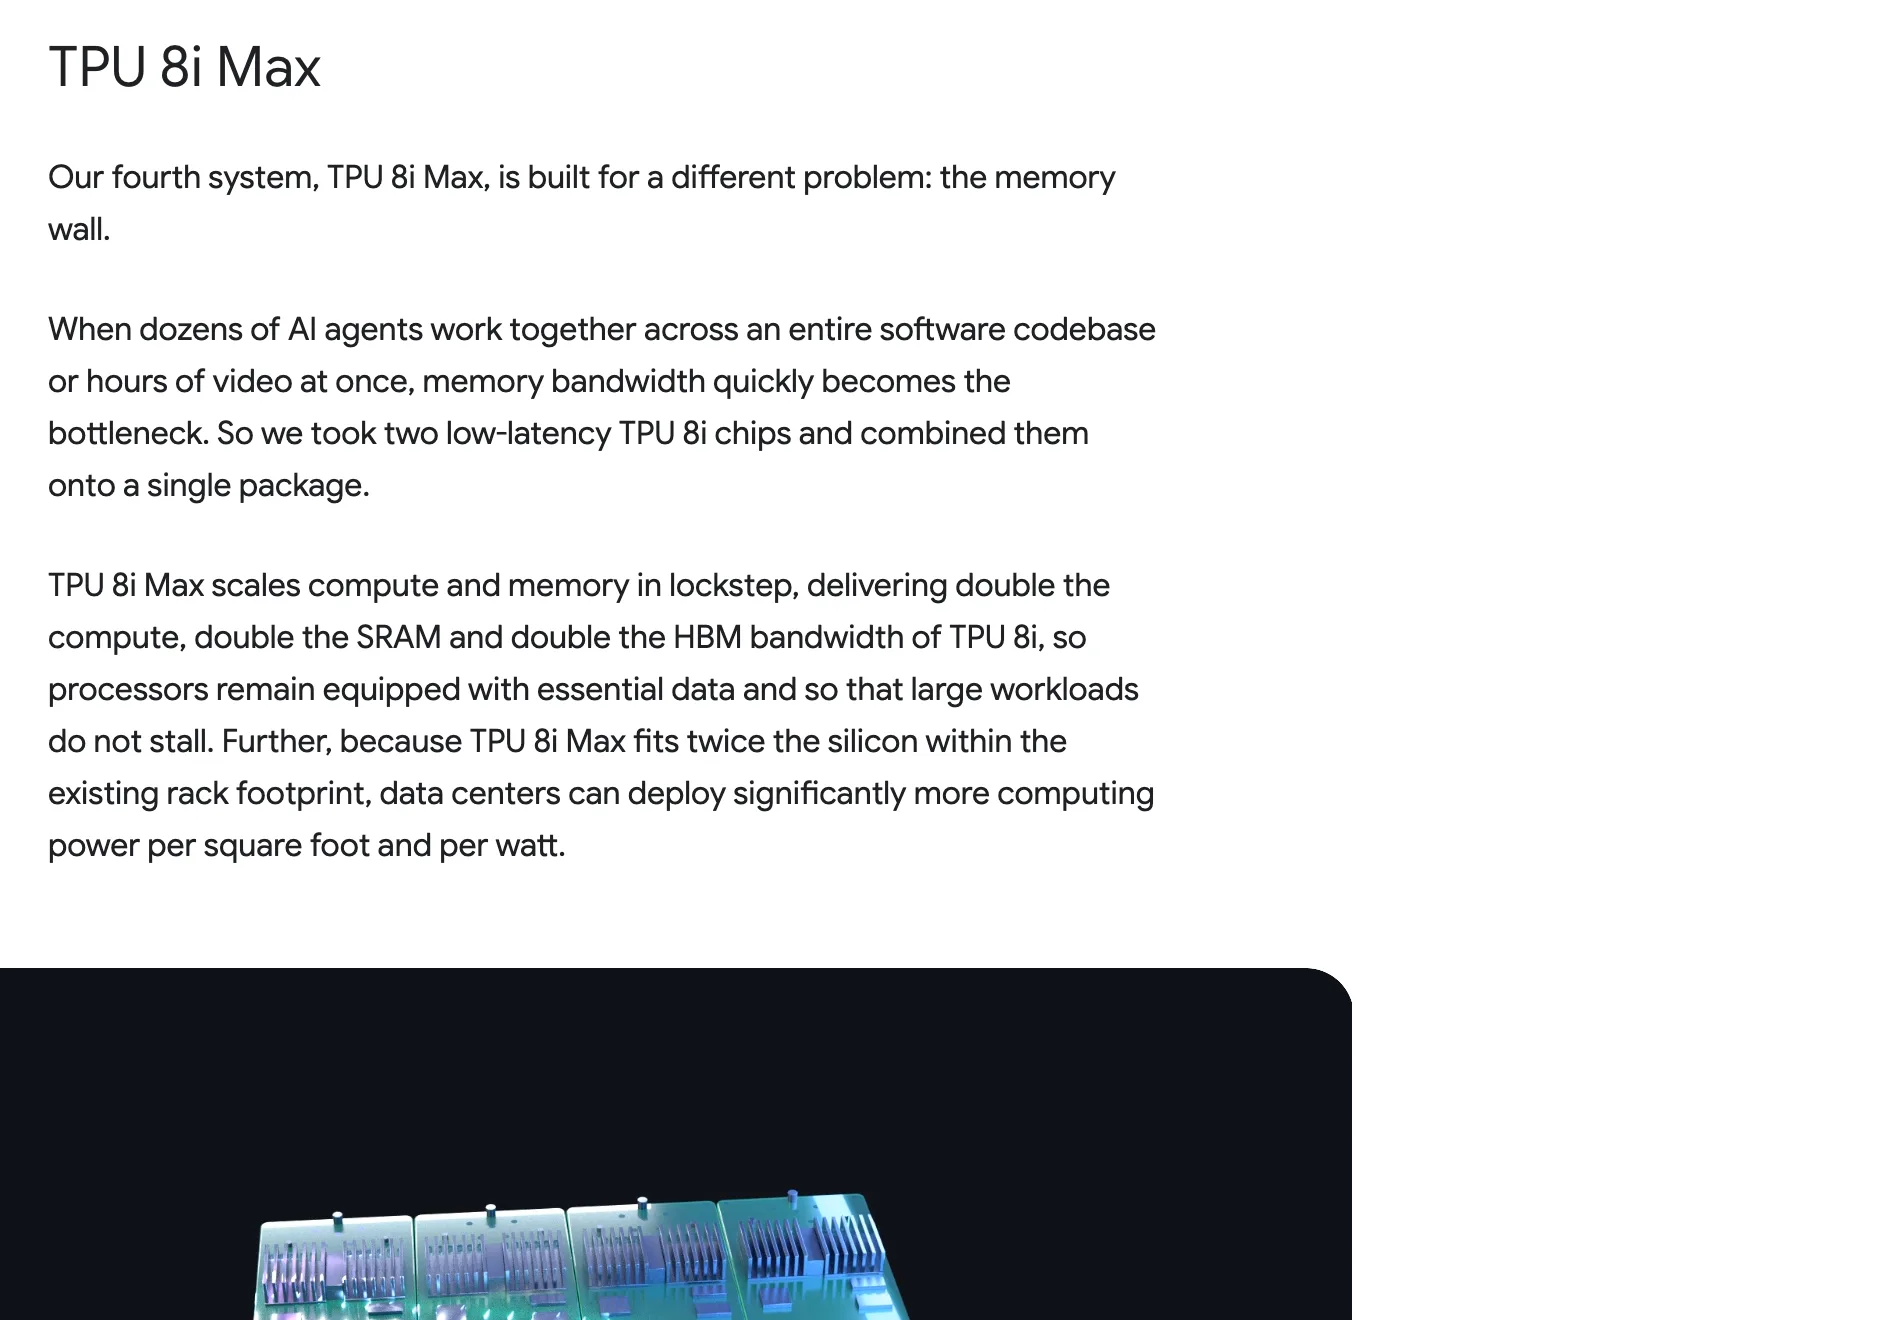
另一個新系統 8i Max 對付的是記憶體牆(memory wall)。這面牆 8i 在 4 月就碰過一次:官方當時把 8i 定位為推論引擎,設計重點就是打破記憶體牆,把晶片之間的通訊延遲最多砍半。8i Max 沿著同一面牆的另一個軸向推進。當幾十個 AI 代理同時讀整個程式庫,或一次處理數小時的影片,先撐不住的往往不是計算單元,而是資料搬不進來的速度。模型處理長內容時會保留先前的計算狀態以避免重算,這些快取隨著脈絡變長而膨脹,如果全擠在晶片記憶體裡,會反過來限制能同時服務的工作數量。處理器等資料的時間一長,算力再快也用不滿。這面牆不是只有 Google 在拆,NVIDIA 也發布過記憶體協同設計的部署拆解,頻寬與快取分層已經是各家 AI 加速器共同的主戰場。
Google 的解法是把兩顆 8i 晶片裝進同一個封裝。相較單顆 8i,8i Max 的計算能力、SRAM(靠近運算單元的高速記憶體)與 HBM 頻寬(高頻寬記憶體的資料傳輸速度)各為兩倍,讓大型工作負載不會在餵資料的階段卡住。這裡有個容易讀錯的地方:公告明寫的是 HBM 頻寬翻倍,全文沒有承諾 HBM 容量也翻倍。頻寬決定資料多快送到,容量決定多少東西放得下,兩個規格不能互相代換,評估長脈絡工作時要分開確認。
密度是另一個賣點。兩倍矽晶片塞進既有的機櫃空間,官方表示資料中心能在同樣的佔地與功耗下部署顯著更多算力,但公告沒有給出具體倍數。在電力與機房空間已經是資料中心擴建主要限制的現在,這個方向對超大規模部署者有感,對租用型客戶的意義則要等計價方式公布才知道。
第八代 TPU 現在有四套系統,分工按照 AI 生命週期切開:
| 系統 | 定位 | 關鍵配置 |
|---|---|---|
| TPU 8t | 大規模訓練 | 4 月登場,追求每瓦特有效算力(goodput) |
| TPU 8i | 低延遲推論 | 4 月登場,切入記憶體牆 |
| TPU 8tx | 機密推論與小規模訓練 | 8t 晶片、第五代 AMD EPYC 主機、Boardfly 網路 |
| TPU 8i Max | 超長脈絡與最高算力密度 | 兩顆 8i 裝進同一封裝 |
讀數字時有個陷阱要避開。4 月 Cloud Next 公布的「最高 2.7 倍訓練效能」屬於 8t,「推論成本效益改善 80%」屬於 8i,兩者都是當時對上一代 TPU 的比較。11 月的公告並沒有為 8tx 與 8i Max 附上同口徑的整體提升數字。把 4 月的倍數與 11 月的翻倍規格相乘,會得出官方從未說過的結論。8tx 的延遲宣稱是拿 8t 當基準,8i Max 的翻倍是拿 8i 當基準,各自保留各自的比較對象就好。
要自己驗收也有順序可循。長脈絡工作先記錄目前常見的輸入長度、同時工作數與等待時間,固定輸入與輸出條件後量等待時間、吞吐量與失敗率;機密推論則先確認保護範圍與金鑰由誰管理。沒有這組基準,之後拿到新配置的展示數字也無法判斷改善落在自己需要的地方。
順帶一提,TPU 出現的環境正在變多:官方把直接部署進客戶自家資料中心列為使用情境,2027 年起也會透過 Oracle Cloud 租用,甚至已有TPU 衛星在軌道上回傳第一個 AI 回應。同一種硬體面對不同客群,包裝方式跟著改變。
同一篇公告也整理了軟體進展,而且時點各自不同。TorchTPU 在上個月開源,PyTorch 程式與 Hugging Face 模型現在能原生跑在 TPU 上,vLLM 與 SGLang 兩個開源推論引擎也有現成後端。新的開源 XLA Serving Engine 則讓團隊用 Python 訓練模型後,直接以低延遲的 C++ 執行環境提供服務,同一套流程可以跨 TPU、GPU 與 CPU。官方還宣稱,在產業基準 InferenceX 與 AgentX 上,原生 vLLM 搭配 TorchTPU 的軟體棧在 TPU 上拿到同級最佳的成本效益,這同樣是官方口徑,獨立複現結果還沒有出現。
TPU agent suite 仍在預覽,它直接接上 Claude Code、Cursor 與 Google Antigravity 這類編碼工具,用自然語言完成 TPU 導入、診斷瓶頸與調校運算核心。針對代理暫停等待的情境,Agent Compute Engine 會自動暫停與恢復閒置的連線,代理停下來等資料庫、外部工具或人工確認時,不必持續佔用基礎設施。
針對長脈絡,Google 開源了 TPU Sync,把晶片上的 HBM、主機記憶體、共用儲存與資料中心網路視為同一個分層記憶體,自動把大型的 KV 快取(模型為長脈絡保留的先前計算狀態)移到晶片外,並在分離的預填與解碼節點之間傳送脈絡。官方宣稱這套機制把 KV 傳輸延遲與首 token 等待時間減少超過 90%。
另外兩項已經全面供應:Cloud Pathways 把 Google DeepMind 跑 Gemini 的執行環境帶進 Google Kubernetes Engine,用單一控制器調度多片 TPU,長時間工作遇到硬體中斷時能熱換切片續跑;GKE 動態切片用光學電路交換技術,把 TPU 動態組成更大拓撲或切成分散的小工作負載,官方宣稱工作啟動最多快 5 倍、故障恢復最多快 4.5 倍。這些軟體依附的是 Google Cloud 現有環境,對已經在用 TPU 的團隊來說,更新價值可能比等新系統開放更快落地。
blog.google 的公告與 Google Cloud 部落格當天的同文重刊,都沒有列出 8tx 與 8i Max 的租用價格、供應地區與開放時間,軟體功能的全面供應也不能當作新硬體已在各地上線的證據。這幾件事需要向 Google Cloud 的帳戶團隊確認,包括想租的配置在目標地區有沒有名額,以及尖峰時段的容量怎麼保障。
現在能做的準備因團隊而異。受監管產業跑私有模型的團隊,可以先整理機密運算的驗收問題:保護範圍涵蓋哪些資料、身分驗證機制是什麼、金鑰與管理權限歸誰。長脈絡工作卡在資料搬運的團隊,可以先建立前面提到的基準量測。至於一般小型推論,8i 的定位本來就是低延遲推論,不必因為新品名稱而更換架構。
這兩款系統值得回查的時點有兩個:Google Cloud 公布價格與供應條件時,以及出現獨立於官方的實測數字時。到時候再回來對照官方宣稱,延遲減半與近乎零損失這類數字才會有第二個來源。