TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

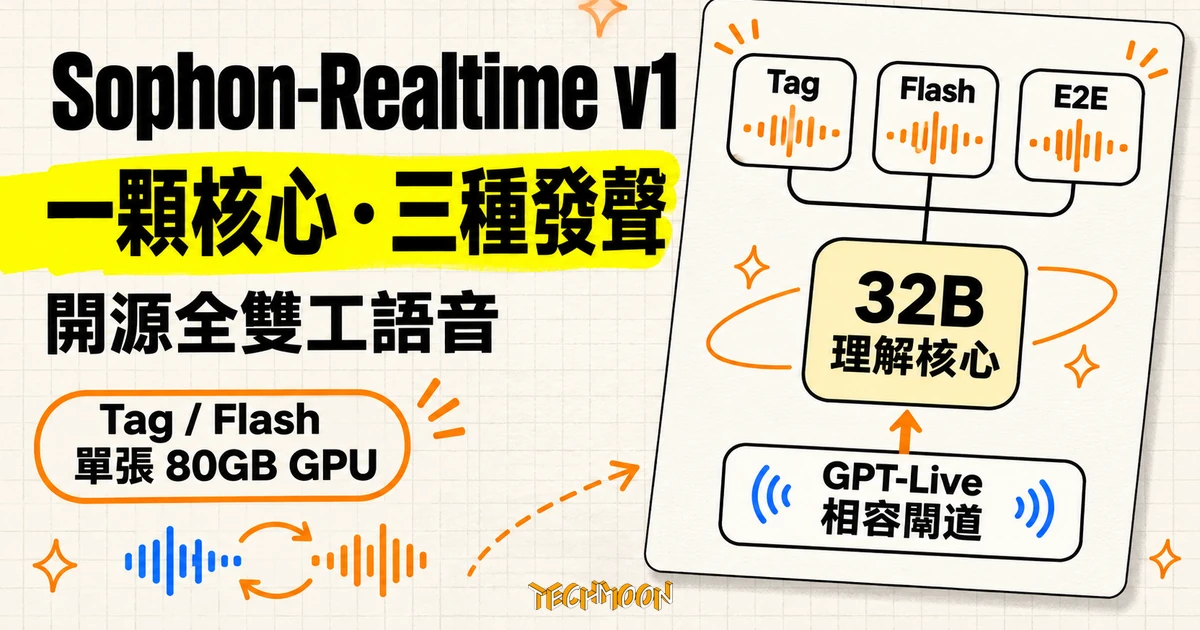
Adventists AI 於 2026-11-09 開源全雙工語音模型家族 Sophon-Realtime v1,程式與權重走 Apache-2.0:Tag 與 Flash 共用同一顆 32B 理解核心、差別在發聲層,一張 80GB GPU 分別約 16 人與 40 人同時在線;官方閘道提供 GPT-Live 與 OpenAI Realtime 相容入口,既有客戶端換網址即可改連自架引擎,但延遲數字有 H100 80GB、FP8 的測量條件,E2E 構成仍列研究預覽。
用 AI 摘要這篇文章:
2026 年 11 月 9 日,團隊名稱為 Adventists AI 的開發者組織公開了開源全雙工語音模型家族 Sophon-Realtime v1,程式碼與模型權重都以 Apache-2.0 授權釋出、開放商用。這套模型能邊聽邊說:你講話的同時它持續聆聽、在你停頓後接話、你插話時停下正在播放的回答,而且對話紀錄只保留你實際聽到的部分。發布節奏值得先記下來:Hugging Face 上的權重庫從 10 月 29 日起分批建立(Tag 構成先行),GitHub 儲存庫 11 月 4 日建立、11 月 9 日下午完成最後推送,ModelScope 官方帳號則在 11 月 9 日 21 時(臺北時間)貼出發布公告。也就是說,公開至今還不滿兩天,文件仍在高頻更新。
與 OpenAI 那套即時語音服務相比,這次方向反了過來。GPT-Live 是封閉服務(我們先前介紹過語音層和推理層分開計費的 GPT-Live-1 API),客戶端接的是 OpenAI 的雲端;Sophon-Realtime 把自己做成開源權重,再由官方閘道講 GPT-Live 與 OpenAI Realtime 兩種協定,讓原本寫給封閉服務的客戶端換個網址與金鑰就能改連自架引擎。對已經在語音代理上投入的團隊,這是這次發布最實際的相容性賭注:聲音層自己架,推理要交給哪個模型自己選。
官方模型卡把整個家族的核心設計講得很直白:三個構成共用同一顆大腦,同一個 320 億參數模型負責聆聽、判斷話輪、寫出回覆,差別只在回覆怎麼變成聲音。Tag 與 Flash 兩個構成走相同 API,之後要換聲音層不用重寫應用。
先看這顆大腦怎麼做事。官方的說明是:它持續聆聽,在每個停頓點用單一 token 判斷你已經講完、還要繼續講、正在附和、還是在思考;回覆草稿從你初次停頓就開始準備,等模型確定輪到自己才開始播放,如果你接著說話,還沒播出的草稿會直接丟棄。這套機制把「聽懂內容」與「決定開口時機」放在同一個模型裡,而不是外掛一個靜音偵測器,這也是全雙工與「先錄完、轉文字、再配音」的串接流程最根本的差別。打斷之後的處理同樣在核心裡:對話紀錄保存雙方實際播放過的音訊,你插話時只保留你真正聽到的部分,後續回覆不會把沒聽到的句子當成共同背景。
Tag 是官方建議的起點。大腦寫回覆時會附上笑聲、嘆氣、咳嗽、換氣這類聲音標籤,再交給表情能力較強的外部語音模型演出,標籤會變成真的聲音而非逐字念出。Flash 拿同一份標籤回覆,交給較輕、較快的語音模型,官方文件說它的發聲每 80 毫秒只做一次前向計算,因此首音更快、同一張卡能接待更多人。E2E 構成把發聲元件放進 32B 模型內部、不再有獨立語音模型,官方將其列為研究預覽。
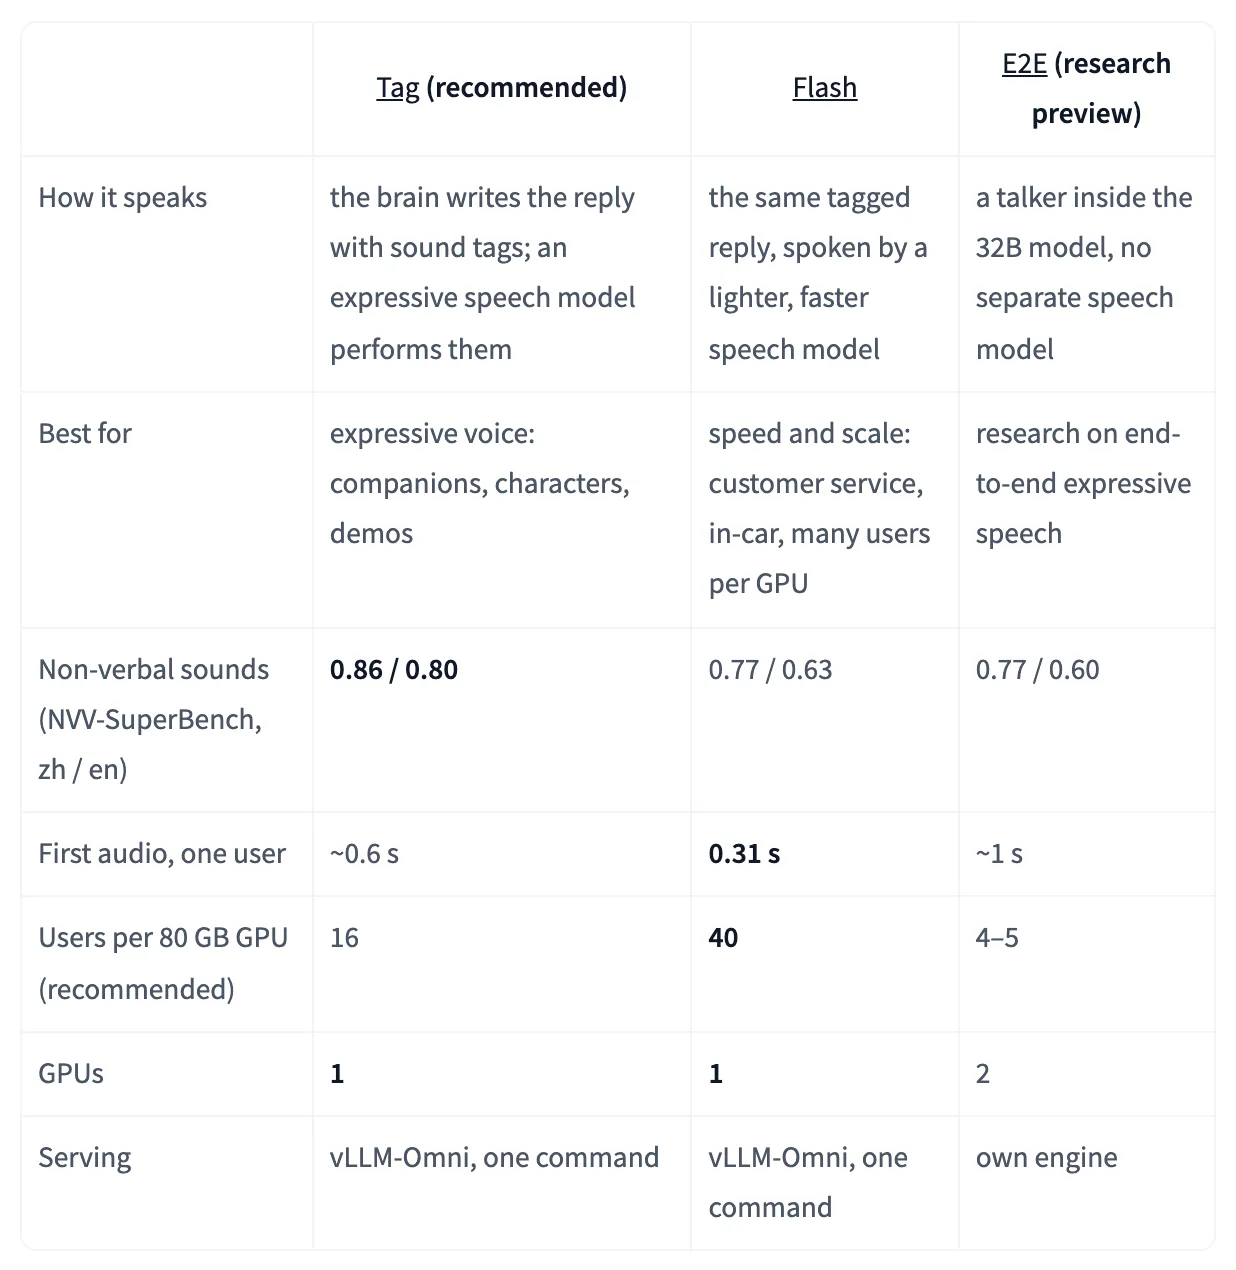
依官方對照表整理如下(非口說聲音分數為 NVV-SuperBench,每個聲音類別、每種語言各 50 題,由 Gemini 3 Flash 評審):
| 構成 | 發聲方式 | 單人首音 | 單張 80GB GPU 建議人數 | 顯示卡需求 |
|---|---|---|---|---|
| Tag(官方建議) | 外部表情語音模型演出聲音標籤 | 約 0.6 秒 | 約 16 人 | 1 張 |
| Flash | 較輕較快的外部語音模型 | 0.31 秒 | 約 40 人 | 1 張 |
| E2E(研究預覽) | 32B 模型內建發聲元件 | 約 1 秒 | 4 到 5 人 | 2 張 |
這張表的關鍵在讀法。NVV-SuperBench 中文分數 Tag 為 0.86、Flash 為 0.77,英文兩者為 0.80 與 0.63,代表表情豐富度確實有差;但兩者共用的理解與回答核心完全相同,官方在多個基準上只給一組分數也是這個原因。選 Tag 或 Flash 選的是發聲層的部署取捨,就像同一份劇本交給不同配音班底,換角不等於換編劇。要角色的笑聲與嘆氣有表演感,選 Tag;要等待更短、同張卡塞更多對話,選 Flash。E2E 目前兩張顯示卡只能服務 4 到 5 人,不會因為「端到端」三個字就自動更省硬體。
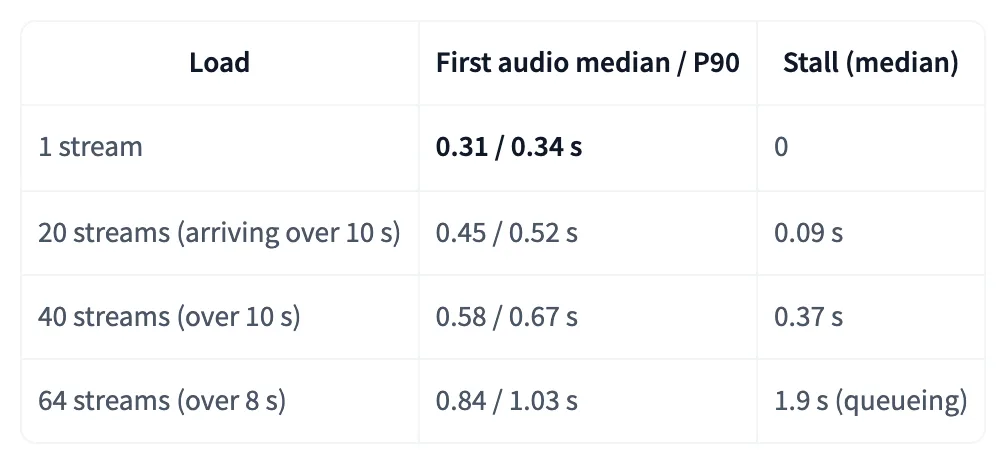
Flash 模型卡的效能表寫明了條件:一張 H100 80GB、理解核心採 FP8、走 /v1/chat/completions 端點、量的是使用者語音到首段輸出音訊。在這組條件下,單路首音中位數 0.31 秒(P90 為 0.34 秒);20 路請求在 10 秒內陸續抵達時,中位數升到 0.45 秒、出現 0.09 秒的播放停頓;40 路時為 0.58 秒、停頓 0.37 秒;64 路(8 秒內抵達)中位數 0.84 秒、排隊造成的停頓中位數達 1.9 秒。官方建議單張 80GB 顯示卡約 40 路以內,更多就一卡跑一個實例、前面掛負載平衡。
把單路 0.31 秒直接乘成服務能力會踩兩個坑。其一,請求是陸續抵達而非同一瞬間齊發,真實對話長短、插話與工具等待都會改變負載;其二,這個數字不含你自己的後端處理時間。ModelScope 發布貼文寫的「停頓後約 0.4 秒回應」屬於展示演示的口徑,與模型卡依構成分列的 0.31 秒(Flash)和約 0.6 秒(Tag)來源不同,轉述時最好對齊構成。
部署門檻也寫得清楚,而且有三個不同的數字要分開記:權重下載量約 42GB(用安裝腳本則約 45GB)、單一實例執行時約佔 55GB 顯示卡記憶體、官方建議的顯示卡是 80GB 級,下載量、執行佔用與建議規格並非同一件事,不能拿 42GB 的下載量反推 48GB 的卡就夠用。首次啟動要先編譯核心,Flash 模型卡量到的等待約 10 分鐘,Tag 腳本路徑官方則寫 15 到 20 分鐘,之後每次啟動 5 到 8 分鐘;執行環境是 Linux、CUDA 與 Python 3.12,推論引擎用 vLLM-Omni。換句話說,開放權重不代表下載一個檔案就能在任何筆電上跑,維運要安排暖機與就緒檢查,不能把初次啟動的等待算進對話速度。
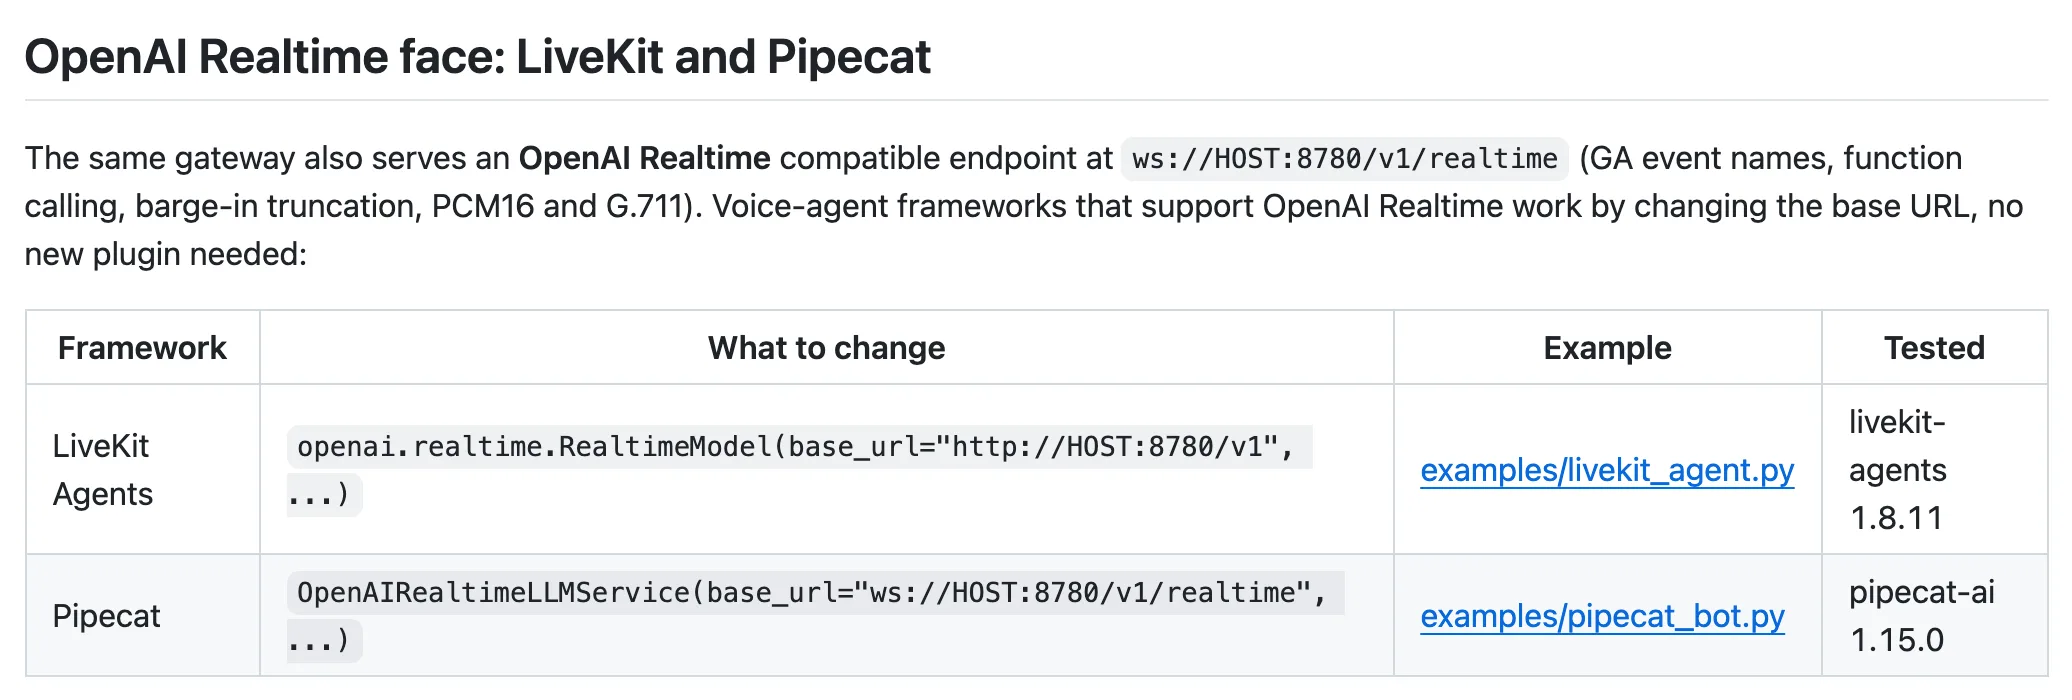
官方儲存庫裡的 live 目錄是一座閘道,對外講 OpenAI GPT-Live 協定(端點 /v1/live/sessions,含用戶端委派),同時另開一個 OpenAI Realtime 相容端點,支援 GA 事件名稱、函式呼叫、插話截斷與 PCM16、G.711 音訊格式。寫給這兩種協定的既有客戶端,理論上改 base URL 與金鑰就能連上自架引擎。官方實測過的框架版本是 livekit-agents 1.8.11 與 pipecat-ai 1.15.0,並量到 Pipecat 經閘道的延遲與直連 WebSocket 相同、LiveKit 差約 0.1 秒。
這座閘道最有意思的設計是委派流程。當問題需要查詢或動作,Sophon 會說一句「讓我查一下」,透過 session.delegation.created 事件把任務交給你的後端,等後端用 session.commentary.append 回傳後,再用自己的話說出結果;它也接受 session.thinking.append 塞進背景脈絡而不念出來。需要逐字稿時,閘道另外載入小型語音辨識模型 Qwen3-ASR-0.6B,約多佔 2GB 顯示卡記憶體,輸出逐字稿會跟著播放進度推進,字幕不會一次跑完整句而聲音還在半路。你也可以設定後辦公室模型讓更大的模型代做推理,官方量測的例子是接上 DeepSeek V4 Pro 後,Big Bench Audio 從 81.2 分升到約 83 分。聲音層與推理層就這樣拆開了:Sophon 留在通話中負責聽、決定話輪與開口,推理與工具呼叫可以是任何 OpenAI 相容端點背後的模型。閘道本身附一個瀏覽器測試頁,開麥克風就能看到委派卡片、示範後端與協定事件紀錄,驗收前先在這頁把事件順序看熟,比直接接正式客戶端省事。
官方也把已知限制列在文件裡,三件事在導入測試時要特別排進去。引擎剛啟動後的頭一個連線可能沒有回應,官方建議先跑一個暖機 session;模型有時會把能自己回答的問題委派出去,或者說了要查卻沒真的發出委派,官方 14 題測試中有 7 題屬可自行回答的題目,Tag 答對 6 題、Flash 答對 5 題,因此驗收不能只聽到「讓我查一下」就認定工具已執行,要核對後端事件;聲音標籤會出現在輸出逐字稿裡,產品要顯示字幕時得決定怎麼呈現,而不是把它當成模型要逐字念出的內容。
模型卡列出的一組數字可以先當同條件參考。VoiceBench 總分 82.8,官方註明用官方評審器、gpt-4o-mini 當評審,與 GPT-4o-mini-Audio 的 82.8 平手、低於 GPT-4o-Audio 的 86.8;同一張表裡的其他開放全雙工模型,MiniCPM-o 4.5 為 76.1、Freeze-Omni 為 55.2、PersonaPlex 為 30.6、Moshi 為 29.5,官方據此稱它在開放全雙工模型中名列前茅,這個說法能否採信,取決於分數的量測方式。Big Bench Audio 81.8%,量法是把口說答案轉成文字後交給 gpt-4.1 評審,同一張表裡 GPT-Live-1 是 90%(取自 Artificial Analysis 榜)、其餘開放模型最高 58%。聽語氣的能力(LISTEN 加 StressTest 加 MSPB 合計)48.6 分,官方排在 Gemini 3.8 Flash 的 46.9 與 Qwen3-Omni 的 44.6 之前(語音代理該不該只看逐字稿,可參考我們先前對 Tazo 的介紹),而它的耳朵是同團隊 9 月底起陸續開源的語音判斷模型 DuplexJev,這條產品線的累積讓「副語言理解」不像憑空冒出的單點能力。工具呼叫用 Full-Duplex-Bench v3 量測,使用 100 題真實非流暢語音的多步工具任務、由 GPT-4o 評審,Pass@1 為 48%、官方註明取多次測量中最好的一次,另外 100% 回應率只代表該回應時有回應,不等於任務完成;同表 GPT-Realtime 為 60% 與 96%、Grok 為 43%。
這些分數的共通點要放在心上:幾乎全部由官方自行量測或取多次最佳,對手分數取自第三方榜,評審模型也不一致。它們能說明「這顆大腦在同條件下有競爭力」,不能直接當成獨立驗證或實際通話滿意度。中文與英文分數也只涵蓋官方測項,臺灣常見的中英混說、口音與環境噪音,官方沒有給量測結果,要用自己的錄音另外驗。
只想聽聽效果的人,最快路徑是 ModelScope Studio 的線上試聽頁,不需要任何顯示卡。已經有 80GB 級 GPU 與語音系統開發能力的團隊,官方給的路徑是 pip 安裝套件後一行指令啟動服務(首次執行會先下載約 42GB 的 Tag 權重,服務開在 8000 埠),對外提供全雙工的 /v1/realtime WebSocket 端點與音訊輸入、文字加音訊輸出的 /v1/chat/completions 端點,儲存庫也附了用 wav 檔提問的範例客戶端,先用錄音檔離線驗再開麥克風最省事;想接既有代理再在旁邊啟動 live 閘道。測試順序建議先窄後寬:先用自己的錄音驗停頓、改口與插話後接話是否正確,再逐步拉同時上線人數,同時記錄首音中位數、慢速請求與播放停頓,工具驗收先用只回固定資料的模擬後端,方便核對委派是否真的發生。要調整人格、語氣或領域知識,官方提供 ms-swift 的 LoRA 微調流程,一張 80GB 顯示卡就夠,聲音與話輪行為維持原樣。至於沒有 GPU 維運能量的個人或少人團隊,這週不必急著動,等社群跑出更多實測或雲端代管方案再評估也不遲。
這個家族還有幾件事懸著。E2E 構成仍是研究預覽,儲存庫 11 月的更新把它的解碼器換成四步驟新版,官方量測 150 則長回覆的錯誤率從 1.78% 降到 1.51%(中文、英文、日文分別為 0.97%、0.71%、2.86%),對未見過說話者的聲音相似度從 0.33 升到 0.52,這條路線會不會轉正、何時轉正,官方沒有給時間表。所有基準分數都還沒有第三方獨立重現。對臺灣場景最相關的中文口音、中英混說與噪音表現,目前只有官方的 zh 與 en 分數可用,自建驗收不可省。截至 11 月 10 日,GitHub 儲存庫上線約一週、約 118 顆星,Hugging Face 家族頁 72 個讚,採用還在非常早期。各項數字以 11 月 9 日版的模型卡與儲存庫文件為準,官方在同一天更新過全部四個權重庫;建議一個月後(或下一版模型卡發布時)回查延遲、同時連線與授權條款有無變動,再決定要不要把它排進正式架構。
程式碼與權重都以 Apache-2.0 釋出、開放商用,第三方元件依各自的 NOTICE 保留授權說明;商業合作聯絡方式在模型卡頁尾。要注意授權涵蓋的是模型與程式,任意聲音、人物形象與輸入錄音的使用權利仍要自行取得。
參考來源:Sophon-Realtime v1 家族模型卡、Sophon-Realtime-32B-Flash 模型卡、sophon-realtime 儲存庫、Live 閘道文件、ModelScope 發布公告、DuplexJev 專案。