TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

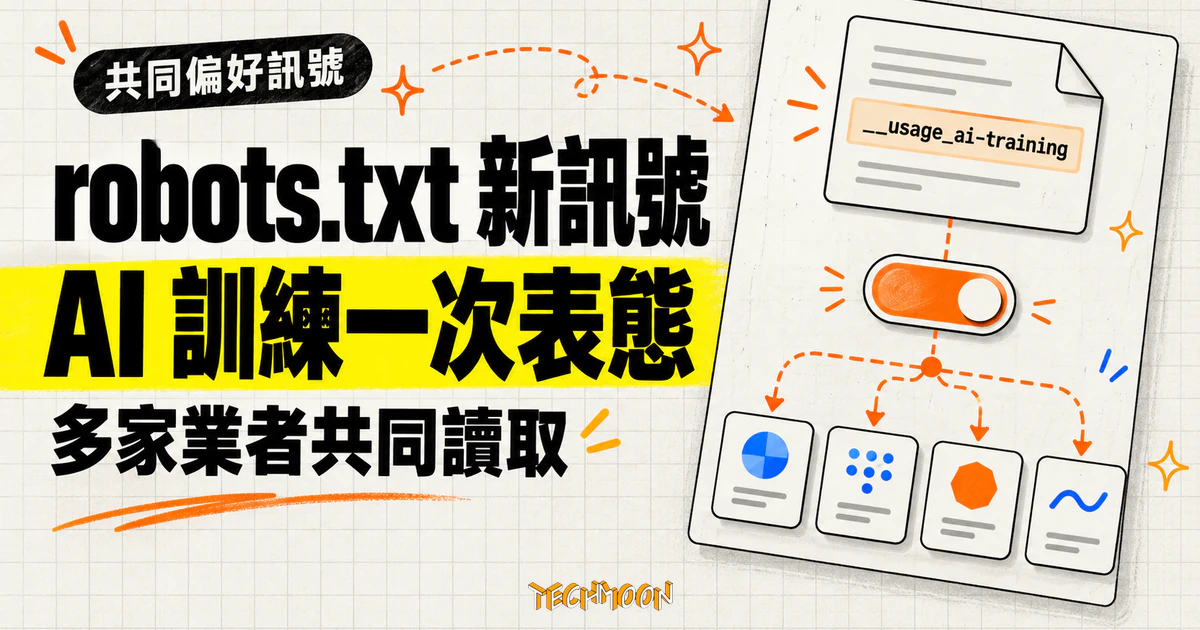
OpenAI 在 10 月 30 日宣布將遵循 robots.txt 裡一個跨廠牌的共同訓練偏好訊號,讓網站用一份設定對多個參與的 AI 業者表達「內容能不能拿去訓練」。訊號由任職 Anthropic 的 Kevin Kelley 以個人草案提交 IETF,OpenAI 的時間表是未來幾個月內實作,草案作者同日表示 Anthropic 已開始實作但尚未完成,截至 10 月 31 日連 OpenAI 自家 robots.txt 都還沒有這個欄位。整理公告承諾、訊號設計與標準化進度,說明實作上線前網站為什麼先不用改設定。
用 AI 摘要這篇文章:
OpenAI 在 10 月 30 日宣布,將遵循 robots.txt 裡一個跨廠牌的共同訊號,讓網站用一份設定,對多個參與的 AI 業者表達「內容能不能拿去訓練」的偏好。robots.txt 是網站放在根目錄、給自動程式讀取的規則檔,搜尋引擎與各種爬蟲進站前會先看它,這個檔案也是網站與自動化世界之間最老牌的溝通介面。
不過這則消息的實際行動結論是:現階段什麼都不用改。訊號還沒有任何一家完成實作:OpenAI 給的時間表是「未來幾個月」,實作完成時會再發布細節;草案作者同日表示 Anthropic 已開始實作,但要涵蓋各項服務還需要時間。截至 10 月 31 日查核,OpenAI 自己官網的 robots.txt 也還沒有加上這個欄位,它提供給網站管理者的爬蟲說明頁同樣未提及此訊號。對網站管理者來說,此刻最有價值的動作是把這則公告讀懂,把追蹤點記下來,設定檔先保持原樣。
要理解這次公告在解決什麼,先看現況。以紐約時報為例,截至 10 月 31 日,它的 robots.txt 有 69 行 User-agent、150 行 Disallow,同樣的表態邏輯對數十種自動程式各寫一次。與 AI 直接相關的權杖就包括 OpenAI 的 GPTBot 與 OAI-SearchBot、Anthropic 的 ClaudeBot 與 Claude-SearchBot、Google 的 Google-Extended、Meta 的 Meta-ExternalAgent,以及 PerplexityBot、CCBot、Bytespider 這類抓取程式。
打開這份檔案,會看到同樣的句式重複數十次:一行權杖名稱,配一行允許或拒絕的路徑,換下一家再來一次。這種維護方式有兩個實際成本。名稱追蹤的成本:每當有業者新增一隻爬蟲,網站團隊就要注意到它、查它的用途、決定要不要為它加一段規則,大型網站的規則檔因此逐年膨脹。語意重複的成本:如果想對十家業者表達同一句「不要拿去訓練」,在現行機制下得寫十段幾乎相同的規則,而 robots.txt 有檔案大小的限制,重複本身就會佔掉空間,這也是後來這份共同訊號草案列為設計目標的問題之一。
值得注意的是,這些權杖裡有一種管理的其實不是爬取,而是用途。草案把既有業者自行發布的這類權杖稱為「專屬政策欄位」,草案作者也在說明信點出,確有爬蟲業者發布的是控制內容用途、而不是控制哪隻爬蟲能抓的權杖。這種做法已經部署在網路上,只是每家各自命名、各自定義,網站想同時對多家表態,仍然要逐家查名稱。從爬蟲那一側怎麼讀規則、怎麼把網站轉成模型可用的素材,可以參考我們先前實測的 Crawl4AI 開源爬蟲;至於繞過規則直接用帳號抓取平台內容的另一種爭議,則記錄在 MediaCrawler 小紅書爬蟲 的分析裡。
OpenAI 這次宣布支援的,就是把「用途權杖」這個既有做法通用化:換成一個由參與業者共同讀取的欄位名稱,寫一次就完成過去要寫十次的表態。
公告本身相當短,重點可以整理成四件事。
最核心的承諾是遵循:OpenAI 說將尊重這個共同訊號,並把它定位為自願性合作,目的是讓出版者與網站經營者「一次向多個參與供應商傳達相同偏好」。公告回顧了過去的做法:網站經營者要逐一辨識各家爬蟲、為每個供應商分別維護規則,而一個跨供應商的共用訊號能減少這些重複工作。
時間表則是「未來幾個月」內實作,完成時會再公布實作細節。換句話說,這是意圖宣告,發布當天沒有任何產品或系統真正開始讀這個訊號,宣布支援與已經支援之間,隔著一段要看後續公告的等待期。
公告也特別強調,新訊號「不會取代」既有控制,現行透過 robots.txt 提供的爬蟲控制會繼續適用並被尊重。這一句對網站管理者最重要:既有規則不是等著被替換的過渡品,不需要為了迎接新機制而預先清空。
在標準化的脈絡上,OpenAI 說這項支援建立在 IETF「AI 偏好」工作群組的既有討論上,提到自己是「與工作群組其他參與者一同」宣布這個共同訊號,並鼓勵其他 AI 業者也尊重它。除了 OpenAI 之外,還有哪些業者以何種形式跟進,公告沒有附上名單,各家頁面需要逐一驗證,這部分目前適合保持觀察,而不是照媒體標題直接寫成幾巨頭同步表態。
時間軸也值得記下來。草案提交與 OpenAI 的公告發生在同一天:草案作者在 10 月 30 日 15 時 39 分(UTC,台北時間晚間 11 時 39 分)把文件發上工作群組的郵件列表,OpenAI 的公告同日上線。技術文件與廠商表態在同一天出現,也提醒讀者:這則新聞的主角是那份文件,單看任何一家的公告稿,會漏掉它的身分與進度。
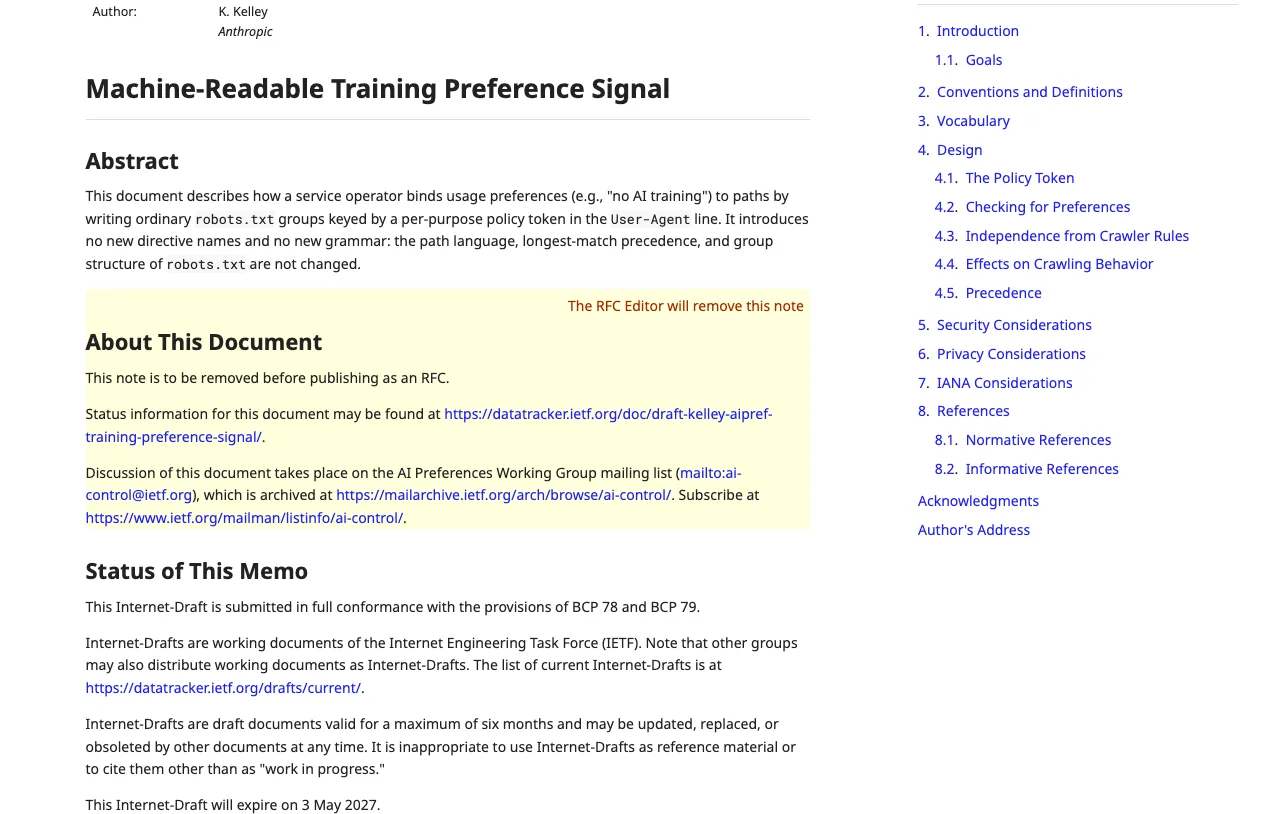
在訊號真正上線前,與 OpenAI 互動的規則仍以現行文件為準。OpenAI 的爬蟲說明頁把用途分開處理:允許 OAI-SearchBot 可以出現在搜尋結果,同時對 GPTBot 設限,則表示抓到的內容不應用於訓練其生成式基礎模型;兩個設定彼此獨立,站方可以「要搜尋曝光、不要訓練」。文件也提醒,兩者都允許時,OpenAI 可能共用同一次抓取的結果來避免重複爬行,這意味著日誌裡少了某隻爬蟲的紀錄,不等於內容沒有被用於另一種用途。
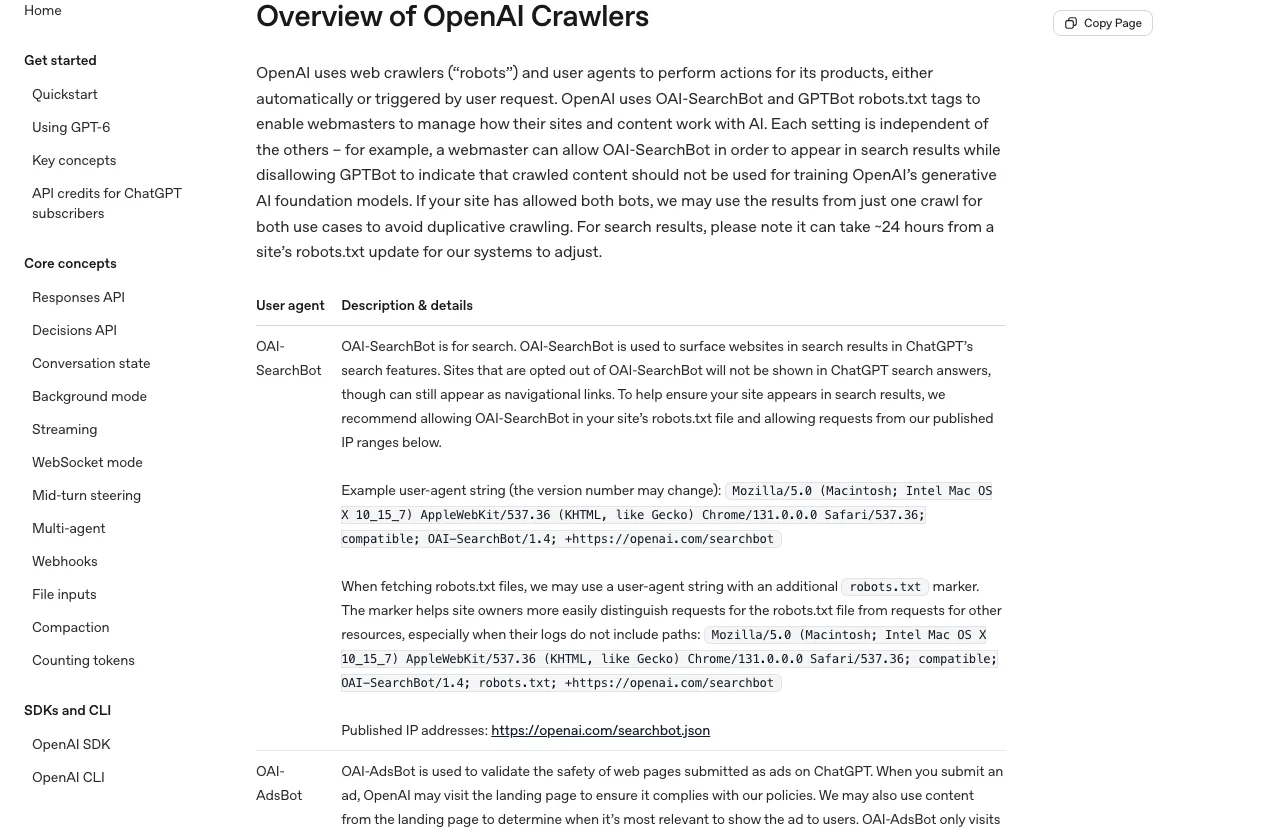
支撐這則新聞的原始文件,是一份 10 月 30 日提交的網路草案。它的設計可以用三行程式碼說明:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
這段的讀法是:整站表達「反對用於 AI 訓練」的偏好,唯獨 /press-kit/ 目錄表達「贊成」。幾個設計細節值得拆開看。
它沒有發明新語法。規則照舊使用 robots.txt 的群組、路徑與 Allow、Disallow 指令,只是 User-Agent 欄位寫的不是某隻爬蟲的名字,而是一個「政策欄位」:__usage_ai-training。草案在定義裡寫明:這個欄位不必出現在任何對外請求的 User-Agent 標頭裡。也就是說,它是一個供應商辨識偏好用的記號,不是新的爬蟲身分,未來在伺服器日誌裡找不到叫這個名字的訪客,屬於正常現象,不能據此判斷訊號有沒有被讀取。
偏好與爬取是兩層。政策欄位表達的是「內容拿去做什麼」的態度,不是「能不能進站」的許可。各家爬蟲對自己名稱的規則照舊生效,兩者刻意分開,草案甚至允許只為某種用途抓取的爬蟲,看到反對偏好時連抓都省下來。這對想保留搜尋曝光的網站很實用:開放搜尋爬蟲進站,同時對訓練用途表達反對,兩個決定互不干擾。搜尋與 AI 檢索可見性的整體健檢,可以搭配 AITDK 瀏覽器擴充功能 一起看。
不寫等於沒表態。草案明確規範:檔案裡沒有這個欄位,就是「沒有透過這個機制表達偏好」,其他規則維持原本的意義。這避免了把沉默解讀成同意或反對的爭議。萬用群組也不會被當成表態:現行最常見的 User-agent: * 整段規則,不會被解讀為對訓練偏好表態,這是草案刻意的設計,避免既有檔案在網站主人不知情的情況下突然長出新的意義。
路徑可以差別待遇。因為沿用既有的路徑比對與最長匹配規則,同一個網站可以讓新聞稿目錄開放訓練、研究內容反對,或任何反向組合,前提是路徑真的對應內容的邊界。另外,草案保留既有安排的優先性:網站與特定業者若另有合約,或已使用該業者的專屬用途欄位,那些安排的意義不變,特定表態優先於一般表態。
這份草案的另一個事實層次,是它的身分。文件作者是 Kevin Kelley,任職於 Anthropic;草案於同日提交,作者隨後在 10 月 30 日 15 時 39 分(UTC,台北時間晚間 11 時 39 分)於工作群組的郵件列表宣布,版本編號 00,到期日是 2027 年 5 月 3 日。
在 IETF 的制度裡,這是一份個人網路草案:仍在討論與修改階段,文件頁面明確標示這類草案不應被當成參考素材以外的定案,也未獲 IETF 背書,在標準程序中沒有正式地位。作者自己在說明信裡也定位得相當保守,稱它是對工作群組「附件機制」工作的一項輸入,並計畫以提取請求的方式併入群組文件。換句話說,即使是草案本身,也未承諾以目前的形式成為最終規範。
說明信裡還有一個值得記下的進度:作者表示 Anthropic 已開始實作對這份草案的支援,並說這與既有爬蟲控制是互補而不是取代,但要涵蓋各項服務、處理各種邊界情況還需要時間。這也是為什麼「已開始」不等於「已完成」,實作進度要逐家分開看。 不過它並非空降。IETF 的 AI 偏好工作群組是真實存在的活躍群組,隸屬 Web 與傳輸領域,章程已經通過,目標是產出表達 AI 相關偏好的詞彙標準,以及把偏好附著到內容的機制標準;詞彙草案已推進到第 08 版。草案的致謝名單也反映了這個群組的組成:主席來自 Cloudflare 與 Cisco,個別參與者來自 OpenAI、Google、Microsoft、Meta、News Corp、英國廣播公司、電子前哨基金會等數十個單位。 __usage_ai-training 對應的「AI 訓練」定義,就直接取自群組的詞彙文件:把資產用於調整生成式模型的學習參數,且不含單純做分類或排序的模型。這個邊界讓「搜尋排序用到的模型」與「生成內容的模型」分屬不同類別,也呼應了前一段「偏好與爬取分開」的設計。
所以準確的說法是:OpenAI 宣布要遵循的,是由任職 Anthropic 的 Kevin Kelley 起草、放在 IETF 標準化軌道上討論的個人草案。廠商表態與標準進度是兩件事,前者已經發生,後者還在走,兩者不該被合併成「標準已經誕生」的敘述。
把公告、草案與現況對齊後,網站管理者現階段的行動清單很短。
不需要動設定的部分:既有 robots.txt 裡對各爬蟲的規則全部保留;想繼續出現在 OpenAI 搜尋結果的,OAI-SearchBot 相關規則照舊;對特定業者的專屬用途權杖(例如 Google-Extended)若已經在使用,它們的意義不受新機制影響。
不建議現在做的有兩件事。把規則檔換成新欄位,或刪掉既有段落:訊號尚未有任何一家完成實作上線,過早改寫等於放棄現行唯一有效的控制。把「加了一段偏好」當成「封鎖所有 AI」的保證:公告與草案都不支持這種延伸,這是自願遵循的表態機制,對未參與的業者沒有約束力,也不是收回既有訓練內容的機制。
日誌判讀也有兩個容易誤判的地方。使用者主動要求而發生的造訪(例如使用者透過 AI 工具打開某個頁面)本來就未必受 robots.txt 約束,OpenAI 文件對 ChatGPT-User 的說明就屬於這一類,看到這種請求不能直接推定為訓練抓取。反過來說,規則檔裡寫了偏好,只能證明網站把態度發布出去,業者是否讀取、怎麼落實,要看對方文件與可觀察的抓取行為,兩個方向的推論都要保守。
值得排進追蹤的驗證點有三個。OpenAI 承諾的實作細節公告,是判斷訊號何時真正開始被讀取的時間錨點。訊號落地後各業者文件的實際行為,包括既有規則如何與新欄位並存、有沒有業者給出不同的解讀,需要對照著讀。草案本體的演進也要留意:個人草案六個月到期,接下來的改版或併入群組文件,都可能調整欄位名稱或匹配規則,照抄今天的語法之前值得再確認一次。
回到主軸:這次公告改變的是表態的成本結構,不是控制力。一份設定對多家業者生效的日子可能真的會來,但在它落地之前,網站最有力的動作仍然是把現有規則寫清楚、看明白公告走向,而不是搶先部署一個還沒有讀者的訊號。