TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

MediaCrawler 用你自己的帳號登入,把小紅書、抖音、微博等七個平台的貼文與評論收進本機檔案。它的原始碼公開、安裝路線清楚,但授權採非商用學習條款,預設單次 15 則,多帳號與代理池等生產能力放在微信訂閱的付費版,商用與放量的線畫得很明確。
用 AI 摘要這篇文章:
在 GitHub 找 Python 爬蟲,星數領先的那幾個名字裡,有兩個走的是完全不同的路。我們先前介紹過的 Crawl4AI 給你一套開源授權的通用框架,對象是公開網頁,輸出拿去餵 AI 或抽結構都可以;同樣落在六萬顆星量級的 MediaCrawler,則把目標鎖在小紅書、抖音、快手、B 站、微博、貼吧、知乎這七個平台,靠你自己的帳號登入,把貼文、評論、創作者資料收進本機。判斷先講:它是一份完整可讀、安裝路線清楚、真的能跑的工程樣本,也是自用小規模研究的順手工具;但它同時把「不得商用、不得大規模爬取」寫進了授權條款、預設值和付費版的切分裡,這條商業線比多數工具都畫得明白。
MediaCrawler 的能力一句話講完:用關鍵字搜尋、指定貼文 ID、指定創作者主頁三種方式找到目標,把整篇貼文和評論(含樓中樓回覆)抓下來,另外能把評論做成文字雲。七個平台在 README 的功能對照表裡都支援同一套流程,操作介面完全一致,換平台只要換一個啟動參數,從小紅書換到微博是 --platform xhs 改成 --platform wb 的差別而已。
抓下來的東西長什麼樣,可以直接看資料庫寫入的欄位定義。以小紅書為例,一則貼文會存進這些欄位:創作者的暱稱與雜湊值、貼文 ID、類型、標題、內文描述、影片連結、發布與更新時間、按讚收藏留言分享四種互動數、圖片清單、標籤清單、貼文網址、觸發這次爬取的搜尋關鍵字。做內容觀察的人看一眼這組欄位就知道:追主題熱度、比較互動結構、建自己的小型語料,都夠用。
登入方式有三種:掃 QR code、手機號碼加驗證碼、貼上既有的 Cookie,預設走 QR code。要緊的是帳號是你自己的。整個專案沒有帳號池,也沒有共用登入的設計,登入的就是你的小紅書、你的抖音,之後所有爬取行為都掛在這些帳號上。登入成功後的瀏覽器狀態會留在專案資料夾裡,下次不用重掃。這裡有個小坑:官方文件把這個資料夾寫成 brower_data,程式碼實際建立的是 browser_data,照文件的拼法去找會找不到。官方換帳號的教學也很直白:把資料夾刪掉重來。倉庫裡還附了一支 recv_sms.py 小工具:一個跑在本機的服務,接收你從手機轉傳過來的簡訊通知,自動抽出六位數驗證碼放進快取,讓手機登入流程不用人守著。從這些小工具的設計可以看出整個專案假設的使用情境:單人、自己的裝置、自己的帳號。
媒體下載(封面、影片、圖文圖片)預設關閉,打開後按貼文 ID 分資料夾存放,封面存成 cover.jpg、影片存成 video.mp4、圖文圖片依序編號,已存在的檔案會跳過。B 站要拿到最高畫質得另外裝 ffmpeg 走 DASH 路線,音訊和視訊分軌下載再無損合流,沒裝 ffmpeg 會自動退回 MP4 直連,檔名也會不一樣好讓你分辨;畫質參數在 bilibili_config.py 裡調,預設 80 對應 1080p,權限不足時自動逐級往下降。下載是逐筆序列進行,README 對此的說法是避免對平台 CDN 造成壓力;媒體下載支援小紅書、抖音、快手、B 站、微博五個平台,貼吧和知乎的資料結構裡沒有媒體欄位,所以不在支援範圍。能輕,能小,能不吵就不吵。
寫平台爬蟲最燒時間的一步,是把 App 或網頁內部的簽名演算法逆向出來。MediaCrawler 的 README 把自己的思路總結成「不必逆向加密」,實際翻原始碼會看到各平台已經分流成好幾條路:快手真的照這個思路走,在登入頁面裡執行 JavaScript 表達式拿回簽名;小紅書用的是內建的 xhshow 演算法,簽名直接在本機算出來;B 站的 wbi 簽名是純 Python 的 md5 實作,瀏覽器只負責取金鑰;微博這條線沒有簽名步驟;抖音和知乎則在倉庫內附了 douyin.js 與 zhihu.js 兩支簽名腳本,透過 execjs 丟給本機的 Node.js 執行,所以爬這兩個平台前要先裝 Node.js 16 以上。官方常見問題頁收了好幾條「缺少 Node 環境」的錯誤案例,錯誤訊息長得像程式碼寫壞了,其實都只是沒裝 Node。
從原始碼看,除了貼吧之外的六個平台在標準 Playwright 模式都會注入 stealth.min.js,一份常見的反自動化偵測腳本,讓自動化開出的瀏覽器看起來更像真人環境;抖音在 CDP 模式下也會補上同一份腳本。更關鍵的是預設打開的 CDP 模式:程式不自己開一個乾淨的瀏覽器,而是連到你平常在用的 Chrome(144 以上版本,先在 chrome://inspect 勾選允許遠端除錯),直接沿用裡面的 Cookie、登入狀態、擴充功能和瀏覽歷史。官方常見問題頁對這個設計的理由講得很直白:連接真實瀏覽器時,平台很難分辨這是自動化操作還是真人行為,被風控偵測的機率大幅下降;開一個乾淨的新瀏覽器,反而更容易被認出來。第一次連線時 Chrome 會跳出確認對話框,六十秒內按下接受就繼續。
不喜歡讓爬蟲碰日常瀏覽器的人有退路:把設定檔裡的 ENABLE_CDP_MODE 改成 False,退回標準 Playwright 模式自己開瀏覽器,代價是更容易踩到驗證關卡;另一個折衷是 CDP_CONNECT_EXISTING 設成 False,讓程式透過 CDP 協定啟動一個新的瀏覽器實體,登入狀態照樣保留。實際被風控攔下的機率多高,目前沒有可信數字,流通的說法都屬於個案回報。
不少介紹文把 MediaCrawler 稱為開源爬蟲,但它的 LICENSE 檔不是任何一種 OSI 認可的開源授權,而是作者自訂的非商用學習授權,連 GitHub 的自動授權偵測都顯示為無法辨識。條款給的權利是:免費、非專屬、不可轉讓,僅限學習與研究目的的使用、複製、修改與合併;限制則寫得很白:不得做大規模爬取或干擾平台營運,未經作者書面同意不得用於商業用途。授權條款之外,每支程式檔頭的聲明另要求遵守目標平台的使用條款與 robots.txt。條款同時指定爭議由作者所在地法院管轄,對打算拿去做生意的人來說,這一條加上非商用限制,等於提前把路封住了。
授權之外,預設值說的是同一件事。打開 config/base_config.py:單次爬取上限 15 則貼文、單則貼文評論上限 10 條、每筆請求之間睡眠 2 秒,資料預設存成 jsonl。評論爬取倒是預設就開著,文字雲的開關預設關閉,要用再自己打開。這組數字和條款指向同一個方向:尺碼停在個人小規模試用,想衝大流量得另找工具。
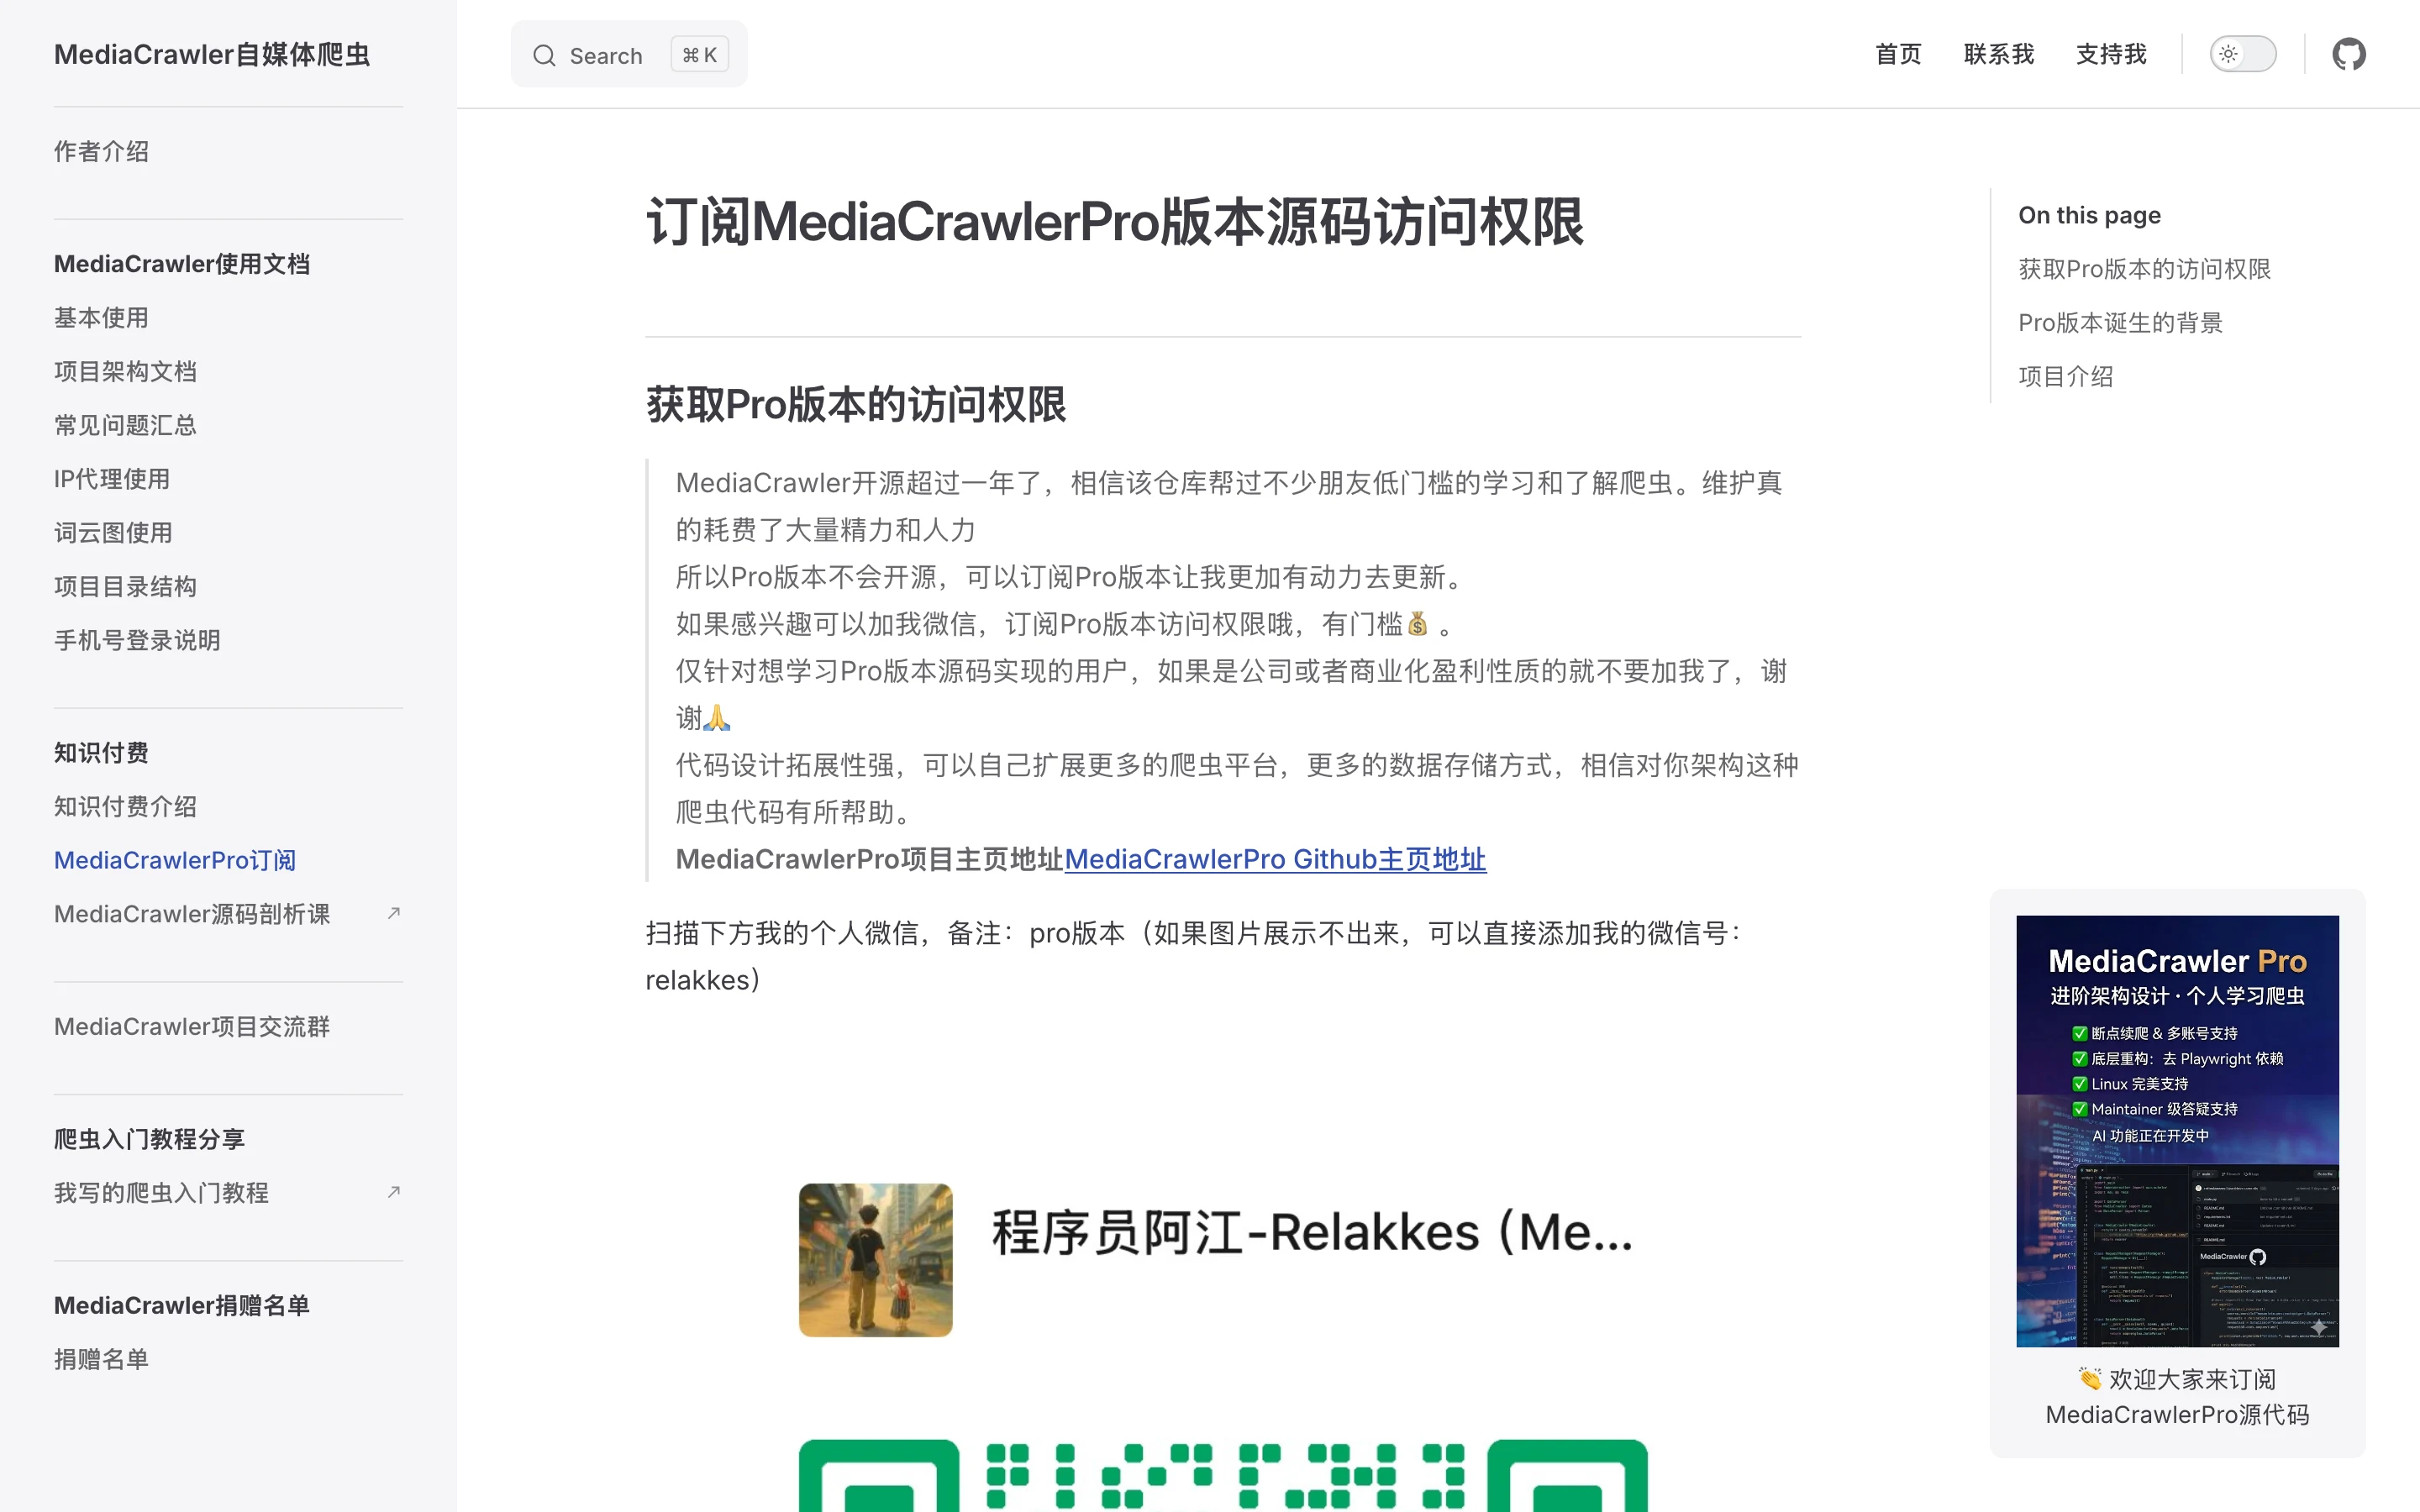
真正需要多帳號、IP 代理池、斷點續爬這些生產能力的版本叫 MediaCrawlerPro,原始碼不公開,採加作者微信洽談訂閱的方式,沒有公開價目,說明頁還明講只服務想研讀原始碼實作的個人,公司或商業化用途請不要來。官方文件站對 Pro 誕生背景的說法是:開源版收到大量「能不能多帳號、能不能上 Linux、能不能去掉 Playwright」的需求,直接在原專案上動刀會讓維護越來越難,所以整個重構放進了付費版,順帶補上 Docker 部署、獨立簽名服務和一整套 AI Agent 技能包,讓 Claude Code、Codex、Cursor 這類工具裝了技能就能喊它爬資料。免費版與 Pro 的差異,官方的說法是:
| 免費版 MediaCrawler | MediaCrawlerPro | |
|---|---|---|
| 授權與取得 | 原始碼公開,非商用學習授權,git clone | 原始碼不公開,微信訂閱,限個人學習 |
| 帳號與規模 | 自己的單一帳號,預設單次 15 則 | 多帳號搭配 IP 代理池,斷點續爬 |
| 架構 | Playwright(CDP 或標準模式) | 移除 Playwright,附 Docker 部署與獨立簽名服務 |
| 附加 | 評論文字雲、媒體下載、WebUI | 首頁資訊流與熱搜、影片下載器、AI Agent 技能包 |
Pro 欄的內容是作者說明頁的宣稱,原始碼不公開,無法對外驗證。
2026 年 10 月下旬,它掛著 68,572 顆星、13,051 次 fork,開著的 issue 加上 PR 共兩百多件。專案 2023 年 6 月建立,到 2026 年 10 月中旬仍有提交進主線,維持得算健康。不過它從沒發過任何一個正式 release,取得方式只有 git clone,沒有版本號可鎖,你拿到的永遠是開發中的最新狀態,回報問題時每個人手上的程式碼可能都不一樣。
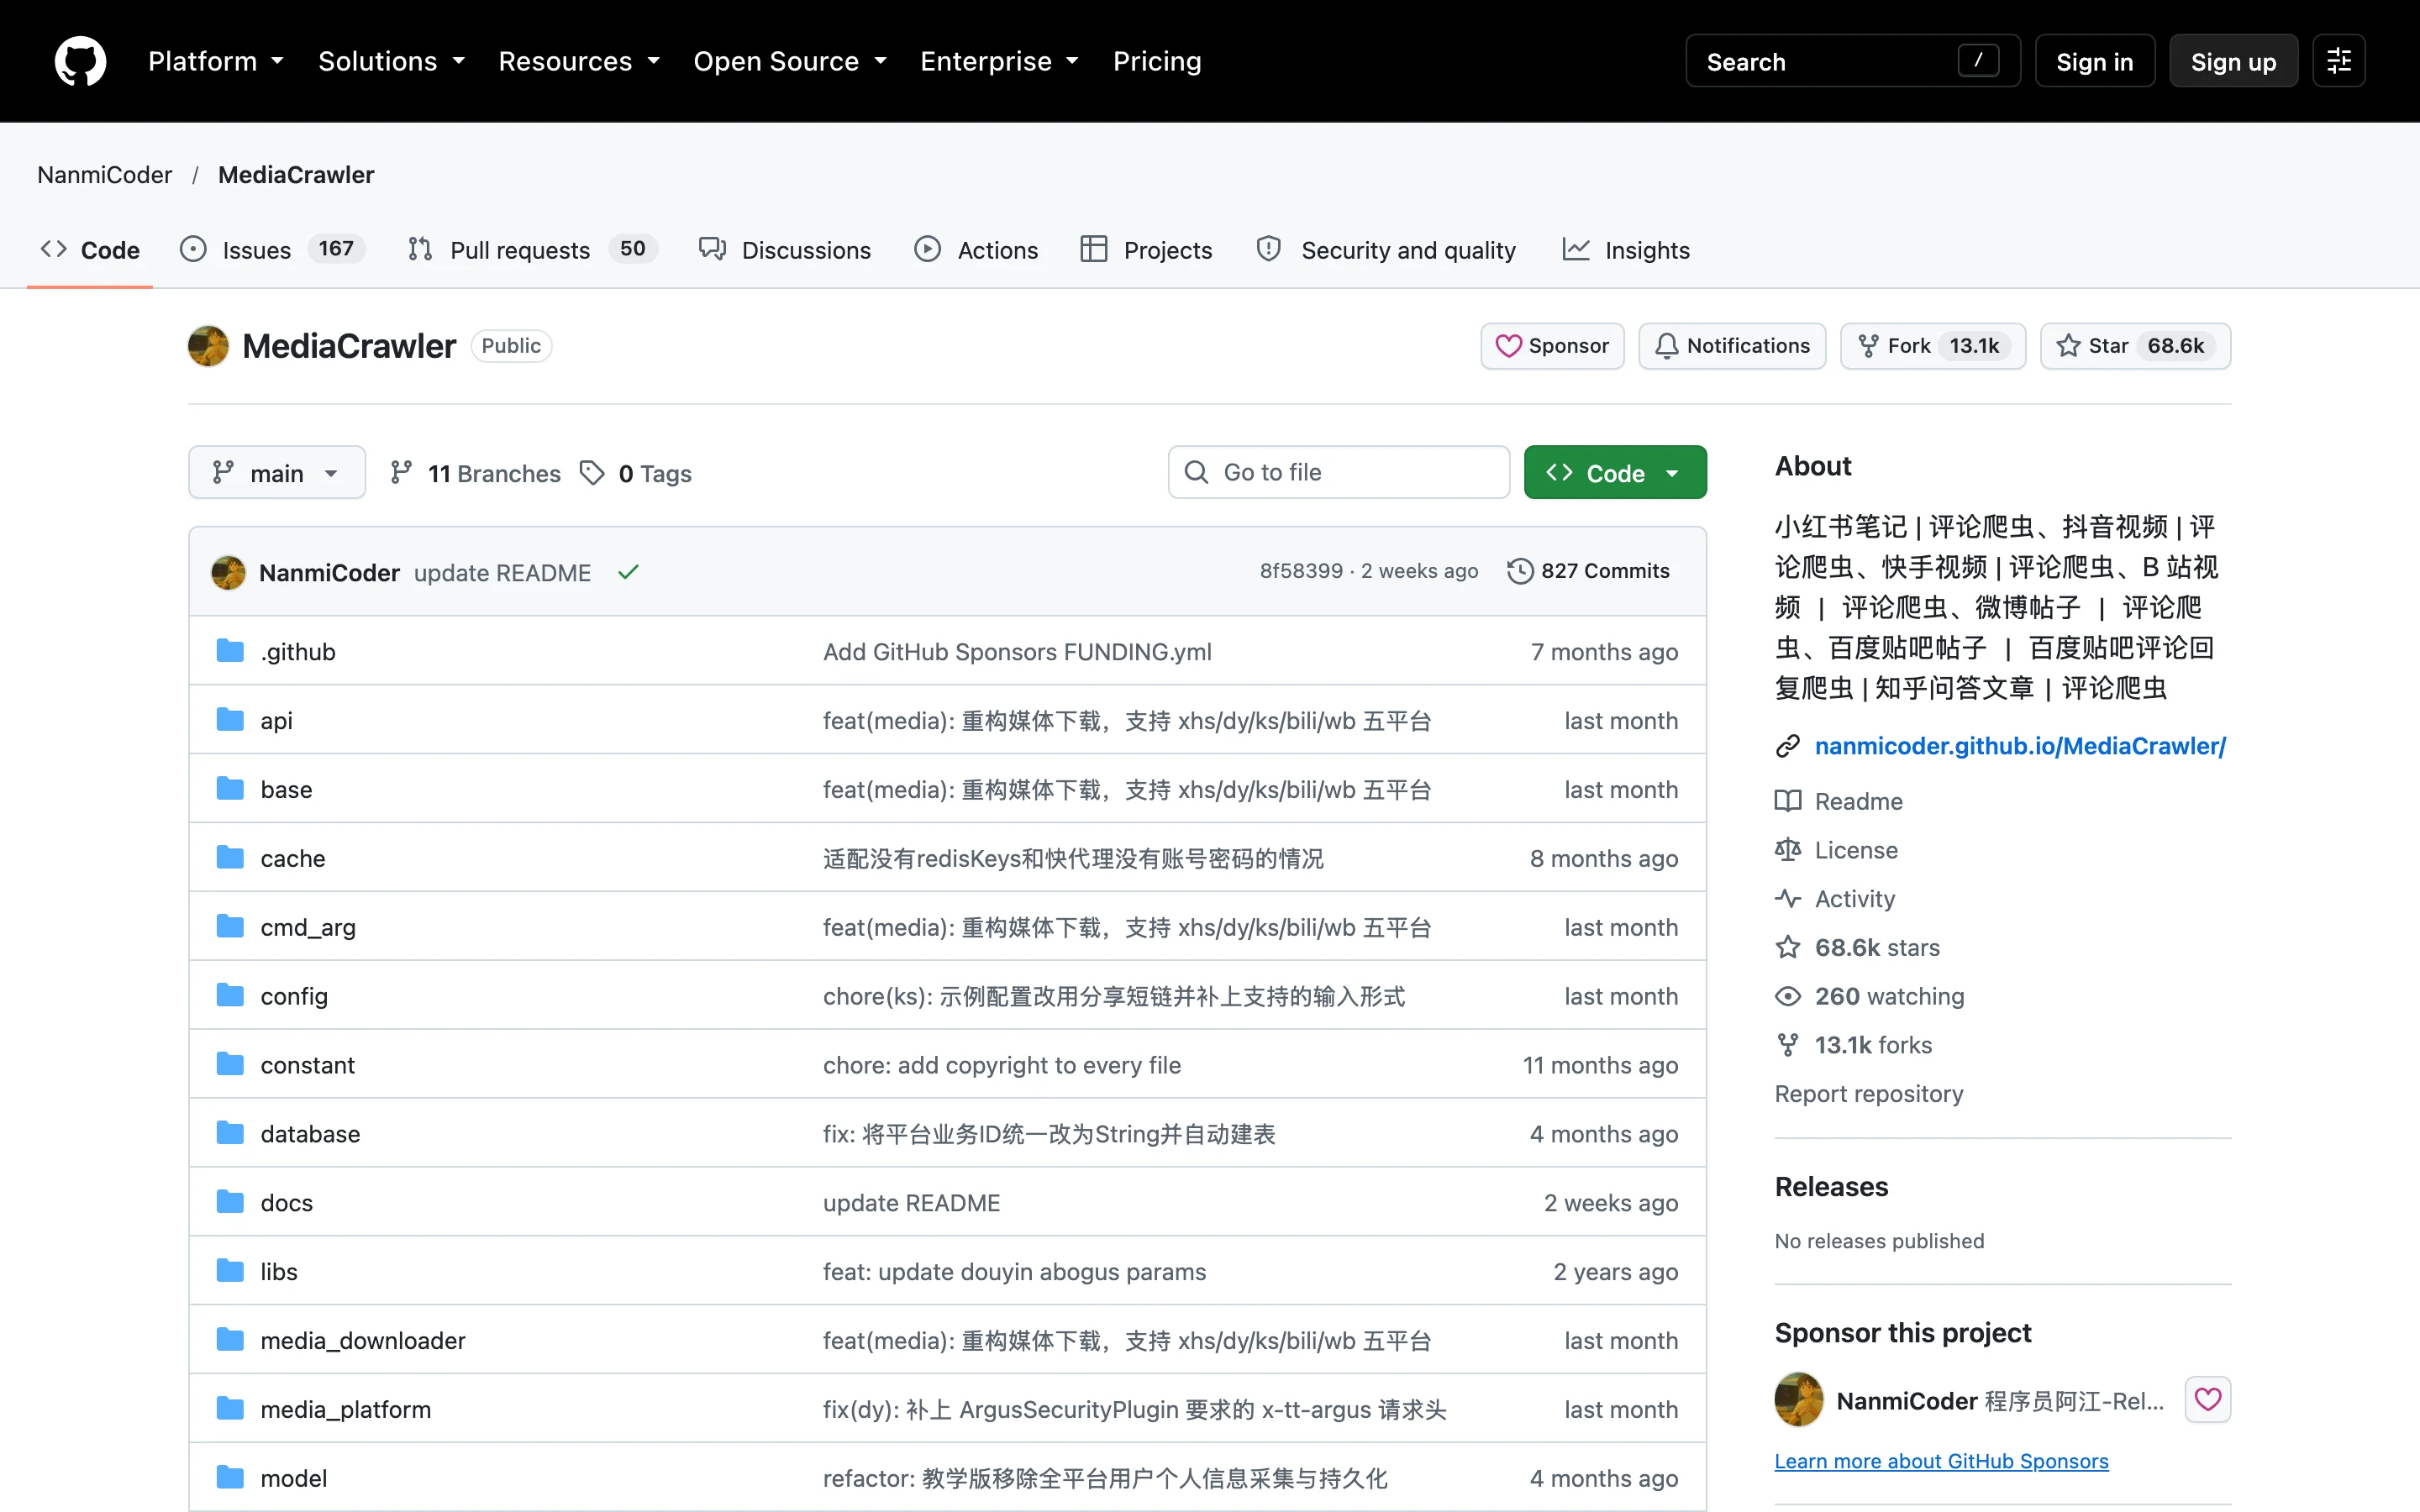
這個專案的維護力氣,很大一部分花在追平台風控。2026 年 9 月 19 日的提交修的是抖音:抖音在邊緣閘道掛上 ArgusSecurityPlugin,對一批介面做前置校驗,缺少 x-tt-argus 請求標頭的呼叫直接回 403,回應內容是 Blocked by ArgusSecurityPlugin Uifid Not Found。這次修補還附了回歸測試,把觸發條件寫進測試文件,之後的改動多了一層測試保護。同一時期的 issue 與 PR 清單也看得出戰場在哪:有人提案用 Firefox 路線增加 stealth 選項(#905)、有人修 CDP 連線逾時的錯誤提示(#988)、有人讓 httpx 請求改用瀏覽器真實的 User Agent 和 Client Hints(#986),指紋特徵的追逐滲透在每個角落。
官方常見問題頁開出來的問題很有代表性:小紅書滑動拼圖驗證一直過不了、本來爬得到後來失效,而官方給失效的答案是多半代表帳號觸發了平台風控,並附帶一句提醒不要對平台做大規模爬取;回報問題的範本更直接把滑動驗證、Cookie 過期、平台風控列為回報前先自查的常見原因。到 10 月上旬,仍有開著的 issue 回報小紅書創作者頁面解析失敗。對使用者的意思是:任何「現在爬得到」的說法都有保存期限,平台改一次風控,可用與不可用就翻一次面。README 的贊助商欄裡四家是代理 IP 服務商(NodeMaven、SX.ORG、ProxyLane、Proxy-Seller,每家都附 MediaCrawler 專屬優惠碼),其餘兩家是資料 API 服務與 AI 模型平台,和風控你來我往,本來就是這門工具的日常。
帳號這層最直接。爬取掛在你的真實登入狀態上,官方常見問題頁自己都把「觸發風控後失效」列為常見結局;主要帳號不該拿來冒這個險,真要試,用一個停權也無妨的小號,並且把授權條款裡的規模限制當真的。滑動拼圖驗證、Cookie 失效這類小麻煩會常態性出現,官方的建議向來是回頭用 CDP 連真實瀏覽器、清掉登入快取重來;繞過驗證這條路,官方文件從來沒教。
平台條款這層也躲不掉。七個平台的使用者協議普遍禁止自動化抓取,程式檔頭的聲明也要求遵守平台規則與 robots.txt。違反條款最常見的後果是帳號被停權或受限,屬於平台與你之間的契約問題;但把抓到的資料拿去轉售或做商業服務,性質就跨到另一個層級,而這恰好也是授權條款明文禁止的方向。
最容易被忽略的其實是資料本身:貼文、評論、暱稱、頭像都是別人的內容與個人資料。在台灣做研究自用,個人資料保護法對蒐集、處理、利用各有對應要求,著作權法對重製與散布也有界線;自己分析,和建資料庫對外提供,是兩個不同的法律位置,後者已經超出這套授權允許的範圍。
官方建議的安裝路線用 uv:裝好 uv 之後在專案資料夾執行 uv sync,Python 依賴一次到位;傳統的 venv 加 pip install -r requirements.txt 仍然可用,文件把它標為不推薦,依賴清單以 Python 3.11 為基準,換其他版本要自己解決相容性。爬抖音或知乎前記得先裝 Node.js 16 以上。官方另有一份文件站,安裝、代理設定、常見問題、專案架構都在上面,出問題先查那一頁比翻 issue 快。
CDP 模式的前置只有兩步:Chrome 升到 144 以上,在網址列輸入 chrome://inspect 勾選允許遠端除錯,看到 127.0.0.1:9222 就緒就完成。回到終端機執行:
uv run main.py --platform xhs --lt qrcode --type search
用手機 App 掃碼登入後,就會照設定檔裡的關鍵字開始爬。要爬哪些字,改 config/base_config.py 裡的 KEYWORDS(作者留的預設值是「編程副業,編程兼職」,改掉就行);要鎖定特定內容,各平台設定檔各有對應清單,小紅書填的是貼文網址清單,其他平台多為 ID 清單。評論開關、儲存格式、單次上限也都集中在這幾個設定檔裡,中文註解寫得算仔細,改起來不用翻原始碼;文字雲的停用詞和自訂詞組也有對應設定檔可調。不想碰命令列的話,專案附了 WebUI:後端用 uvicorn 跑在 8080 埠,前端開發模式跑在 5173 埠,可以視覺化調參數、看即時日誌、預覽和匯出資料;要單一服務部署就先把前端 build 進 api/webui,開一個 8080 就夠。
儲存後端的選擇比 README 寫的還多一個:文件列了 CSV、JSON、JSONL、Excel、SQLite、MySQL,但資料庫連線模組裡 PostgreSQL 是現成支援的,程式碼裡還留了 MongoDB 的儲存基底可以接。預設存 jsonl,落在 data/ 資料夾下,拿去餵 pandas 或文字分析工具都順。
出口這件事也有內建選項,但預設全關。設定檔裡的代理開關預設是關的,打開後可以接代理池,內建範本對接的是快代理、豌豆 HTTP 這類中國大陸的代理商,不然就填一組固定的代理網址。規模需求,免費版裡沒有出口。
適合的讀者有幾種典型情境。想讀一份真實世界爬蟲工程的人:登入保持、簽名取得、反偵測、儲存抽象、多平台介面隔離,這個倉庫都有成形的實作可以對照著學,回歸測試和架構文件都齊。要做小規模、自用性質內容觀察的人:例如經營者想追自家品類的關鍵字在小紅書或抖音的討論變化,每輪換一組關鍵字、單次 15 則的預設量級累積幾輪就足以看出話題輪廓,不需要真的開大流量。以及願意用可承受風險的帳號、接受「今天能爬明天未必」的人。
不適合的也一樣明確。想拿來做商業服務或代抓營利的人,免費版授權不允許,付費版也不收公司客,兩邊都沒有你的位置。要穩定產能的團隊,它的可用性跟著平台風控漂移,沒有服務保證可言。不願意讓任何帳號碰風險的人,這工具的整個設計都建立在「你有帳號可以犧牲」上。
同類需求裡,爬公開網頁餵 AI 用 Crawl4AI;想要拖流程圖的視覺化操作看 Kspider;只在瀏覽器裡抽表格清單用 Easy Scraper;不想寫程式的雲端方案可以看 BrowserAct,它正好是 MediaCrawler 的金牌贊助商;想把抖音創作者內容整份歸檔的另有 dYm。
一句話收尾:把它當教材和自用研究工具,它的價值對得起它的星數;把它當商業機器的地基,授權、帳號風險和維護模式都會要你重新想清楚。