TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南
TechMoon 科技月球
WordPress、SEO 與 AI 工具實測指南

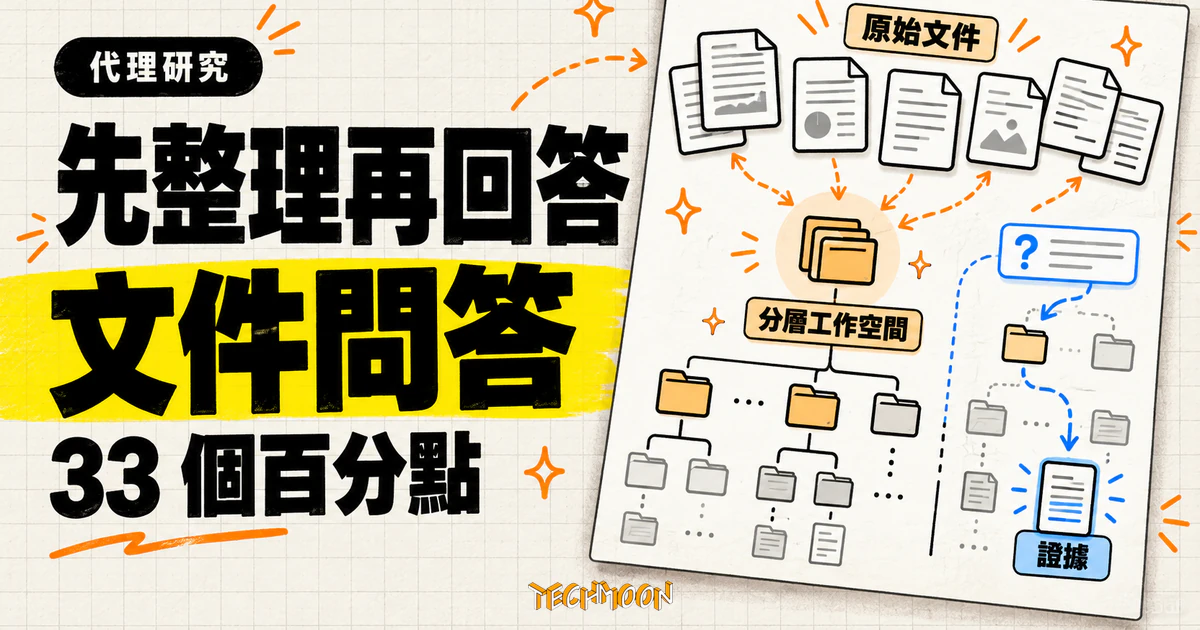
史丹佛團隊的 Librarian Agents 研究用強化學習訓練建置代理,在問題出現前把文件整理成分層工作空間,回答代理沿結構找證據,在 BrowseComp-Plus 比最強檢索基線平均多 33 個百分點;建置成本約 17.9 萬 tokens,損益兩平估在每個文件集合約 31 題,程式碼 MIT 開源但權重未隨附。
用 AI 摘要這篇文章:
公司裡最常見的知識庫困境長這樣:一批規範、手冊、維修紀錄擺了半年,AI 助理每次被問到新問題,都要把整堆文件重新翻一遍,再現場拼出一個答案。文件沒變、問題換了,搜尋與整理的成本就再付一次。2026 年 10 月 15 日提交到 arXiv 的一篇論文把這件事換了做法:讓另一個代理在問題出現之前先把文件整理好,蓋成一個之後所有問題都能反覆使用的分層工作空間,而且整理這個動作本身,是用強化學習訓練出來的能力。
這份研究叫 Librarian Agents,由史丹佛大學的 Anikait Singh、Teresa Zhang、Yoonho Lee、Roshen Sanjay Nair、Chelsea Finn,與卡內基美隆大學的 Aviral Kumar 合作完成,程式碼與專案頁已經公開。論文摘要裡最顯眼的宣稱是:在 BrowseComp-Plus 文件問答基準上,比最強的檢索與預計算基線平均多拿 33 個百分點。這個數字有明確的計算條件。框架本身動的,是問題到來之前的那段整理工作。
長上下文模型能把整批文件裝進視窗,但跨文件的關聯仍要自己找:哪份規範的哪一條例外適用於眼前這題,模型每次都要重新定位。標準的檢索增強生成(RAG)是收到問題之後才開始動作,先搜尋相關片段再生成答案;知識圖譜那類預先計算的結構則依賴固定規則,遇到意料之外的問法就使不上力。論文的切入點是把一部分推理工作搬到問題到來之前:先替文件建立可導航的結構,而且這個結構要為「未來可能的查詢」而蓋,不是為眼前那一題。
框架把代理拆成兩個角色。建置代理只做四個動作:Create、Merge、Delete、Stop,把平面的文件集合整理成分層的合成檔案,每個合成檔案都保留回到原始文件的參照連結。回答代理維持原樣,用檔案列示與檔案閱讀這些它本來就熟悉的操作,在整理好的空間裡找證據作答。合成檔案的角色是導航層,權威依據仍是原文,這條參照連結讓「找到答案」隨時可以回頭查證,概念上接近把散落的資料整理成有目錄與索引的知識庫,只是目錄本身會隨使用經驗演化。
論文點出這個設計背後的現況落差:像 Claude Code 這類代理很會在既有檔案系統裡導航、解決眼前的任務,卻幾乎沒有被訓練去為未來的查詢蓋可重用的工作空間。導航與整理是兩種能力,前者已被大量打磨,後者是這份研究想補上的那一塊。既有的兩個極端各有代價:什麼都不整理,每個新問題都重付一次搜尋與拼湊的成本;把整批文件壓成一份總摘要,看似省了,但摘要為某一族問題服務時,另一族問題需要的細節可能已經在壓縮中消失。分層加上參照連結是走中間路線:上層給快速定位,需要細節時沿連結回原文,兩種需求的成本都壓得下來。
評測設定是 BrowseComp-Plus 拆成 680 個訓練任務與 50 個隨機抽出的保留任務,回答代理全程凍結,只更換它前面的記憶層。研究跑了兩個回答模型,結果表逐格公開:
| 回答代理 | Librarian 工作空間 | 最佳檢索基線 | 嵌入式檢索 | 未訓練建置者 |
|---|---|---|---|---|
| Qwen3.5-4B | 75% | 44% | 42% | 25% |
| Gemini 3.1 Flash Lite | 77% | 42% | 30% | 28% |
33 個百分點的計算方式:兩個回答模型各自對最佳基線的差距是 31 與 35 個百分點,取平均就是摘要裡的 33。細看會發現 Qwen3.5-4B 那組對嵌入式檢索剛好贏 33 個百分點(75% 對 42%),但真正的最強基線其實是重排器與代理式檢索的 44%。引用這個數字時,把它當「特定模型與基準下的平均幅度」比當「保證增幅」安全得多。嵌入式檢索依賴把文字轉成向量再找語意相近片段,這條路的編碼器品質近年進步很快,卻仍然受「收到問題才開始找」的架構限制。
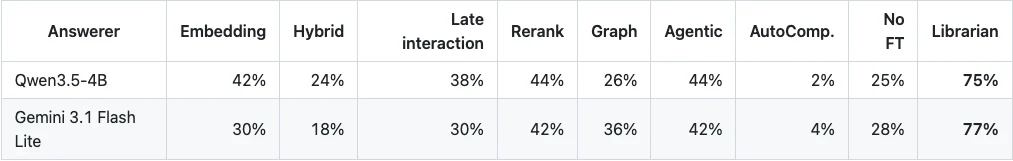
整份結果裡最有說服力的對照是未訓練那一欄。同一顆 Qwen3.5-4B 沒有經過強化學習就去蓋工作空間,兩種回答代理下只剩 25% 與 28%,比多數檢索基線還差;它還在 50 個文件集合中有 14 個根本沒完成建置,訓練後的版本是 0 個未完成。換句話說,改善來自訓練出來的整理策略,單純多放一個代理進去不會變準,反而可能更糟。
研究把工作空間的建置形式化為馬可夫決策過程,用群組相對政策最佳化(GRPO)更新建置代理的政策。獎勵的設計只留兩件事:每 8 輪用一批隱藏的抽樣查詢探測一次可答性的變化(每條軌跡最多 4 次),加上最後的答案正確性;至於檔案結構整不整齊、建置花多少 token,顯式獎勵項一律為零。論文引用潛在函數獎勵整形的結果,主張這組密集回饋等價於直接最大化最終答題表現。之所以不對每個編輯動作都做完整評分,是因為每評一次就要讓回答代理實際跑一輪答題,成本太高;間隔探測把回饋密度與訓練開銷折衷在中間。白話講:整理的好壞由下一關的答對率定義,摘要漂不漂亮、檔案多不多,計分板上沒有這一欄。
訓練配方的細節都寫在重現文件裡:建置政策是 Qwen3.5-4B 配上 rank-32 的 LoRA,檔案的實際建立與合併由 Qwen3.5-35B-A3B 執行器輸出;訓練跑在 Tinker 平台上,推論由 Modal 託管;680 個任務、10 個 epochs、每條軌跡 32 輪建置動作、每個動作上限 1,024 tokens、整條軌跡上限 60,000 tokens。儲存庫的致謝段寫明 Tinker 提供訓練算力、Modal 支援模型推論。這些依賴項說明了重現門檻:它不是一份單機就能跑的腳本。
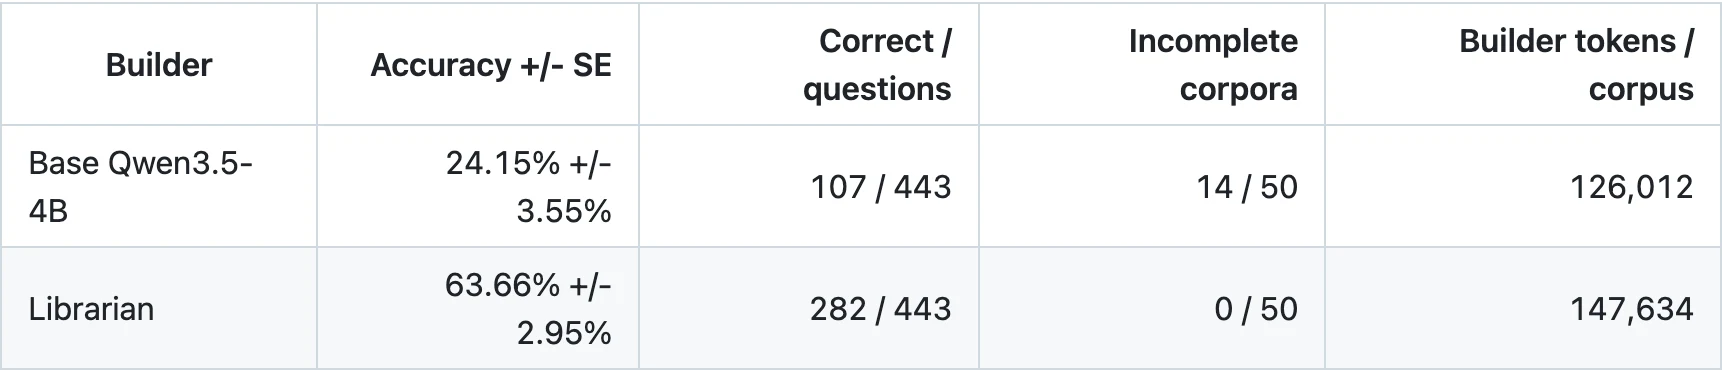
先整理的成本結構要分兩個協議看,論文與儲存庫都明講不能混用:跨回答者的建置實驗記到 178,926 tokens;重複使用協議記到每個文件集合 147,634 tokens。另一個容易被標題掩蓋的事實是,回答代理在豐富的工作空間裡讀得更多:每題平均讀 26.9 個檔案、9,346 tokens,而基礎建置者的陽春空間每題只要 1,238 tokens。單題閱讀量變貴了,省錢的前提是正確率把差價賺回來。
重複使用實驗是這套方法最貼近知識庫場景的一段:443 題查詢分配到 50 個文件集合(每集合 7 到 10 題),同一個工作空間服務所有題目。正確率從 24.15% 升到 63.66%,配對增益 39.50 個百分點(95% 信賴區間 31.47 至 47.75),每單位建置 token 換到的正確答案數提升 2.25 倍。這裡有個前提必須交代:那 443 題是 Gemini 3.1 Flash Lite 用少量樣本提示生成的合成查詢,並非人類的真實提問。
攤提的帳是這麼算的:按每個文件集合 20 題把 17.9 萬的建置成本攤進去,論文推估每題總用量約 18K tokens,重複使用協議自己記錄的口徑則接近 16.8K;在每集合 10 題的規模,每個預期正確答案的記錄 tokens 比基礎建置者少 33.8%(比值 0.662,95% 區間 0.504 至 0.836);兩種方法的每正確答案成本打平的估計點,是每個集合約 31 題(95% 區間 18 到 54)。對營運決策的意義很直接:一個文件集合被查詢的次數如果到不了數十題的規模,前置整理這筆錢很可能收不回來;會被反覆查詢的手冊、規範、支援知識庫,才符合這套方法的經濟學。實務上要看的數字也因此在帳務系統裡,應用服務日誌與搜尋紀錄,先把每個文件集合的月查詢次數量出來,再決定哪些集合值得預付建置成本。
研究用 BRIGHT 基準測未見領域的轉移:三個領域各 50 題共 150 題,每個領域只蓋一個共用檔案系統,建置代理在蓋的時候沒見過任何評測題。平均單次回答正確率 0.520,同一批題目上最佳基線只有 0.208,這就是摘要裡 31 個百分點平均改善的出處。分領域看落差很大:數學競賽討論的 AOPS 是 0.360 對 0.330 的小勝,生物是 0.345 對 0.195,Stack Overflow 程式問答則是 0.855 對 0.115 的壓倒性差距。評測把每題配上固定參考答案,再對生成的回答做語意正確性判分。
結構面的證據同樣值得看:在 BRIGHT 上,訓練後的建置代理平均留下 53.4 個活躍合成檔案、45.4 個群集、8.0 次合併,基礎版只有 4.8、4.2、0.6。蓋得豐富本身就是訓練出來的行為,而且這種豐富沒有綁死在訓練分布上。論文的定性分析裡還有一個耐人尋味的案例:某個查詢需要的細節當初沒有被收進合成層,回答代理沿著參照連結回到原始檔案,照樣把答案找出來,不必把整個未整理的語料從頭列舉一遍。整理不需要完美,只要留下回頭路,導航就還能完成任務。
分層到底有沒有用?分層的價值另有 49 個文件集合的消融可以檢驗:把階層攤平,正確率幾乎不動(55.86% 對 57.70%),但每題導航成本增加 1,862 tokens;把檔案的語意位置打亂,正確率掉 4.14 個百分點。層級結構的價值主要在導航成本與證據定位,評斷整理品質不能只看答題分數,還要看讀者(或代理)找證據要走多遠。
儲存庫在 2026 年 10 月 7 日建立、最後一次更新在 10 月 16 日,MIT 授權,共 105 個檔案:強化學習環境、資料處理、訓練與評測腳本、指標重算工具、資料切分清單一應俱全,實驗產物以 CC BY 4.0 釋出。想驗證論文數字的人,現在就能用附帶的壓縮紀錄重算全部表格。
缺的一塊是權重。檢查點文件只給了訓練步數對應:BrowseComp 評測用第 55 步、BRIGHT 用第 89 步,並要求使用者自行準備模型路徑;重新訓練則需要 Tinker 的 API 金鑰與外部執行器。換句話說,可以完整重走訓練與評測路線,但不能下載一個訓練好的建置代理直接接上自己的知識庫。截至 10 月 19 日,儲存庫只有 3 顆星,這個方向還非常新。
論文裡有一個很實在的例子:建置代理整理出的一份版本時間軸,可以服務回歸問題、路線圖變更、客戶溝通、依賴更新等一整族問題。一次整理換多次使用,這才是這套方法的獲利模式。對照下來,適合跟進的條件相當清楚:文件集合穩定、每個集合的查詢量能到數十題以上、答案需要回到原文查證。
該再等的場景也一樣清楚。文件經常更新的知識庫要先算更新帳,論文的限制段落明講:評測限於靜態語料上的問答,文件變動後如何維護這種先行整理的記憶,是還沒解決的問題。大海撈針型的細節查詢也要小心,合成壓縮可能丟掉罕見但關鍵的條款,參照連結是退路,但什麼時候該繞過合成層直接回原文,研究自己也說仍是挑戰。另外有兩件事隨時在變:代理記憶的工程實作(例如跨工具共用記憶的開源堆疊)進展很快,而論文的所有數字都是作者自報,同儕審查與第三方重現都還沒有出現。
把「資料存在」與「資料整理到可用」分開計價,是這份研究給知識庫團隊最實用的一課。整理能不能被訓練、值不值得預付成本,這份論文給了一份從訓練配方到評測紀錄都完整公開的肯定證據;至於你手上的文件集合適不適用,答案在自己的查詢次數統計裡,不在那 33 個百分點裡。